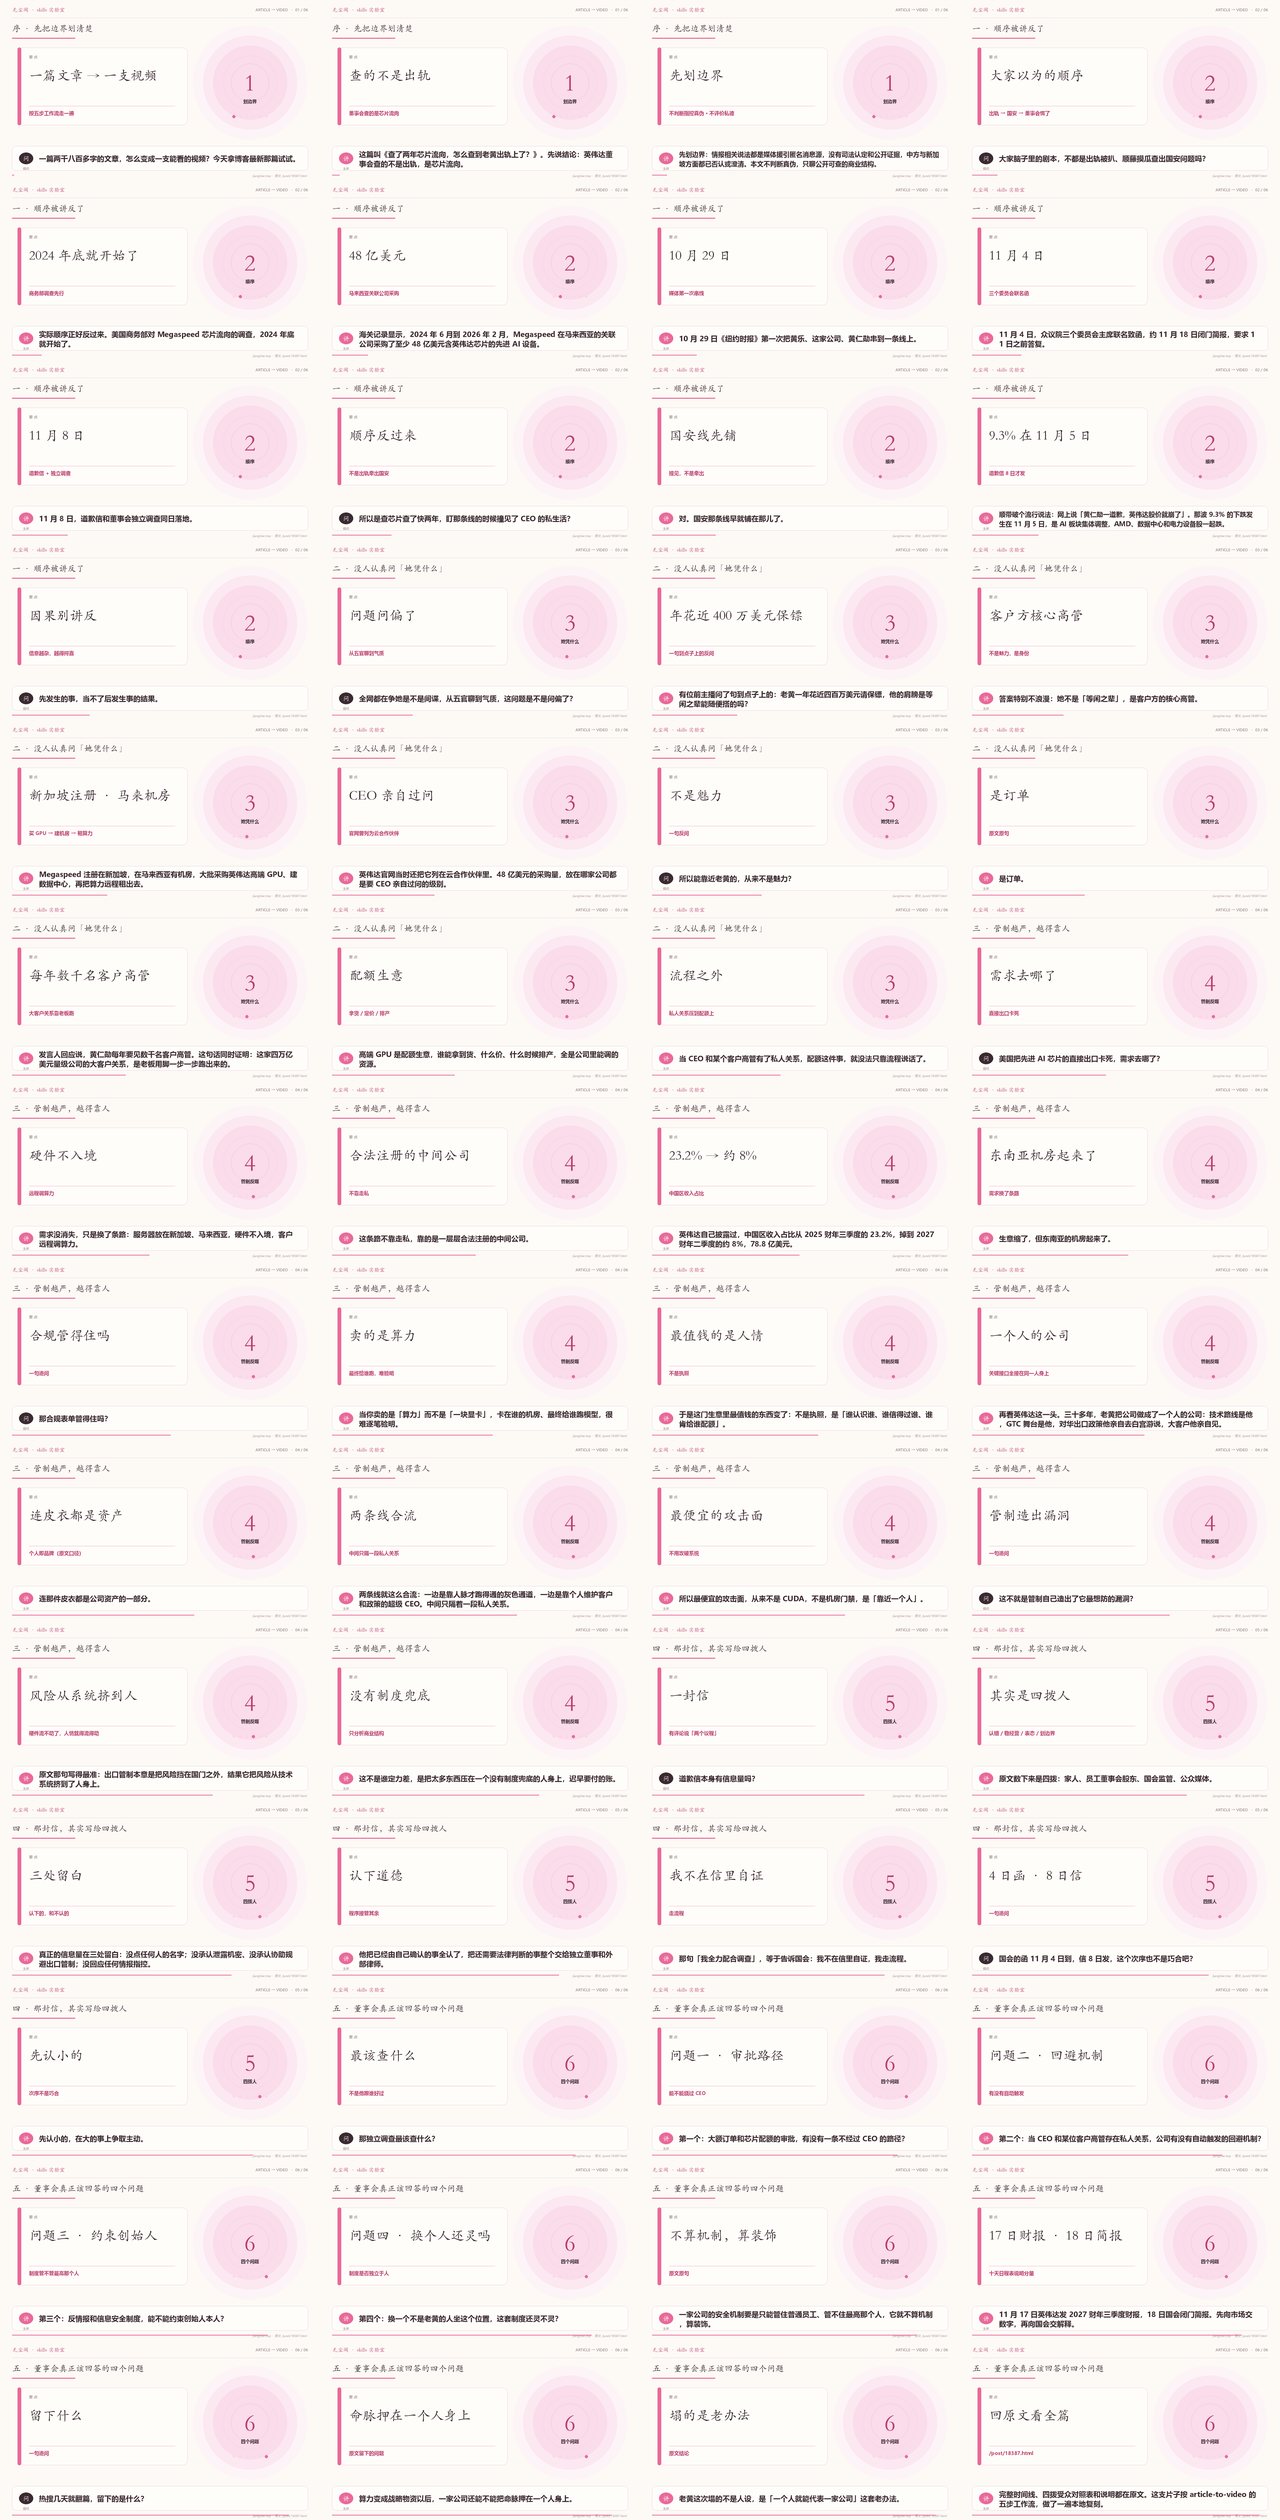
把博客最新那篇长文,按 article-to-video 开源工作流的五步方法论,做成两个人对话讲给观众听的 16:9 讲解片。讲到哪一句,画面和字幕就停在那一句;脚本、配音、成片三道关卡各自留下可核对的文件。
原始文章:《查了两年芯片流向,怎么查到老黄出轨上了?》 /post/18387.html ↗
主讲(女声)讲结构,提问者(男声)替观众问卡点。字幕烧录在画面里,另附可下载的 SRT。
文章的核心不是八卦,而是顺序与结构:芯片流向调查先行、管制把风险从技术系统挤到人身上、道歉信写给四拨人、董事会真正该回答的四个问题。视频按这条线一幕一幕讲下来,事实与数字全部照原文,未添任何判断。
打开原文 /post/18387.html →来自公众号「漫行书海」的开源工作流,MIT 许可,代码与流程手册都在 GitHub。
一句话把图文文章变成 16:9 知识讲解视频:两个人的对话讲给观众听,截图上的红框、终端里的命令,讲到它的那一秒才出现。作者用它做过一支 14 分钟实战成片。
装好工具后,在 Claude Code / Codex / Cursor / WorkBuddy 里发一句:按 WORKFLOW.md 的流程,把这篇文章做成视频:<文章链接或 .md 路径>,助手自己往下跑,只在三道关卡停下来等确认。
Gemini TTS 免费版出双人配音,WhisperX 逐字对齐,Remotion 渲染画面,FFmpeg 合成。原工程面向 Mac / Linux,Node 18+、uv,安装约 3 GB;免费版每天 10 次配音调用,一支片子通常 2 次。
左边是原工程的命令与动作,右边是这一支片子实际落在磁盘上的东西。
./a2v fetch正文和截图一起拿下来,支持公众号、飞书文档、任意网页和本地 Markdown。
本片:直接用博客文章 18387 的 Markdown 源稿,事实与数字逐条对原文核对。
./a2v voice → 关卡 ②先出 1 分钟试听段,再整段对话一次配好;满意才往下走。
本片:preview-1min.mp3 试听段 + video.mp4 双声整片,按真实音频时长排时间码。
./a2v shots每个画面切换绑定台词关键词,讲到哪张图就推近哪一处,渲染前自动校验。
本片:每句一张粉色要点卡 + 幕导航,timeline.json 逐句记 start/end,字幕按同一时间码烧录。
./a2v render → 关卡 ③一条命令出片,自动做黑帧扫描、配音切点检查,抽帧拼成缩略图墙交给你复核。
本片:contact-sheet.jpg 缩略图墙 + qc-report.json 质检报告(黑帧告警 0 条)。
另外还有 ./a2v chapters:本片对应 chapters.txt,页面上方的章节按钮可直接跳播。
原流程要求脚本、配音、成片都由人确认再往下走;这次由助手代跑,三份复核材料全部摊开放在页面上。
| 关卡 | 要确认什么 | 本片的复核文件 |
|---|---|---|
| ① 口播脚本 | 读一遍稿子,看有没有讲错事实、有没有把因果关系说反 | script.txt |
| ② 配音 | 先听 1 分钟试听,再听整片,音色、节奏、停顿是否顺 | preview-1min.mp3 / video.mp4 |
| ③ 成片 | 看缩略图墙有没有空画面,字幕有没有盖住要点卡 | contact-sheet.jpg / qc-report.json |
实验室的规矩:每篇都得说清成品、原始素材、用的是哪个 skill、以及哪里做不到。
7:47 成片、6 幕、56 段对话、9,356 帧、10.7 MB,附 SRT、口播稿、时间线、缩略图墙、试听段、章节表。
博客文章 18387 ↗,2026-11-09 发布;片中所有时间、金额、比例与引句均出自该文及其列举的公开报道口径。
方法论来自 MIT 开源工作流 article-to-video ↗(漫行书海),本次为本地等效复刻。
没跑原工程,也不是官方产出;不是 14 分钟长片;无截图红框推近;事实边界与原文一致,不判断任何指控真伪。
说清楚这次的等效实现:原工作流要求 Mac / Linux + Node 18 + uv + Gemini API Key(免费版)+ WhisperX 中文对齐模型(约 1.3 GB)+ Remotion 渲染引擎(约 3 GB)。这台机器是 Windows,也没有 Gemini Key,因此 没有运行 article-to-video 原工程:配音改用本地免费 TTS 双声,逐字对齐改用「按真实音频时长排时间码」,画面改用 Python 逐帧绘制 + FFmpeg 管道合成,红框识别与 Remotion 模板没有复刻。五步顺序、双人对话结构、台词与画面绑定、三道关卡的复核产物、自动质检,都按它的方法论保留。
内容边界:情报相关说法均为媒体援引匿名消息源,尚无司法认定与公开证据,中方与新加坡方面均已否认或澄清;成片与原文一致,只分析公开可查的商业结构,不判断真伪、不评价任何人的私德。
无尘阁日记 · skills 实验室 · 2026-11-09 · 配色:牛奶白 × 粉 · 上游:article-to-video(MIT)