搜索给广度,垂直库给精度
一个命令行入口接两层数据来源:DeepSeek 搜索与抓取负责全网召回和整页转 Markdown,11 个免 key 垂直源负责把论文、漏洞、财报、药品的原始字段直接取回来。附一个在线功能:输入一个名字,出一份可打印成 PDF 的简报。
为什么不只用搜索
搜索能告诉你「哪里有」,但说不准「具体是多少」。写进报告的数字要能核对,所以这两层都留着。
搜索 + 抓取
- POST /v1/tools/searchquery · count 1–50
- POST /v1/tools/fetch整页转 Markdown
- 返回字段authority · rerank_score
- 算符site: lang: after: "…"
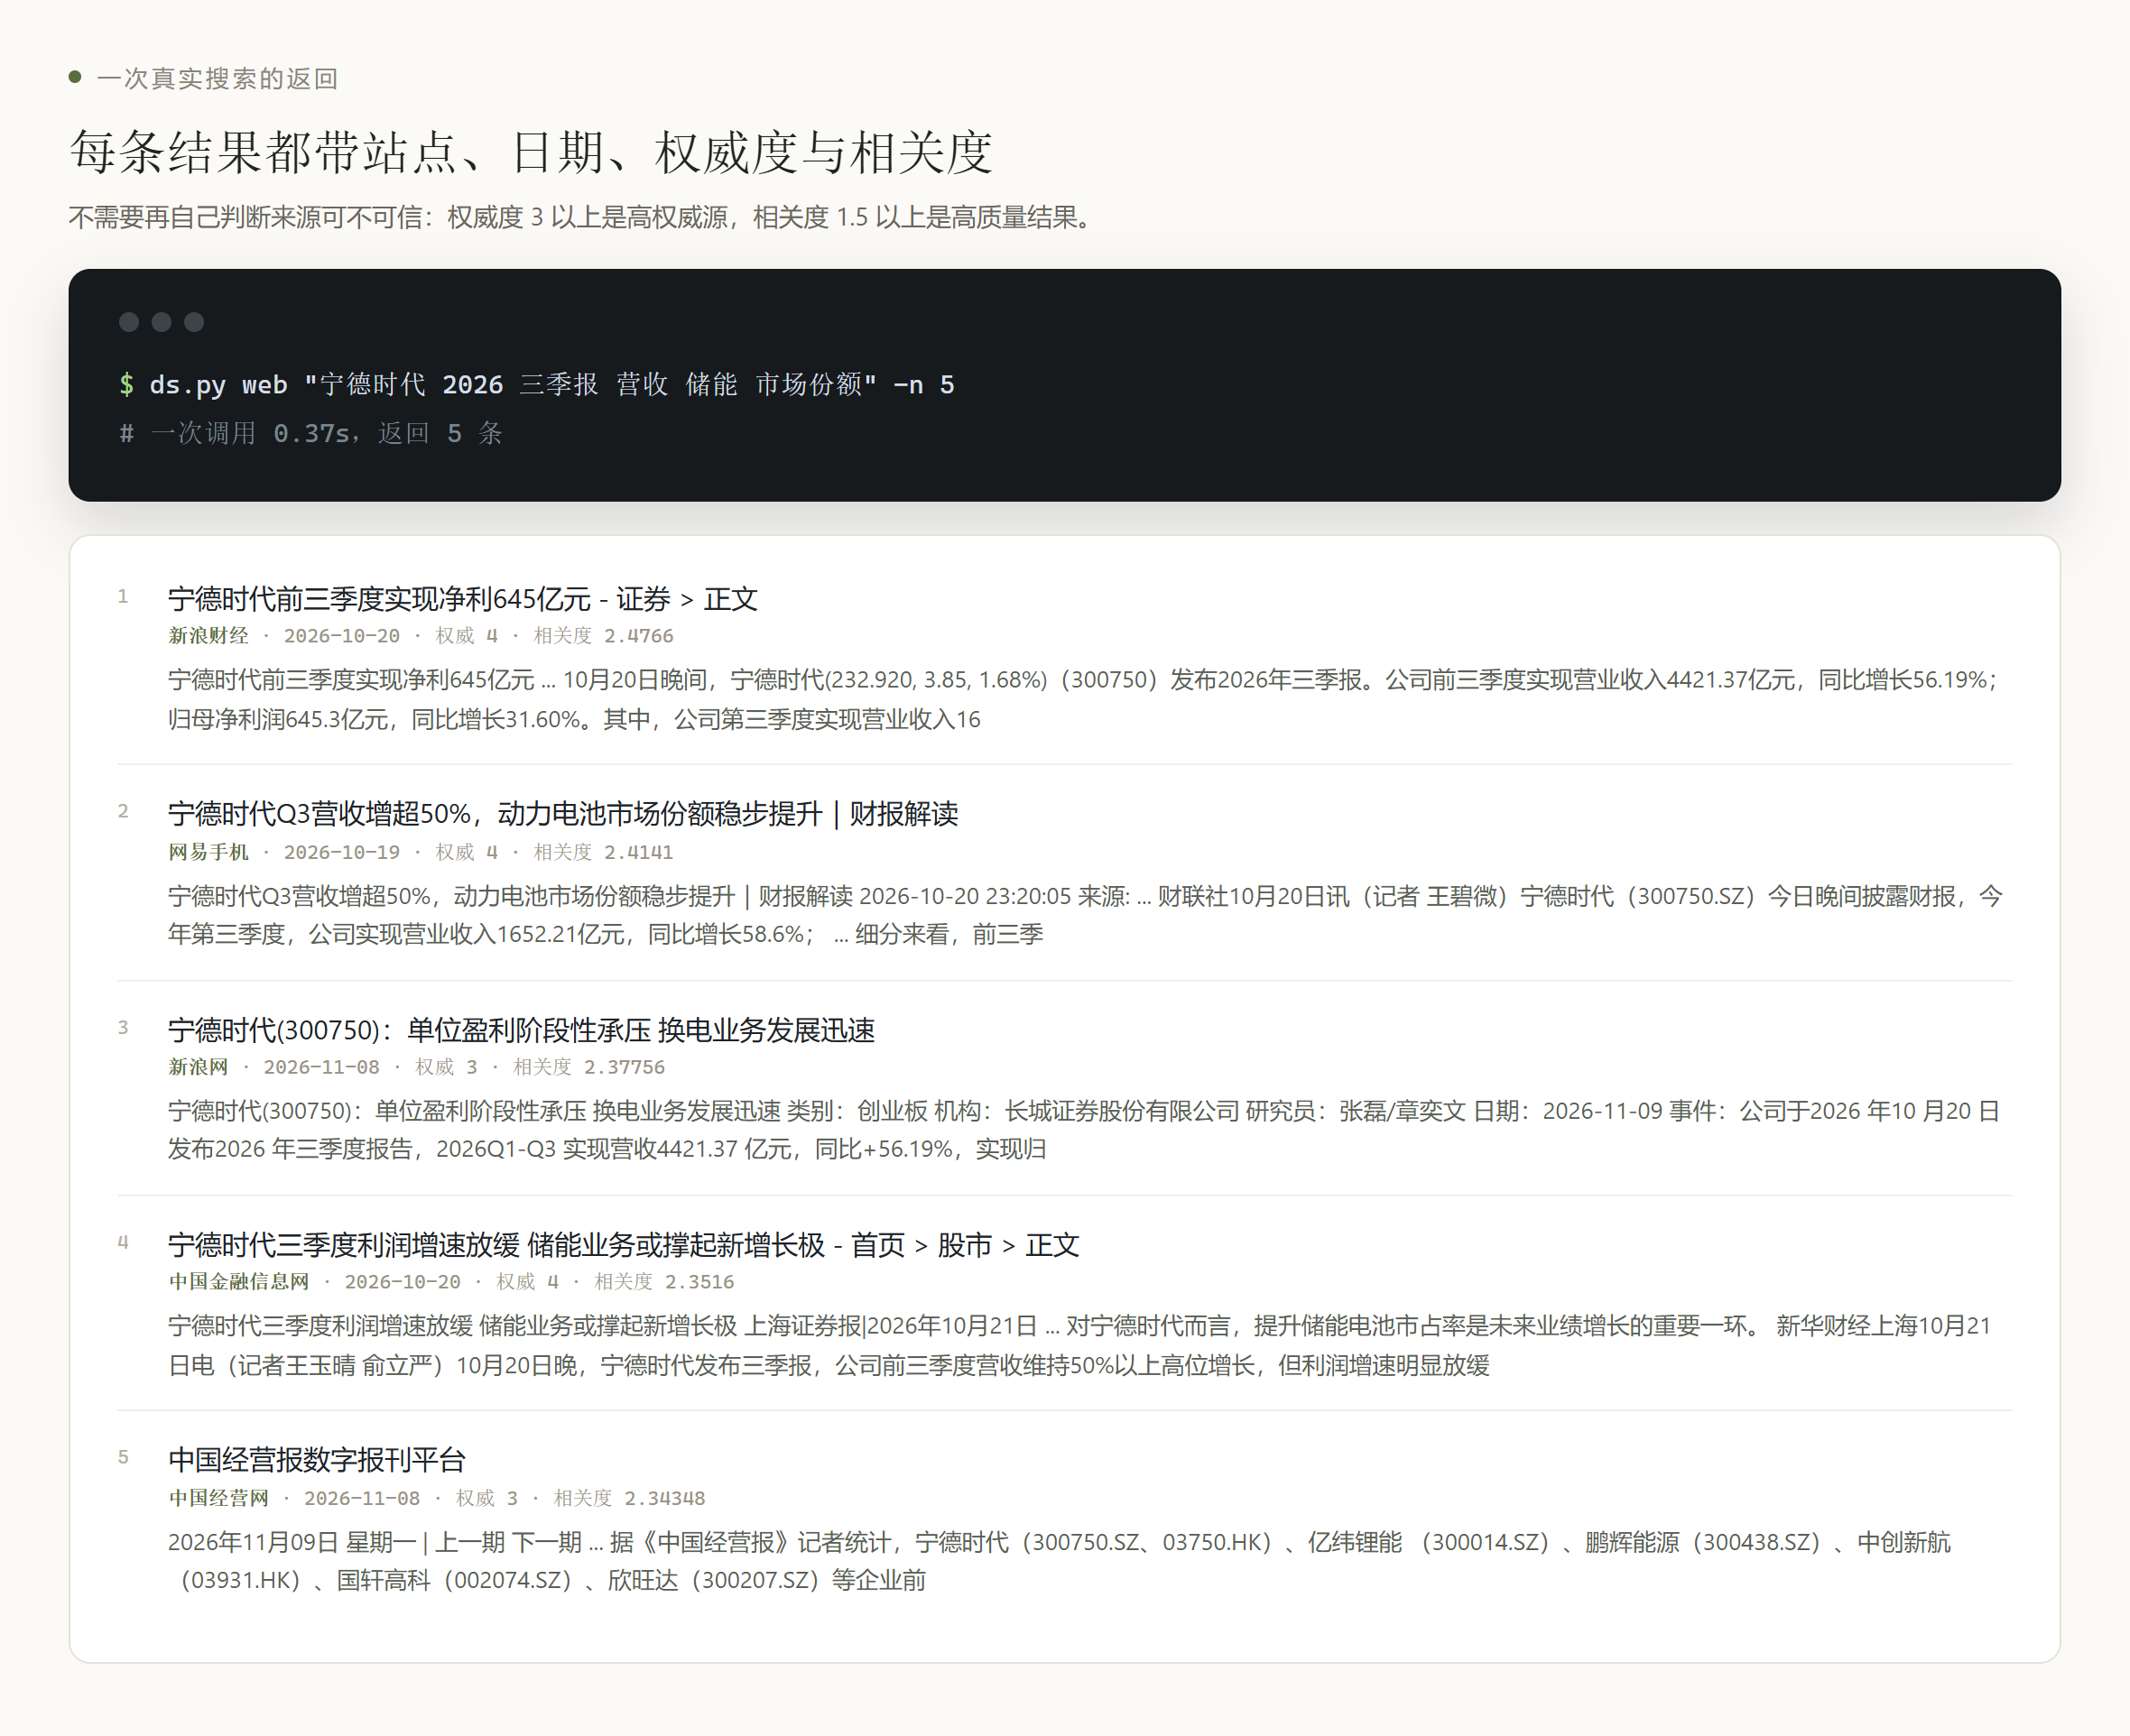
每条结果自带站点、日期、权威度(0–4)与相关度(0–3),不用自己猜来源可不可信。抓取直接给 Markdown,标题层级和代码块都保留。
11 个垂直源
- 论文arXiv · OpenAlex · Crossref
- 漏洞OSV + NVD 双源并列
- 医学Europe PMC
- 财报 / 药品SEC EDGAR · openFDA
- 代码 / 问答GitHub · Stack Overflow
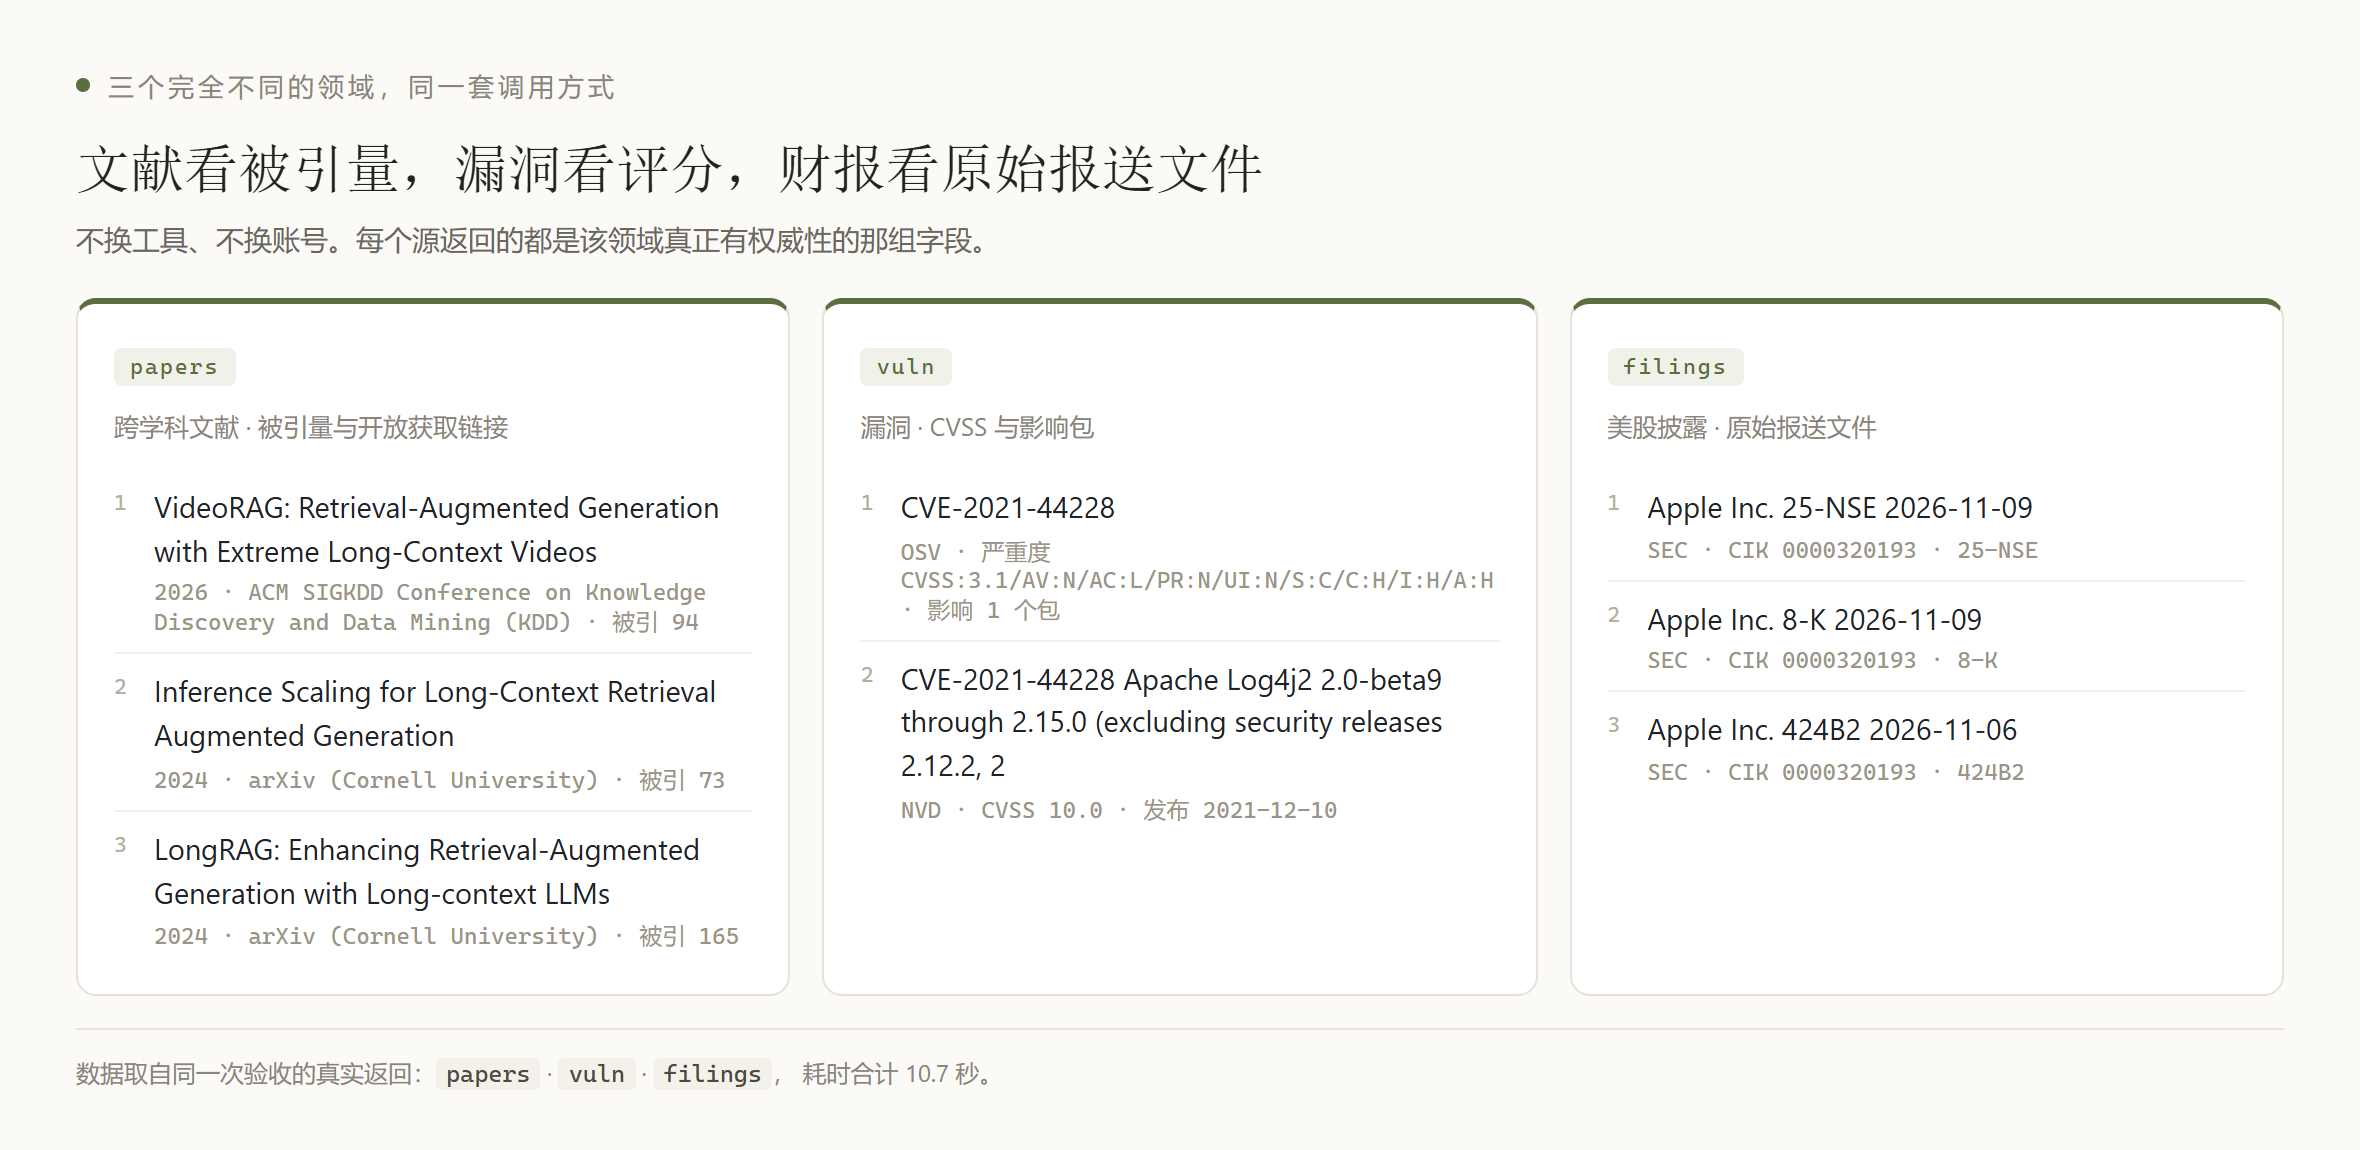
这些是一手库,返回的就是该领域真正有权威性的字段:被引量、CVSS、原始报送文件、说明书适应症。不消耗任何额度。
输入一个名字,出一份 A4 简报
这是这套东西里唯一带界面的部分。前端只发一个名字,服务端并发检索三个角度、去重、按权威度排序,再把材料交给模型写成结构化简报,回到浏览器排版。
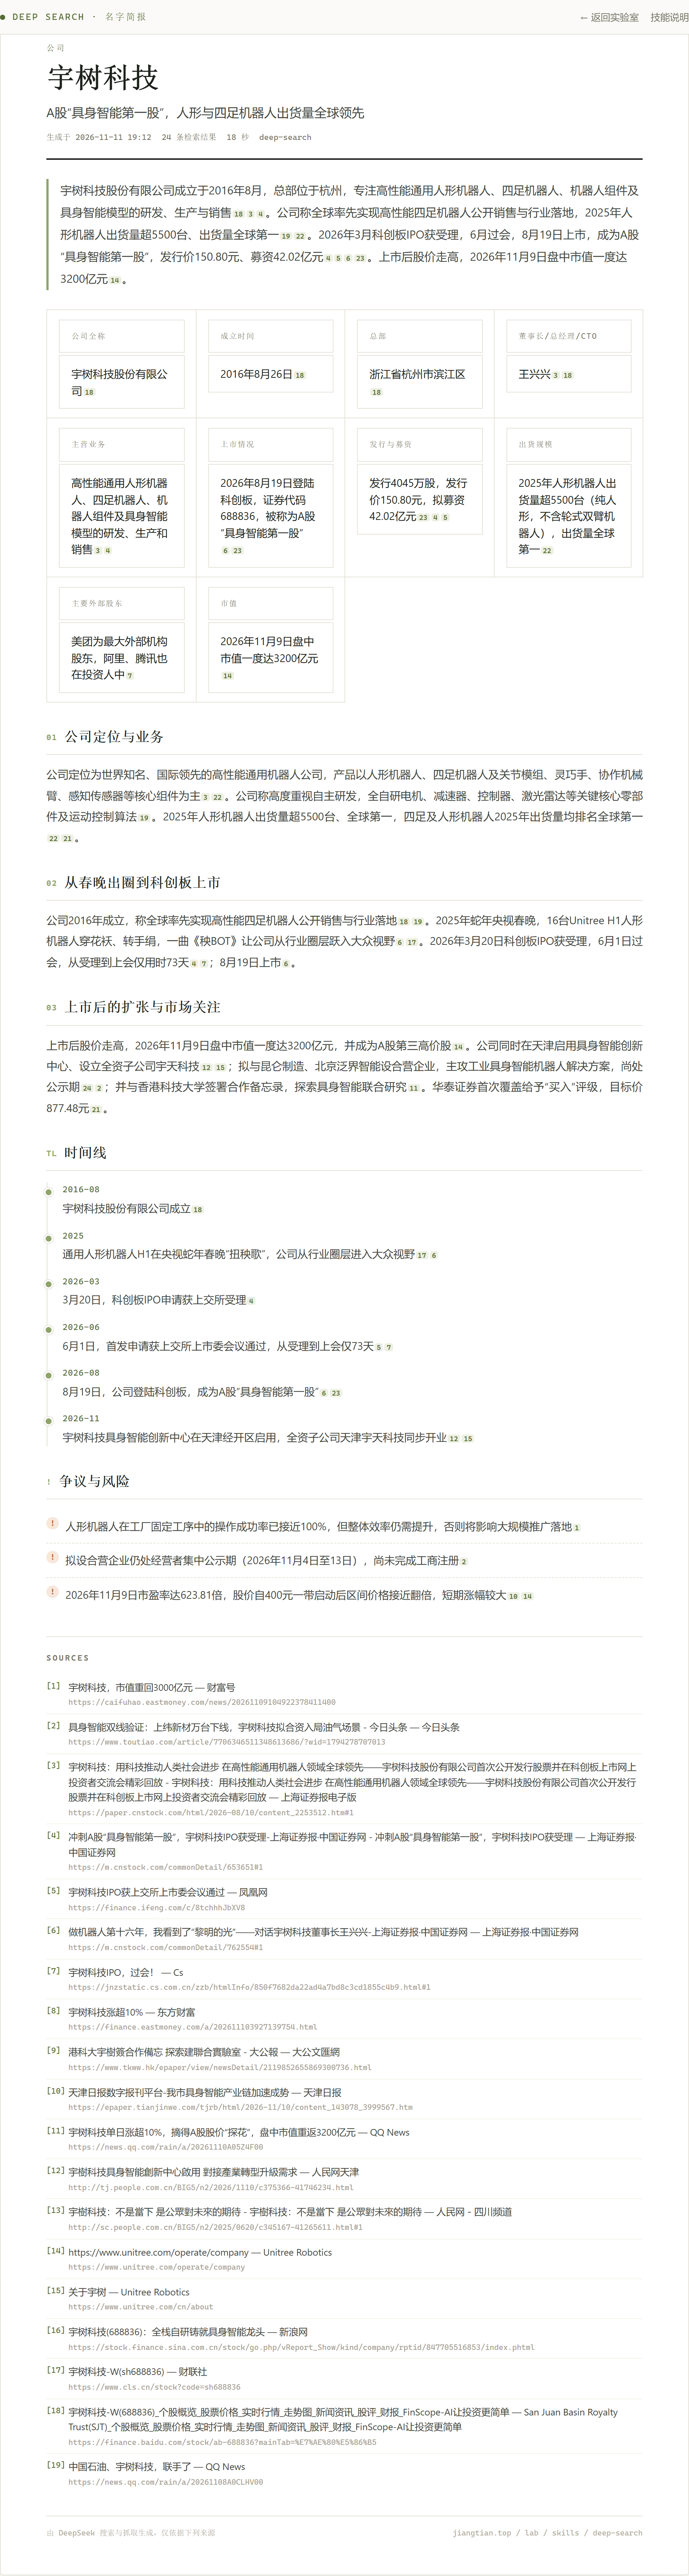
每份生成完都会自动存档,页面上给一条永久链接。存档页公开、不需要登录:别人拿到链接能看,从 /report/archive/ 也能翻到全部。同一个名字只留最新一份,不堆垃圾。
图里的每个数字都是跑出来的
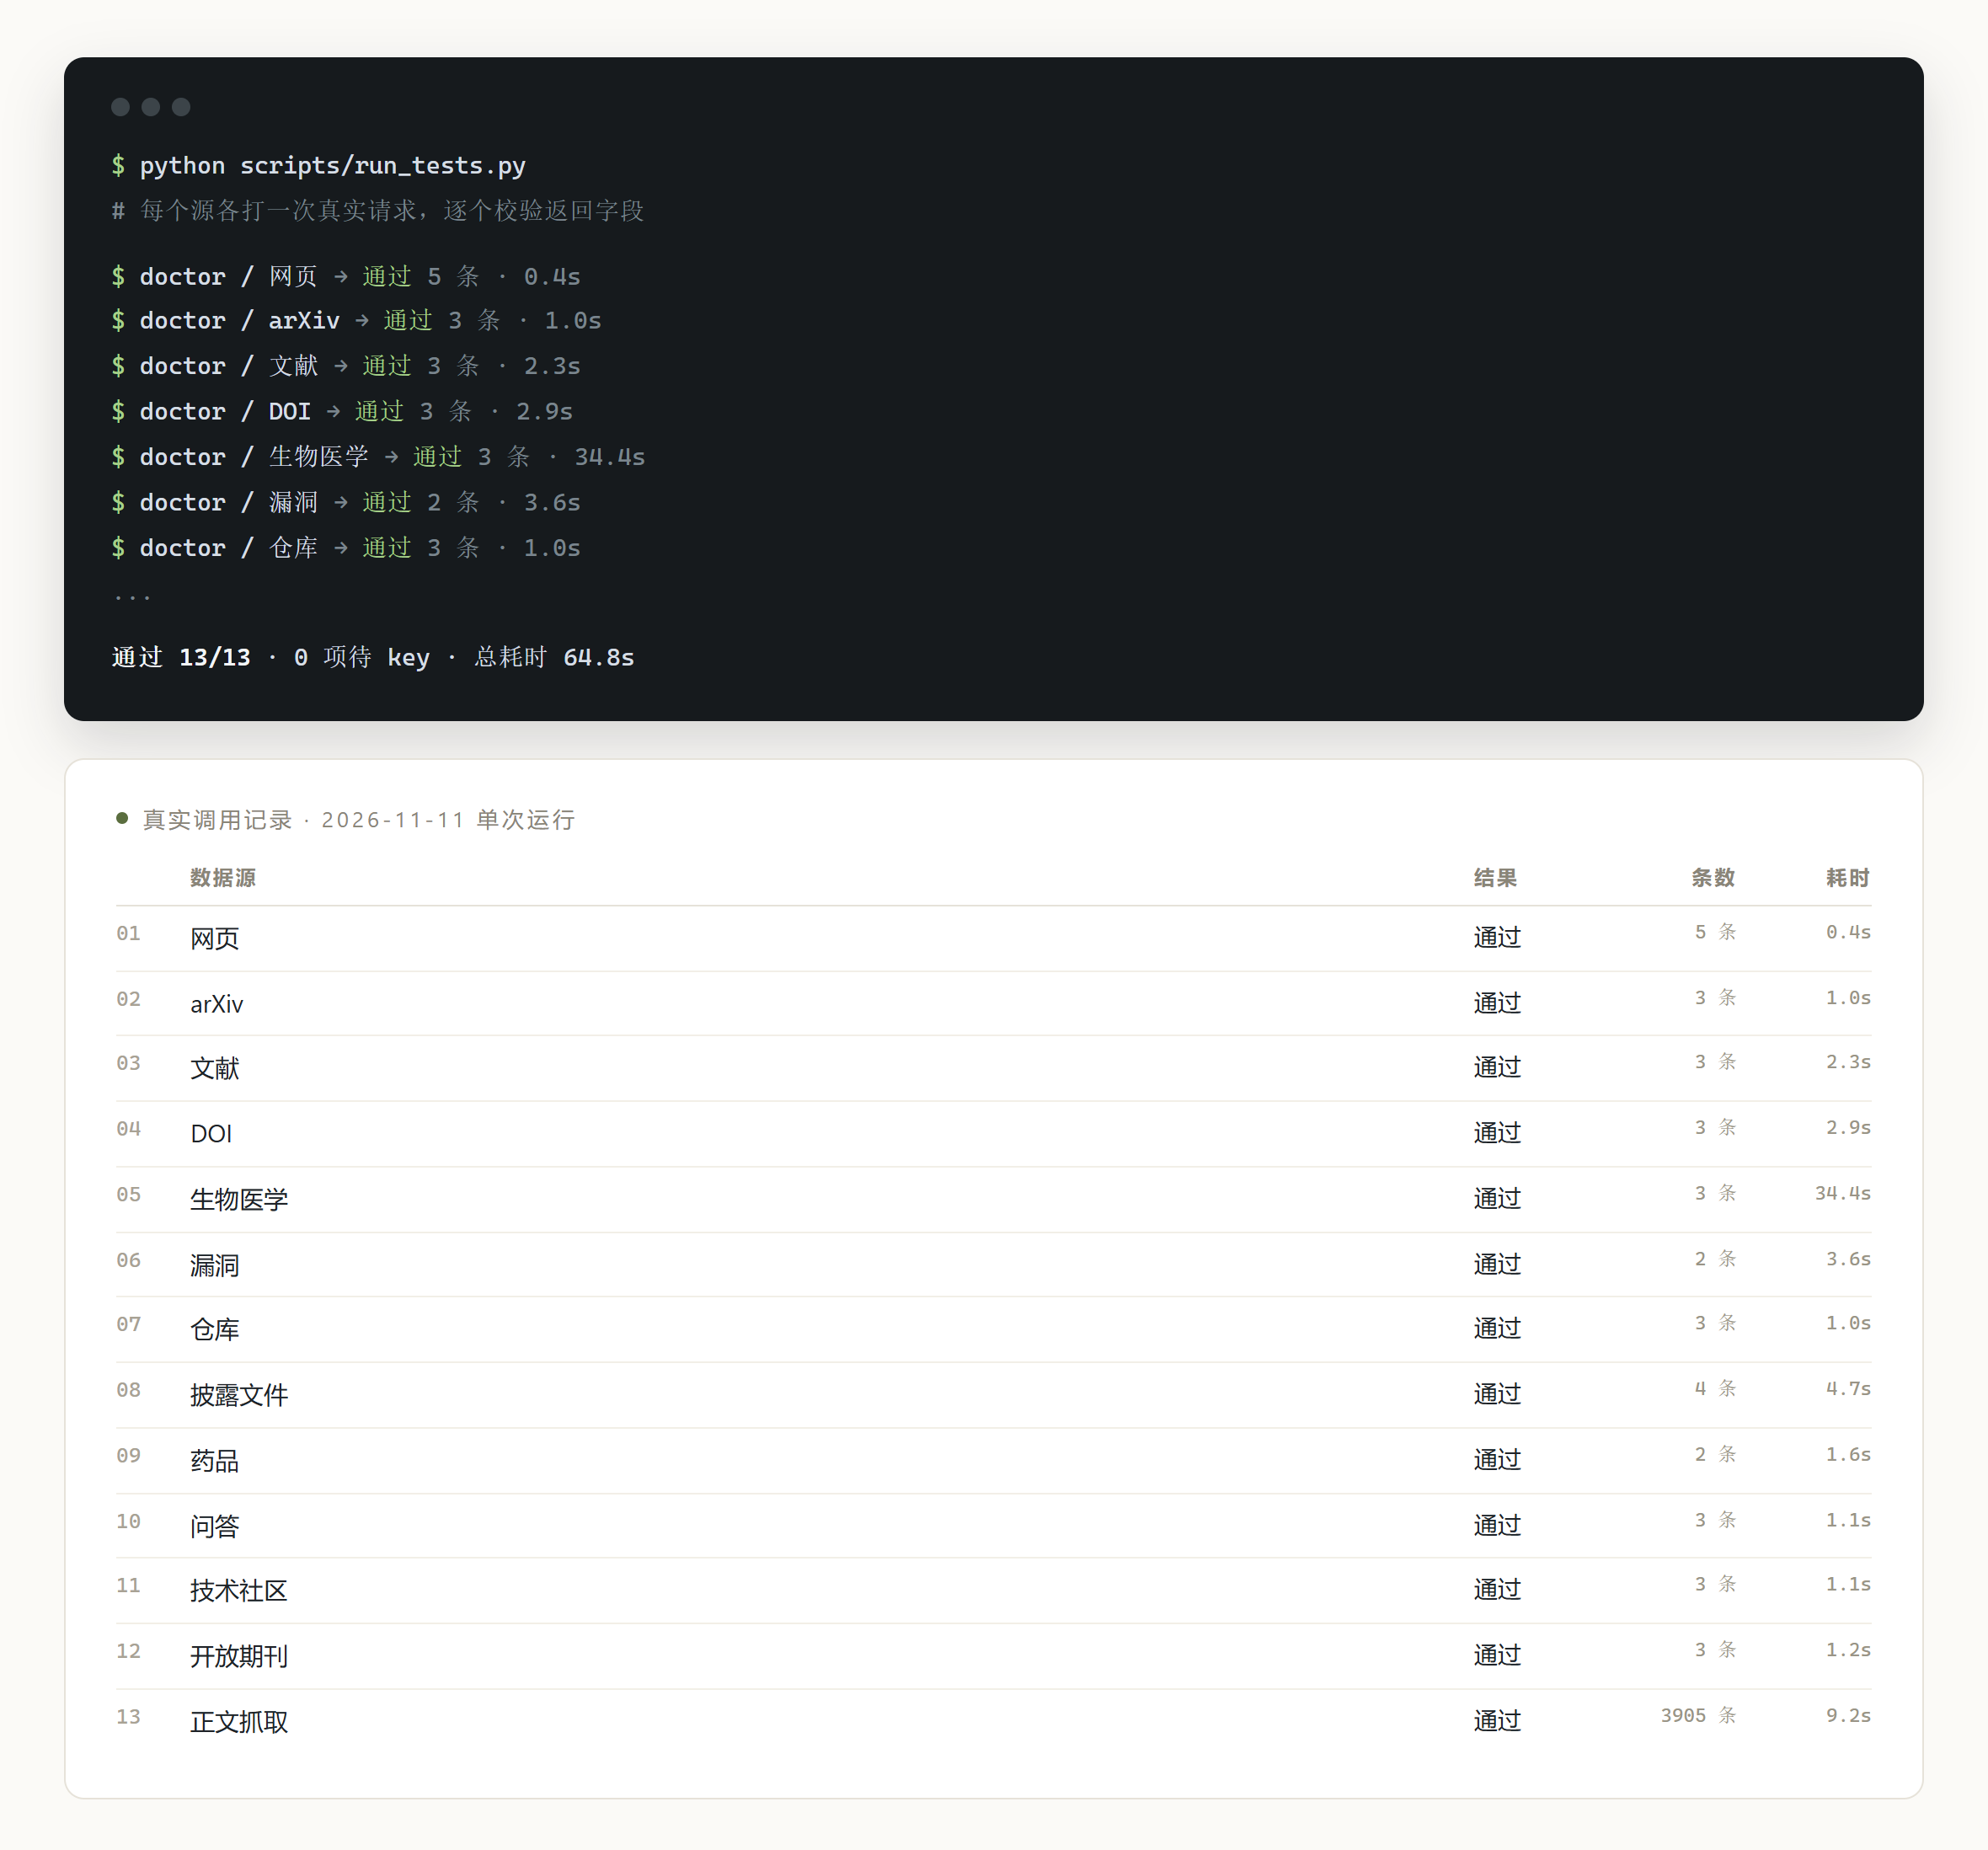
先用 run_tests.py 打一遍真实请求、把 JSON 存下来,再由 make_shots.py 用这批数据渲染成画面。图里的条数、耗时、标题、来源域名,一个字没改。
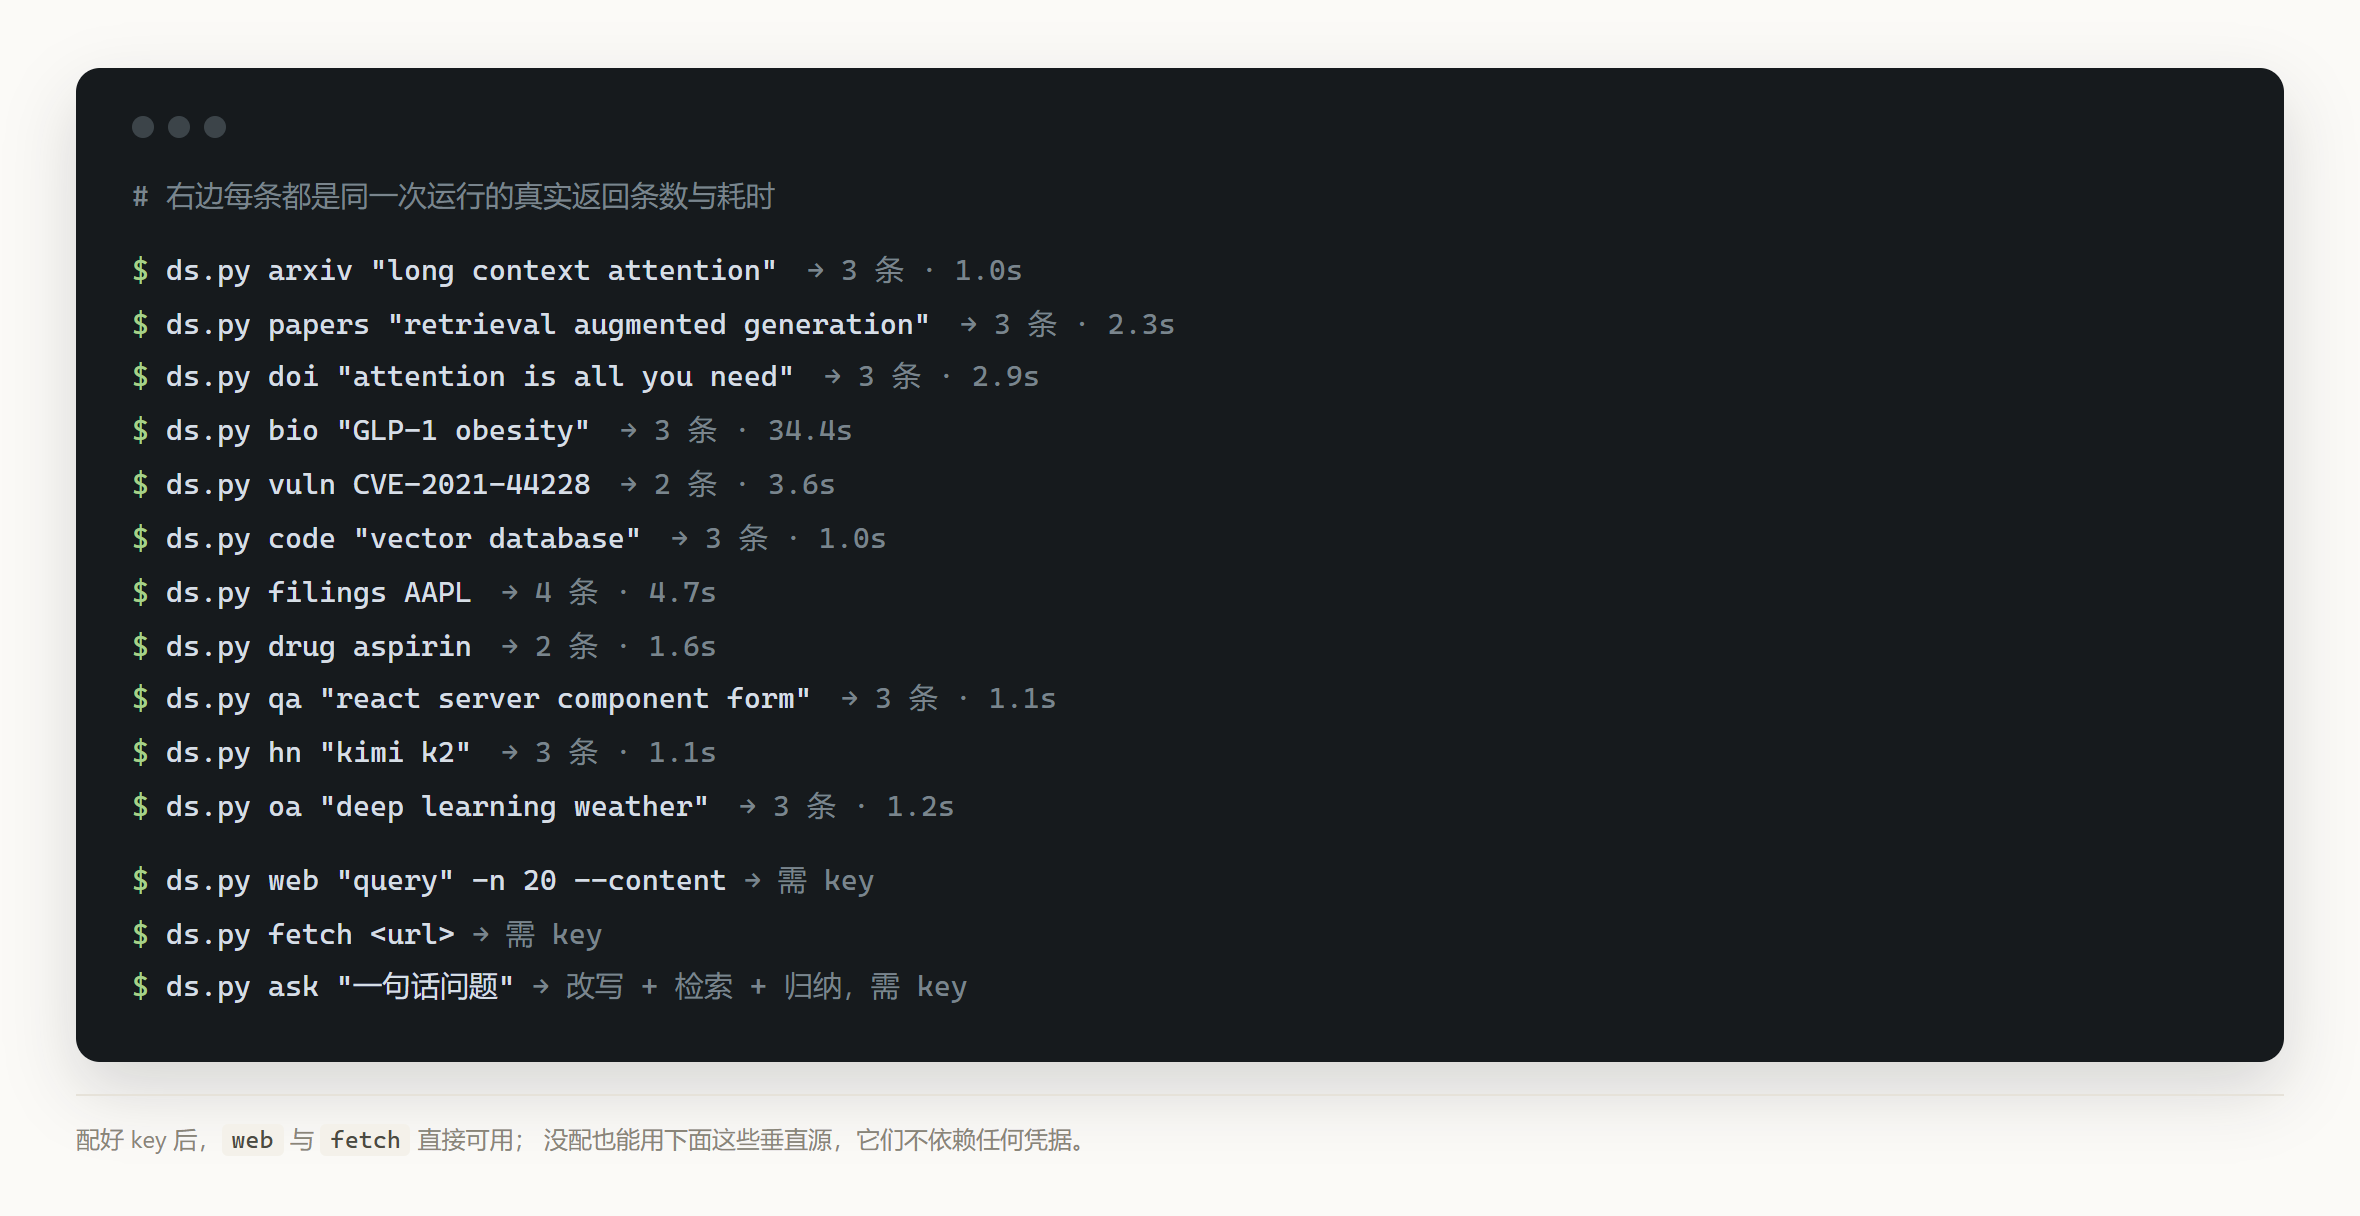
web 与 fetch 就能用;不配也能用下面这些垂直源。一个脚本,全部动作
# 配一次 key,写进本地 .env(不进代码、不进包)
echo 'DEEPSEEK_API_KEY=你的key' > ~/.workbuddy/skills/deep-search/.env

DS=~/.workbuddy/skills/deep-search/scripts/ds.py

python $DS doctor                       # 自检:13 项逐个探活
python $DS web "宁德时代 2026 三季报" -n 5   # 搜索
python $DS web "query" --content        # 搜索并带正文
python $DS fetch <url>                # 整页转 Markdown
python $DS ask "GLM-5.3 上下文窗口多大"   # 改写 → 检索 → 归纳

# 免 key 的垂直源
python $DS papers  "retrieval augmented generation"
python $DS vuln    CVE-2021-44228
python $DS filings AAPL
python $DS bio     "GLP-1 obesity"
检索算符写在 query 里,直接透传
| 算符 | 例子 | 作用 |
|---|---|---|
| site: | DeepSeek site:github.com | 限定站点,多个用 OR 连 |
| -site: | DeepSeek -site:example.com | 排除站点 |
| "…" | DeepSeek "exact phrase" | 精确短语 |
| - | DeepSeek -advertisement | 排除含该词的页 |
| lang: | DeepSeek lang:zh,en | 限定语言 |
| after: / before: | DeepSeek after:2025-01-01 | 限定发布时间 |
钱花在哪,怎么省
搜索和抓取都按成功调用计费,失败、空结果、超时不计。垂直源全部免费。
| 动作 | 消耗 | 单次成本 |
|---|---|---|
| web / fetch | 1 次成功调用(每千次 5 元) | 约 0.005 元 |
| 生成一份简报 | 3 次搜索 + 1 次模型归纳 | 约 0.03 元 |
| 论文 / 漏洞 / 财报等 | 不产生费用 | 0 |
web,直接走垂直子命令。查 CVE 用 vuln、查论文用 papers,返回的字段更准,还不要钱。三个真实问题,都写进代码了
一、模型只吐推理过程,正文是空的
这两个可用模型(deepseek-flash、deepseek-v4-pro)都是推理模型,会先花 token 写 reasoning_content。第一次生成简报时 max_tokens 设了 2600,结果预算全被推理吃掉,content 回来是空字符串,解析 JSON 自然失败。
现在预算提到 8000,并且在代码里区分「没内容」和「有推理没正文」两种情况 —— 后者会明确告诉你预算不够,而不是假装成功。
二、连续角标会黏成一串数字
把 [18][34] 转成上标后,视觉上变成「1834」,还有孤零零一个「14」掉到下一行。换成带浅底的小标签,并在句读前保持同行,问题才消掉。
三、表格加了「不跨页」反而更难看
给事实表格设 break-inside:avoid 之后,整块跳到第二页,第一页留下半页空白。改成打印时三列紧凑排布、允许自然分页,A4 才是 4 页而不是 5 页带窟窿。
做不到的事,写在前面
不是爬虫。每次调用只发 1–3 个请求,没有队列、没有并发抓取设计。
不读扫描件。
fetch 处理的是页面正文,PDF 里的图片和公式拿不到。简报会漏。材料不足时它会标
insufficient 并说明搜到了什么,而不是编一段补上 —— 但这也意味着冷门名字的简报会很薄。没有实时行情。股价、航班、天气这类接口没接,搜索到的也是二手报道。
八个文件,零第三方依赖
只用 Python 标准库。下载包不含任何凭据,打包脚本会解包复扫 sk- 串、key 赋值、Bearer 头,命中就删包中止。
SKILL.md触发词与决策流程scripts/ds.py搜索 / 抓取 / 11 个垂直源scripts/run_tests.py13 项验收,可随时重跑scripts/make_shots.py用真实返回渲染效果图scripts/package.py打包并反扫凭据references/sources.md字段含义与实测耗时.env.example凭据模板(值留空).gitignore挡住 .env 与产物
装到本地
# 解压到技能目录
unzip deep-search-skill.zip -d ~/.workbuddy/skills/deep-search

# 填自己的 key(不填也能用免 key 的垂直源)
echo 'DEEPSEEK_API_KEY=你的key' > ~/.workbuddy/skills/deep-search/.env

# 自检
python ~/.workbuddy/skills/deep-search/scripts/ds.py doctor