Remake · 自己生成,不是搬运
《张良拾履》五秒
我们自己复刻的一版
这一条从头到尾是 AI 生成的:拿原文片子里的一个画面当风格参考,喂给视频模型,生出一条 5 秒片段。它不替代原片,只是把「这套画风能不能被复现」这件事实测了一次。同一篇文章的六条原始片子,在原文原片页。
生成内容 · 画面非实拍、非原片,含平台 AI 水印
复刻
AI 生成 · 我们自己做的
|
《张良拾履》桥上扔鞋
|
5.17s · 1344×768 · 24fps · h264 + aac · 414 KB
01
这条是怎么来的
没有复制原片的任何一帧像素,也没有做拼接剪辑。参考帧只当画风样本,真正的画面全部由模型重新绘制。
STEP 01
从原片抓一帧
用 ffmpeg 从原文《张良拾履》第 5 秒取一帧,缩到 1024 宽。仅作为风格参考,不进入成片。
ffmpeg -ss 5 -frames:v 1STEP 02
写死造型规则
把原片的画法拆成可执行约束:三头身、奶白圆脸、两道短眉一条嘴线、粉腮红、扁平纯色块、无描边、深褐夜景 + 暖黄灯笼 + 满月。
prompt · 12 条约束STEP 03
图生视频
参考帧 + 提示词一起交给模型,生成 16:9、5 秒、24fps。动作只要求小幅转身与前倾,不允许镜头运动。
minimax-video-h302
参考帧 vs 生成结果
左是原文原片的一帧(灰点),中间和右边是生成片的开头与结尾(绿点)。首帧几乎与原片重合是正常的——图生视频的第一帧本质就是对参考图的重绘,看不出差别恰恰说明画风抓准了。真正能看出模型自己画了东西的是末帧:张良已经俯身下去,原片那一帧里他还是站着的。
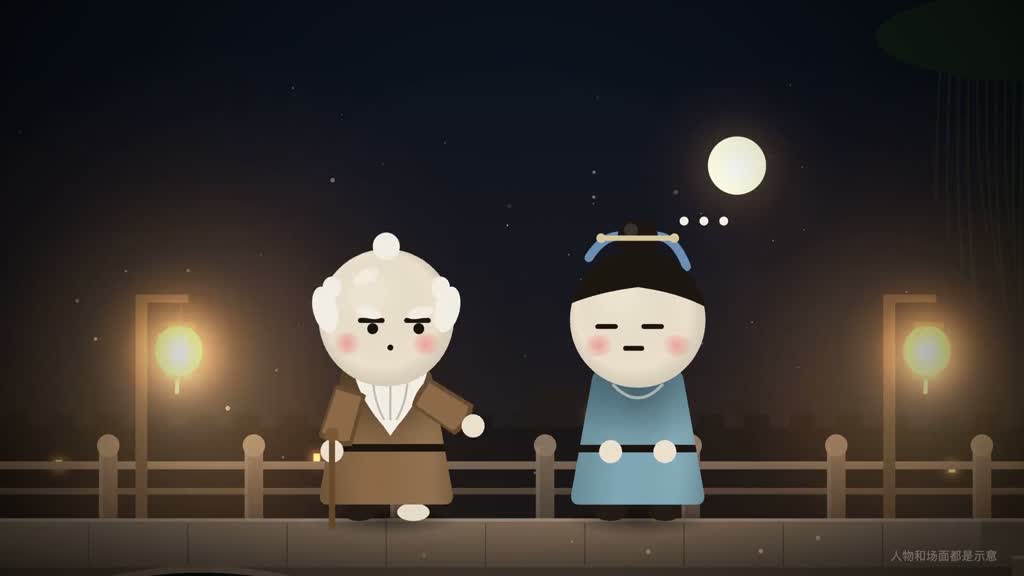
参考帧 · 原文原片
《张良拾履》00:05 · 1024×576
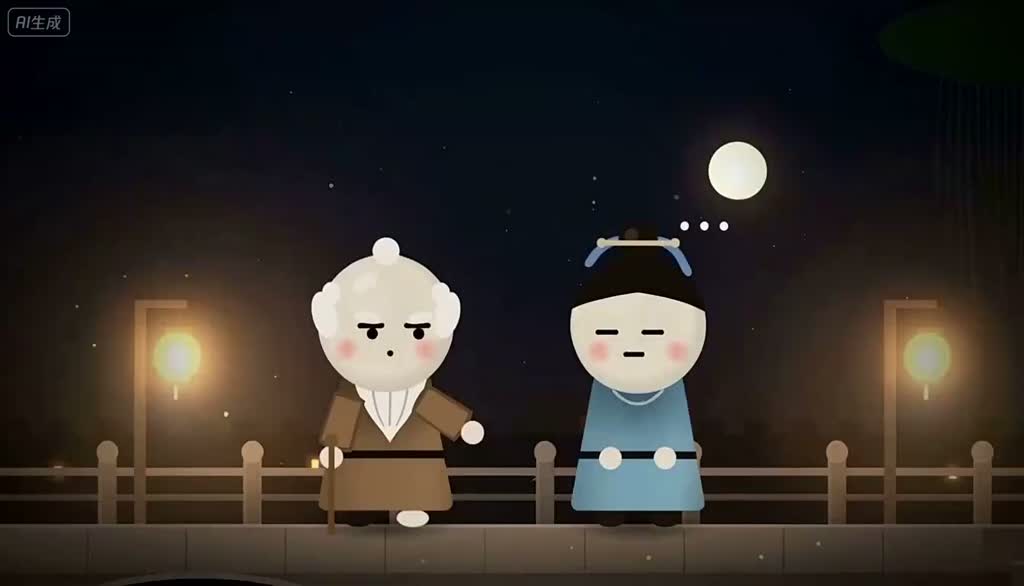
生成首帧
00:00 · 1344×768
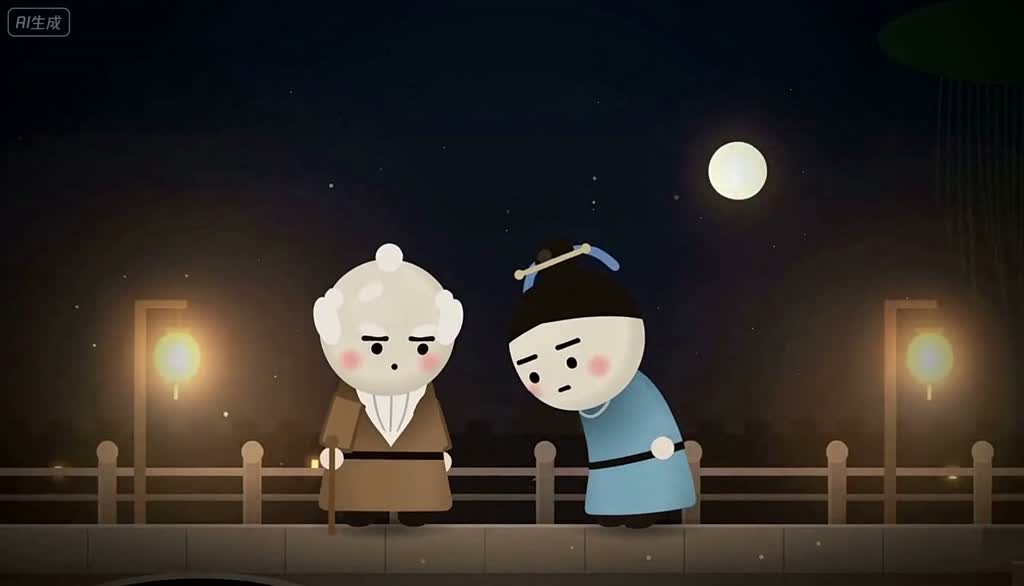
生成末帧
00:05 · 张良已俯身
03
成片参数
| 生成方式 | 图生视频(reference image → video) |
|---|---|
| 模型 | minimax-video-h3 |
| 提示词 | 1344×768 约束版,含造型 12 条、场景 6 条、禁项 3 条 |
| 分辨率 / 帧率 | 1344 × 768 · 24 fps |
| 时长 | 5.17 s |
| 编码 | H.264 + AAC(音频轨由模型强制附带,已静音处理) |
| 文件 | 424,313 字节 |
| sha256 前 16 位 | 5d399694cbe76204 |
| 成本 | 约 50–100 credits / 5 秒 |
04
做到了什么,没做到什么
✓ 复现成功的部分
- 画风对得上:三头身比例、圆脸简笔五官、粉腮红、扁平色块都没跑偏
- 氛围守住了:深褐夜色、两盏灯笼光晕、右上满月、空中细光点
- 有真实动作:张良从直立到俯身,老人保持站立,5 秒内动作连贯不崩
- 构图稳定:镜头全程不动,没有出现推拉摇移
- 没有文字幻觉:画面里没冒出假字幕或乱码
✗ 做不到 / 打了折扣
- 只有 5 秒,原片是 250 秒。这不是缩水版,是另一个东西——一个镜头
- 没有字幕系统。原片的 47 句文案、54→68px 字幕,这里一句都没有
- 没有配音与音效。音频轨是模型附带的,无实际内容
- 细节密度低:原片的栏杆雕纹、宫墙砖缝、衣袖褶皱,生成版基本抹平了
- 带平台水印:左上角「AI生成」四字是模型输出自带,我没裁
- 不能直接连续生成成片——长片仍需逐镜头生成再拼接,成本按秒线性增长
一句话结论:这套画风可以被复现,但复现的是「一帧的气质」,不是「一部片子的工程」。原文那套 skill 真正的价值在分镜、文案、字幕节奏和 250 秒的调度,不在单帧好不好看。
← 回原文原片页,看六条完整片子