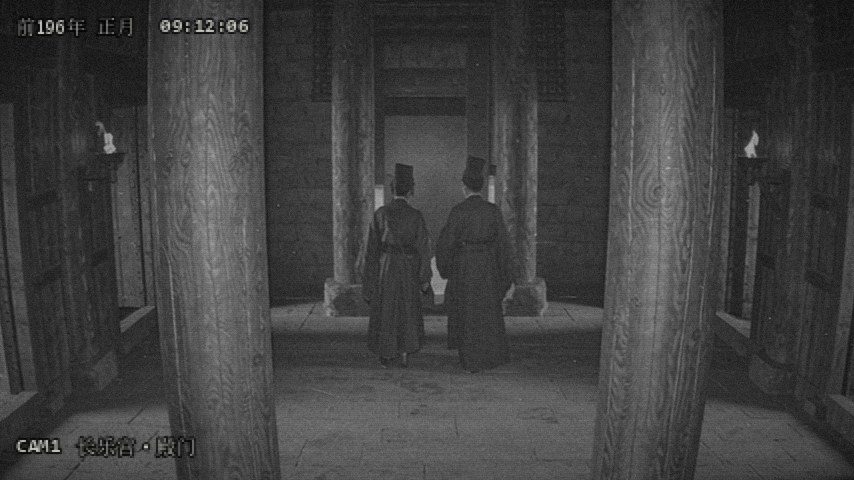
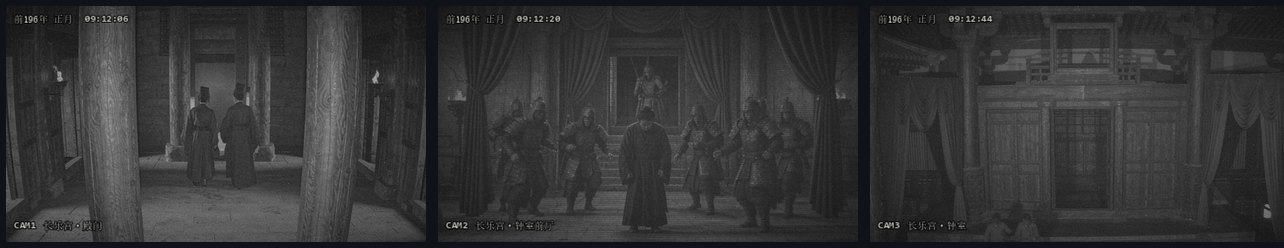
机位不动,黑白,左上角一行日期时间,左下角一行机位名加地点。好笑的不是「韩信被拍到」,是你会忍不住想:谁装的?硬盘存了二千多年还没坏? 我们把这套流程整个跑了一遍,成片就在下面,三机位,带跳秒。
公元前 196 年正月,长乐宫钟室。三段录像,三个机位,中间跳了几次秒——像从一卷旧硬盘里挑出来拼的。 按原文那句话办:关键动作略过,只留前因和后果。
源材料是公众号「涌现AI笔记」那篇《古代监控视频,这个 skill 可以一键搞定》。里面点名的仓库叫
retro-cctv-video,作者 0xMomo-NGClubs,MIT 协议。它不是一条提示词模板,是一整套制作流程,外加一组本地后期脚本。
给一个历史事件或虚构故事,走完参考拆解、关键帧、提示词、生成、后期、验收。生成服务可换,默认给的是 RunningHub 上的 MiniMax H3 图像参考工作流,也能换 Seedance 2.0 / 2.5 或自接接口。
已有素材只想调时间地点的字号、模糊程度、画面色调,就直接进后期,不必重跑视频模型。原文特意说了一句:这一条挺省钱。
SKILL.md 里攒了一堆返修返出来的检查项。就算不用它的脚本,这些坑也值得抄一遍——见下面第 5 节。
原文把流程压缩成四步。我们这次也是照这个顺序走的,每一步的产物都留在下面的下载区。
第二步最容易被跳过,也最要命。原文举例:人物慌张不能只写「很慌」,得写成上前、伸手、够不着、退回来、回头看门口—— 远景里能看清,模型也演得出来。道具要单独记一行:几件、什么材质、在谁手上、被哪只手碰过、最后去哪了。
OSD 不是在视频上盖一行字幕。它是在一张 854×480 的透明层上,把日期、时间、机位号、地点一个一个画出来:
| 项 | 原文规范 | 本次等效做法 |
|---|---|---|
| 字格 | 数字/英文 VCR OSD Mono,16×24;中文 GNU Unifont,24×24 | 本机无这两款字体,改用小字号等宽 + 宋体在 427×240 半层绘制,NEAREST 放大 2 倍得到硬边点阵感 |
| 轮廓与字面 | 1 像素黑轮廓,字面用偏灰的白 | RGBA 层先画 stroke_width=1 黑描边,再画 #D4D4CE 灰白字面 |
| 软化 | 约 0.45 个原生像素 | 整层放大后 GaussianBlur(0.45),只作用于字层 |
| 拖影 | 补一道很淡的水平拖影 | 字层右移 2px、alpha 压到 12% 叠在底层 |
| 画面 | 只软化字,不动画面 | 底片只做降对比、暗角、扫描线、噪点;不加整片高斯模糊 |
| 节奏 | 中间跳过几次秒,像从不同时段剪出来的 | 三机位切换 + 段内跳秒,切换帧加横向撕裂与短暂掉电平 |
原仓库的两条命令,后期与验收分开:
python scripts/cctv_post.py render --project project/postprocess.json \
  --out project/outputs/final.mp4 --work project/work/post

python scripts/cctv_post.py verify project/outputs/final.mp4 \
  --audio-source project/premix.mp4
verify 核对总帧数、时长、能否完整解码、音轨码流哈希。仓库里记过一次验证结果:1280×720、24fps、896 帧、37.333333 秒。
SKILL.md 里最值钱的其实是这几条。不用它的脚本,也该抄进自己的检查表:
| 坑 | 为什么会毁掉监控感 |
|---|---|
| 人物画太大 | 远景里剧情不成立,观众会当成剧情片而不是「碰巧拍到」 |
| 石头数量前后对不上 | 道具账本没记,跨镜头穿帮,一眼假 |
| 破碎效果像泡沫 | 材质写错,模型按塑料演 |
| 为强调动作把镜头推近 | 摄像头不该有情绪,一推近监控感立刻没了 |
| 整片加模糊做旧 | 字糊人也糊,像滤镜不像录像 |
按实验室一贯的口径,把做得到的和做不到的都摊开:
| 环节 | 原仓库 | 本次 |
|---|---|---|
| 干净素材 | RunningHub / MiniMax H3 图像参考工作流,或 Seedance 2.0 / 2.5 生成视频 | 未接生成服务。用 3 张图像模型生成的关键帧做固定全景底片,本地做极缓推镜与信号劣化 |
| OSD 后期 | cctv_post.py render + VCR OSD Mono / GNU Unifont | Python + Pillow 按同一组规范重写透明层绘制、软化、拖影、叠回 |
| 画质处理 | 只软化字,不动画面 | 一致:底片只降对比、加暗角/扫描线/噪点,无整片模糊 |
| 音轨 | 混音后校验码流哈希 | 程序化生成电流底噪(白噪 + 50Hz 嗡鸣 + 偶发脉冲),无语音无配乐;未做哈希对照,改用 ffprobe + 全帧解码校验 |
| 验收 | cctv_post.py verify | 等效:核对帧数 / 时长 / 分辨率 / 编码 / 逐帧可解码,结果写进 qc.json |
所以这页展示的是按公开规范做的本地等效复刻,不是原仓库跑出来的官方产物。 三张底片由图像模型生成、右下角水印已在裁切环节去掉;OSD 字体是点阵模拟,不是原字体。 真要一字不差地复现,还是得装原仓库、接上生成服务。
git clone https://github.com/0xMomo-NGClubs/retro-cctv-video.git \
  ~/.codex/skills/retro-cctv-video
装到支持 SKILL.md 的环境里,然后说人话就行:
用 $retro-cctv-video,把「一个人搬重箱子」的故事做成老监控短片,
固定全景,时间和地点用柔化点阵字样。

用 $retro-cctv-video,复用现有视频,只调整监控时间和地点的字号与模糊程度。成片、关键帧联系表、后期参数、分镜因果链、验收结果和这份页面的说明,全部放在这一目录下。
这一页已经挂进 /lab 的 skills实验室,索引里也能找到。 那边还有十几个跑完的 Skill 实验:文章转视频、直播转文字、白板动画、HTML 幻灯片、画风插画矩阵、设计物料套件…… 每个都能看成品、看做法、看用的是哪个 Skill。
retro-cctv-video,MIT。本页所有画面均为虚构重演,不具备取证或新闻证据效力。