《生成式人工智能》读后:AIGC不是生成内容,是把内容生产变成工程
阅读方式:微信读书网页版,从版权页翻到参考资料,共 275 屏、29 节、6 分 20 秒。
这批 AI 书里,这本是结构最"教材"的一本:从产业版图讲到模型原理,从能生成什么讲到能卖给谁,最后停在两个最硬的问题上——版权归谁,工作还在不在。
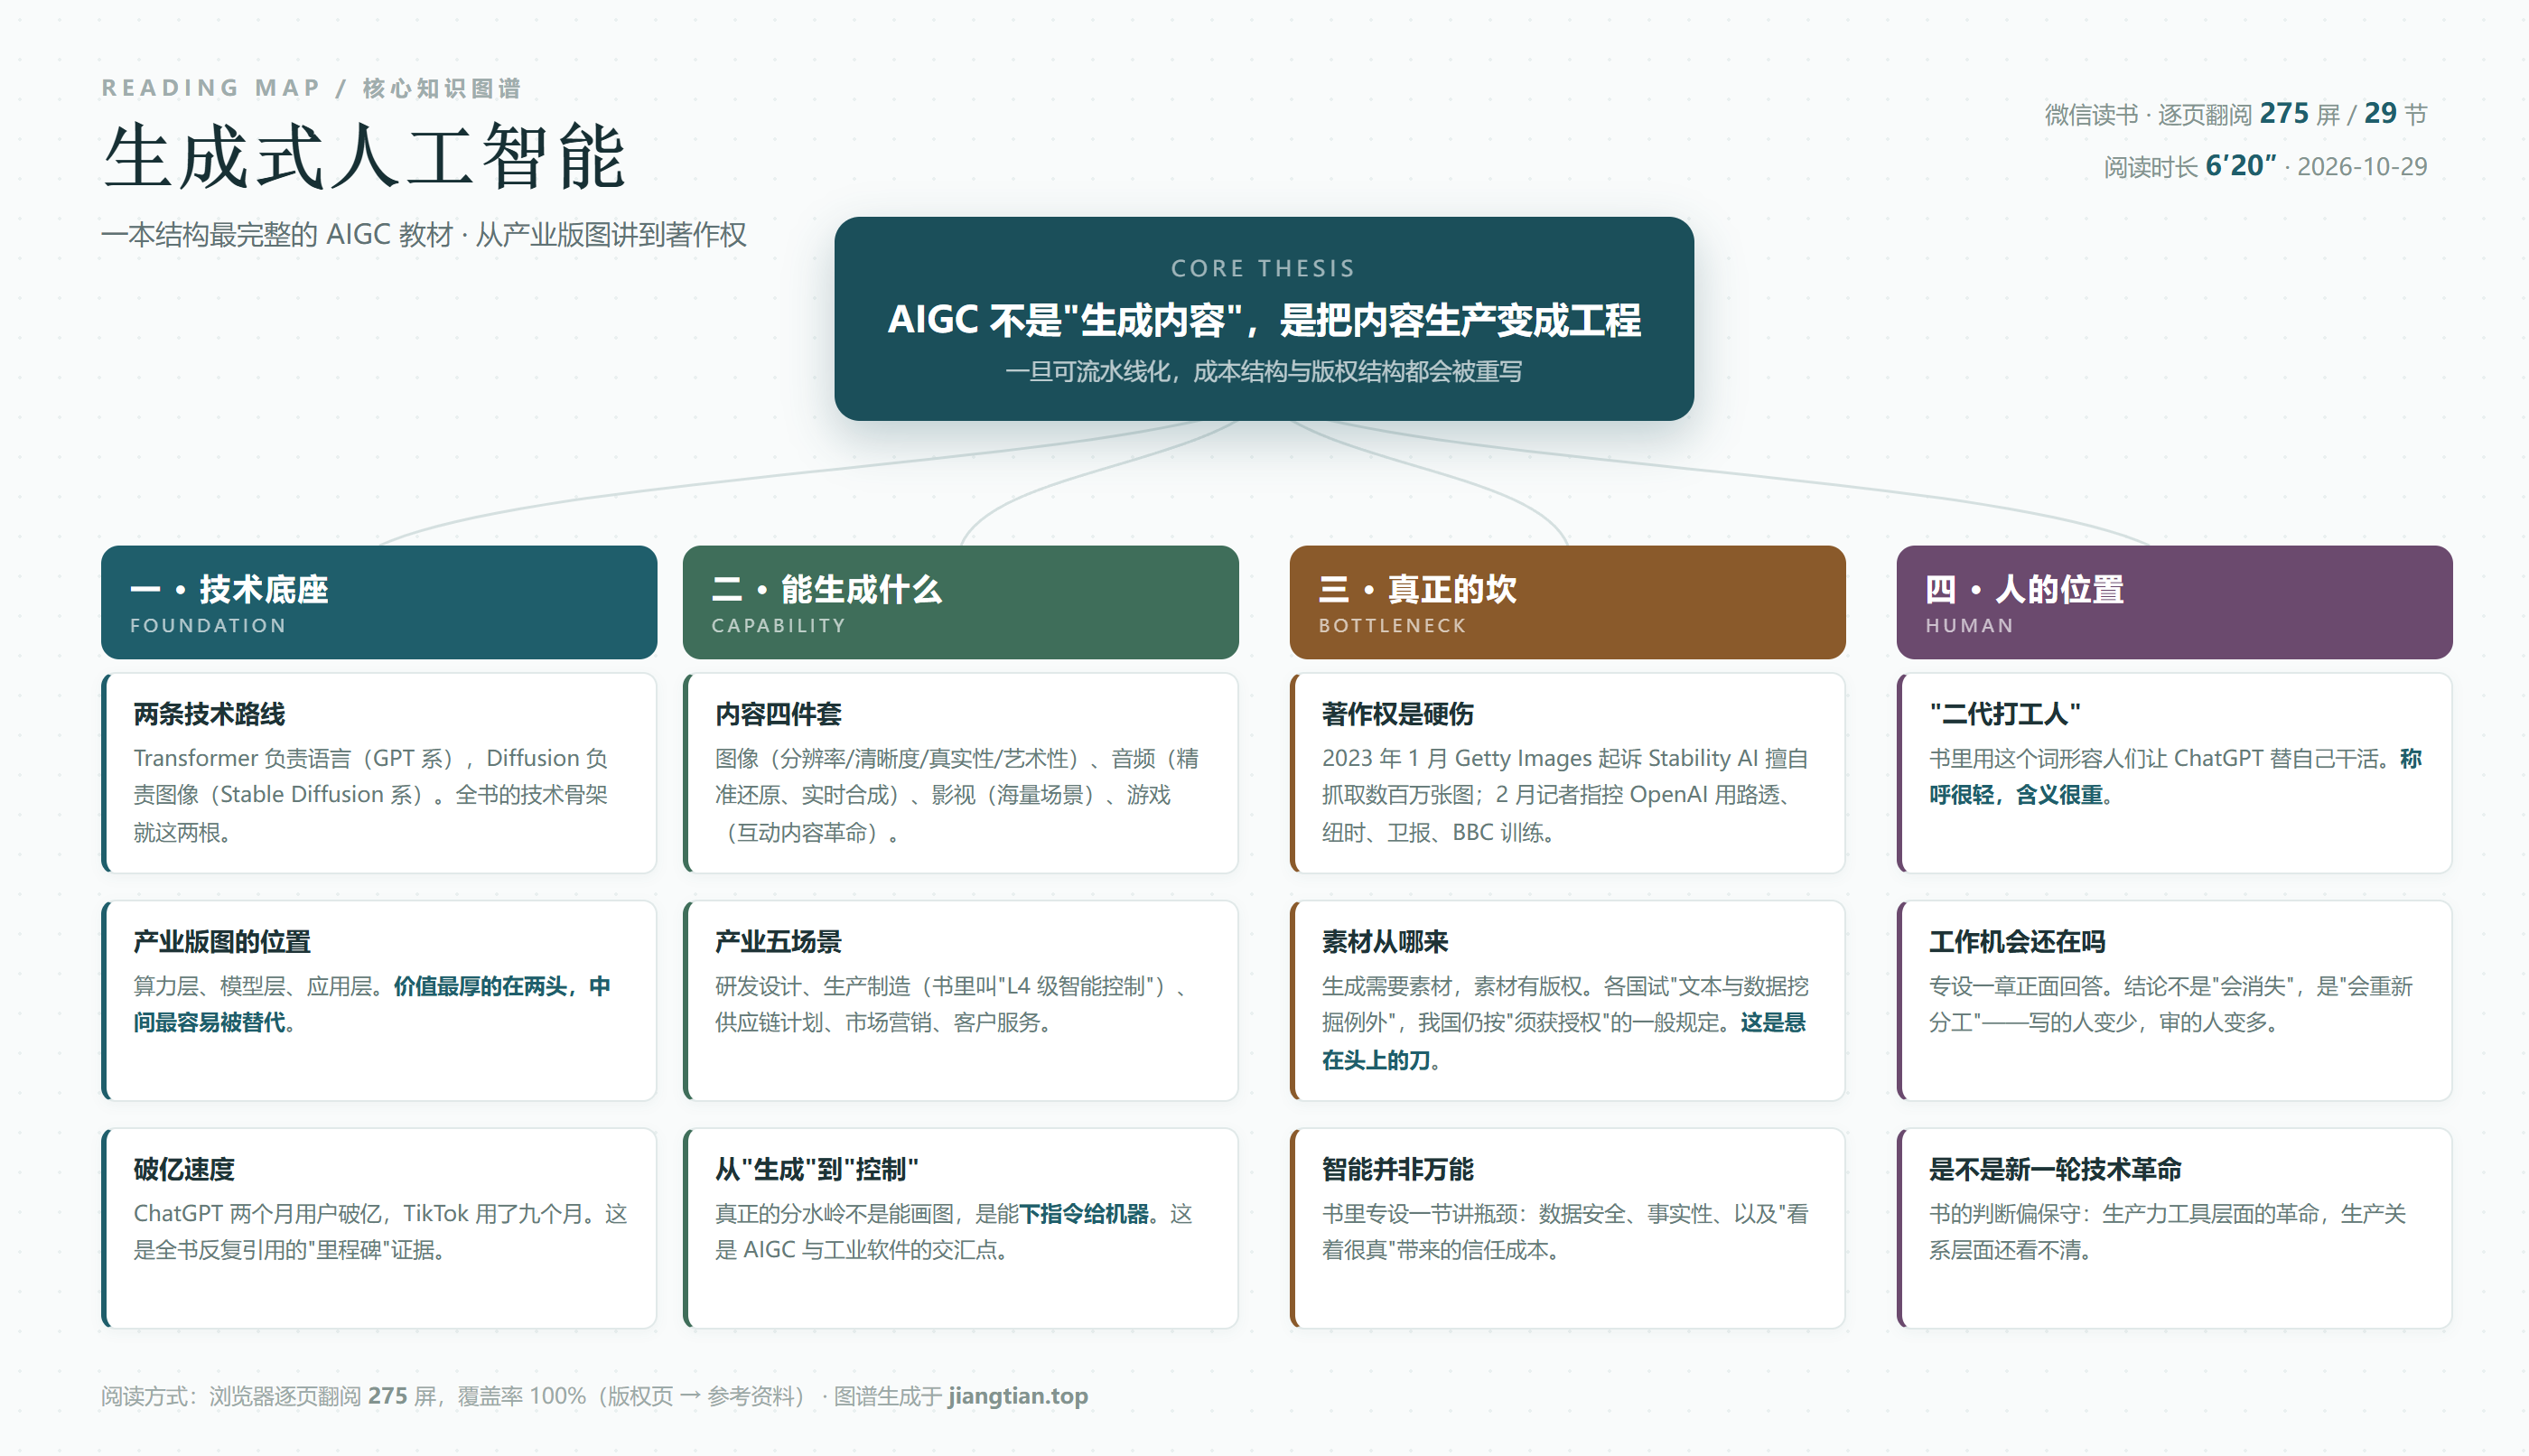
读完的最大收获不是知道了 AIGC 能画图能作曲,而是明白了一件事:AIGC 的实质不是"生成内容",是把内容生产变成了工程。 一旦可以流水线化,成本结构和版权结构就都得重写。
一、两根技术支柱,撑起全书
全书的技术部分只讲了两条路线,讲得很清楚:
Transformer 管语言,GPT 系列是它的后代,靠注意力机制处理标记序列;Diffusion 管图像,Stable Diffusion 那一路,靠逐步去噪从随机噪声里"显影"出画面。
书里对 ChatGPT 的问世用了一个很有画面感的说法:"里程碑式的存在"。它引用的证据是速度——两个月用户破亿,而 TikTok 用了九个月。这个对比在 2023 年被反复引用,现在看依然能说明问题:它不是一个新产品,是一次集体认知的突然对齐。
二、功能清单:从"内容"到"控制"
第三章是全书篇幅最大的一章,按能力铺开:
内容侧——图像(讲分辨率、清晰度、真实性、艺术性四个维度)、音频(精准还原、实时合成)、影视(海量场景)、游戏(互动内容革命)。
产业侧——研发设计、生产制造、供应链计划、市场营销、客户服务。其中"生产制造:L4 级别的智能控制"这个提法最有意思:它把自动驾驶的分级逻辑迁移到了制造业。
我认为全书真正的分水岭就藏在这里:能画图只是"生成",能下指令给机器才是"控制"。 前者是内容行业的工具,后者是工业软件的替代品。后者的商业价值大一个量级,但书里着墨反而少——这是它的遗憾。
三、最有价值的一章:著作权
大多数讲 AIGC 的书会绕开版权,这本没有。它把 2023 年那几场官司摆了出来:
2023 年 2 月,《华尔街日报》记者 Francesco Marconi 公开指责 OpenAI 未经授权,大量使用路透社、《纽约时报》、《卫报》、BBC 等媒体的文章训练模型,且未支付任何费用。
然后它给了各国做法的差别:一些国家试"文本与数据挖掘例外""计算机分析例外";我国按"使用他人作品应当取得授权"的一般规定处理,AIGC 生成过程中应当审查素材库是否存在受保护作品。
这段话的分量在于:它把 AIGC 从"技术问题"拽回了"产权问题"。 换句话说——你的模型再强,如果训练数据来路不清,商业化的那天就是被告的那天。
同章还有一节"智能并非万能",讲数据安全与事实性问题。作者没有吹,这很难得。
四、"二代打工人"与工作机会
书里有一句很有意思的话:很多人让 ChatGPT 帮自己干活,成了代替自己的"二代打工人"。
称呼很轻,含义很重——它点出了一个正在发生的事实:不是 AI 替代人,是人主动把活外包给了 AI,然后自己的角色从"生产者"变成"验收者"。
后一章"我们的工作机会还在吗"给了正面回答。结论不是"会消失",而是"会重新分工":写的人变少,审的人变多;执行的人变少,定义问题的人变多。
至于"AIGC 是不是新一轮技术革命",书的判断偏保守:生产力工具层面的革命已经发生,生产关系层面还看不清。 我认为这个保守是对的——2023 年下判断太早,2026 年看,它说的"看不清"依然成立。
五、核心知识图谱
六、一句话收尾
如果要给这本书一个定位:它是这批书里最适合当"参考书"的一本——覆盖面够全,观点不算锋利,但边界划得清楚。
而它留给我的最深一句话,是那句不起眼的"二代打工人":当所有人都有了实习生,真正稀缺的就不再是干活的人,而是知道该干什么的人。
阅读记录:微信读书网页版 · 逐页翻阅 275 屏 / 29 节 / 6 分 20 秒 · 覆盖率 100%
发表评论: