《Context Engineering for Multi-Agent Systems》读后:写提示词是在求它演一段,做上下文是给它整本剧本
阅读方式:微信读书网页版(中英对照),从版权页翻到附录 B,共 1042 屏、11 章、25 分 27 秒。 这是这一批里最硬的一本,也是最值得反复翻的一本。它讲的不是"怎么搭一个智能体",是"怎么让模型看懂你的世界"。
全书真正的主张只有一句话,但它把这句话推到了底:
写提示词,是在求它演一段;做上下文,是在给它整本剧本。
书里用的比喻很准——给演员一句台词,和给演员完整的剧本(含人物动机、舞台指示),是两回事。前者你是在"要求一次表演",后者你是在"设计这场表演,并告诉模型该怎么做"。
而这一句话背后,是角色的转换:你不再是提问者,你是导演。
一、五级台阶:绝大多数人卡在第二级
第 1 章最有用的部分,是把"上下文"拆成了五级。我第一次看到有人把这件事分层得这么清楚:
| 层级 | 形态 | 本质 |
|---|---|---|
| L1 | 裸提示 | 零上下文,一句话丢过去,全靠模型的默认理解 |
| L2 | 线性上下文 | 补一段背景文字。市面上多数"提示词技巧"停在这里 |
| L3 | 目标导向 | 交代目的、约束、验收标准,让它知道"为谁而写、写到什么程度算完" |
| L4 | 角色化 | 加入角色、立场、语气,输出开始有个性和判断 |
| L5 | 语义蓝图 | 不再是一段文本,而是结构化的场景模型:目标、参与者、关系、待完成的动作 |
这个分层最狠的地方在于它暗含了一个判断:L2 到 L4 都还在"用自然语言描述自然语言",只有 L5 换了表征方式。
你可以把 L4 写到极致——人设、语气、禁忌、示例都给全——但只要还是"一段话",模型就得在语义空间里自己找落点。而 L5 是把这个落点直接标出来。
二、L5 长什么样:借语言学的手,画一张"关系树"
书里的做法很聪明:它没有发明新框架,直接借了语言学里现成的东西——SRL(语义角色标注)。
SRL 干的事,本来就是"谁—做了什么—对谁"。书里把这个结构拿来当上下文的骨架,再把句子画成树(stemma),一个场景里谁对谁做了什么,一目了然。
然后它给了一个演示,任务是"写一句悬疑的话"。你看它给的输入:
TASK: Generate a single, suspenseful sentence.

SEMANTIC BLUEPRINT:
{
  "scene_goal": "Increase tension by showing defiance",
  "participants": [
    { "name": "Onyx",            "role": "Agent",           "description": "black cat" },
    { "name": "Red Ball",        "role": "Patient",         "description": "mysterious" },
    { "name": "Grandfather Clock","role": "Source_of_Threat","description": "ancient, looming" }
  ],
  "action_to_complete": {
    "predicate": "play with",
    "agent": "Onyx",
    "patient": "Red Ball"
  }
}

SENTENCE TO COMPLETE: "He then played with the..."
我读到这里有种被点醒的感觉。因为它干的事情,跟"写好提示词"完全不是一回事:
它没有告诉模型"要写得悬疑、要有张力、要用短句"。它告诉模型:这个场景里有一只黑猫(施动者)、一个红球(受动者)、一座老钟(威胁来源),目标是"用挑衅制造紧张"。
模型不需要猜风格,只需要把角色关系填进句子——而"老钟是威胁源"这个设定,天然就把悬疑感写进了结构里。
这就是 L5 和 L4 的真实差距:L4 是在描述氛围,L5 是在定义关系。 氛围靠形容词,关系靠结构。而结构不会跑偏。
三、玻璃箱:把"智能"做成可审计的流水线
从第 2 章开始,书进入工程部分。它用 MCP 搭多智能体,然后一路把这个系统加固成所谓"上下文引擎"(Context Engine)。
书里反复强调的一个词是 glass box(玻璃箱),对立面是 black box(黑箱)。它的原话大意是:很多人急于把 AI 当成一个黑箱来用——丢数据进去,期待好结果出来;而正确的做法是造一个透明可控的系统,让每一步都能追踪、每个决策都能审查。
落地上,引擎分四个阶段:启动(Initiation)→ 规划(Planning)→ 执行循环(Execution Loop)→ 收尾(Finalization)。每个节点都对应到具体的代码文件(engine.py、agents.py、registry.py、helpers.py、utils.py),流程图里的颜色和代码一一对应。
配套的三样东西值得单独记:
双 RAG。 它把知识分成两类——程序性知识(procedural,怎么做一件事,比如流程、方法论)和事实性知识(factual,是什么,比如产品参数、法规条文),分别建库。这个区分很实用:你问"报销怎么走"和问"报销上限多少",命中的根本不是一个库。
Agent Registry(名册)。 不是把所有 Agent 塞给编排器,而是维护一份可查询的名册:谁擅长什么、需要什么输入、产出什么格式。编排器按需调用。这其实就是"岗位说明书"的工程实现。
Summarizer(摘要代理)。 专门负责压缩上下文。书里把它单列一章(第 6 章),理由很实在:上下文越长越贵越慢,而大部分历史信息在下一轮已经没用了。摘要代理就是那个"把会议纪要写好再往下传"的人。
四、全书最诚实的一段:慢,是引擎在思考
第 8 章讲"面向现实的架构",里面有一段我几乎想整段抄下来。
它先说现象:跑示例时你会发现,执行一个复杂目标不是瞬时的,从提交任务到看到结果,可能要一分钟甚至更久。
然后它给了一个我读完愣了一下的解释:这不是效率低下,也不是出错,而是我们精心设计的多步骤推理过程必然产生的延迟。
原文那句更漂亮:"the 'slowness' is the sound of the engine thinking."(这种"缓慢",正是引擎思考的声音。)
接着它算了笔账:一个典型的三步计划,会触发至少 8 次 API 调用——检索、清洗、规划、执行、验证、记录,环环相扣。
这段为什么重要?因为它把"延迟"从一个"要优化掉的缺陷",重新定义成了"能力的价格"。你想让它想清楚,就得给它想的时间;你想让它一秒回,就得接受它只做了浅层匹配。
书里还顺手做了一个很漂亮的类比:ChatGPT、Gemini 这些平台,回答复杂推理问题也比回答简单问题慢——因为它们的内部架构,越来越像我们正在搭的这种多智能体、思维链系统:内部路由、工具使用、事实核查,用速度换准确性和可解释性。
同章另一个我很认同的设计是 policy(政策层)作为最终上下文。它列了五条原则,核心意思是:自动化的情境判断有边界,所以必须有一个高于模型的规则层,明确"什么能自动做、什么必须人批、什么永远不做"。
书里那句话说得比我好:政策是最终的上下文。 模型再聪明,也不该拥有"决定自己权限"的权力。
五、核心知识图谱
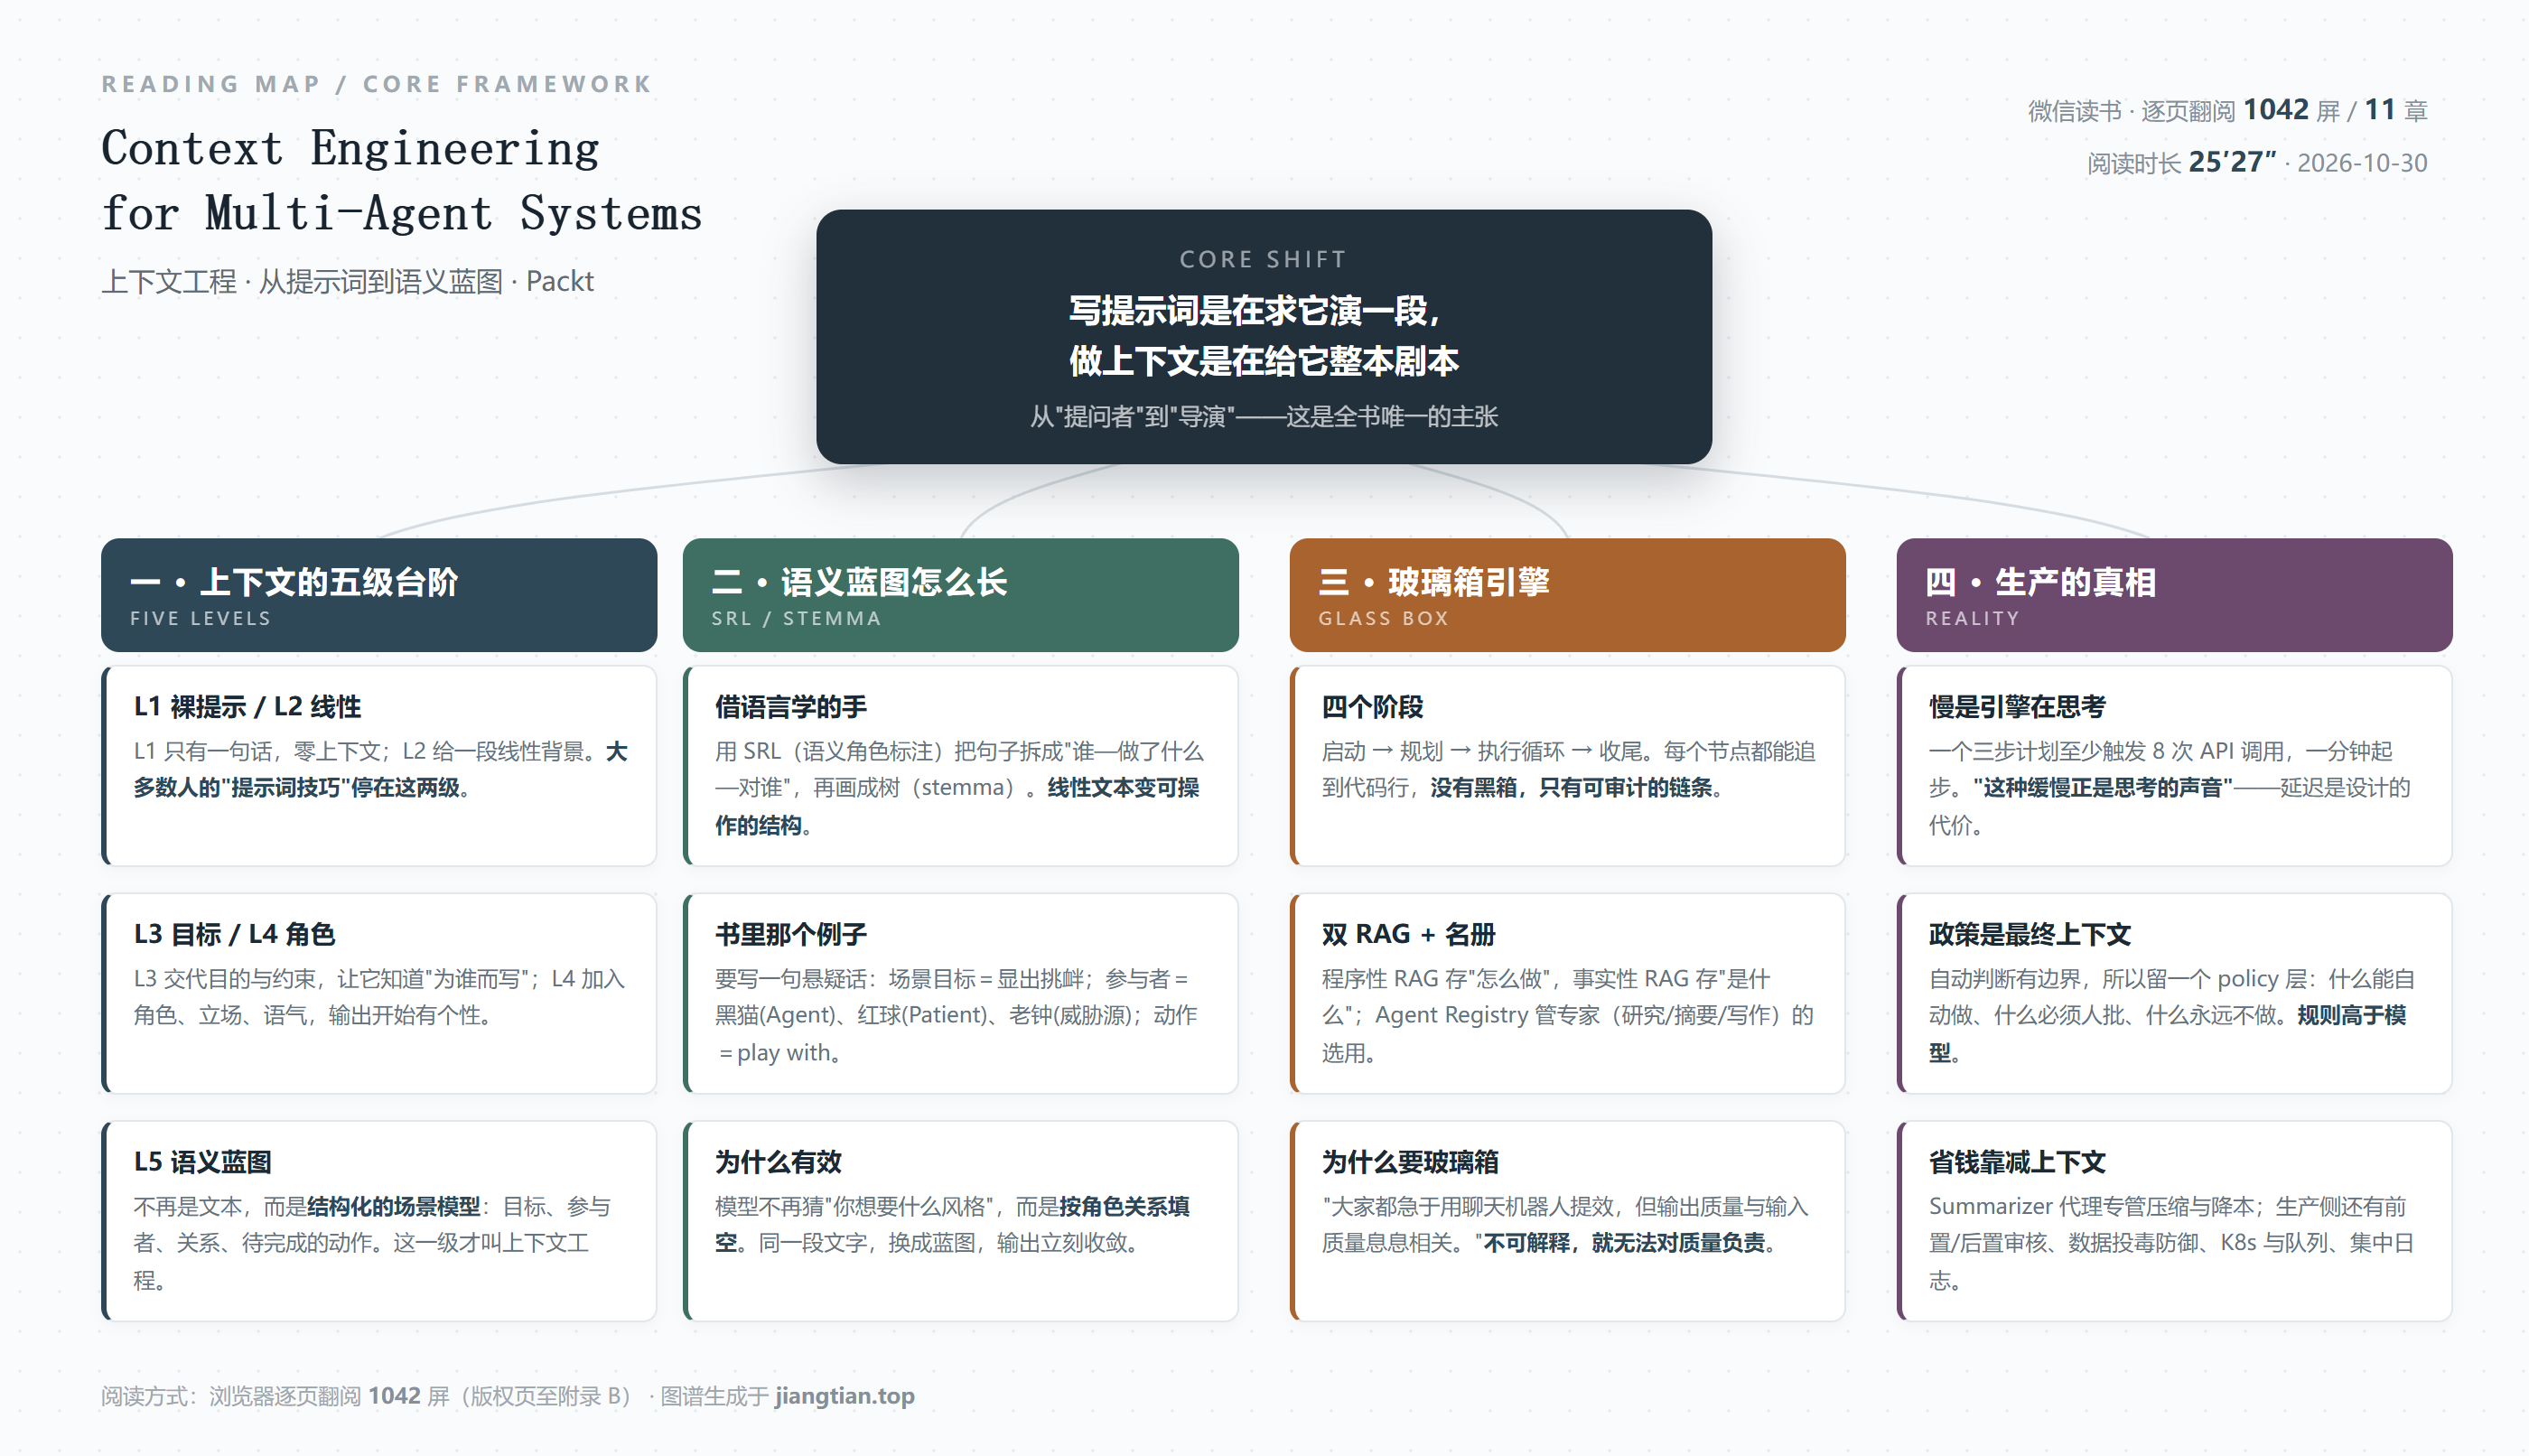
六、我的保留意见
第一,代码密度高到影响阅读节奏。 全书大量篇幅在贴 Python 代码——建索引、定义 schema、写校验循环、重构模块。如果你不跟着敲,很多章节会读得很空;如果跟着敲,1042 屏大概要读一周。它本质是一本"带解说的代码库",不是一本"讲道理的书"。
第二,技术栈绑得比较死。 向量库用 Pinecone、模型演示用 Gemini 2.5、协议用 MCP。这些选择本身没问题,但书里的实现细节跟这些具体产品强耦合,换栈就要重写。读的时候要有意识地把"设计意图"和"实现细节"分开。
第三,中英对照是双刃剑。 微信读书这版是中英逐段对照,好处是遇到术语能立刻看原文(这本书的术语翻译质量参差,"stemma"译成"树形图"、"glass box"译成"玻璃箱"都还行,但有些句子机翻痕迹明显);坏处是篇幅直接翻倍,1042 屏里有近一半是重复内容。
第四,它假设你已经会写代码、懂 RAG、用过 API。 前言里虽然给了硬件建议(双核 8G 起步、推荐 16G 或 Colab),但没给"不懂 RAG 怎么办"的路径。这本书的门槛,比它自己以为的高。
尽管如此,我还是认为它是这一批里信息密度最高、最值得二次阅读的一本。因为其他书在教你"做一个能演示的东西",这本在教你"做一个能负责的东西"。
七、一句话收尾
读完 1042 屏,我最想留下的是这个判断:
提示词的极限,是模型的理解力;上下文的极限,是你的表达能力。
前者你改不动,后者你随时能改。而所谓"上下文工程",说到底就是把"我心里想要的那个东西",翻译成模型能直接站进去的结构——不是描述它,是搭建它。
阅读记录:微信读书网页版 · 逐页翻阅 1042 屏 / 11 章 / 25 分 27 秒 · 覆盖率 100%(版权页至附录 B)
《Context Engineering for Multi-Agent Systems》 Packt Publishing · 中英对照版
发表评论: