《Generative AI with LangChain》第一章:生成不是魔法,是一堆能数出来的东西(试读)
阅读方式:微信读书网页版(中英对照),逐页翻到第一章末尾,共 126 屏、6 分 30 秒。 先说清楚:这本只读到第一章。 翻到 1.4 节"什么是文生图模型"就到头了,再点"下一章"页面不再前进——微信读书给的是试读范围。 所以这篇不是"全书笔记",是"第一章笔记"。我尽量把这一章里真正有用的东西榨干。
为什么还值得写?因为这本书的第一章,做了一件很多书没做好的事:它把"生成式 AI"从概念,落到了可数的数字上。
8.9 亿词、33 亿词、13 万亿 token、1.8 万亿参数、16 个专家、每专家 1110 亿。这些数字摆在一起,"大模型"这个模糊的词,突然有了重量。
一、判别与生成:一句话说清区别
书里区分生成模型的方式很朴素:判别模型回答"这是不是猫",生成模型回答"画一只猫"。
但我觉得更值得记的是它对"为什么是现在"的解释。这个问题被问过太多次,答案往往流于"算力变便宜了"。书里给的是三件事同时到位:
- Transformer 结构——让"并行处理长序列"成为可能,这是 2017 年那篇论文真正的遗产;
- 可堆的算力——GPU 集群让"加大模型"变成可执行的工程决策;
- 能吃下的语料——互联网提供了史无前例的训练素材。
三件事缺一件都不成立:没有结构,算力无处使;没有算力,结构跑不动;没有语料,模型学不到东西。
而"生成"这个动作本身,书里说得极其克制:一次次预测下一个词,重复到句号为止。
这句话有点煞风景,但它是理解后面一切的前提。你觉得它在写诗、在推理、在共情——底层都是同一个动作:给定前文,算下一个 token 的概率分布,挑一个,接上去,再来一遍。
二、Transformer 的两个半边,讲清了"为什么它能记住上文"
书里讲编码器—解码器结构的那一段,是我读到过最清楚的版本之一(虽然中英对照显得有些冗长)。
编码器:由多个相同的层堆成,每层两个子层——先过注意力机制,再过全连接前馈网络。每个子层后面都接残差连接 + 层归一化,所以每个子层的输出是"输入值 + 子层输出值",然后才归一化。
解码器:结构相同,但多一个子层——对编码器输出做多头注意力(MHA)。更关键的是,解码器的自注意力被改造过:用掩码挡住后面的位置,让第 i 个位置的预测只能依赖它之前已知的输出。
这两句话解释了 LLM 最基础的两个性质:
残差连接解决了"深"的问题。 一层层加下去,如果每层都只是"重新计算",深层的网络早就把浅层信息洗掉了。残差让信息可以"直通",这才堆得动几十上百层。
掩码解决了"因果"的问题。 生成必须是一个字一个字往后长,不能偷看答案。掩码保证训练时模型看不到未来——这跟人类的写作体验是一致的:你写下一句时,只知道上一句。
三、那些数字:GPT 是怎么"长大"的
这一节是第一章里我最想抄下来的部分,因为它把"规模"这件事讲成了时间线:
| 模型 | 书里给的规模数据 |
|---|---|
| GPT-1 | 基于 BookCorpus 训练,语料约 8.9 亿词 |
| BERT | BookCorpus + 英文维基,合计约 33 亿词 |
| GPT-4 | 约 1.8 万亿参数(是 GPT-3 的 10 倍以上);MoE,16 个专家,每个约 1110 亿参数;训练约 13 万亿 token,文本数据 2 轮、代码数据 4 轮 |
从 8.9 亿词到万亿级语料,中间隔了大概五年。这个跨度不是"进步",是"换了一个数量级"。
但真正有意思的不是总量,是 MoE。书里点出了它存在的理由:OpenAI 能在训练和推理成本上保持合理,靠的是用 16 个专家组成的混合专家模型来分摊。
翻译一下:参数总量很大,但每次推理只激活其中一部分专家。 所以"1.8 万亿参数"不等于"每次要算 1.8 万亿次"——它更像一个有 16 个科室的医院,你挂哪个科就去哪个科,不用全院会诊。
这解释了为什么大模型能同时做到"很大"和"负担得起":用稀疏换便宜。 而这套思路后来几乎成了行业标配。
顺带说一句书里的态度,我觉得挺专业:这些数字前面都加了"有消息称""据传"——因为 OpenAI 从来没公开过 GPT-4 的架构细节。一本技术书肯把"这是传闻"写清楚,比给出一个笃定的假数字要可信得多。
四、许可那一节,比技术更现实
第一章最后谈到文生图,也谈到了模型许可。这一段很短,但我觉得是整章最"成人"的部分。
书里的分类是三种:开源许可、专有许可、非商业许可。
然后它把取舍摊开说:开源许可促进了模型的广泛应用、协作与创新,惠及学术研究和商业开发;专有许可给企业独占控制权,但可能限制学术研究的进展;非商业许可限制商业用途、允许研究使用。而新的许可机制,目的就是缓解这些取舍。
最后那句我读了两遍:没有免费午餐。
这段为什么重要?因为大多数人读 AI 书只关心"模型能干什么",不关心"我能不能用、能不能商用、用了要不要开源"。而后者才是真正会让项目死掉的地方——技术问题能修,许可问题只能重做。
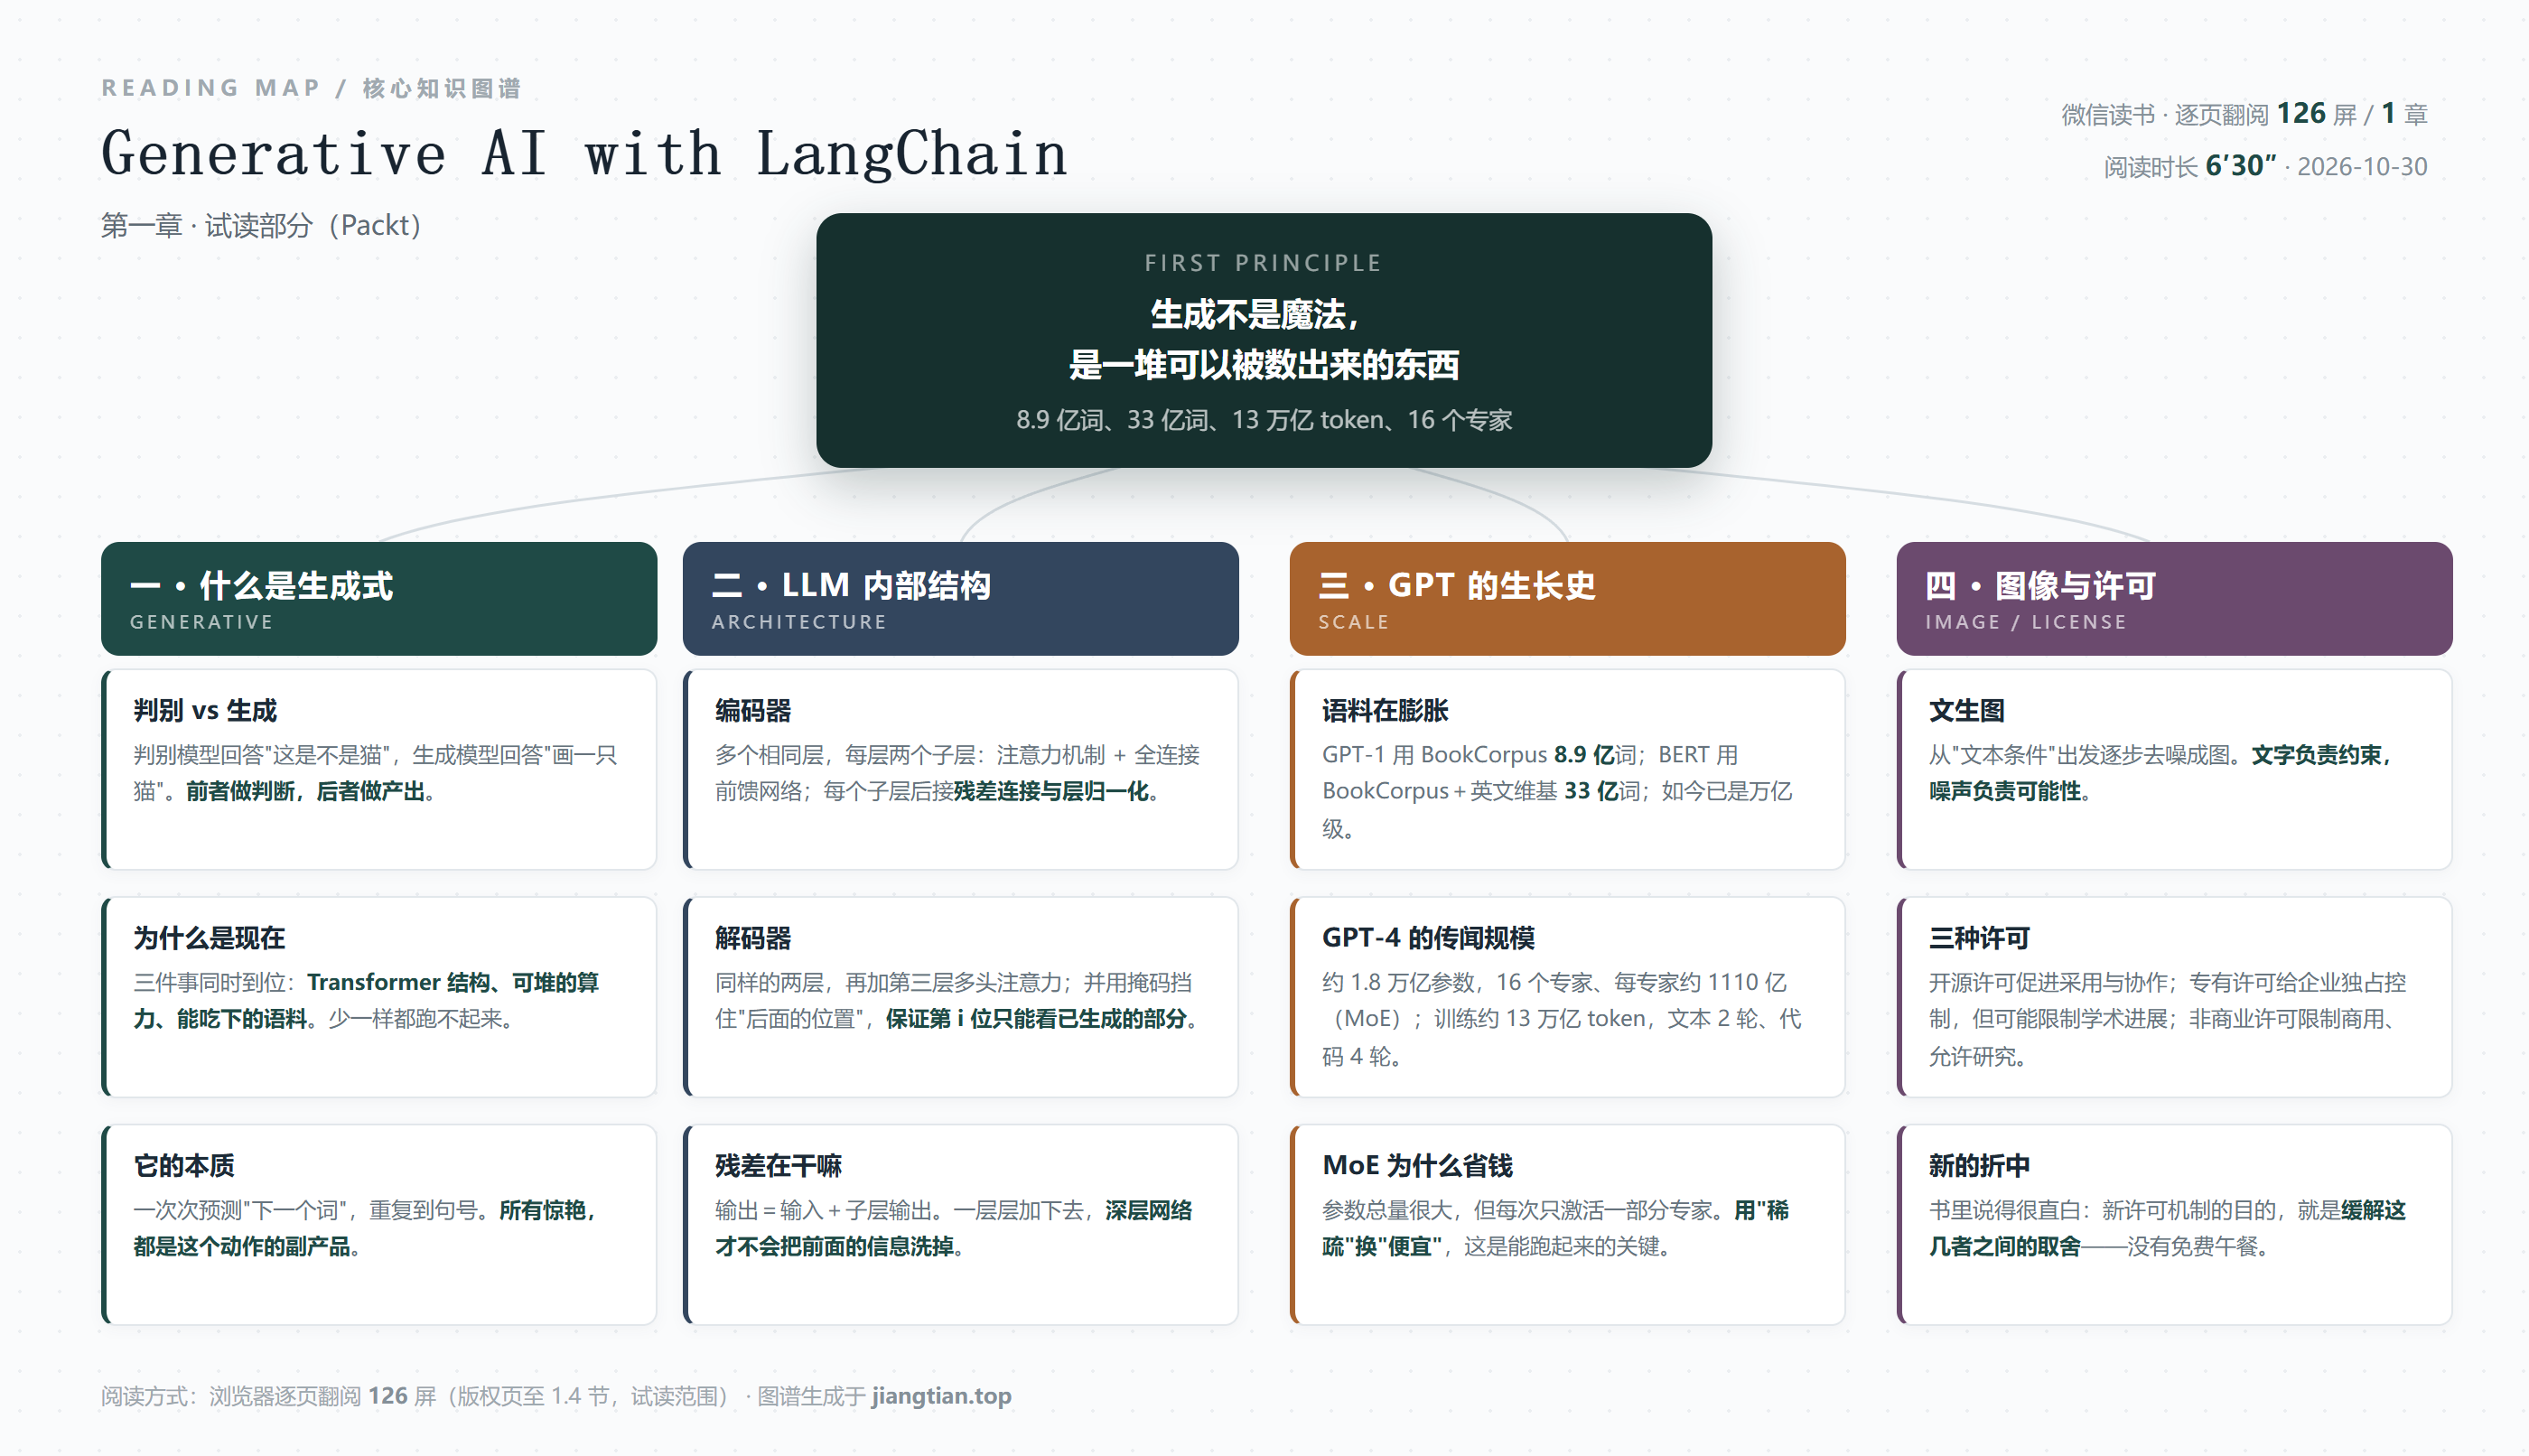
五、核心知识图谱
六、我的保留意见(也说说这次阅读的遗憾)
第一,只读到第一章,这是硬伤。 书名是"with LangChain",但 LangChain 的部分(链、代理、记忆、检索)全在后面章节,试读范围一点没碰到。所以这篇笔记对"LangChain 怎么用"这个问题,一个字都答不上。我把这点写在最前面,免得读者误会。
第二,第一章偏"科普综述",不算硬核。 对完全没接触过的人,这章是很好的入口:结构、历史、规模、许可,四件事都讲到了。但对已经读过几本同类书的人来说,新东西不多——除了那组数字。
第三,中英对照排版消耗耐心。 每段英文后面跟一段中文译文,126 屏里有一半是重复信息。好处是术语能立刻对回原文,坏处是阅读节奏被反复打断。
第四,它带着明显的"产品说明书"痕迹。 文前有一部分在介绍 Packt 自家阅读器的功能(图 1.1 就是一整屏的阅读器界面截图)。这部分对读者没有价值,纯占篇幅。
不过话说回来,一本技术书的绪论能写成这样,已经算合格了:它没有一上来就吹"革命",而是从"下一个词"讲起,一路讲到许可。这个顺序,本身就是一种诚实。
七、一句话收尾
这一章给我留下的是这个:
所有关于 AI 的玄学讨论,都可以被还原成几个能数的数:多少词、多少 token、多少参数、激活几个专家。
数得出来,就说明它是工程,不是魔法。而工程的好处是——它总有可以下手的地方。
阅读记录:微信读书网页版 · 逐页翻阅 126 屏 / 6 分 30 秒 · 覆盖率:仅第一章(试读范围,至 1.4 节)
《Generative AI with LangChain》 Packt Publishing · 中英对照版
发表评论: