《从ChatGPT到AIGC》读后:它教你判断内容对不对,前提是你已经知道答案
阅读方式:微信读书网页版,从版权页翻到第 12 章,共 261 屏、12 章、6 分 30 秒。 这是第三本讲 AIGC 的书了。前两本一本讲技术、一本讲商业模式,这本讲"行业怎么用",所以它的价值不在观点,在案例清单。
但也正因为是案例清单,它有个明显的毛病:一半的篇幅读起来像厂商的宣传稿。 这一点我后面细说。
一、四块技术地基,一句话一块
第 2 章讲技术构成,四节:自然语言处理、AIGC 生成算法、预训练大模型、多模态交互。
这一章写得不算深,但它有个好处——把"笔"和"脑子"分开了。
生成算法(GAN、Diffusion)决定的是"画得像不像",这是笔;预训练大模型决定的是"懂不懂我要什么",这是脑子。两者结合,才出现"你随便说一句它就画得对"的体验。
而多模态交互的意义,书里点得很轻,但我觉得最重:模态一打通,工具就开始变成"入口"。
因为工具是"你为了某个目的去打开它",入口是"你一直在里面,顺手就把事办了"。三年后回看,这句话几乎预言了聊天框取代搜索引擎的过程。
二、安全那一节,是全书最准的地方
第 3 章讲产业挑战,里面有一节"安全挑战",把风险归成三类,并且用一张图列了出来:内容本身的安全问题、可能引发违法犯罪行为、用户隐私数据泄露。
第一类的论述我几乎逐字读完了:
"互联网中的一些内容是虚假的,而随着 AIGC 内容的爆发,内容的虚假问题会更加明显。例如,当下的一些 AIGC 应用虽然能够智能生成内容,但会出现一些明显的错误。因为这些内容源于 AI 的随机联想。AI 模型可以预测用户输入的下一个关联内容,并生成看似有道理但是并不正确的内容。AIGC 在内容方面存在的风险在于,除非用户知道问题的正确答案,否则难以判断内容的正确性。"
最后那句是全书写得最锋利的一句。
它其实说破了一个很别扭的循环:你要判断它答得对不对,前提是你已经知道答案;可如果你已经知道答案,你就不需要问它了。
这就是"幻觉"最麻烦的地方——它不是"错得离谱",而是"错得合理"。离谱的错你能一眼看出,合理的错会一路滑到终点。
而书里对第二、三类的描述也很实在:不法分子可能利用 AIGC 生成虚假名人照片、制造谣言;也有公司在训练数据里故意加入违禁内容,让用户"方便"地用它做不合规的东西,以此换取网络曝光——书里直接说"这种行为无疑是更加应该被打击的"。
这段的态度,比很多只谈"技术向善"的书要硬。
三、案例部分:有用,但要会挑
第 5 到第 10 章按行业铺开:传媒、电商、影视、娱乐、教育、工业。每一章的结构都差不多——先讲这个行业哪里痛,再举几个产品/公司做例子,最后展望。
我挑三个真正有信息量的说。
传媒:从"采"到"剪"全线被打通。 书里列了一串具体能力:语音表达智能过滤、视频唱词智能分离、SRT 字幕导出、采访角色智能分离;今日头条推出"自动生成原创软件",能根据实时输入的内容要点和关键字自动生成原创新闻内容,还带语音识别、标题生成、内容生成、定位标签、关键字匹配、图片批量上传;剪映则把"一键加字幕""视频特效""素材库"这些做到了普通人能用。
这段的价值在于:它展示的不是"AI 能写稿",是"一条内容产线被拆成了若干个可替代的工位"。
电商:把"拍"的成本压到近零。 商品图智能生成、场景三维建模、虚拟主播、虚拟 IP 代言(既可邀请也可自建)。书里对虚拟主播的定位很实在——"电商营销的好帮手"。
而"虚拟 IP"这一节透露出一个趋势:品牌方开始把"代言人"当成一项可以自建的资产,而不是一笔可以谈判的费用。这背后的账很清楚:真人代言有档期、有舆情风险、有涨价;虚拟 IP 没有。
工业设计:3–5 天压到 1 天。 书里举了神采 PromeAI:设计师上传一张 CAD 草图或照片就能拿到方案效果图;原来做一套完整住宅设计方案要 3–5 天,现在 1 天左右能出初步方案。
它还补了一句我觉得很关键的观察:PromeAI 可以生成一些设计师难以推敲出的设计方案。
这句话比"提效 5 倍"有价值得多。因为它说明 AI 在这里的角色不是"更快的画图员",而是"提供你没想过的选项"——而后者才是创意行业真正稀缺的东西。
四、创投那两章:谁的生意最稳
第 11 章讲创投机遇,给了三条入局路径:以技术入局(瞄准 AI 顶层技术)、以产品入局(多角度打造 AIGC 产品)、以及围绕产业链找投资机会。
其中有一段我印象很深,讲的是海天瑞声:从数据入手,提供专业数据服务,拥有近千个数据成品库,包含近 200 种语言,覆盖虚拟主播、智能搜索等场景;服务涵盖数据采集、标注、评测、方案设计。
为什么这段重要?因为它说明了一个反直觉的事实:模型越卷,卖数据的越稳。
做模型的要赌技术路线、赌算力、赌窗口期;做数据的只要保证"别人要什么我有什么"。前者是高方差生意,后者是低方差生意。在一个所有人都在赌的行业里,卖铲子的永远先赚钱。
第 12 章给了三个趋势判断:技术迭代深化、参与主体由 B 端向 C 端扩散、行业渗透提升与场景蔓延。
三年后回看,这三条全部应验。而且应验得比书里写的更彻底——C 端已经不只是"用 AIGC 生成内容",而是"让 Agent 替自己干活"。
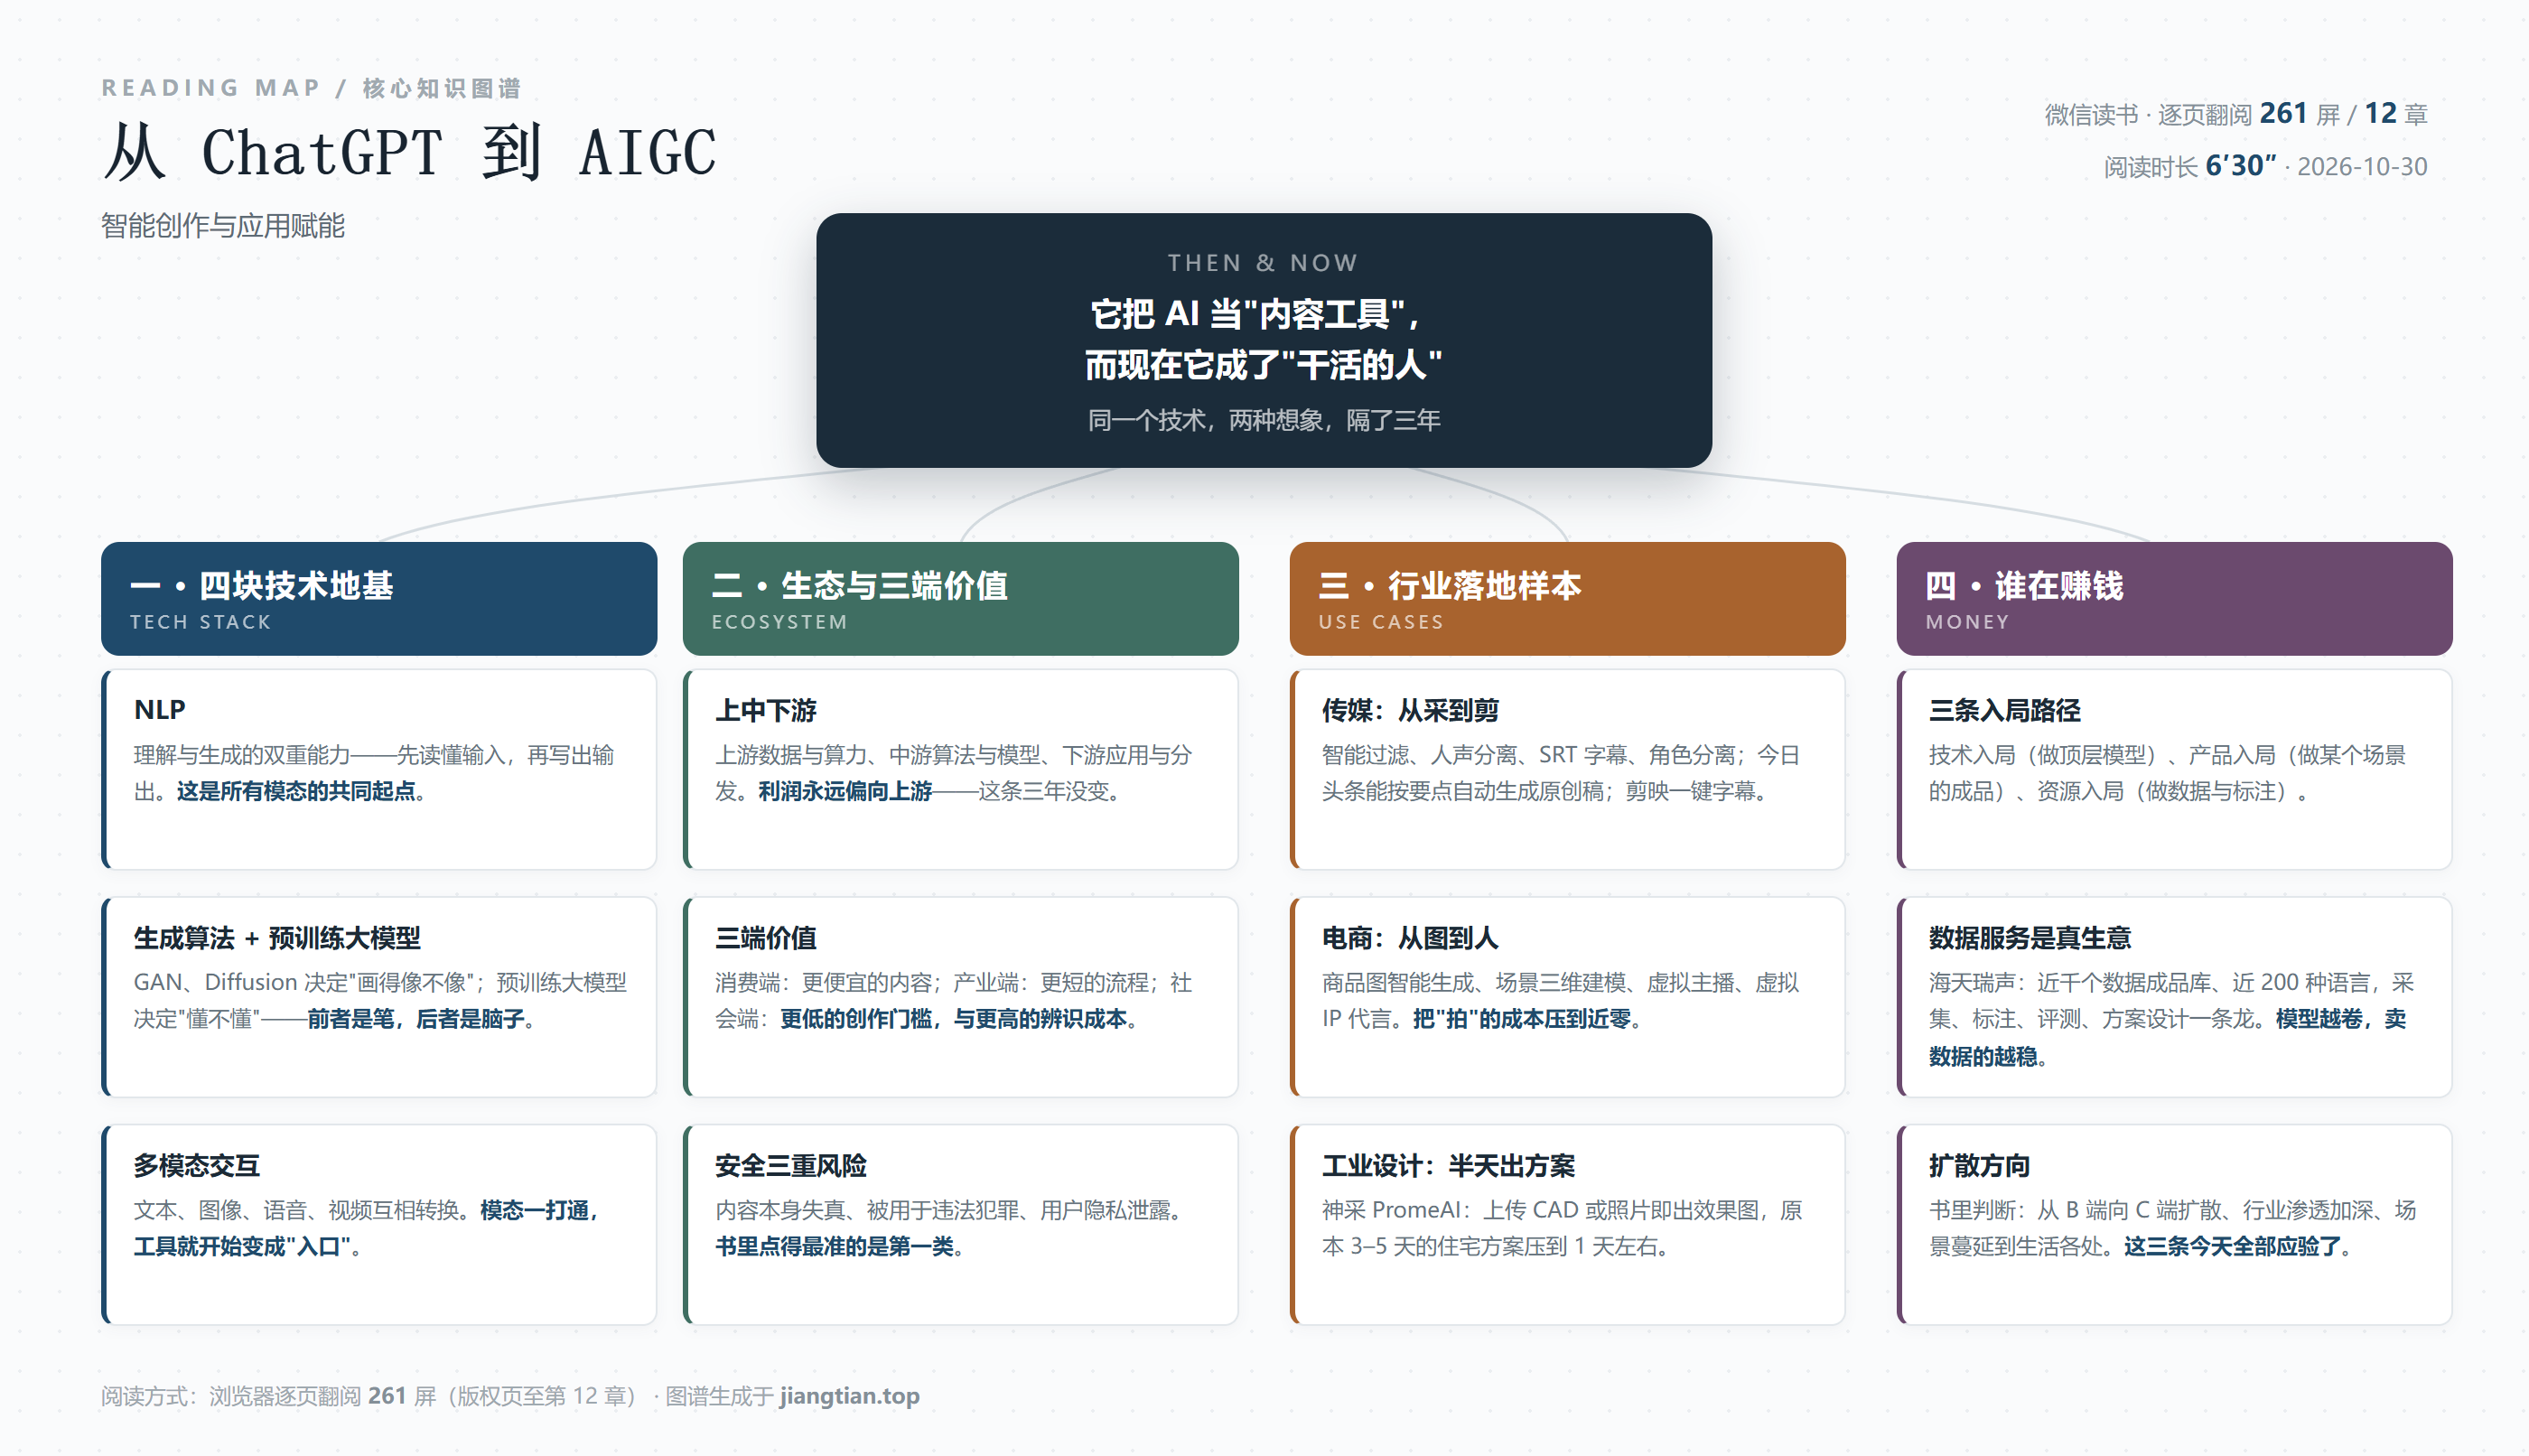
五、核心知识图谱
六、我的保留意见
第一,案例的写法偏"产品介绍"。 大量段落是"某公司推出了某产品,具备 A、B、C 功能,能够实现 X、Y、Z"——这是产品说明书的语言,不是分析的语言。读多了会发现,它在告诉你"有什么",但很少告诉你"为什么这家成了、那家没成"。
第二,行业章节同质化。 传媒、电商、影视、娱乐、教育、工业,六章的论证结构几乎一样:痛点 → 案例 → 展望。真正的行业 know-how(比如影视的排期与审查、教育的课标与评价)没有展开。
第三,缺"失败案例"。 全书没有一个"这样做失败了"的例子。而 2023 年那批 AIGC 创业公司,死亡率相当高。一本讲行业落地的书回避失败,就等于回避了最有价值的部分。
第四,时间戳太明显。 大量 2023 年的产品名和功能描述,今天很多已经改版、合并或消失。当"行业史料"读可以,当"选型参考"读会踩坑。
但这些批评不否定它的用处。作为一本"2023 年 AIGC 行业落地快照",它把当时能看到的场景几乎都扫了一遍——你想知道三年前大家认为 AI 会先改造哪些行业,翻它就行。
七、一句话收尾
这本书让我确认了一件事:
2023 年的 AIGC 书,几乎都把 AI 当成"内容工具";而 2026 年的现实是,它成了"干活的人"。
这个转向不是技术突然进步了,是大家终于意识到:能生成内容,只是能交付的第一步。
而真正难的那一步——决定做什么、做完对不对、出了事谁负责——从来没有被写进这些书里,因为它不在技术范畴内。
阅读记录:微信读书网页版 · 逐页翻阅 261 屏 / 12 章 / 6 分 30 秒 · 覆盖率 100%(版权页至第 12 章末)
《从 ChatGPT 到 AIGC:智能创作与应用赋能》
发表评论: