《人人都是设计师》读书笔记:前 43 屏不聊 AI,却决定了后面 340 屏
阅读方式:微信读书网页版,从版权页翻到附录,共 383 屏、7 章、9 分 11 秒。 这本书的结构非常规整:第 1 章讲设计基础,第 2–5 章讲 Midjourney,第 6 章讲 ChatGPT 配合,第 7 章是案例库。
我翻开它的时候有个先入为主的判断:一本叫《人人都是设计师》的书,前面那些"设计基础"大概是为了让书显得像本教材而凑的篇幅。毕竟读者是冲着 Midjourney 来的。
翻完前 43 屏,我改主意了。
这 43 屏里,一次都没有出现"AI"这个词。 讲色轮、讲版式、讲字体分类,全部是纸媒时代的老知识。而恰恰是这 43 屏,决定了后面 340 屏你能玩到什么程度。
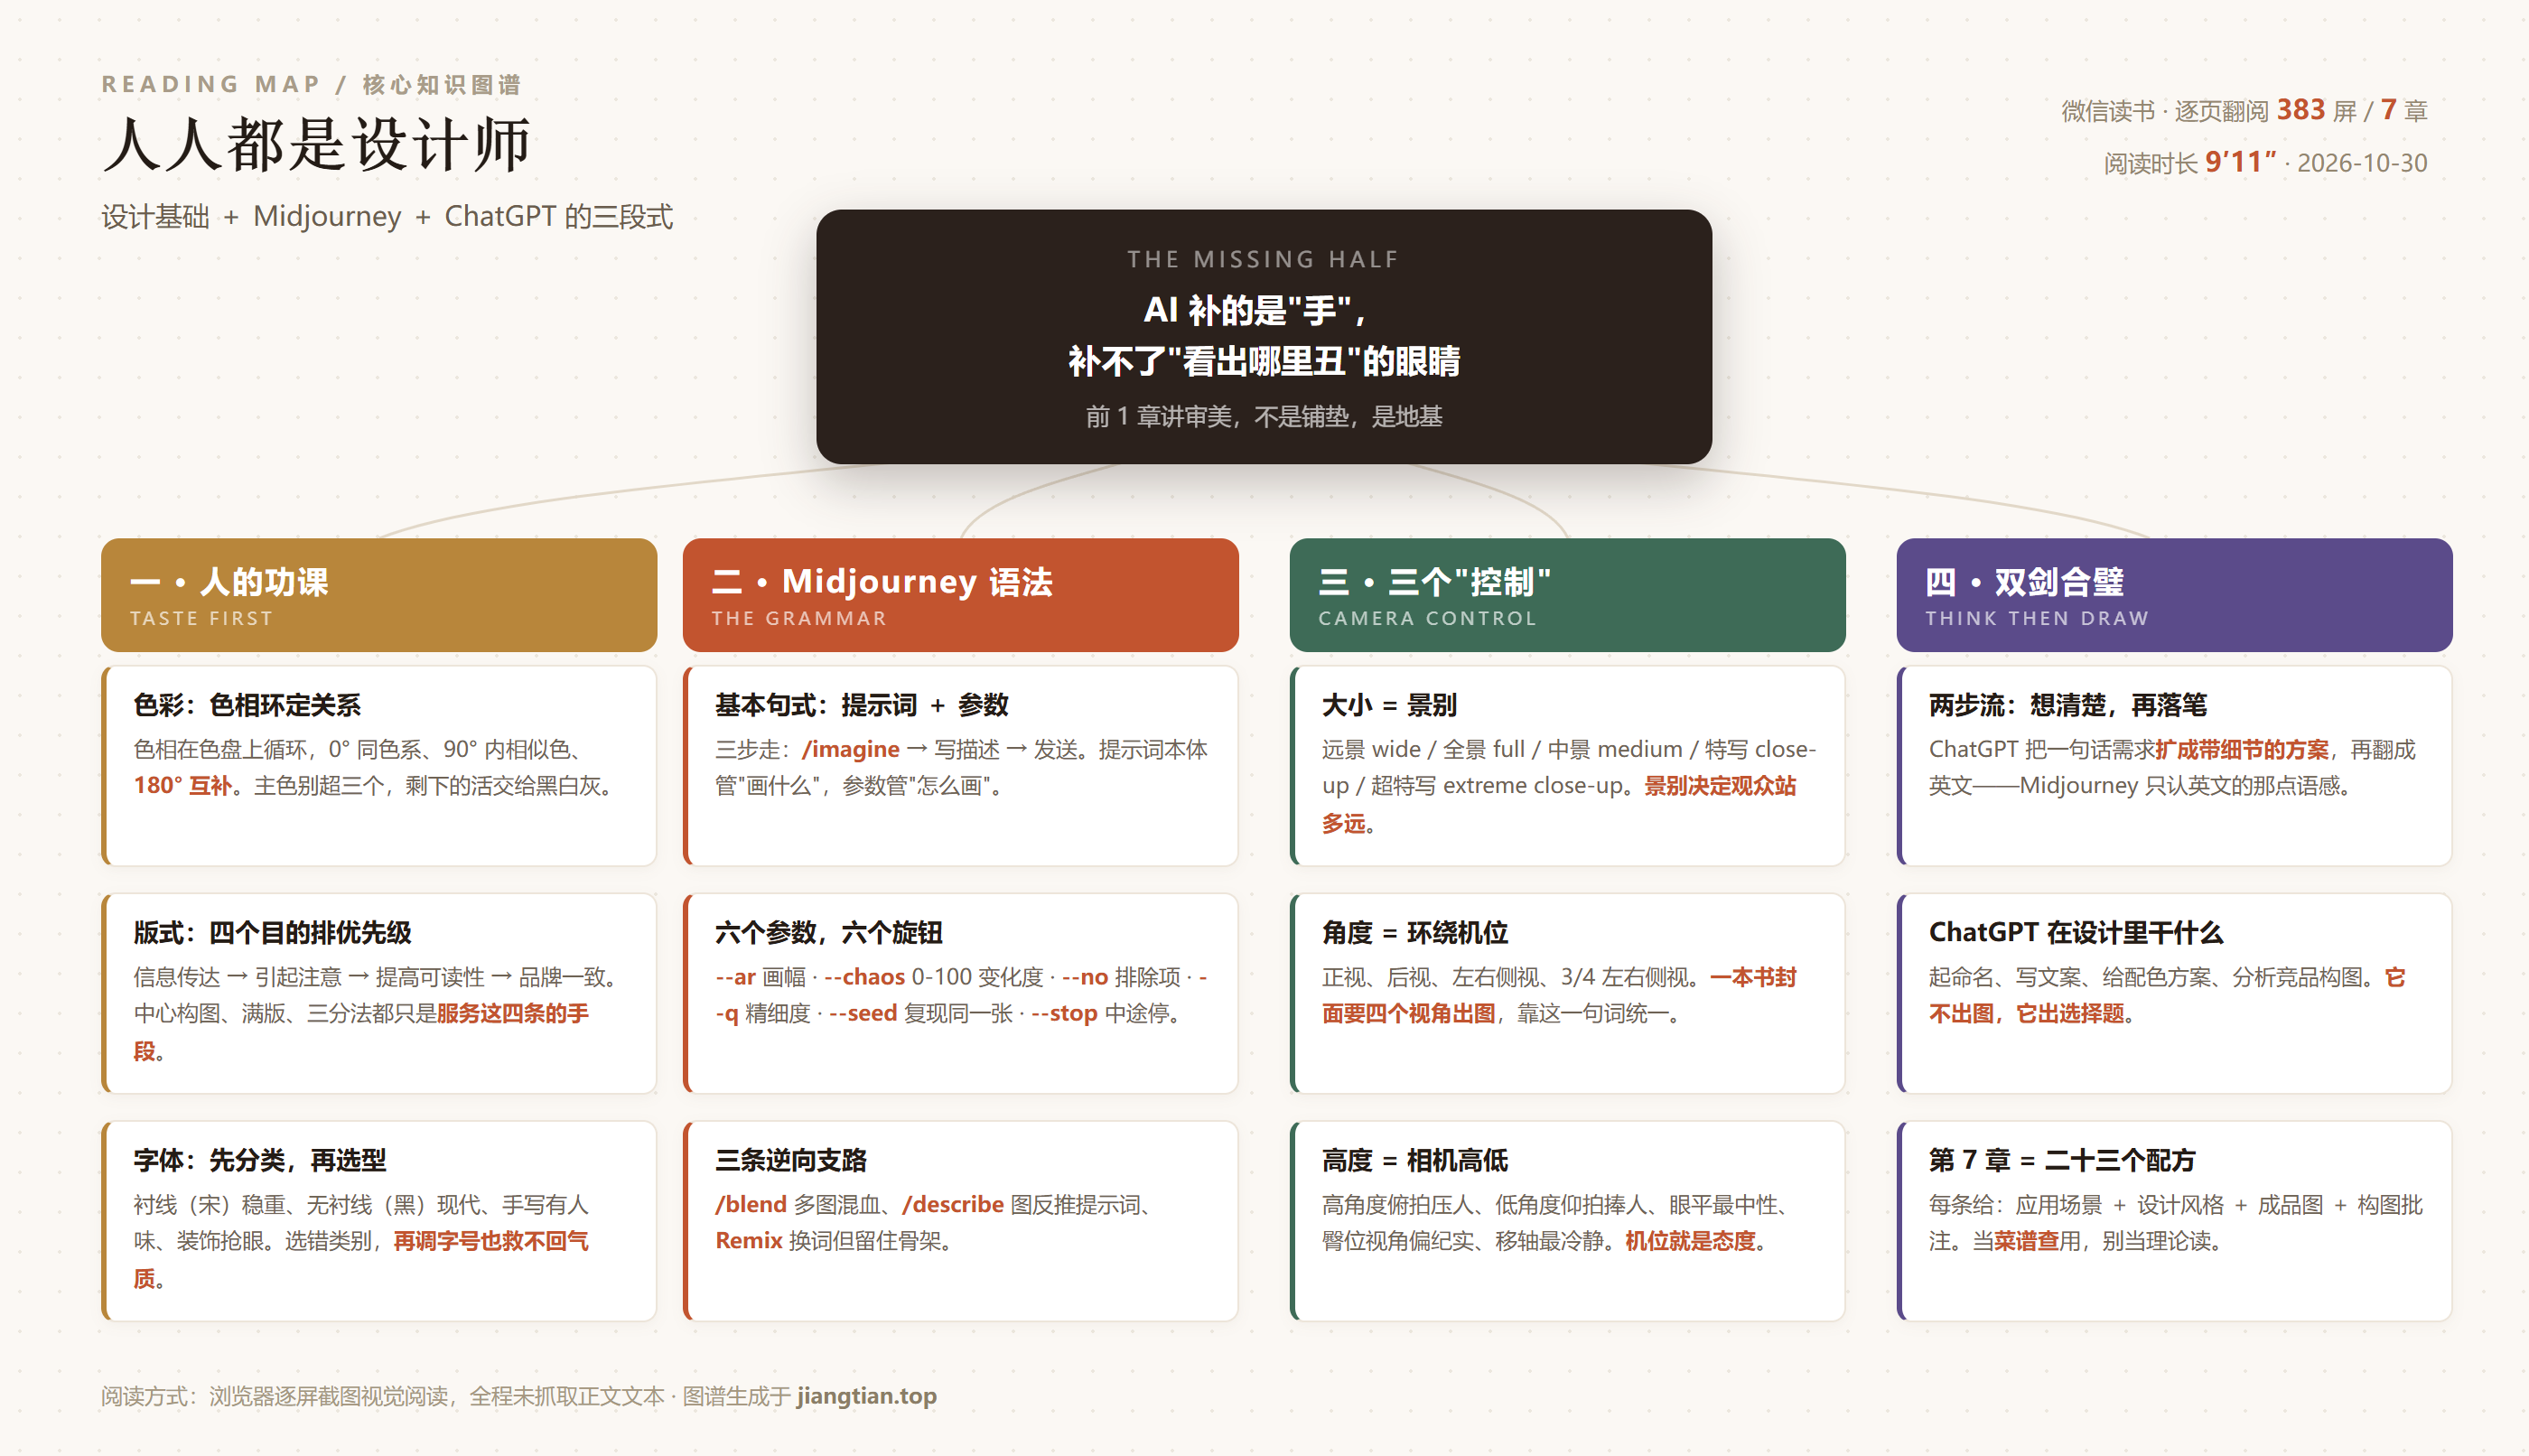
一、前面 43 屏,是在建一套"共同语言"
1.1 色彩设计基础,13 屏。开篇第一句是:"色彩是设计中至关重要的元素之一,它能够引导观众的情绪和体验,塑造视觉效果,甚至传达特定的信息。"
然后它做了一件很朴素的事:给色轮标上角度。同一个色系是 0°,90° 以内是相似色,180° 是互补色。红、黄、绿、青、蓝在盘上循环排布,每个色块下面还标了 RGB 值。
1.2 版式设计,9 屏。它把版式的作用拆成五条:信息传达、引起注意、提高可读性、增强视觉吸引力、保持品牌一致性。然后逐条展开——比如"信息传达"这条下面写的是:"合理的排版结构和明确的信息层次可以帮助观众更容易地获取所需信息,避免出现信息混乱或难以理解的情况。"
1.3 字体与版式的结合,8 屏。它先给"字体"下定义——"一组具有相似设计风格和特征的字形集合",然后直接甩资源清单:中文有思源黑体、思源宋体、江西拙楷、龚帆字体、三围追光、悠然小楷、阿里数黑、鸿雷行书;西文有 Poppins、Lato、AiDeep、GOVER、POTRA、CHINNERS、HANSIEF、PERFOGRAMA。再往下才是衬线/无衬线的分类。
这三节加起来 30 屏,抵得上一门课的第一次课。它们的共同点是什么?
它们全都在给事物命名。
色相、明度、纯度、互补色;信息层级、视觉重心、留白、对齐;衬线、无衬线、字重、字距。这些词不是知识,是词汇表。而词汇表的意义在于——你能把"这张图不好看"这个模糊的痛感,拆成"配色对比度不够"或者"信息层级太平"这样一句能被执行的话。
这解释了为什么它要把这三节放在最前面:Midjourney 的参数面板上没有"好看"这个旋钮。 你能拧的只有画幅、变化度、排除项、精细度、种子、停止点。所有这些旋钮,都需要你先知道要往哪个方向拧。
换个说法:AI 补上了"手",但补不了"看出哪里丑"的那双眼睛。这本书前 43 屏,练的是眼睛。
二、Midjourney 的语法:一句话加六个旋钮
第 3 章把 Midjourney 的用法压缩得非常干脆。
先说流程,三步:在斜杠命令里输入 /imagine prompt,在字段里写描述,发送。就这样,没有第四步。
再说句式,一句话:提示词 + 参数。
书里对提示词的作用列了四条:描述细节、提供风格指导、匹配上下文、激发创造力。这四条里我觉得最容易被忽略的是"匹配上下文"——"提示词应该与图像生成任务的上下文相匹配,以便模型可以理解所需的图像背景和环境。"翻译成人话就是:你得告诉它这张图是用在哪儿的。做电商主图和做杂志插画,同样的主体,提示词写法完全不同。
然后是参数表。书里列了七个,我挑三个最有信息量的:
--ar(--aspect),宽高比,默认 1:1。这一条决定了构图空间。1:1 适合头像和产品,16:9 适合场景,2:3 适合海报——你选比例的同时,也选了构图法。
--chaos,0–100,默认 0。书里的说明是:"数值越大越会产生更多不同寻常的变化。"这是多样性旋钮。做提案时把它拧高,做定稿时拧回 0。
--seed,这个我认为是全表最有价值的一个。书里的解释是:种子值编号是每个图像随机生成的,但你可以用 --seed 参数指定它,从而生成相同的图像。
为什么 --seed 重要?因为它把 Midjourney 从"抽奖"变成了"可复现的实验"。没有种子,你调一个词、出一张图,永远分不清变化是来自那个词还是来自随机。有了种子,你才能做控制变量——固定种子,只改一个词,看差异。这是从"玩"跨到"调"的那一步。
另外还有 --no(排除内容)、--q(精细度,默认 1)、--repeat(一次跑多个任务)、--stop(中途停止,0–100)。这些是修饰性参数,用得少但关键时刻能救场。
三、三条逆向的路:从图回到词
正向是"词 → 图"。但第 3 章后三节讲的是反方向:从图回到词。这三条路,用途完全不同:
/blend(图生图 / 混合)——喂它几张图,让它混血。适合"我有 A 的构图和 B 的配色,想要一个 C"。
/describe(图生文)——给它一张图,它反推提示词。这一条我觉得是全书最容易被低估的功能。因为它是偷师的合法通道:你在网上看到一张喜欢的图,不用猜作者写了什么,直接让它把词还给你。你看多了会发现,好图背后的词往往很朴素——不是什么神秘咒语,就是准确的场景描述加克制的风格词。
Remix(混合模式)——在已有生成结果上换提示词,但保留原来的骨架。适合"结构对,内容不对"。
这三条路合起来回答了一个问题:当你写不出好提示词的时候,怎么办? 答案不是硬憋,是去找一张对味的图,让它把词翻译回来。
四、第 5 章的三个控制,其实是摄影课的词汇表
第 5 章标题叫"Midjourney 高级玩法实操",一共三节。翻完我发现,它讲的不是 Midjourney,是镜头语言。
5.1 控制主体的大小 —— 也就是景别。书里配了张示意图,把画面切成五档:远景(wide angle)、全景(full shot)、中景(medium shot)、特写(close-up)、超特写(extreme close-up),还多标了一个中特写(medium close-up)。
5.2 控制主体的角度 —— 也就是环绕机位。示意图画了个圈:正视图(front view)、后视图(back view)、左侧视图、右侧视图、3/4 左侧视图、3/4 右侧视图。这一节的实际价值是做系列图——同一角色出六个角度,靠的就是这几个词保证一致性。
5.3 控制主体的高度 —— 其实是相机高低。这一节标题有点误导,因为图里画的是机位:高角度镜头(high angle shot,俯拍)、低角度镜头(low angle shot,仰拍)、眼平/胸平镜头(eye level)、臀位镜头(hip level)、移轴镜头(tilt shift)、第一人称视角(first person view)。
这三节连起来看,逻辑很清楚:景别决定观众站多远,机位决定观众站多高,角度决定观众站哪边。 三个维度合起来,就是一个完整的摄影机坐标系。
这也解释了为什么这套词好用——它不是 Midjourney 发明的,是电影工业用了一百年的标准术语。模型在海量图像-文本对上训练过,这些词在数据里出现得又多又准,所以它认识。反过来,"高级感""氛围感""ins 风"这类词,在训练数据里没有稳定指向,模型只能猜。
所以"提示词技巧"的本质是:用模型听得懂的、有稳定指向的词,替换掉你自己觉得舒服但含义模糊的词。
五、双剑合璧:ChatGPT 想,Midjourney 画
第 6 章只有三节,但它是全书结构上的收口。
6.3 给了个两步流程图:第一步,在 ChatGPT 中通过提问的方式获取关键提示词;第二步,将提示词粘贴在 Midjourney 中,根据提示词生成图像。
书里举的例子很具体。需求是:一幅日本漫画家宫崎骏风格的绘画作品,内容是午后的阳光下,一家人坐在绿草地上悠闲地聊着天,喝着咖啡。
然后拆两步:
(1) 把这段需求输入 ChatGPT,让它完善细节,提出具体的设计绘图方案。 书里的说法是"ChatGPT 会给出更多的场景细节"。
(2) 让 ChatGPT 把这段文字直接翻译成英文。
第二步看着像凑数,其实是全书最实用的一条工程细节。书里的成品提示词长这样:Cartoon style, family of four sitting on a green grass lawn, drinking a cup of coffee, on a beautiful sunny day... 后面还有背景、光线、人物表情、色彩描述的一大串。
为什么必须翻英文?因为 Midjourney 的中文语义空间是稀疏的。你用中文写"宫崎骏风格",它可能只抓到"日本""动画"两个模糊标签;写 "in the style of Hayao Miyazaki" 就精确得多。这不是模型歧视,是训练数据的密度差异。
而 ChatGPT 在这个流程里的角色,我读下来觉得比"翻译"更重要:它把一个句子扩成了一份方案。 你原本只说了"一家人草地上喝咖啡",它补出了背景、光线、时间、表情、色彩。这些细节你可能想得到,但你不会主动写出来——因为人写提示词时总是倾向于写"要点",而模型需要的是"画面"。
六、第 7 章是菜谱,不是理论
第 7 章占了全书一半以上的篇幅:从 158 屏一直排到 375 屏,217 屏,23 个案例。
每个案例的版式都一样,我拿"商业设计:产品宣传"这一条举例:
顶部两行标签——应用场景:水果礼盒产品宣传图;设计风格:实景拍摄。然后是一整页成品图,图上用引线标出构图批注:"使用视觉主体构图,铺满整个画布""采用中心构图法,中间为安排标题"。
23 个案例覆盖的场景很全:商品促销、产品宣传、业务展示、产品展示、节日主题、节气主题、视觉 Logo、字体设计、产品包装、IP 角色、玩具设计、3D 插画、社交媒体、艺术插画、国潮插画、动漫插画、游戏设计、UI/UX、工业产品、建筑设计、商业空间、数字后期合成、人像摄影。
这一章怎么用?我的看法是:当字典查,别当书读。 它的可复制性极强(照着改成自己的主体就能用),但可迁移性很弱(换个完全不同的品类就不灵了)。真正可迁移的东西在第 1 章和第 5 章——一个是审美词汇,一个是镜头词汇。
书末还有个附录,标题就叫"Midjourney 提示词大全"。这是这类书的标配,价值在于省掉你从零造句的时间。
七、保留意见
这本书有三个明确的时效风险,读的时候得自己打折:
一、版本参数会过期。 书里第 2 章专讲"Midjourney 模型版本",第 3 章的参数表也是按当时版本写的。Midjourney 的迭代速度是一年几个大版本,参数表这类内容半年就可能失效。读参数那一节,重点不是记数值,是记住"有这么一类旋钮存在"。
二、工具信息衰减最快。 2.3 节专门讨论"Midjourney 是免费的吗",2.2 节讲怎么注册使用。这类内容在成书那一刻就已经开始贬值。当历史读可以,当指南读会踩坑。
三、设计基础部分偏薄。 30 屏讲完色彩 + 版式 + 字体,密度相当于设计专业的一节导论课。它给了你词汇表,但没给你判断力——判断力还是得靠看图。这一点书里没夸大,是我要提醒自己的:别把"知道有互补色"当成"会用互补色"。
八、一句话收尾
这本书的书名其实是个承诺:"人人都是设计师"。但读完 383 屏,我觉得它给出的路径比书名诚实——
它先花了 43 屏告诉你:设计是有门槛的,门槛叫色彩、版式、字体。然后花了 340 屏告诉你:AI 能帮你跨过"手"这道门槛,但"眼"那道门槛,还得自己迈。
所以"人人都是设计师"这句话,准确的说法可能是:人人都能出一张图,但能出好图的人,还是那批先学会了怎么看的人。
阅读记录:《人人都是设计师:设计基础+Midjourney+ChatGPT》|微信读书网页版逐屏截图阅读|383 屏 / 7 章 / 9 分 11 秒|知识图谱已上传至本站|笔记写于 2026-10-30
发表评论: