《深度学习》(花书)读后:正确使用一个普通算法,好过草率地用个自己不懂的
阅读方式:微信读书网页版,从版权页翻到内容简介,共 1210 屏、20 章、24 分 51 秒。 这是这批书里最厚的一本:正文约 1000 屏,参考文献 138 屏,索引 64 屏。三部分结构:应用数学与机器学习基础(1–5 章)→ 深度网络:现代实践(6–12 章)→ 深度学习研究(13–20 章)。
Ian Goodfellow、Yoshua Bengio、Aaron Courville 合著的这本,业内叫"花书"。它 2016 年出英文版,2017 年出中文版,是这一代做深度学习的人共同的入门砖。
我原以为重读它会是一种"补课"——毕竟今天大家都在谈大模型,花书看起来像上个时代的东西。读完 1210 屏,我的判断反过来了:
这本书真正教的东西,恰恰是今天最缺的那部分。
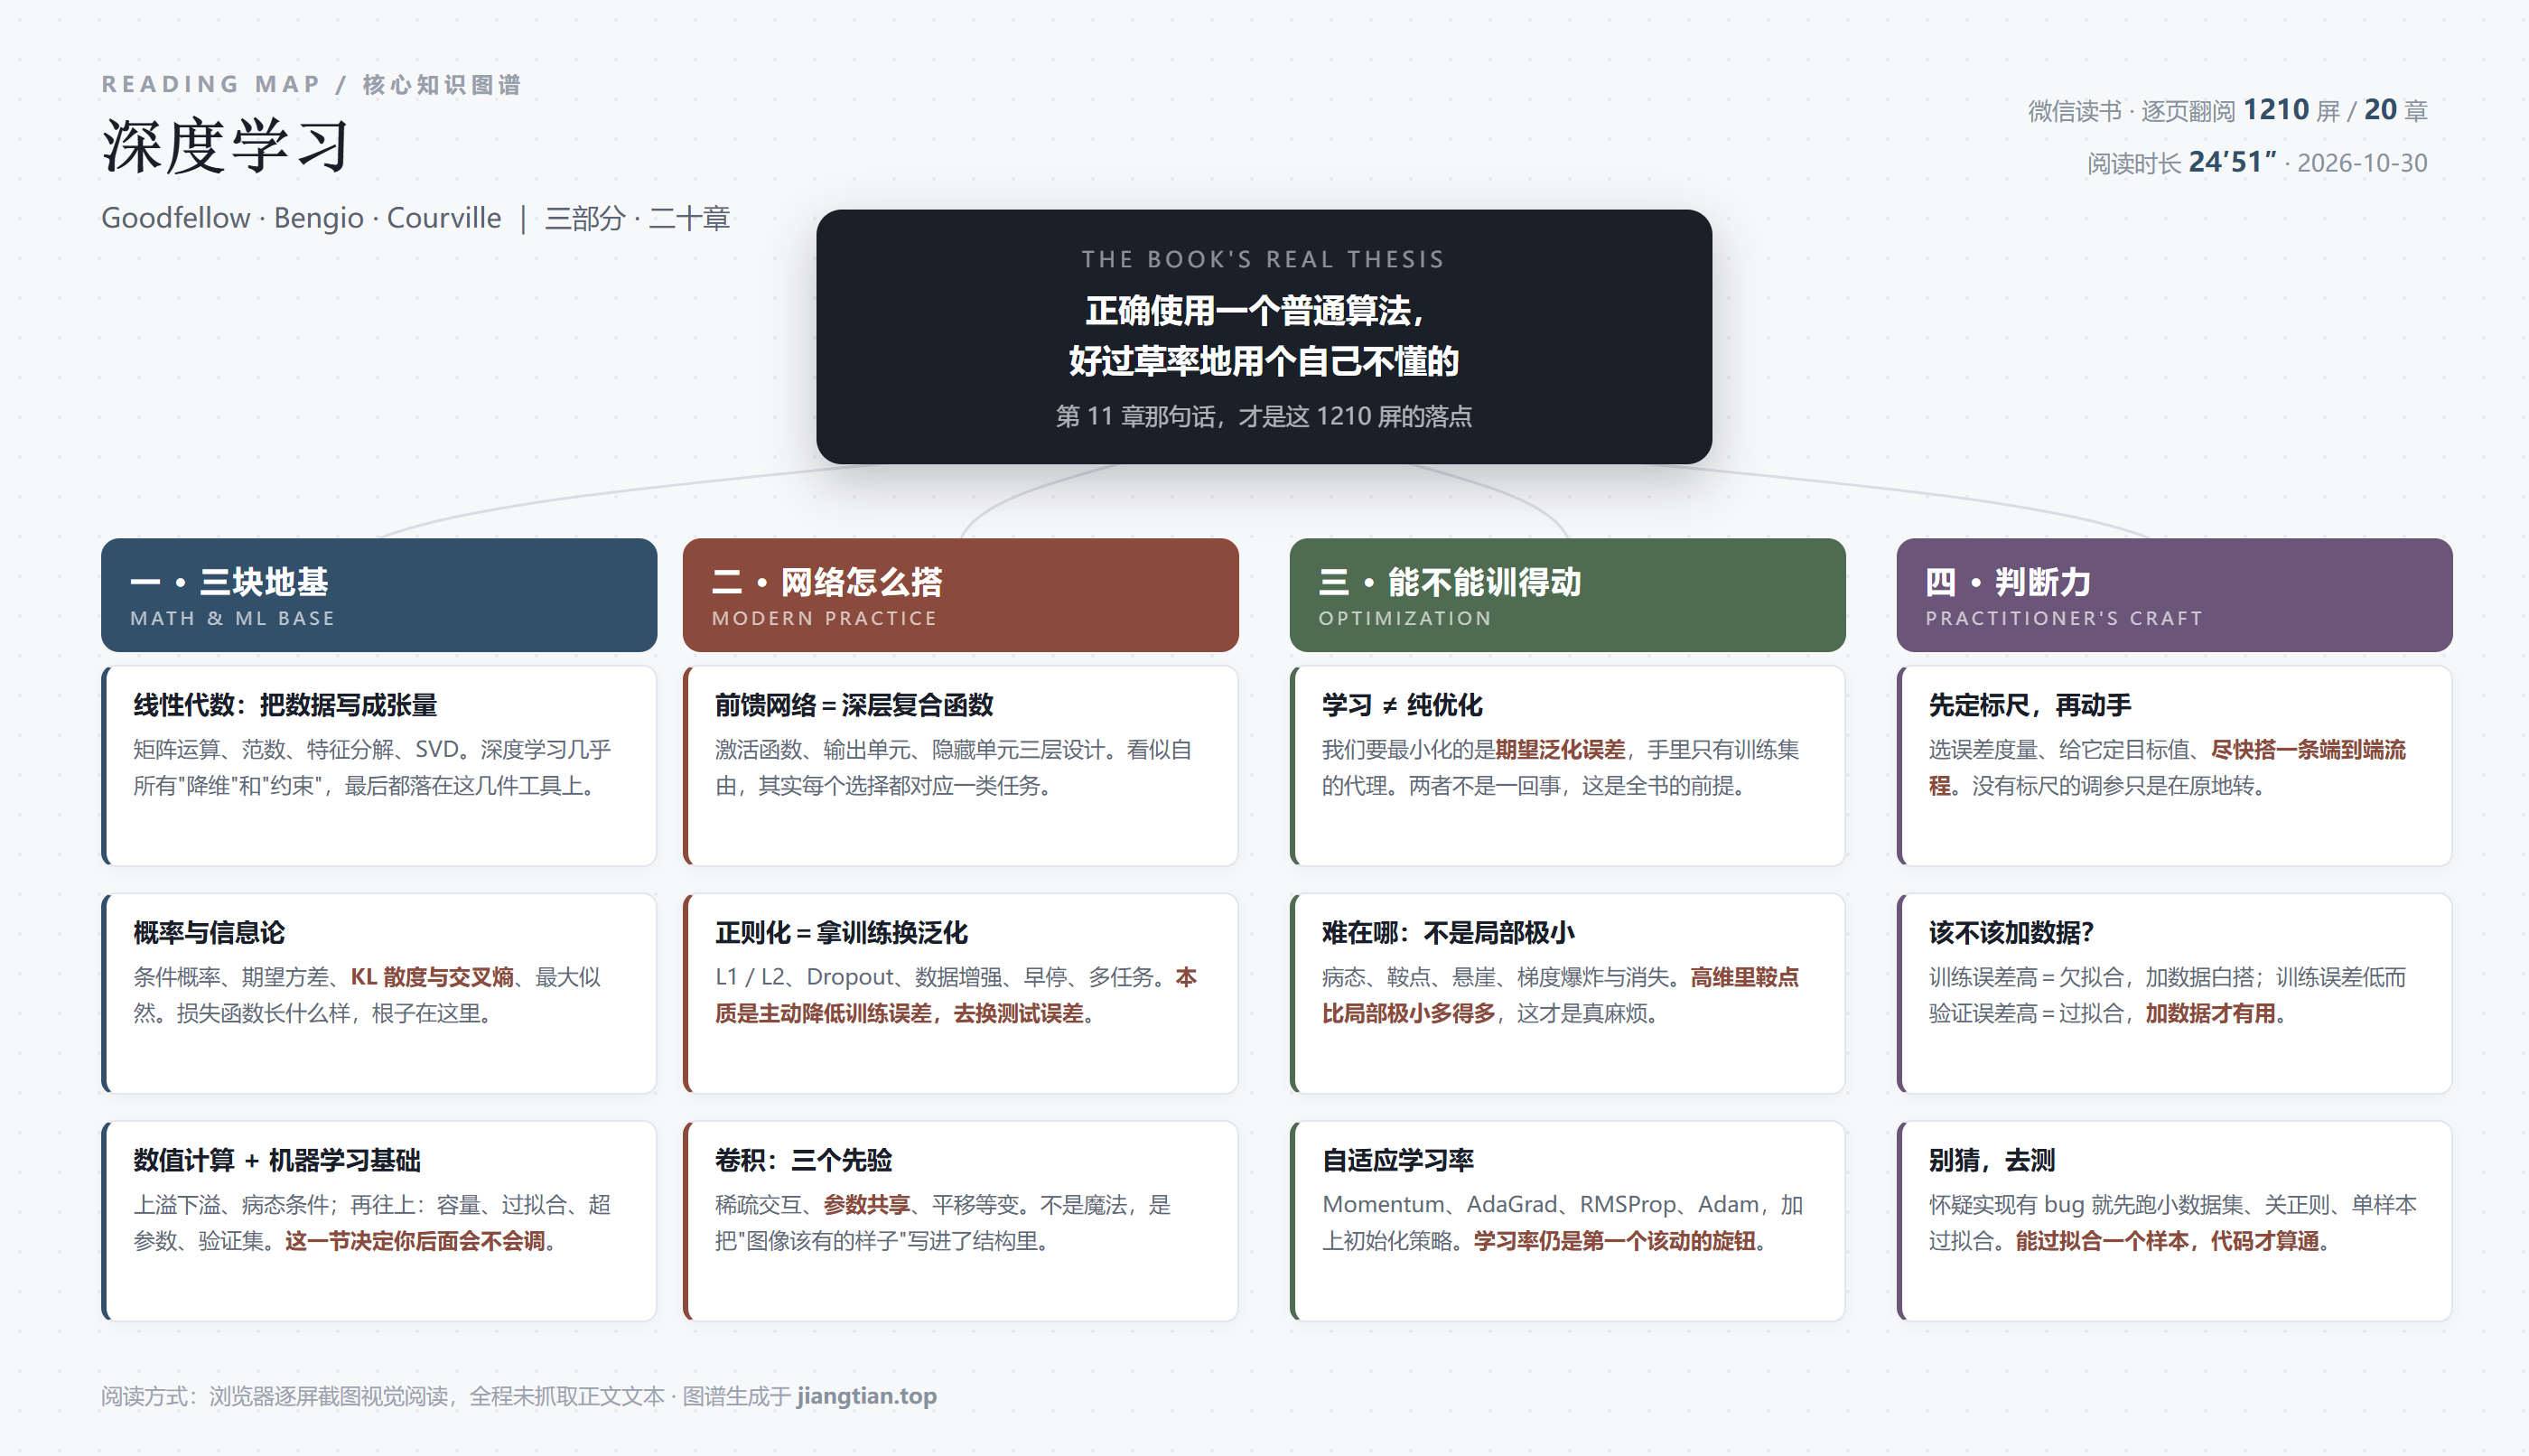
一、第 11 章那句话,是这 1210 屏的落点
全书最"祛魅"的一段,在第 11 章《实践方法论》的开头。它先说了一件事:知道原理不够。
"要成功地使用深度学习技术,仅仅知道存在哪些算法和解释它们为何有效的原理是不够的。一个优秀的机器学习实践者还需要知道如何针对具体应用挑选一个合适的算法以及如何监控,并根据实验反馈改进机器学习系统。"
然后它把日常开发中真正要做的决策列了出来,这一段我认为是全书最值钱的清单:
"实践者需要决定是否收集更多的数据、增加或减少模型容量、添加或删除正则化项、改进模型的优化、改进模型的近似推断或调试模型的软件实现。尝试这些操作都需要大量时间,因此确定正确的做法,而不盲目猜测尤为重要。"
接着就是那句话:
"在实践中,正确使用一个普通算法通常比草率地使用一个不清楚的算法效果更好。正确应用一个算法需要掌握一些相当简单的方法论。"
为什么这句话重要?因为它把"深度学习工程师"这个身份的重心,从"我知道多少种模型"挪到了"我能不能把一个模型用对"。
而这两件事的门槛完全不同。前者靠读论文,后者靠做实验——而且要做得有章法。
二、第 1 部分:为什么数学这关躲不掉
第 2 到第 4 章讲线性代数、概率与信息论、数值计算,一共 97 屏。很多人读花书就卡在这里,然后放弃。
我的看法是:这三章不用"学",要"查"。它们是工具书,不是教材。但里面有几处是绕不过去的——因为它们决定了你后面能不能看懂损失函数。
线性代数那章真正有用的是三样:矩阵运算(因为所有模型的前向传播都是它)、范数(因为正则化就是给范数加罚)、特征分解与 SVD(因为所有"降维""压缩"最后都归到它)。
概率与信息论那章的核心是四个概念:条件概率、期望与方差、KL 散度、最大似然。这里有个隐藏的连通性——交叉熵损失不是"设计"出来的,是从最大似然推出来的。 想通这一点,你再看任何分类模型的损失函数,就不再是背公式了。
数值计算那章讲上溢、下溢、病态条件。这一章短,但它解释了一个非常实际的现象:为什么你的 loss 会突然变成 NaN。
然后第 5 章《机器学习基础》才是真正的分水岭,87 屏。它把"容量、过拟合、欠拟合、超参数、验证集"这几个词一次讲透。
三、容量与正则化:全书最实用的两个概念
第 5 章里有一段讲权重衰减的例子,把"容量"这个抽象词讲成了具体的画面:用 9 阶多项式拟合一组点。
书里的描述是:当 λ 非常大时,模型被强迫学到一个"没有斜率的函数",因为它只能表示一个常数函数,所以会导致欠拟合;取适当的 λ 时,模型能恢复出正常的曲线形状;当 λ 趋近于 0(即用最小正则化的欠定问题求解)时,这个 9 阶多项式会导致严重的过拟合。
同一个模型,同一个数据,只改一个标量 λ,就从"太简单"滑到"太复杂"。这就是容量的可调性。
然后它给了一个我认为全书最凝练的定义:
"正则化是指修改学习算法,使其降低泛化误差而非训练误差。 正则化是机器学习领域的中心问题之一,只有优化能够与其重要性相提并论。"
请注意这句话里的悖论感:正则化是"故意让训练误差变大"的技术。而它的目的是让测试误差变小。
这个反直觉的点,是很多人学不明白正则化的原因——大家下意识地认为"训练得越好,模型越好"。而深度学习的第一课恰恰是:训练得好,可能只是记住了。
第 7 章把这件事展开成一整章:参数范数惩罚(L2/L1)、作为约束的范数惩罚、数据集增强、噪声鲁棒性、半监督学习、多任务学习、提前终止、参数共享、稀疏表示、Bagging、Dropout、对抗训练。
这一章的方法看着杂,其实只有一条主线:用各种方式给模型加限制,逼它学规律而不是记答案。 数据增强是限制输入分布,Dropout 是限制网络结构,早停是限制训练时长,L2 是限制权重幅度。
四、卷积网络:不是魔法,是把先验写进了结构
第 9 章开篇给的定义很朴素:
"卷积网络(convolutional network),也叫作卷积神经网络(convolutional neural network, CNN),是一种专门用来处理具有类似网格结构的数据的神经网络。例如时间序列数据(可以认为是在时间轴上有规律地采样形成的一维网格)和图像数据(可以看作二维的像素网格)。"
"类似网格结构"这五个字是理解 CNN 的钥匙。它说明卷积不是万能工具,是有适用前提的。
而它为什么有效,书里靠三个性质来解释:稀疏交互(每个输出只连局部输入)、参数共享(同一个卷积核滑过全图)、平移等变(物体挪了位置,特征照样被认出来)。
我一直觉得这三个词是全书对"归纳偏置"最好的说明。翻译成人话:CNN 之所以强,不是因为参数多,是因为它一开始就相信"图像里的东西在哪儿都长得差不多"。 这个信念如果对了,它就用极少的参数学到极多;如果错了(比如输入根本不是网格结构),它就毫无优势。
这条逻辑在今天特别有用。为什么大模型处理图像要切成 patch?因为那是在把图像重新变成"网格数据",好让卷积或注意力有东西可抓。为什么图神经网络要用邻接矩阵?因为社交网络不是网格,得换一种先验。
五、优化那章最反直觉的一点
第 8 章开头先说了一句很实在的话:
"在深度学习涉及的诸多优化问题中,最难的是神经网络训练。甚至是用几百台机器投入几天到几个月来解决单个神经网络训练问题,也是很常见的。"
然后它马上划了一条界线:
"首先,我们会介绍在机器学习任务中作为训练算法使用的优化与纯优化有哪些不同。"
这个区分是很多人搞混的地方。纯优化是最小化一个已知的目标函数;而机器学习要最小化的是期望泛化误差,这个量我们永远拿不到,只能拿训练集上的经验误差当代理。
由此推出一个结论:训练 loss 降到 0,不代表优化成功了,可能代表优化过头了。 这在纯优化里是不可想象的——目标函数的最小值就是终点。而在机器学习里,终点可能在半路上。
至于"难在哪",书里列的是:病态条件、局部极小值、高原、鞍点、悬崖、梯度爆炸与梯度消失。
这里面最值得记住的是鞍点。因为在低维空间里我们习惯想象"卡在山谷里出不来",但在几百万维的参数空间里,真正困住优化器的往往不是谷底,而是鞍点——某些方向是上坡,某些方向是下坡,但梯度接近零。高维空间里鞍点的数量远远多于局部极小,所以"局部最优"这个说法在深度学习中其实经常是误用。
六、第 11 章:三件比模型更重要的事
回到开头那章。它给了一个"实践设计流程",我把它归纳成三件事。
第一件:先定标尺。 书里的原话是"确定目标——使用什么样的误差度量,并为此误差度量指定目标值。这些目标和误差度量取决于该应用旨在解决的问题"。
注意它说的是"指定目标值",不是"选一个指标"。这两者差别很大:选指标是"我用 F1",定目标是"F1 要到 0.92 才算能用"。没有目标值,你永远不知道什么时候该停。
第二件:尽快搭一条端到端流程。 书里写的是"尽快建立一个端到端的工作流程,包括估计合适的性能度量"。
这条建议的深意是:先要有一个能跑通的、哪怕很烂的系统,再去改它。 因为没有端到端流程,你连"改进了没有"都测不出来。所有"我在优化模型"的自信,都建立在有一个能反复跑的基线之上。
第三件:判断该往哪调。 这是第 11 章最实用的部分——决定要不要收集更多数据。
书里的逻辑其实很干脆,我用一句话概括:训练误差很高,说明模型连训练集都没学会,这是欠拟合,加数据毫无用处,该加容量;训练误差很低但验证误差很高,说明它在背答案,这是过拟合,加数据才有用。
这条判断之所以值钱,是因为它替你省掉了最贵的一种浪费:花三个月标了十万条数据,结果发现瓶颈根本不在数据量上。
至于调试,第 11 章给的方法也很实在:怀疑实现有 bug 时,先在小数据集上跑、关掉正则化、试着让模型过拟合一个样本。能过拟合一个样本,说明代码是通的;连一个样本都学不会,那一定是实现有问题,不用再调超参数了。
七、一本写在 Transformer 之前的书,把后来的路都画了
这是重读时最让我意外的一点。
第 10 章讲序列建模,主角是循环网络和 LSTM——那是 2016 年的主流答案。第 20 章讲深度生成模型,目录是玻尔兹曼机、变分自编码器、生成对抗网络、自回归模型、RNN 生成模型。
书里对生成模型的分类,今天看依然准确:
"所有这些模型在某种程度上都代表了多个变量的概率分布。有些模型允许显式地计算概率分布函数。其他模型则不允许直接评估概率分布函数,但支持隐式获取分布知识的操作,如从分布中采样。"
"显式建模概率" vs "只能采样"——这条分界线,今天依然把生成模型分成两大阵营。GPT 走的是自回归的显式路线,扩散模型走的是另一条路。
而第 20 章里那个现在最不起眼的小节——自回归模型——恰恰是今天所有大语言模型的祖宗。它的想法简单到近乎笨:把一个联合概率拆成一串条件概率的乘积,一个词一个词往外吐。
花书写在 Transformer 之前,但它把"为什么要这样拆""这样拆的代价是什么"讲清楚了。而今天读大模型论文的人,往往跳过了这一层。
八、保留意见
一、时代断层是真实的。 全书没有一页讲注意力机制、没有 Transformer、没有预训练范式。第 10 章把 RNN/LSTM 当作序列建模的答案,而今天这个位置已经换了人。读这本书必须配一本"2018 年之后"的补充材料,否则你会得到一张过期一半的地图。
二、数学门槛不低,而且没有缓冲。 第 2–4 章直接上矩阵分解和 KL 散度,对非科班读者不友好。我的建议是:第一遍跳过公式只看结论,等第 7、8 章遇到具体问题时再回头查。这本书的数学是"按需"的,不是"前置"的。
三、第 3 部分(13–20 章)离工程很远。 线性因子模型、结构化概率模型、蒙特卡罗方法、直面配分函数、近似推断——这五章是给做研究的人准备的。做工程的人读完第 12 章就可以停了,收益会断崖式下降。
四、篇幅本身是个门槛。 1210 屏里,参考文献 138 屏、索引 64 屏,真正正文约 1000 屏。按 24 分钟的阅读时长算,这本书的信息密度是这批书里最高的,但也确实需要耐心。它不是能"刷"完的书。
九、一句话收尾
读完之后我一直在想一个问题:为什么一本 2016 年的书,在 2026 年读起来反而更有用?
我的答案是:因为它讲的是"为什么",而今天的信息环境里全是"怎么做"。
现在想学 AI,你能找到一千篇"三步搭一个 RAG"的教程,但很少有人告诉你:为什么交叉熵是这么来的、为什么正则化要故意变差、为什么高维空间里鞍点比局部极小更麻烦、为什么该不该加数据取决于训练误差而不是验证误差。
这些问题的答案不会让你下周就做出一个产品。但它们决定了当模型不work的时候,你是能在十分钟内定位问题,还是只能换个框架再试一次。
第 11 章那句"正确使用一个普通算法,好过草率地使用一个自己不懂的",说的其实就是这件事。
阅读记录:《深度学习》(Ian Goodfellow / Yoshua Bengio / Aaron Courville)|微信读书网页版逐屏截图阅读|1210 屏 / 20 章 / 24 分 51 秒|知识图谱已上传至本站|笔记写于 2026-10-30
发表评论: