
AIGC从入门到实战:三个名字并列,Stable Diffusion 只分到十二屏
微信读书《AIGC从入门到实战:ChatGPT+Midjourney+Stable Diffusion+行业应用》(韩泽耀 / 袁兰 / 郑妙韵)· 抓取 328 屏 · 8 章 + 4 个附录 · reached_end=True,读到书尾附录 D
逐字核对 15 屏 · 本篇为重写:旧稿只读了 330 屏、判定「无记录」,等于把这本书当成了另一本。本轮从头翻到尾,屏数与章节标签全量切分,才看清它的真实形状——书名并列了三件工具,屏数却是 83 / 70 / 12。· 2026-11-11
抽样点位的选法:这本书按「工具 → 场景 → 行业」三段推进,所以我按配比抽:开头两屏核对书名与提要(p0006、p0002),第 1 章的年代划分(p0020),ChatGPT 章的写作范例与提问框架(p0050、p0090),Midjourney 的提示词公式与 logo 自评(p0130、p0170),Stable Diffusion 只剩的部署细节(p0193),职场章的截图式教学(p0210、p0250),行业章的电商、教育、工业三节(p0268、p0290、p0305),以及第 8 章与附录的事实核对(p0315、p0320)。抽读 15 屏约占 4.6%,但八章的屏数是全量统计,不是估的。
先把结论放在前面:这不是一本讲三件工具的书,而是一本 ChatGPT 操作手册,外加一节 Midjourney 配图课,再挂上十二屏 Stable Diffusion 当封面。328 屏里,ChatGPT 拿走 83 屏(25.3%),Midjourney 拿走 70 屏(21.3%),Stable Diffusion 只剩 12 屏(3.7%);被写进书名的「行业应用」是第 7 章,47 屏,14.3%。三件工具加起来 165 屏,刚过一半。
这个配比本身就是一个判断:作者最熟的是 ChatGPT,最想教的是提示词,最不敢深写的是 Stable Diffusion,最省力的是行业章。下面按这个顺序拆。
一、把配比摊开:83 / 70 / 12
按 pages.jsonl 的 chapter 字段全量切分,八章的实际屏数是:第 1 章 25 屏(p0009 起)、第 2 章 24 屏(p0034 起)、第 3 章 59 屏(p0058 起)、第 4 章 70 屏(p0117 起)、第 5 章 21 屏(p0187 起)、第 6 章 55 屏(p0208 起)、第 7 章 47 屏(p0263 起)、第 8 章 8 屏(p0310 起),前面还有版权、提要、序、前言共 8 屏,后面附录 11 屏(p0318 起)。加起来正好 328 屏。
第 5 章的 21 屏最值得单独看。它内部是这样分的:5.1 Stable Diffusion 12 屏、5.2 D-ID 6 屏、5.3 MetaHuman 2 屏,加一屏章首页。也就是说,这本书里真正属于 SD 的,只有 12 屏;而标题写着「生成你的数字人分身」的这一章,真正的重心其实是 D-ID 和 MetaHuman——两个把静态照片变成会说话视频的现成工具。SD 在其中扮演的是「先画一张小姐姐」的前置步骤。
这就解释了书名为什么读起来别扭。三件工具的排列是并列的(加号连接),但投入是主从的。ChatGPT 讲了「是什么、为什么能、怎么问、怎么编程、怎么规划职业」五个层次;Midjourney 讲了「怎么装、怎么写词、五个案例、自动生成提示词」四层;SD 只讲了「装在哪、文件放哪个目录、怎么画小姐姐」一层半。同一本书里,三件工具被当成三种不同的东西对待。
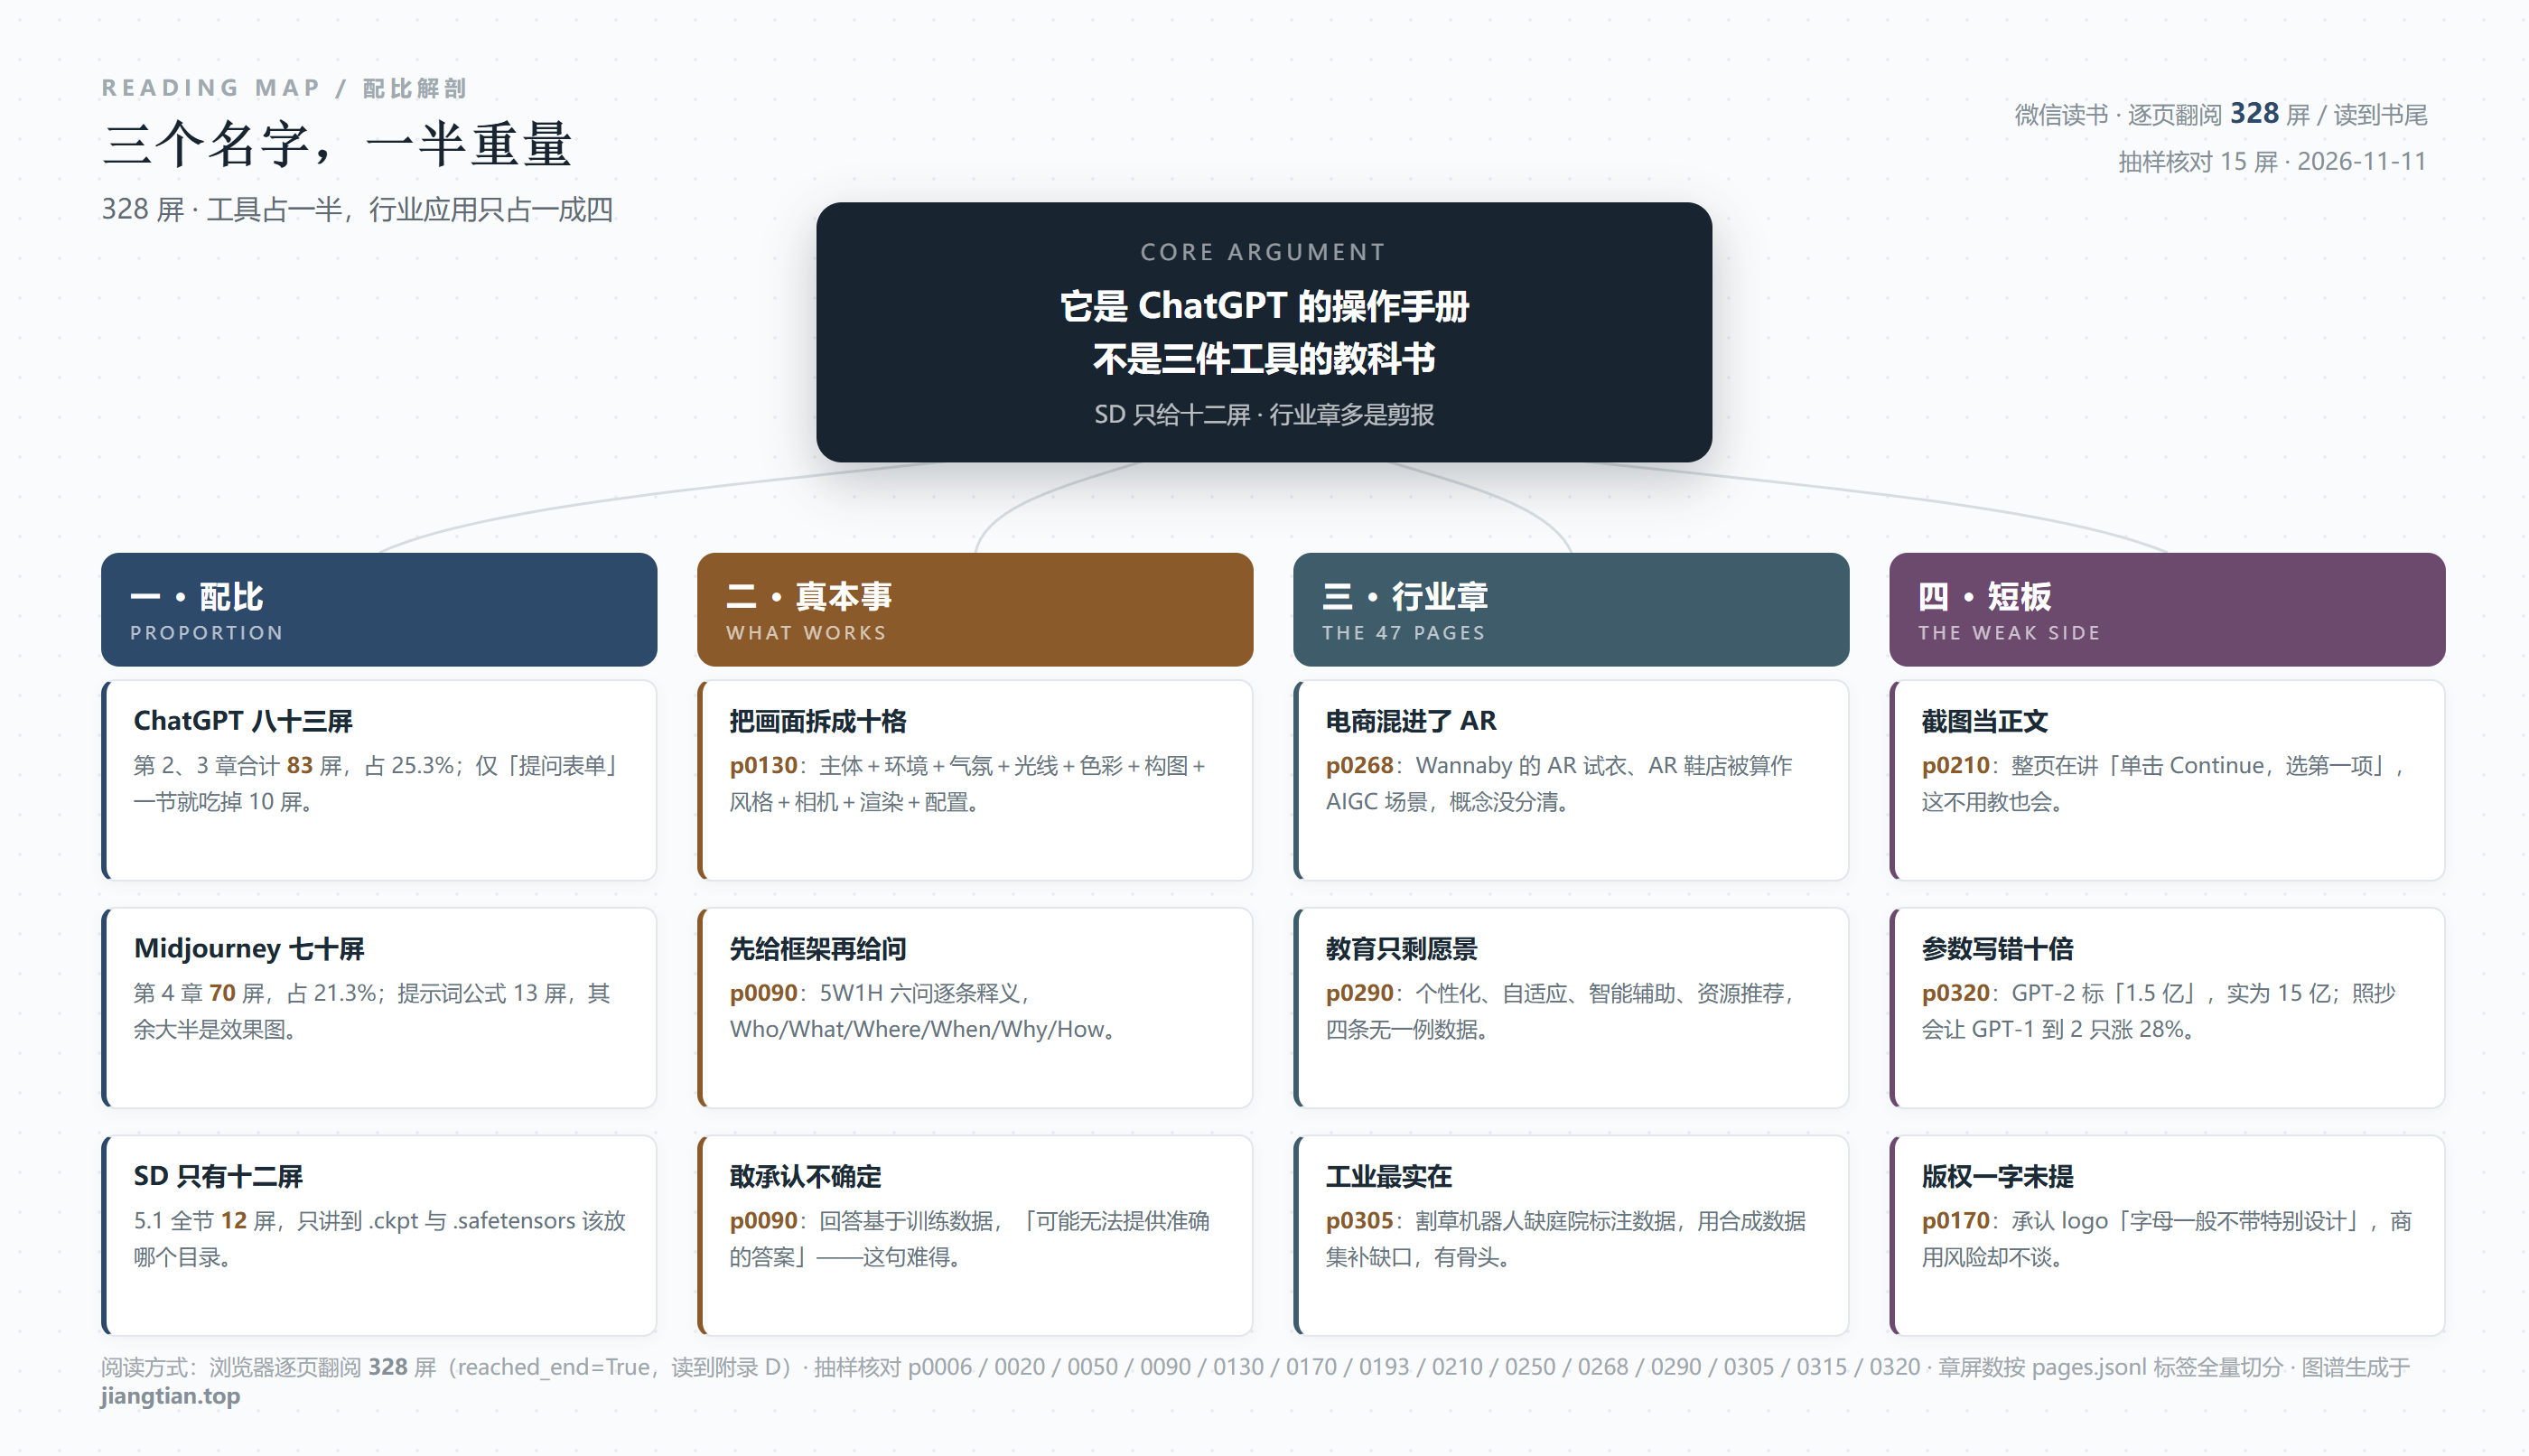
我在读之前预设过一个反驳:「SD 本来就比 ChatGPT 难,写浅一点是体谅读者。」这个理由站不住。同书第 3 章为了讲清「ChatGPT 为什么能生成有意义的文本」,用了 2.2.2 到 2.2.4 三节 6 屏去讲 Transformer 和预训练模型;讲 SD 的时候,连「采样器」「步数」「CFG」这三个必调的参数都没出现过一次。这不是体谅,是跳过了。
二、83 屏 ChatGPT:它真正教的是「怎么问」,不是「是什么」
第 2 章 24 屏,第 3 章 59 屏,合计 83 屏。但这两章的重量分布很不均匀:第 2 章的 24 屏里,有 9 屏是「超强的文科状元 / 理科状元」(2.3.1 三屏、2.3.2 六屏),也就是让 ChatGPT 现场表演写诗、写故事、解题;第 3 章的 59 屏里,3.2.2「简单的应用范例」13 屏、3.3.1 提示词写作技巧 7 屏、3.3.2 如何提问 6 屏、3.3.3 提问表单 10 屏——光是「怎么问」这一件事,就烧掉了 36 屏,占全书 11%。
这个投入是有回报的。p0050 是我抽到的最能说明它水平的一屏:它让 ChatGPT 写七言律诗,还让 ChatGPT 自己解释押韵,页面上给了一句很朴素的评语——「可以看到,七言律诗的押韵还是不错的」。同一屏的下半部分给了三个范例,第三个范例的提示词是:「写故事:用《肖申克的救赎》的故事框架,写一个贾宝玉穿越到现代创业、追爱、复仇的故事。」
这句提示词值得停一下。它不是「帮我写个故事」,而是给了一个可迁移的结构:拿一个成熟文本的骨架,换一套人物和处境。这是 2023 年那一批提示词书里最实用的一招,比任何「你是一位资深作家」的角色扮演前缀都管用,因为它约束的是结构而不是语气。一个读者学会这一招,可以把它套到广告脚本、产品文案、课程大纲上。这是真本事。
p0090 更进一步,把提问拆成框架:5W1H 六问——Who(谁,涉及人物或者实体的问题)、What(什么,询问事物、概念或者事件)、Where(哪里)、When(何时)、Why(为什么)、How(如何)。六条各配一句释义,再给六个例句:「阿尔伯特·爱因斯坦是谁?」「什么是相对论?」「长城在哪里?」「《独立宣言》是何时签署的?」「为什么我们需要睡觉?」「汽车引擎是如何运转的?」
坦白说,这六个例句很像小学语文的造句练习,信息密度不高。但框架本身是对的:它把一个模糊的「我该问什么」变成了六个必填槽位。对完全没接触过 ChatGPT 的读者,这一页的价值高于后面十页案例图。
问题出在第 2 章和第 3 章的分工上。第 2 章在证明「它很强」,第 3 章在教「怎么用它」,但没有一章在讲「它什么时候会骗你」。全书 83 屏 ChatGPT,讲局限的只有 p0090 结尾那半段,而且那半段还被放在「提问框架」的末尾,像是顺带的补充说明。这个我会在第七节展开。
还有一处分配值得记下来:第 3 章给「用 ChatGPT 写代码」的 3.4 节留了 9 屏(3.4.1 生成前后端代码 3 屏、3.4.2 分析跟踪算法代码 3 屏、3.4.3 提升编程与算法效率 3 屏),给「AIGC 时代职业该怎么规划」的 3.5 节只留了 3 屏。教工具怎么用花 9 屏,讨论「人会不会被替掉」花 3 屏,比例是 3:1。这不是篇幅问题,是兴趣问题——作者显然更愿意写「怎么让它干活」,不太愿意写「干完之后人干什么」。而后者恰恰是 2023 年最多人焦虑的事。
三、那一页难得的地方:它承认自己不知道
p0090 的结尾是全书我唯一想抄下来的一段。原文是:
「虽然 ChatGPT 可以回答这些问题,但它的回答是基于它在训练数据中看到的信息,而不是基于任何实际的知识或经验。因此,对于一些需要最新信息或者专门知识的问题,ChatGPT 可能无法提供准确的答案。」
——《AIGC 从入门到实战》p0090
这句话在 2023 年的 AIGC 图书里算是罕见的克制。绝大多数同类书的写法是「ChatGPT 无所不能,你只需要学会提问」,把幻觉当成一个可以靠提示词解决的工程问题。这本书至少在正文里写清了归因:它的答案是「基于训练数据中看到的信息」,不是「基于知识或经验」。这个区分很关键,因为它是后面所有「要不要核实」的推理起点。
可惜的是,这个起点没有被走完。全书 328 屏,没有一节讲「怎么核实」。没有讲交叉验证,没有讲让它给出处,没有讲答案里的数字要怎么回查。第 3 章 3.4 节讲用 ChatGPT 写代码(9 屏),也没有讲生成的代码怎么测、跑不通怎么办。它把「可能不准」这四个字写下来了,然后就翻页了。
这是我很在意的一种写法:它知道风险在哪,但把风险写成了免责声明,而不是写成了操作步骤。免责声明保护作者,操作步骤才保护读者。p0090 那句话如果后面跟着三屏「三个必须回查的数字类问题」,这本书的可信度会上一个台阶。
四、70 屏 Midjourney:把审美拆成十个格子
第 4 章是全书最厚的一章,70 屏,21.3%。它的分配是:4.1.1 上手 10 屏、4.1.2 提示词技巧 13 屏、4.2.1 古风 5 屏、4.2.2 萌版头像 11 屏、4.2.3 AI 化身 5 屏、4.3.1 logo 7 屏、4.3.2 建筑 10 屏、4.4 让 AI 自动生成提示词 6 屏。
p0130 是这一章的技术核心,也是全书我最愿意推荐给朋友的一页。它把提示词拆成九项,然后给了一个加法公式:主体描述+环境描述+气氛描述+光线+色彩+构图+作品风格+相机参数+渲染参数+配置参数。九项各自的词表都给了:光线有 volumetric lighting(体积照明)、bright(明亮的)、cold light(冷光)、soft illumination / soft lights(柔和的照明 / 柔光)、mood lighting(情绪照明);相机有 film(电影质感)、Fujifilm(富士胶片)、luxurious(奢华质感)、焦距 35mm、光圈 f1.8;宽高比 16:9、9:16、2:3;分辨率 4K、8K、16K、32K;渲染器 Unreal Engine(虚幻引擎)、octane render(辛烷值渲染)、Maxon C4D、Quixel Megascans Render、architectural visualisation(建筑渲染)、Corona Render(室内渲染)。
给的例句是:「A girl is standing, ports, ships, sunset, beautiful lighting, golden moments, surreal atmosphere, focused, detailed, cinematic quality, clouds in the sky...」——一个站在港口边的女孩,日落,好看的光,金色时刻,超现实氛围,聚焦,细节丰富,电影质感,天上有云。
这一页做对的事,是把「审美」翻译成了「可勾选的清单」。新手最怕的不是不会写英文,是不知道该写什么;给了十项,他就有了十个空格要填。这跟 p0090 的 5W1H 是同一个方法论:把开放性任务变成填空题。这也是这本书前后唯一一次方法论上的自洽——它在两个完全不同的工具上,用了同一种「先给槽位,再教填充」的教法。
但清单有清单的代价。十项公式的稳定产出,是「看起来很专业、彼此很像」的图。这本书 70 屏里有大量「同一提示词换风格词」的对照图,读者跟着做,多半也能出图,但出的是那种「一眼 AI」的图——光很足、景很深、构图很正、没有一处意外。公式教的是下限,不是上限。书里没有一页在讲「怎么故意破坏公式」:怎么留白、怎么让构图犯错、怎么用不完美的光。
更有意思的是作者自己在 p0170 的坦白。讲完 logo 案例(图 4-36,U1-U4 四张、V1-V4 四张放大),他写:「要特别注意的是,Midjourney 生成的 logo,字母一般不带有特别的设计,要得到成熟的 logo,还是要用其他工具做一些修改的。」接着又写:「花费 30 分钟左右的时间,基本就能挑出 3~5 张质量还算不错的作品,某种程度上也算达到了‘顺手设计个 logo’的效果。」
「字母一般不带有特别的设计」这句,比前面 13 屏提示词技巧都值钱。因为它说的是 Midjourney 在 logo 这件事上的真实边界:它能给你字形感、材质感、构图,但给不了可注册的标识设计。作者知道,也写了,只是写在案例的最后,用「还是要用其他工具」一句带过。这是全书的一个通病——真话总是出现在一节的末尾,而且不带操作。
4.4 那 6 屏是另一处有意思的地方,标题叫「魔法打败魔法,让 AI 自动生成提示词」。逻辑是让 ChatGPT 先写一段 Midjourney 提示词,再贴进去出图。这个思路在 2023 年是聪明的,在今天已经是标配。但它藏着一个这本书没讲的问题:让语言模型写图像提示词,写出来的一定是「语言上合理的词」,不是「视觉上有效的词」——它会把 cinematic、8K、detailed 这类词堆满,却不知道哪些词在 MJ 里真的起作用、哪些只是装饰。书里给了方法,没给「怎么判断生成的词好不好用」。
五、12 屏 Stable Diffusion:全书最名不副实的一节
5.1 节的 12 屏,我逐屏看了目录标签:5.1.1 硬件部署和运行工程源码 3 屏、5.1.2 安装权重文件和 LoRa 模型文件 3 屏、5.1.3 绘制美丽小姐姐的提示词写作技巧 5 屏,加一屏节首。十二屏里,讲「部署」的 6 屏,讲「写词」的 5 屏,讲「SD 为什么和 MJ 不一样」的,0 屏。
p0193 是部署段的一屏,内容是这样的:模型文件有两种格式,.ckpt(Model PickleTensor)和 .safetensors(Model SafeTensor),「据说 .safetensors 格式的文件相对更安全」;下载好的文件放到 stable-diffusion-webui\models\Stable-diffusion 目录下;放好之后需要重启 stable-diffusion-webui(运行 webui-user.bat);首次启动会自动下载 Python 依赖库,具体下哪些见 requirements.txt;示例文件名是 v1-5-pruned-emaonly.safetensors。
这一页的信息是准确的,路径、文件名、重启动作都对,对 2023 年第一次装 webui 的人是真有用的。但它回答的是「文件放哪」,不是「SD 怎么用」。一个读者照着做完,会得到一个能启动的界面,然后呢?采样器选哪个、步数给多少、CFG 拉到几、负面提示词写什么、ControlNet 怎么锁线稿、LoRA 权重 0.6 和 0.8 有什么区别——这六个问题,十二屏里一个都没答。
更值得注意的是那句「据说」。「据说 .safetensors 格式的文件相对更安全」——这是一本工具书里最不该出现的措辞。safetensors 之所以更安全,是因为它不像 pickle 那样在反序列化时执行任意代码,这是有明确机制的,一句话能说清。写成「据说」,等于把可核实的技术事实降级成了传闻,而读者要的恰恰是判断依据:我该不该为了省事去下 .ckpt。
第 5 章的结构也印证了这个判断。SD 12 屏之后,5.2 是 D-ID 6 屏(让照片里的人说话),5.3 是 MetaHuman 2 屏(三步建数字人)。这两节加起来 8 屏,比 SD 的「提示词技巧」还多。而 D-ID 和 MetaHuman 的操作逻辑,本质上是「上传—选模板—导出」,跟 ChatGPT 的「输入—等回答」是同一类交互,教起来省力;SD 要讲参数、讲控制、讲失败重试,教起来费力。这本书在费力处收了手。
这不是孤例。第 6 章讲短视频(6.5,11 屏),p0250 的教学是:先给一张分镜表(00:41-01:15 讲技巧 2,01:16-01:50 讲技巧 3,01:51-02:00 结束),然后写「我们只需保留上图中旁白部分的文案」,提示词就一句「请保留旁白部分的内容。」把「剪辑」简化成「让 AI 抄出旁白」,这是把工序里最难的部分(镜头、节奏、素材匹配)整段跳过了。SD 的十二屏,是同一种省略。
六、47 屏行业应用:一半剪报,一节有骨头
第 7 章 47 屏,五个行业:7.1 电商 11 屏、7.2 传媒 8 屏(含新闻 3、音视频 3、推荐 1)、7.3 金融 6 屏、7.4 教育 14 屏、7.5 工业 7 屏。厚度排序是:教育 14 > 电商 11 > 传媒 8 > 工业 7 > 金融 6。
这个排序很反常。按行业复杂度,工业最高、金融次之、电商最低;按书里的篇幅,恰好倒过来。原因不难猜:越是有现成新闻稿可摘的行业,写得越长;越是需要给具体流程的行业,写得越短。
p0268 在电商章,讲虚拟试穿:「AIGC 还推动了虚拟试穿功能的发展,从而降低了产品的退换率。」接着举 Wannaby 公司的两个产品——「AR Try-On」(AR 试衣)和「AR Shoe Store」(AR 鞋店),说用户用手机相机把衣服投射到自己身上,查看颜色、质地、合适程度。这段描述本身没错,但它讲的是 AR,不是 AIGC。AR 试衣的核心是人体关键点识别 + 三维贴合,跟生成模型是两条技术线。把 AR 装进 AIGC 的筐里,说明这一节的分类是按「听起来很新」来的,不是按技术路径来的。
p0290 在教育章,给了四条赋能方向:个性化学习体验(收集、分析学习数据与行为模式)、自适应教学(实时调整学习计划和资源)、智能辅助教学(帮教师做学情分析)、教育资源的个性化推荐(按兴趣推荐视频、练习题)。四条都写了「可以」,没有一条写「做到了什么程度」。14 屏的教育章,是全书最长的一个行业节,也是全书唯一一个从头到尾没有一个可核对数字的行业节。没有一所学校的试点数据,没有一个学生的时长对比,只有「例如,钛创星是一家专注于人工智能教育的青少年教育企业」这类公司介绍。
反过来,7.5 工业只有 7 屏,却是这一章唯一有骨头的。p0305 讲得极具体:机器人视觉模型要先设计网络、再用标注好的数据训练、得到参数、部署到 AI 芯片上;「为了训练割草机器人的视觉 AI 模型,需要将大量与庭院场景有关的经过标注的数据提供给模型训练,这就得做两项工作:数据集的采集和数据集的标注。这两项工作都非常耗时耗力。」然后给出 AIGC 的位置——合成数据集,补上采集与标注这两块最贵的成本。作者还顺手写了一句俏皮话:人工智能是「人工」+「智能」,采集和标注就是要「人工」完成的部分。
这一节之所以好,是因为它先讲清了「不用 AIGC 会卡在哪」,再讲 AIGC 补哪个洞。割草机器人这个例子选得准:庭院场景的标注数据确实难采、长尾多、季节变化大,合成数据在这里是有真实价值的。7 屏里,成本、瓶颈、替代方案三件事都落地了。同样的写法如果用在教育章,14 屏可以缩到 7 屏,但含金量会翻倍。
所以「行业应用」这四个字,在这本书里只兑现了五分之一。47 屏里,真正讲清了「这个行业的哪个环节贵、AIGC 怎么把它变便宜」的,只有工业那 7 屏。其余 40 屏,更接近行业观察短文:有名词、有公司、有愿景,缺成本结构和失败条件。
七、它的短板:截图当正文,错误没人校对
第一条短板最直观:大量篇幅是软件截图的文字转述。p0210 整页在讲 Gamma 的操作:「单击‘Continue’(继续)按钮,会出现如图 6-3 所示的界面,询问你是想新建演示文稿(Presentation)、文档(Document),还是网页(Webpage)。选择第一项——演示文稿。」这句话精确、无错、也完全没有信息量。界面上三个按钮摆在那,识字的人不需要教。第 6 章 55 屏里,这种「点哪里、填什么」的段落占了很大比重:6.1 做 PPT 13 屏、6.6 Copilot 8 屏,都是这个路数。
这类内容的问题是会过期,而且过期得很快。2026 年再打开 Gamma,界面早就改版;书里写的 webui 启动脚本、按钮位置、菜单路径,一半对不上。一本把「截图路径」当知识主体的书,保质期等于软件的一个大版本。而它讲原理的部分(2.2 节的 Transformer、p0020 的三阶段划分)反而没过期——这说明作者知道什么是长效的,只是没舍得在长效的部分多花屏数。
第二条短板更硬:事实错误没有人校对。p0320 是附录 B,逐条列 GPT 各代参数:GPT-1 于 2018 年发布,用了包含 1.17 亿个参数的模型;GPT-2 于 2019 年发布,「它的参数规模增大到了 1.5 亿个」;GPT-3 于 2020 年发布,1750 亿参数,特点是零样本学习;GPT-4 于 2023 年发布,一次能处理多达 25000 个单词的文本。
GPT-2 的参数是 15 亿,不是 1.5 亿。差了十倍,而且这个错误会当场自相矛盾:如果 GPT-1 是 1.17 亿、GPT-2 是 1.5 亿,两代之间只涨了 28%,可书里紧接着就说 GPT-2「文本生成能力令人印象深刻,它可以生成连贯、有趣且通常语法正确的段落」。用 1.17 亿到 1.5 亿解释「令人印象深刻」,逻辑上说不通;用 1.17 亿到 15 亿(约 13 倍)才说得通。一个数字错了,整段论证就悬空了,而编辑没有发现。
第三条短板是缺失,不是错误:版权与商用,全书一字未提。p0170 自己承认 Midjourney 生成的 logo「字母一般不带有特别的设计」,也承认要拿去用还得靠别的工具修,但「AI 生成的图形能不能商用」「用名人的名字当提示词有没有风险」「训练数据涉及哪些版权争议」——328 屏里没有一页碰过。而这本书的目标读者,p0002 写得很清楚:专业人士、创意工作者、职场人士。对这三类人,版权不是选修课,是第一章就该讲的东西。
第四条是时间感。p0020 把 AI 2.0 的起点定在 2022 年,说这是「应用落地时代」,AI 3.0「尚未到来」。这个划分在 2023 年成立,放在 2026 年读就有明显的时代印记:书里的 ChatGPT 停在 GPT-4,Midjourney 停在 V5 时代的界面,SD 停在 1.5 的权重文件。它不是写错了,是写早了——而工具书的宿命就是,写得越细,过期越快。这也解释了为什么它讲原理的部分今天还能读,讲操作的部分今天只能当史料。
最后一条,也是我最在意的一条:全书 328 屏,没有一屏在讲失败。没有一张出坏了的图,没有一段跑不通的代码,没有一次被 ChatGPT 带偏的经历。SD 那 12 屏只给出「文件放哪个目录」,不给出「放错了会报什么错」;MJ 的 70 屏只给成功案例,不给出「这个词堆了没效果怎么办」;第 3 章的编程 9 屏只讲「它能写」,不讲「它写的跑不起来时怎么定位」。一本只演示成功的工具书,会把读者对失败的耐受力教没——而真实使用中,八成时间是在处理失败。
八、谁该读,怎么读
如果今天还有人要读这本书,我的建议是跳读,按三段走。
第一段读 p0088 到 p0116(3.3 节全部,23 屏)。这是全书方法论最密的地方:5W1H 框架、提示词写作技巧、提问表单、以及 p0090 那段关于「基于训练数据而非知识经验」的坦白。这 23 屏教的是「怎么把一个模糊需求拆成可回答的问题」,这个能力不随模型版本过期。
第二段读 p0127 到 p0136(4.1.2,13 屏)。十项公式和词表到今天仍然能用,因为 Midjourney 的提示词结构这几年没大变。但要把 p0170 那句「字母一般不带有特别的设计」一起读进去,把它当成这一章的结论而不是脚注。
第三段读 p0303 到 p0309(7.5 工业,7 屏)。这是全书唯一一处把「行业痛点—成本结构—AIGC 切入点」三段讲全的地方,也是唯一一节可以拿去跟工程师对话而不心虚的内容。
至于 SD 那 12 屏、第 6 章的截图教学、第 8 章的 8 屏口号(工作+AI / 业务+AI / 业务×AI,p0315),可以整段跳过。第 8 章 8 屏讲「如何有效应对 AI 革命」,给出的三层框架本身不错,但每层只有一段话,连一个企业案例都没有——8 屏讲一个这么大的题目,本身就是一种态度。
还有一件事值得说:这本书的定位是诚实的。p0006 前言里,作者写他希望「让 AI 工具不再局限于科学家或程序员等专业人士的圈子里,而是成为像 Word 和 Excel 一样普惠大众的工具」。它确实做到了「普惠」——把门槛压到只需要会打字。但它没做到「实战」——实战要的是「搞砸了怎么办」,而这本书 328 屏里,几乎没有一页在讲搞砸。
一句话收尾:这是一本合格的 ChatGPT 入门书,一本不错的 Midjourney 词表,一节没写完的 Stable Diffusion,和一章半成品的行业观察——它的问题不在写得浅,在于把四样东西装订成了一本,还用了三件并列的书名。
阅读记录:微信读书《AIGC从入门到实战:ChatGPT+Midjourney+Stable Diffusion+行业应用》,韩泽耀 / 袁兰 / 郑妙韵 · 逐页翻阅 328 屏(reached_end=True,读到附录 D)· 章屏数按 pages.jsonl 全量切分 · 逐字核对 p0002 / p0006 / p0020 / p0050 / p0090 / p0130 / p0170 / p0193 / p0210 / p0250 / p0268 / p0290 / p0305 / p0315 / p0320 · 2026-11-11
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: