《AI Agent开发与应用》读书笔记:七个项目一套骨架,最值钱的是一张四列表
阅读方式:微信读书网页版,从版权页翻到第 12 章末,共 460 屏、12 章、8 分 42 秒。 结构很规整:前 5 章打地基(智能体是什么、技术框架、LangChain、LlamaIndex、快速上手),后 7 章是七个实战项目。
这本书的目录一看就明白:七个项目,七个业务场景——出行订票、智能翻译、邮件助理、面试助手、推荐系统、写作助手、在线客服。
读到第三个项目时我意识到一件事:这七章其实是同一章写了七遍。 骨架完全一样,只是换了业务对象。
而这恰恰是它最诚实的地方——因为现实中的 Agent 开发,本来就是这样。
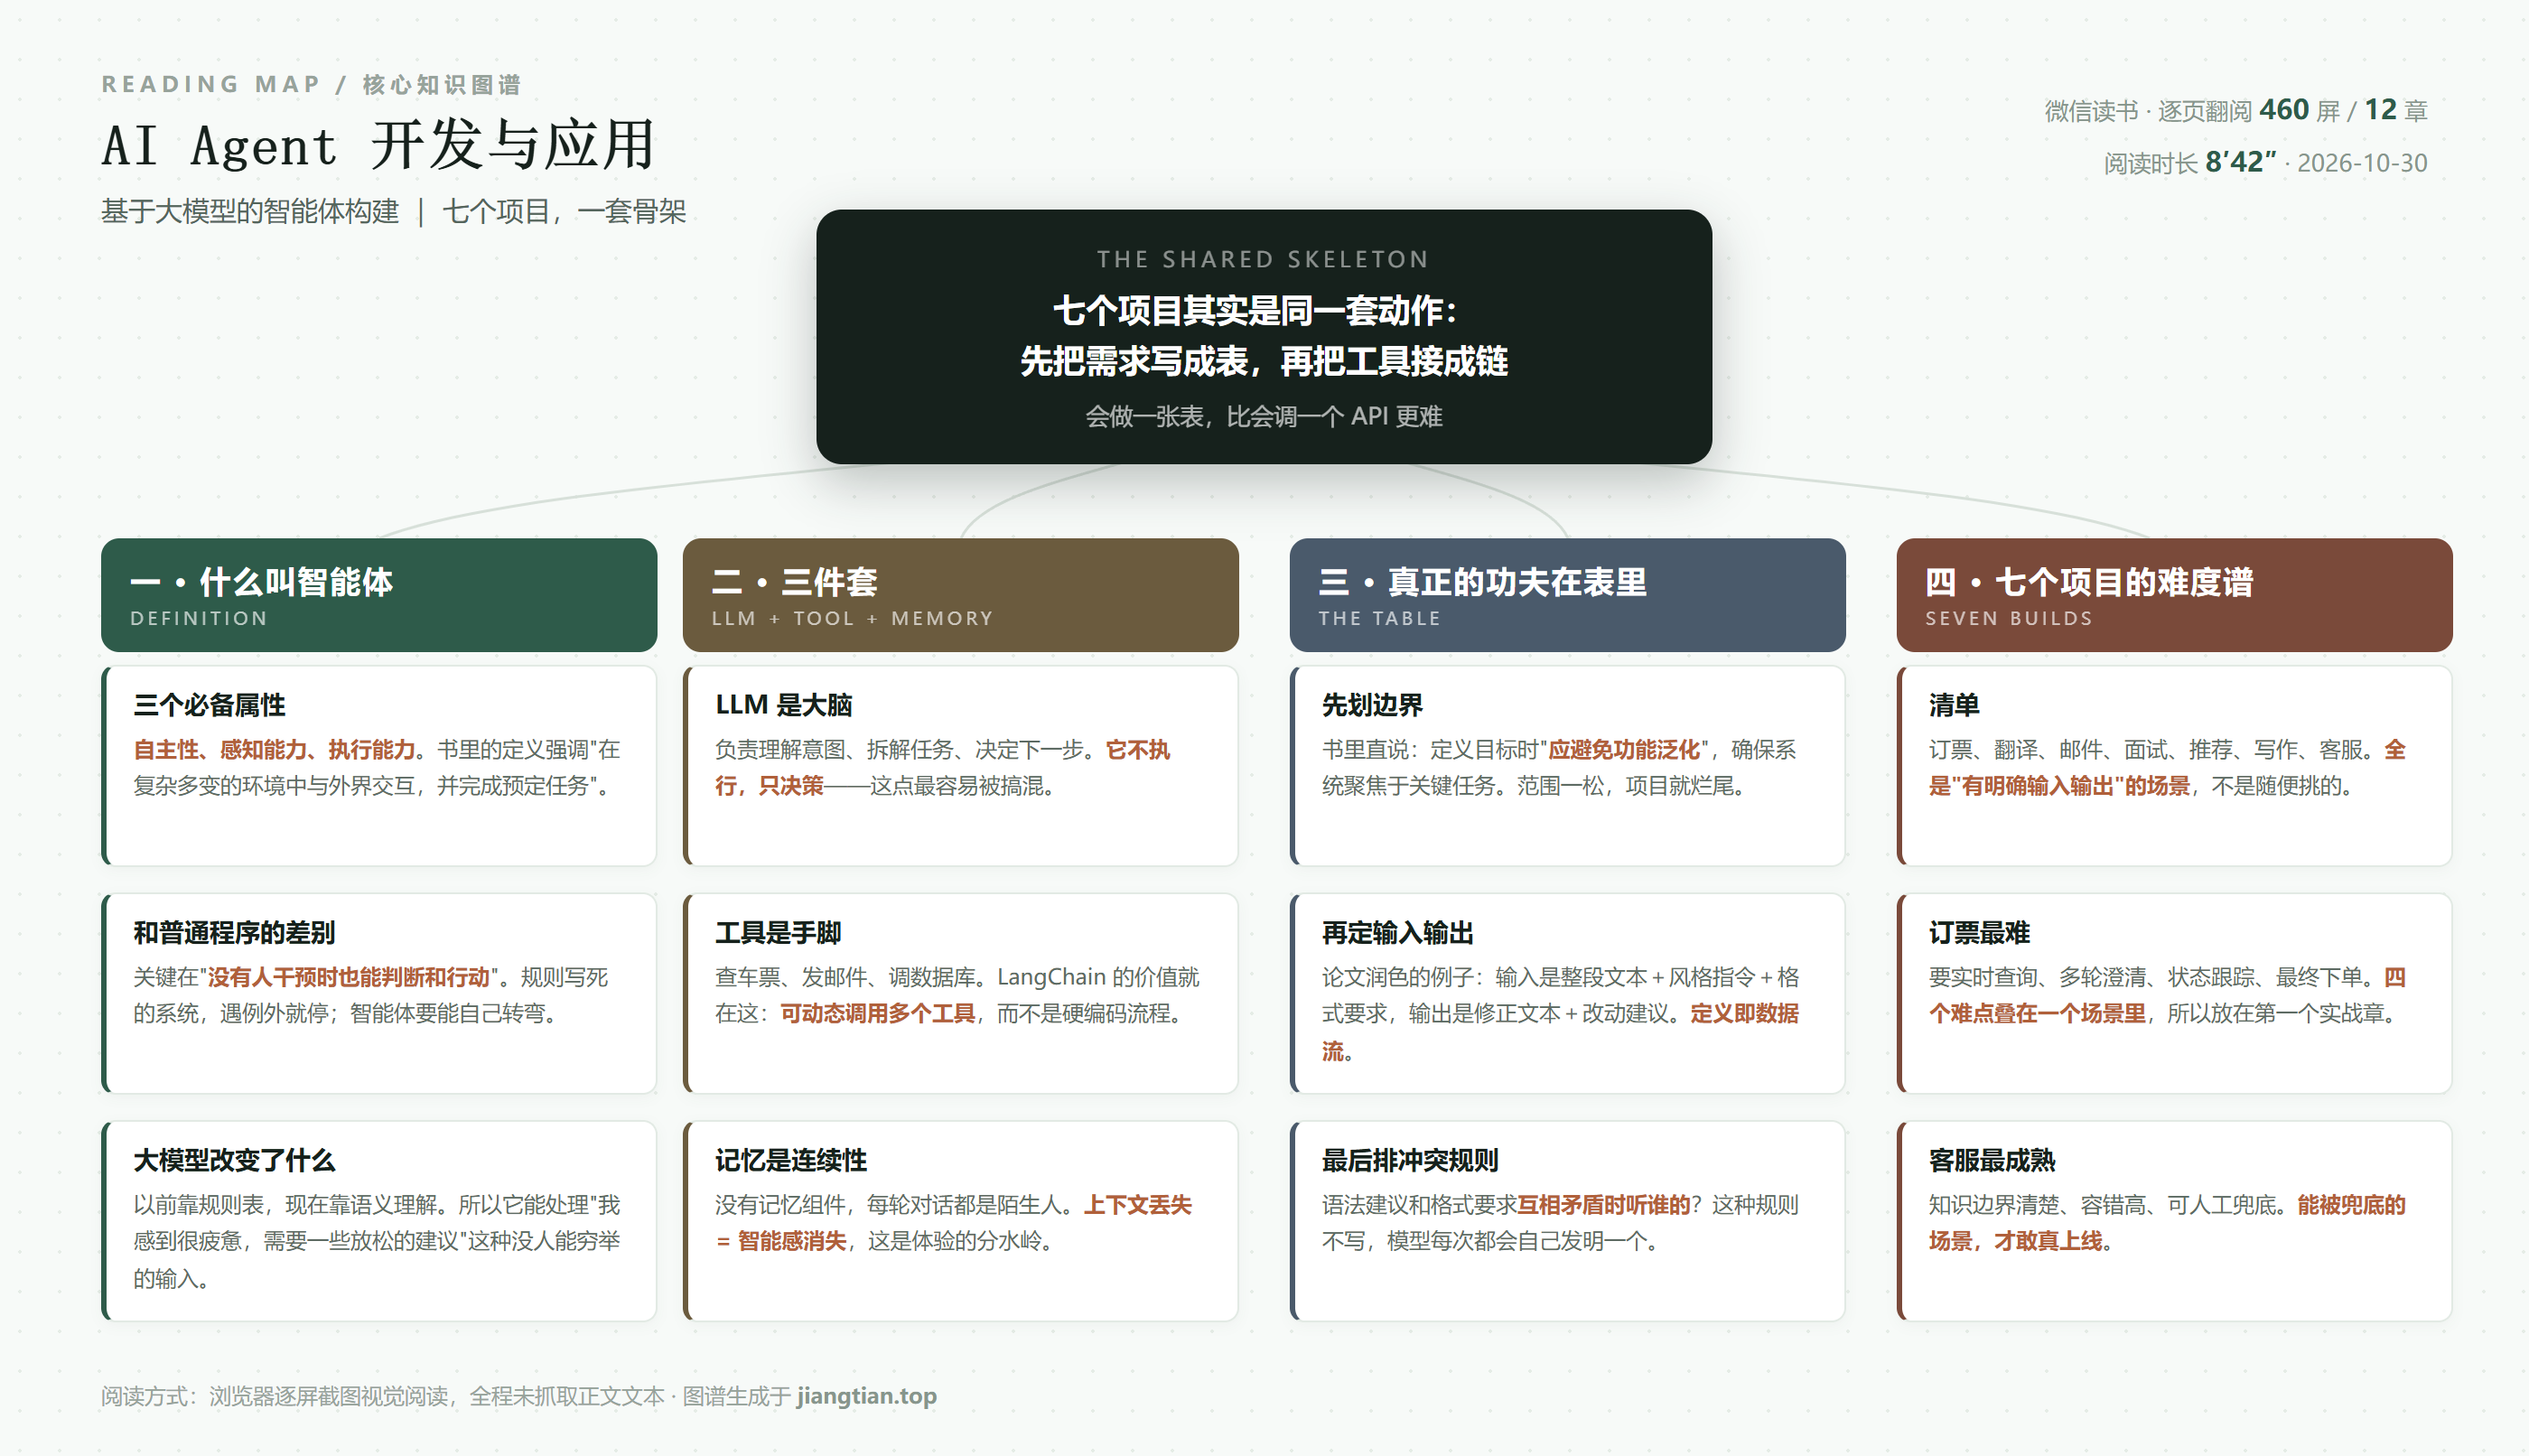
一、什么叫智能体:三个属性,一句关键
第 1 章给的定义很清楚:
"智能体是一个具备自主性、感知能力和执行能力的系统,能够在复杂、多变的环境中与外界交互,并完成预定任务。其特点在于具备一定的独立决策能力,能够在没有人工干预的情况下,基于收集到的信息进行逻辑判断和行动。"
三个属性里,我认为真正划界的是"没有人工干预"这五个字。
因为一个写死规则的自动化脚本,也有"感知"(读输入)和"执行"(写输出),但它遇到没预料到的输入就停住了,或者给出荒唐结果。而智能体必须在遇到例外时自己转弯——转弯这个动作,才是"智能"的落点。
书里还给了个很具体的例子来说明"语义理解"和"关键词匹配"的差别:当用户输入"我感到很疲惫,需要一些放松的建议"时,模型能识别出情感状态,提取"疲惫"和"放松的建议"两个核心需求,再生成"试试深呼吸和轻松的音乐"这类回应。
如果换成关键词匹配的系统,这句话大概会被匹配到"疲惫→睡眠建议",然后给你一篇养生文章。差别不在知识,在理解。
二、三件套:大脑、手脚、记忆
第 2 章讲框架,把 Agent 拆成三样东西,这个拆法我认为比很多更复杂的架构图好用:
LLM 是大脑。 它负责理解意图、拆解任务、决定下一步做什么。但请注意:它不执行,只决策。 这一点最容易被搞混——很多人以为"模型能力强了,Agent 就强了",其实模型再强,没有工具它也只能说话。
工具是手脚。 查车票、发邮件、调数据库、下单。第 6 章对 LangChain 的定位说得很准:
"LangChain 的设计理念围绕将大语言模型与外部工具整合展开,旨在为开发者构建一个可扩展的框架,使模型能够在复杂场景中发挥更强的作用。"
它列的第一条就是"多工具调用":允许开发者定义多个工具(如 API、数据库查询等),智能体在运行时可动态调用这些工具,实现交互式任务执行。
注意"动态调用"这个词。这是 Agent 和"固定流程脚本"的分水岭:脚本是 A→B→C 写死的,Agent 是"看情况决定先调哪个"。前者遇到异常就崩,后者能绕。
记忆是连续性。 第 3 章专门有一节讲"构建具备记忆能力的对话系统"。理由很简单:没有记忆,每轮对话都是陌生人。你说"帮我订明天去上海的票",它问"从哪里出发";你答"北京",它又问"您要去哪里"。
这三个零件里,工具决定能力上限,记忆决定体验下限。而大部分人做 Agent 失败,不是能力不够,是体验太差。
三、全书最值钱的一页:需求分析表
第 5 章"快速上手智能体开发",我原以为会是"装环境、跑 demo"那种内容。结果它上来讲的是需求分析——这本书最反直觉的安排。
它用"论文润色智能体"举例,说了三件事,每一件都值得抄下来:
第一,划边界。
"首先,必须明确系统的核心目标和业务范围。以论文润色智能体为例,任务包括语法检查、语言风格优化和格式校准……在定义目标时,开发团队应避免功能泛化,以确保系统聚焦于关键任务。"
"避免功能泛化"这五个字,是 Agent 项目死亡的第一大原因。所有人都想在第一个版本里塞进十个功能,结果每个都做不好,最后一个都不能用。
第二,定输入输出。
"功能设计的另一个关键点在于确定输入和输出的形式……输入和输出的定义有助于后续系统模块的设计和数据流的规划。"
书里给了具体清单:输入包括整段文本、风格指令(简洁表达或正式语言)、格式要求(APA 或 MLA);输出应与用户需求一致,比如提供修正后的文本、格式调整结果或改进建议。
为什么要做到这个颗粒度?因为输入输出的定义,本质上就是数据流的定义。你定不清"输出要不要带修改说明",后面的提示词、工具、界面全都定不下来。
第三,排冲突规则。 这一条最容易被跳过,也最要命:
"在复杂任务场景中,还需要定义多任务之间的优先级,以及当任务冲突时如何处理,例如在语法和风格建议相互矛盾时如何做出决策。"
举个具体的:一句话语法正确但风格啰嗦,你要它改简洁,改完语法就不那么严谨了——听谁的?
这种规则你不写,模型每次都会自己发明一个,而且发明得不一致。于是用户会发现"同一个问题问两遍,答案标准不一样",然后不再信任它。
最后书里给了一张需求分析表,四列:功能模块 / 输入类型 / 输出类型 / 依赖工具或模型。论文润色的例子填下来是:语法检查模块(输入论文段落,输出错误及建议列表,依赖语法检查 API)、风格优化模块(输入文本及风格指令,输出风格化后的文本,依赖 GPT 模型)、格式检查模块……
整本书 460 屏,如果只带走一样东西,我带走这张表。因为它把"我要做个 Agent"这句空话,变成了四列可以填满的格子。 填不满,说明你还没想清楚,别急着写代码。
四、七个项目,一张难度谱
后七章的项目,我按"难点在哪"重新排了个序,比书里的顺序更能说明问题:
订票(第 6 章)最难。 书里的描述是"该智能体不仅可以查询车票、优化出行方案,还能自动完成购票,并在多轮交互中保持逻辑一致性"——四个难点叠在一起:实时查询、多轮澄清、状态跟踪、最终执行不可逆。放在第一个实战章,其实是给读者一个下马威。
客服(第 12 章)最成熟。 知识边界清楚、容错高、有人工兜底。这类场景敢真上线,因为出错代价可控。
邮件、翻译、写作属于中间地带:输出可见、可编辑、可撤回,人可以在环里把关。
面试、推荐最微妙:它们涉及对人的判断,一旦出错不是"重来一次"能解决的。
这条难度谱背后其实是一条通用规律:能不能兜底,决定了能不能上线。 越是"错了可以改"的场景,越早被做出来;越是"错了没法撤"的场景,越晚。
五、为什么这七章看起来像同一章
读的时候我一度觉得重复:每个项目都是"需求分析 → 技术选型 → 代码实现 → 部署 → 本章小结 → 思考题"。
但转念想,这个重复恰恰是这本书想传达的东西——Agent 开发的手艺,不在某一个惊艳的算法,而在这套雷打不动的流程里。
而且七个项目换的不是"技术",是"业务约束":订票要处理实时性和不可逆;邮件要处理格式和语气;面试要处理隐私和公平;推荐要处理冷启动。这些约束才是真正的难点,也是唯一不能从教程里抄来的部分。
六、保留意见
一、代码占比过高,阅读体验差。 七个实战章里有大量 Python 代码块,在手机或网页阅读器里翻页极累,而且脱离运行环境基本无法验证。这类书更适合当 PDF/纸质工具书用,不适合逐屏读。
二、七个项目同构,读到第四个就疲了。 如果目的是"学会方法",读完第 6 章就可以跳到第 12 章看最成熟的案例;中间四章的信息增量主要是业务差异,不是技术差异。
三、没有失败案例。 七个项目全部"顺利实现"。而 Agent 开发真正的坑——工具调用超时、模型幻觉导致死循环、多轮对话里状态丢失——书里几乎没提。这类内容比成功路径更有价值。
四、教材体例带来的稀释。 每章都有"本章小结"和"思考题",这是为课堂教学设计的。对自学读者,这两块基本可以跳过,占了不少篇幅。
五、技术栈绑定较紧。 LangChain 和 LlamaIndex 的 API 迭代很快,书里的写法过一段时间可能需要对照新版本文档调整。读的时候重点看"为什么这么设计",别死记"这一行怎么写"。
七、一句话收尾
这本书让我改了一个看法。
以前我觉得做 Agent 的难点在"让模型会用工具"。读完发现,工具调用是最容易的那一段——LangChain 已经把这件事封装到几行代码。
真正难的是那张四列表:这个功能到底要什么输入、给什么输出、依赖哪个工具、和别的功能冲突时听谁的。
这四个问题答不清,你接再多工具,也只是做了一个会说话的脚本。
阅读记录:《AI Agent 开发与应用:基于大模型的智能体构建》(凌峰)|微信读书网页版逐屏截图阅读|460 屏 / 12 章 / 8 分 42 秒|知识图谱已上传至本站|笔记写于 2026-10-30
发表评论: