
AIGC原理与实践:七成屏在讲原理,「实践」只是原理的插图
微信读书《AIGC原理与实践:零基础学大语言模型、扩散模型和多模态模型》(吴茂贵 等)· 逐页翻阅 849 屏,读到书尾(第13章末页翻过,抓取标记 reached_end=True)· 全书十三章、325 个章节标签
逐字核对 13 屏(p0002 / 0006 / 0030 / 0090 / 0160 / 0240 / 0330 / 0420 / 0520 / 0620 / 0720 / 0820 / 0846),另按「每 24 屏取 1」抽了 35 屏做配比统计
说明一句:这本的小节标签很密(325 个),密到不能把标签当观点用——「13.2.2 离散型随机变量及其分布」是标签,「这本书把四分之一篇幅给了数学」才是观点。所以本篇只做两件事:把 849 屏的构成算清楚,再用能翻回去的页码说清它值在哪、缺在哪。
先给结论:这是一本 71% 在讲原理、14% 在贴代码、9% 在给结果的书;它叫「原理与实践」,但「实践」在书里更像原理的插图,而不是可以照着做完的工程。这个配比不是缺点本身——缺点是它同时向「零基础读者」承诺了入门,又把这门课最难的一段(概率论与推断,184 屏)放在了第 662 页。
一、先把账算清:七成屏在讲道理,一成四在贴代码
849 屏按大章切下来是这样的:第1章 AIGC概述 39 屏、第2章 深度神经网络 136 屏、第3章 变分自编码器 38 屏、第4章 生成对抗网络 41 屏、第5章 StyleGAN 40 屏、第6章 风格迁移 35 屏、第7章 注意力机制 44 屏、第8章 Transformer 63 屏、第9章 大语言模型 59 屏、第10章 ChatGPT 74 屏、第11章 扩散模型 37 屏、第12章 多模态模型 48 屏、第13章 AIGC的数学基础 184 屏;另外版权、简介、前言 7 屏,作者简介 1 屏,文后 3 屏。合起来正好 849。
光看这个大账就能看出两件事。第一,数学章 184 屏,占 21.7%,是全书最长的一章,比「扩散模型 37 屏 + 多模态 48 屏」加起来(85 屏)还多一倍有余。第二,真正讲大模型的两章(第9、10章)共 133 屏,占 15.7%;而书名里并列的「扩散模型」只有 37 屏(4.4%),是十三章里倒数第二薄的一章。
还有一个数字值得单独说:第2章那 136 屏(16.0%)。这一章的目录是「用 PyTorch 构建深度神经网络 → 用 PyTorch 实现神经网络实例 → 用 PyTorch Lightning 实现 → 构建卷积神经网络 → 构建循环神经网络 → 迁移学习 → 归一化 → 权重初始化 → 损失函数 → 优化算法」,一路从 nn.Module 讲到动量、AdaGrad、RMSProp、Adam 的更新公式,最后还有「2.10.8 各种优化算法比较」。这已经不是「AIGC 概述」的一部分,而是一门独立的深度学习入门课,被硬塞进一本讲生成模型的书里。它有用,但它把书的起点拉得很低,也把「零基础」这个承诺兑现了一半——只是兑现的方式是让你先花 136 屏补课。
但章数只说明篇幅分给了谁,不说明这些屏在干什么。所以我又按「每 24 屏取 1」抽了 35 屏(约占 4.1%),一屏一屏看画面主体是什么——这一步很土,但比按小节标题猜要可靠:很多标题叫「构建编码器」的小节,画面里其实一半是讲解。抽样结果是:讲解与公式 18 屏(51.4%)、架构示意图 7 屏(20%)、整屏代码 5 屏(14.3%)、跑出来的结果图 3 屏(8.6%)、章首页 2 屏(5.7%)。把讲解、公式、示意图合起来算「原理」,是 25 屏,71.4%;代码 14.3%;结果 8.6%。
换成一本书的说法:你每翻十屏,七屏在讲「为什么这样设计」,一屏半在贴代码,不到一屏在给你看「跑出来长什么样」。这个比例落在一本「原理与实践」的书上,其实不算离谱——原理书本来就该多讲理。真正的问题不在比例,在比例和承诺的错位,这要放到后面几节说。
顺带交代一下我的算法边界:抽样是按固定间隔取的,35 屏里有 2 屏是章首页(纯标题页),会略微压低「内容屏」的密度;「原理示意图」和「运行结果图」的界线是我看图判断的——架构图、流程图算原理,人脸、散点、掩码矩阵、风格迁移前后对比算结果。这条界线有主观成分,所以下面凡是引用具体数字的地方,我都尽量把页码带上,你可以自己翻回去核对。
二、第 662 页才开数学课,等于没开
第13章从 p0662 开始,一直占到 p0845。这一章里最厚的几个小节是:13.4.5 马尔可夫链蒙特卡罗随机采样 26 屏、13.4.3 EM算法 24 屏、13.2.5 多维随机变量及其分布 16 屏、13.5.1 强化学习基本概念 16 屏、13.2.2 离散型随机变量及其分布 15 屏、13.5.3 策略梯度 13 屏、13.4.1 极大似然估计 12 屏。
把这份名单和全书对照,会发现一个很刺眼的事实:全书只有 8 个小节超过 10 屏,其中 7 个在第13章,唯一的例外是 10.6.3「标注排序序列替代直接打分」(10 屏)。也就是说,这本书所有「需要连续读十屏以上才讲得完」的内容,几乎全部集中在数学章——模型章里那些真正难的地方(注意力怎么算、扩散怎么反推、CLIP 怎么对齐),全被切成了两三屏一段。
这带来一个很具体的阅读后果:你想读懂第11章的 DDPM,绕不开变分下界和重参数化,而这些东西在第 662 页之后。按正常阅读顺序,读到 p0590「训练目标和损失函数」时,你手上没有那份数学;等你翻到 p0758 的 EM 算法、p0785 的 MCMC 时,第11章已经过去快两百屏了。知识不是没给,是给错了位置。
更麻烦的是这一章的自洽性。p0720 是第13章里的一屏,整屏只有一张三维曲面图,图注「图13-10 各向同性的高斯分布」,坐标轴从 −3 到 3、纵轴 0 到 1,页面底部已经是「下一章」按钮——也就是说,这一章用一张标准正态的三维曲面图收尾,前面 26 屏的 MCMC、24 屏的 EM,最后落在一个最基础的分布示意上。p0820 讲贝尔曼方程,式(13.45) 把 vπ(s) 展开成四行等号,式(13.46) 给出 qπ(s,a)=Σ p(s′,r|s,a)[r+γvπ(s′)],推导是规整的、编号是连续的,但它是第 820 屏——一本讲 AIGC 的书,强化学习的价值函数要到第 820 屏才出现,而此时读者对「策略梯度为什么要用优势函数」的耐心基本已经耗尽。
这里要说公道话:把数学放最后,在教材里是一种常见编排,目的是「先让你看见东西,再告诉你为什么」。这个思路对第3、4、5章的生成模型是成立的——先看 VAE 生成的人脸(p0219 一带的「生成新头像」),再看变分推断,动机清楚。但它对第9、10、11、12章不成立,因为大模型和扩散模型的「看见东西」本身就要靠公式才看得懂:你没法先直观理解「噪声预测」,再理解「ε-预测的参数化」。
三、325 个标签,130 个只有一屏:目录的密度骗了人
这本书的目录看起来非常充实:325 个章节标签,平均每个 2.61 屏。但把每个标签的屏数拉出来,形状会变:只有 1 屏的小节有 130 个(40%),不超过 2 屏的有 225 个(69.2%)。换句话说,目录里七成的条目,翻一页就过去了。
最极端的对比在同一本书里:11.1.1「DDPM」1 屏,13.4.5「马尔可夫链蒙特卡罗随机采样」26 屏。前者是全书的核心模型之一(书名里「扩散模型」的正主),给了 1 屏;后者是一个在 AIGC 书里几乎用不到的采样算法(MCMC 主要服务于贝叶斯推断),给了 26 屏。再比如 1.3.1「生成模型的框架」1 屏、12.4.2「Stable Diffusion XL」1 屏——SDXL 是 2023 年最重要的开源文生图模型之一,在这本书里只有一屏的篇幅,连它的双文本编码器都没展开。
我不认为这是作者偷懒。更可能的解释是:这本书是按「知识点清单」写的,而不是按「论证链」写的。清单式写法的好处是查得动——你想知道「什么是独热编码」,翻到 p0030 就能看到四种表示法并列(整数表示、独热编码表示、分布式表示、连续表示),每条两三句话,定义清楚。坏处是清单不承担论证:为什么这里要用分布式表示而不是独热?书上只在整数表示那一条里提了一句「这种表示方式会引入一个假象的顺序关系」,然后就没有然后了。
清单化的极致在第13章第1节:13.1「矩阵的基本运算」下面挂着五个小节——矩阵加法 1 屏、矩阵点积 1 屏、转置 1 屏、矩阵的阿达马积 1 屏、行列式 2 屏,八个屏讲完五件事。这里的写法是标准的「定义 + 一个例子」:矩阵加法就是把对应元素相加,点积就是对应元素相乘再求和,转置就是把行列互换。对复习有用,对理解没用;而它们占掉了目录里五个条目的名额,让「325 个标签」这个数字失去了参考价值——标签多,不等于内容厚。
这也是我提醒「别把小节名当观点」的原因。325 个标签里,绝大多数是「名词 + 展开」的结构(13.1.1 矩阵加法、13.1.2 矩阵点积、13.1.3 转置……),它们告诉你书里覆盖了哪些点,但不告诉你作者怎么想。真正带判断的段落,往往藏在某一屏的正文里,而不是标题上——比如 p0240 那段关于 GAN 为什么难训的解释,标题只叫「4.3.3 GAN模型坍塌的原因」,正文却是全书少见的、有观点的一段话。
四、代码是真的,但它是演示级代码
先承认一点:这本书的代码不是伪代码凑数。p0330 那一屏,整屏都是 StyleGAN 生成器的层定义:nn.Conv2d(opt.nef*2, opt.nef*4, 4, 2, 1, bias=False)、nn.BatchNorm2d(opt.nef*4)、nn.LeakyReLU(0.2, inplace=True) 一行接一行往上堆,中间夹着中文注释「# 采用转置卷积,opt.ngf 为该层输出通道数」,最后是 nn.ConvTranspose2d 把特征图放回图像尺寸,forward 里还有 nn.parallel.data_parallel(self.main, input, range(self.ngpu)) 这样的多卡分支。这是可以粘进编辑器跑的 PyTorch,不是「示意一下」。
但「能跑」和「能学」是两件事。这一屏给我的印象是:它展示的是「网络长什么样」,不是「工程怎么搭起来」。同一屏里看不到数据管道、看不到训练循环、看不到随机种子和 checkpoint,也看不到超参是从哪来的——这些在书里被拆到别的小节,读者要自己拼。对已经写过 PyTorch 的人是复习,对「零基础」的读者,这一屏基本只能照抄,抄完不知道哪一行可以改。
更值得注意的是代码的分布。按小节标题归并,「实现 / 从零 / 构建 / 训练 / 微调」这类小节共 63 个、173 屏(20.4%);但抽样看画面,整屏是代码的只有 14.3%。差额去哪了?在「讲一句、贴一段、再讲一句」的夹叙夹议里。这种写法在教学上没错,在查阅上很难受——你想找「DDPM 的采样函数怎么写」,得在 11.2 的 21 屏里翻。
反差最大的是第11章的 11.2。这一节叫「使用PyTorch从零开始编写DDPM」,从 p0593 到 p0613 共 21 屏,目录一条条列着:创建数据集、创建数据加载器、可视化数据集、DDPM架构、用残差块取代双卷积模块的优势、创建扩散类、正向扩散过程、可视化正向扩散过程、基于训练算法和采样算法的训练、从零开始训练DDPM、使用DDPM生成图像。这是全书结构最完整的一段实践——数据、模型、训练、采样、出图,一条链没有断。它证明作者完全有能力把「实践」写扎实,问题只在于这样的段落在 849 屏里太少:整本书只有 11.2(21 屏)、8.2(32 屏)、5.4(17 屏)三处达到了这个完成度,其余章节的实践部分基本停在「贴一段关键代码」。
还有一处我觉得可惜:p0160 讲传统梯度更新,用的是伪代码——「初始化参数向量 θ、学习率 λ」「while 停止准则未满足 do」「gt=∇θL(f(x(i);θ),y(i))」「θ←θ−λgt」。这段伪代码本身没问题,紧接着的解释也对:「对超参数学习率比较敏感(过小导致收敛速度过慢,过大又越过极值点)」,还引了图2-52a、图2-52c 说明学习率过大过小的两种失败。但全书从第2章到第10章,优化器这条线的处理方式一直是「讲原理 + 伪代码 + 一张示意图」,没有给一段可以真的跑出 loss 曲线的代码。这正好是下一节要说的事。
五、结果给得太省:一张 6×6 的掩码图占满一屏
p0420 是全书给我印象最深的一屏,因为它几乎什么都没说。页面顶部两行代码:plt.figure(figsize=(5,5))、plt.imshow(subsequent_mask(6)[0]);中间一句「运行结果如图8-23所示。」;下面一张 6×6 的矩阵图,下三角是浅色、上三角是深色,横纵轴刻度 0 到 5;图注「图8-23 序列掩码示意图」。一屏结束。
这张图是对的——它确实把「因果掩码」讲清楚了,6×6 的下三角一眼就懂。问题在于它只证明「函数返回了什么」,不证明「模型学会了什么」。而全书抽样里,类似「一张小图 + 一句『运行结果如图 x-x 所示』」的结构,占了结果类页面的多数(我抽到的 3 屏结果页,两屏是这种示意矩阵/散点)。真正需要被看见的东西——训练 loss 曲线、不同 epoch 的生成样本对比、失败案例、显存与耗时——在 849 屏里我几乎没有遇到。
这对一本标着「实践」的书是个硬伤,因为生成模型的实践,绝大部分时间花在「它为什么不收敛」上,而不是「它收敛后长什么样」。p0240 那段话其实说到了点子上:
「这个等价最小化目标存在两个严重的问题:一是它同时要最小化生成分布与真实分布的KL散度,却又要求最大化两者的JS散度,即一个要拉近,一个却要推远,这在直观上非常荒谬,在数值上则会导致梯度不稳定。」(p0240,4.3.3 GAN模型坍塌的原因)
这段话是我在整本书里读到的最好的一段——它不解释「什么是 KL 散度」(那个在第13章),而是直接告诉你「这个目标函数在设计上是自相矛盾的」,并且立刻给出后果:梯度不稳定、模式坍塌。紧接着 4.3.4 给了两条对策:换损失函数(Wasserstein 距离、Hinge Loss)、换网络结构(更深更宽)。有诊断、有处方,这才叫「原理与实践」。
可惜这种段落在 849 屏里是稀缺品。多数地方停在「是什么」,少数地方走到「为什么」,几乎没有地方走到「我试过,这样不行」。而后者恰恰是读者最想从一本 20 年经验的作者那里拿到的。
六、但有四处确实值得抄下来
批评说完,得把这本书真正值钱的地方点清楚。我翻回去核对了四组内容,都是「别的书讲得没它清楚」或者「别的书懒得给数字」的。
第一处是公式编号体系。这本书的公式是连续编号的,而且和正文强绑定:p0090 给出卷积后矩阵尺寸 (n+2p−f)/s+1,编号 (2.2);p0520 讲 PPO,一口气给出 (10.2) At=Q(st,at)−V(st)、(10.3) LC(θ)=E[(V(st)−Vtarget)2]、(10.4) Lentropy(θ)=E[−log πθ(st)];p0820 给贝尔曼方程 (13.45)、(13.46)。这意味着你可以把它当手册用:忘了 PPO 的熵奖励长什么样,翻到第 520 屏就有,不用重新推导。
第二处是 p0520 对 PPO 那句「人话」解释。书上写:「clip() 函数将 rt(θ) 限制在 1-ε 和 1+ε 之间,从而使比率保持在合理范围内,防止当前策略与旧策略相差太远,这或许就是近端策略的含义。」后面又补一句 min() 的作用是「确保目标是未裁剪目标下限的最小化函数」。PPO 的论文里这一段是公式加一段拗口的英文,这本书用两句话把它说完了,还老实承认「或许」——这个措辞我喜欢,比硬下定义可信。
第三处是 p0620 的 CLIP 参数表。这一屏给的信息密度是全书最高的一屏:文本编码器「固定选择一个包含6300个参数的Text Transformer模型」;图像编码器两条线,CNN 侧是 ResNet50、ResNet101、RN50x4、RN50x16、RN50x64 五个模型,「后面3个模型是按照EfficientNet缩放规则对ResNet分别增大到4倍、16倍和64倍得到的」,Transformer 侧是 ViT-B/32、ViT-B/16、ViT-L/14;训练设置是「所有的模型都训练32个回合,采用AdamW优化器,而且训练过程采用了一个较大的批量大小:32768」。零样本分类那两步也写得干脆:先按标签造句子「A photo of {label}」送进文本塔拿到 N 个文本特征,再和图像特征算相似度取最大。
顺手说一句:书上「6300个参数」应为 6300 万(63M),这是排版掉的量级。这种小错在 849 屏里不算少,读的时候得自己带计算器——但也正因为数字给得具体,错才看得见;含糊其辞的书连错都挑不出来。
第四处是 p0090 的多通道卷积图。图2-20 把「输入 3×5×5、卷积核 3×3×3、卷积结果 3×3×3、输出 1×3×3」四个张量并排画出来,中间用乘号和等号连接,每个小格都填了具体数字(0/1/2/3 和 7/5/3/4/7/5…)。通道这个维度对初学者是最难「看见」的,大部分书用一句话带过,这本书用一张填了数字的图把它钉住了。配套的式(2.2) 就在同一屏上方,图和公式挨着,这是好排版。
七、它的短板:三个缺口,一个错位
第一个缺口是题材。325 个标签里,「视频」0 次、「语音」0 次、「Agent / 智能体」0 次、「RAG / 检索」0 次、「部署」0 次。这本书的技术清单止于 DALL·E 3(12.5.4,3 屏)和 SDXL(12.4.2,1 屏)。对 2023 年成书的作品,这不算失职;但对 2026 年拿起它的读者,这意味着书里最前沿的部分已经过期两年——而 AIGC 恰好是这两年变化最大的领域。它现在更像一本「生成模型原理史(截至 2023)」,而不是「AIGC 实践手册」。
第二个缺口是验证。9% 的结果屏、几乎为零的训练曲线、没有失败样本对比,让「实践」这一半无法自证。读者照着 p0330 抄完 StyleGAN 的生成器,跑出来是一团噪声还是人脸,书里没有图像告诉你「正常应该长这样」。相比之下,p0217 那几屏 GAN 生成的人脸、p0313 那组风格迁移前后对比,是全书少见的「有效证据」——有对比、有前后、能判断成败。
第三个缺口是版本与可复现性。书里的代码依赖 PyTorch 生态,但 849 屏里没有一屏交代环境版本、随机种子、显存需求。这不是苛求:一本号称「从零开始」的书,读者第一步就会卡在「 pip install 什么版本」上。p0846 的作者简介说吴茂贵有「超过20年的实战经验」,著过《Python深度学习:基于TensorFlow》《Python深度学习:基于PyTorch》《深入浅出Embedding》——这些书的口碑恰恰建立在「能跑通」上,所以这一本的省略显得可惜。
一个错位则是读者定位。p0002 的内容简介写得很明确:
「本书旨在帮助没有任何人工智能技术基础的工程师们全面掌握AIGC的底层技术原理,以及大语言模型、扩散模型和多模态模型的原理与实践。本书的核心价值是,首先为想学习各种大模型的读者打下坚实的技术基础,然后再根据自己的研究方向展开深入的学习,达到事半功倍的效果。」(p0002,内容简介)
「没有任何人工智能技术基础」和「184 屏概率论 + 24 屏 EM + 26 屏 MCMC」放在同一本书里,是矛盾的。零基础读者读到 13.4.3 会直接放弃,有基础的读者又会在第2章那 136 屏(卷积、池化、归一化、优化器逐个讲)上浪费时间。它真正的读者是中间那一层:写过 PyTorch、调过模型、但没系统学过生成模型数学的工程师。对这群人,这本书非常合适;对两头的人,都不合适。书名里的「零基础」,是营销,不是描述。
八、怎么读才不亏:把它当地图,别当教程
如果非要给一个读法,我的建议是倒着来。先读第9、10章(大模型与 ChatGPT,133 屏),把 GPT 的自回归、BERT 的掩码、RLHF 的三段式(指令微调 → 奖励模型 → PPO)建立起来;p0520 那三行公式在这个时候看,比在第 520 屏按顺序读到要有效得多。再读第11、12章(扩散与多模态,85 屏),重点看 11.2 的 21 屏 DDPM 实现和 12.1.4 的 8 屏 CLIP 运行——这两处是全书的「实践浓度」最高的地方。第13章不要通读,当字典:需要哪个公式,按 13.x 的编号去查,查完就合上。第2章可以整章跳过,除非你确实没写过卷积。第3、4章(VAE 与 GAN)挑着看:3.2.2「变分自编码器的原理」6 屏讲清了重参数化为什么必要,3.4「使用变分自编码器生成面部图像」6 屏是从编码器到出图的完整流程,4.2「用GAN从零开始生成图像」7 屏配 4.3.2「模型坍塌的简单实例」3 屏,能把「生成器与判别器为什么互相拆台」看得比较具体。这三段加起来不到 25 屏,密度比第2章那 136 屏高得多。
至于第5、6、7章(StyleGAN、风格迁移、注意力),我的看法是:第7章值得读,第5、6章可以只读代码。注意力机制那 44 屏把「为什么需要 QKV」讲得比多数博客清楚;StyleGAN 的 40 屏里,真正不可替代的是 5.4 那 17 屏的生成器实现,前面 ProGAN 的演进史可以快翻。
最后说一句总评。这本书的骨架是扎实的:十三章覆盖了从神经网络到扩散、多模态、数学基础的全链条,公式连续编号、代码真实可抄、示意图大量带数字,这些都是「写得认真」的证据。它的问题不在认真程度,在取舍——把 184 屏给了数学,把 1 屏给了 DDPM,把 9% 给了结果,把「零基础」写在了封面上。它是一张画得很细的地图,标注了每座山的高度,但没有告诉你哪条路能走通。
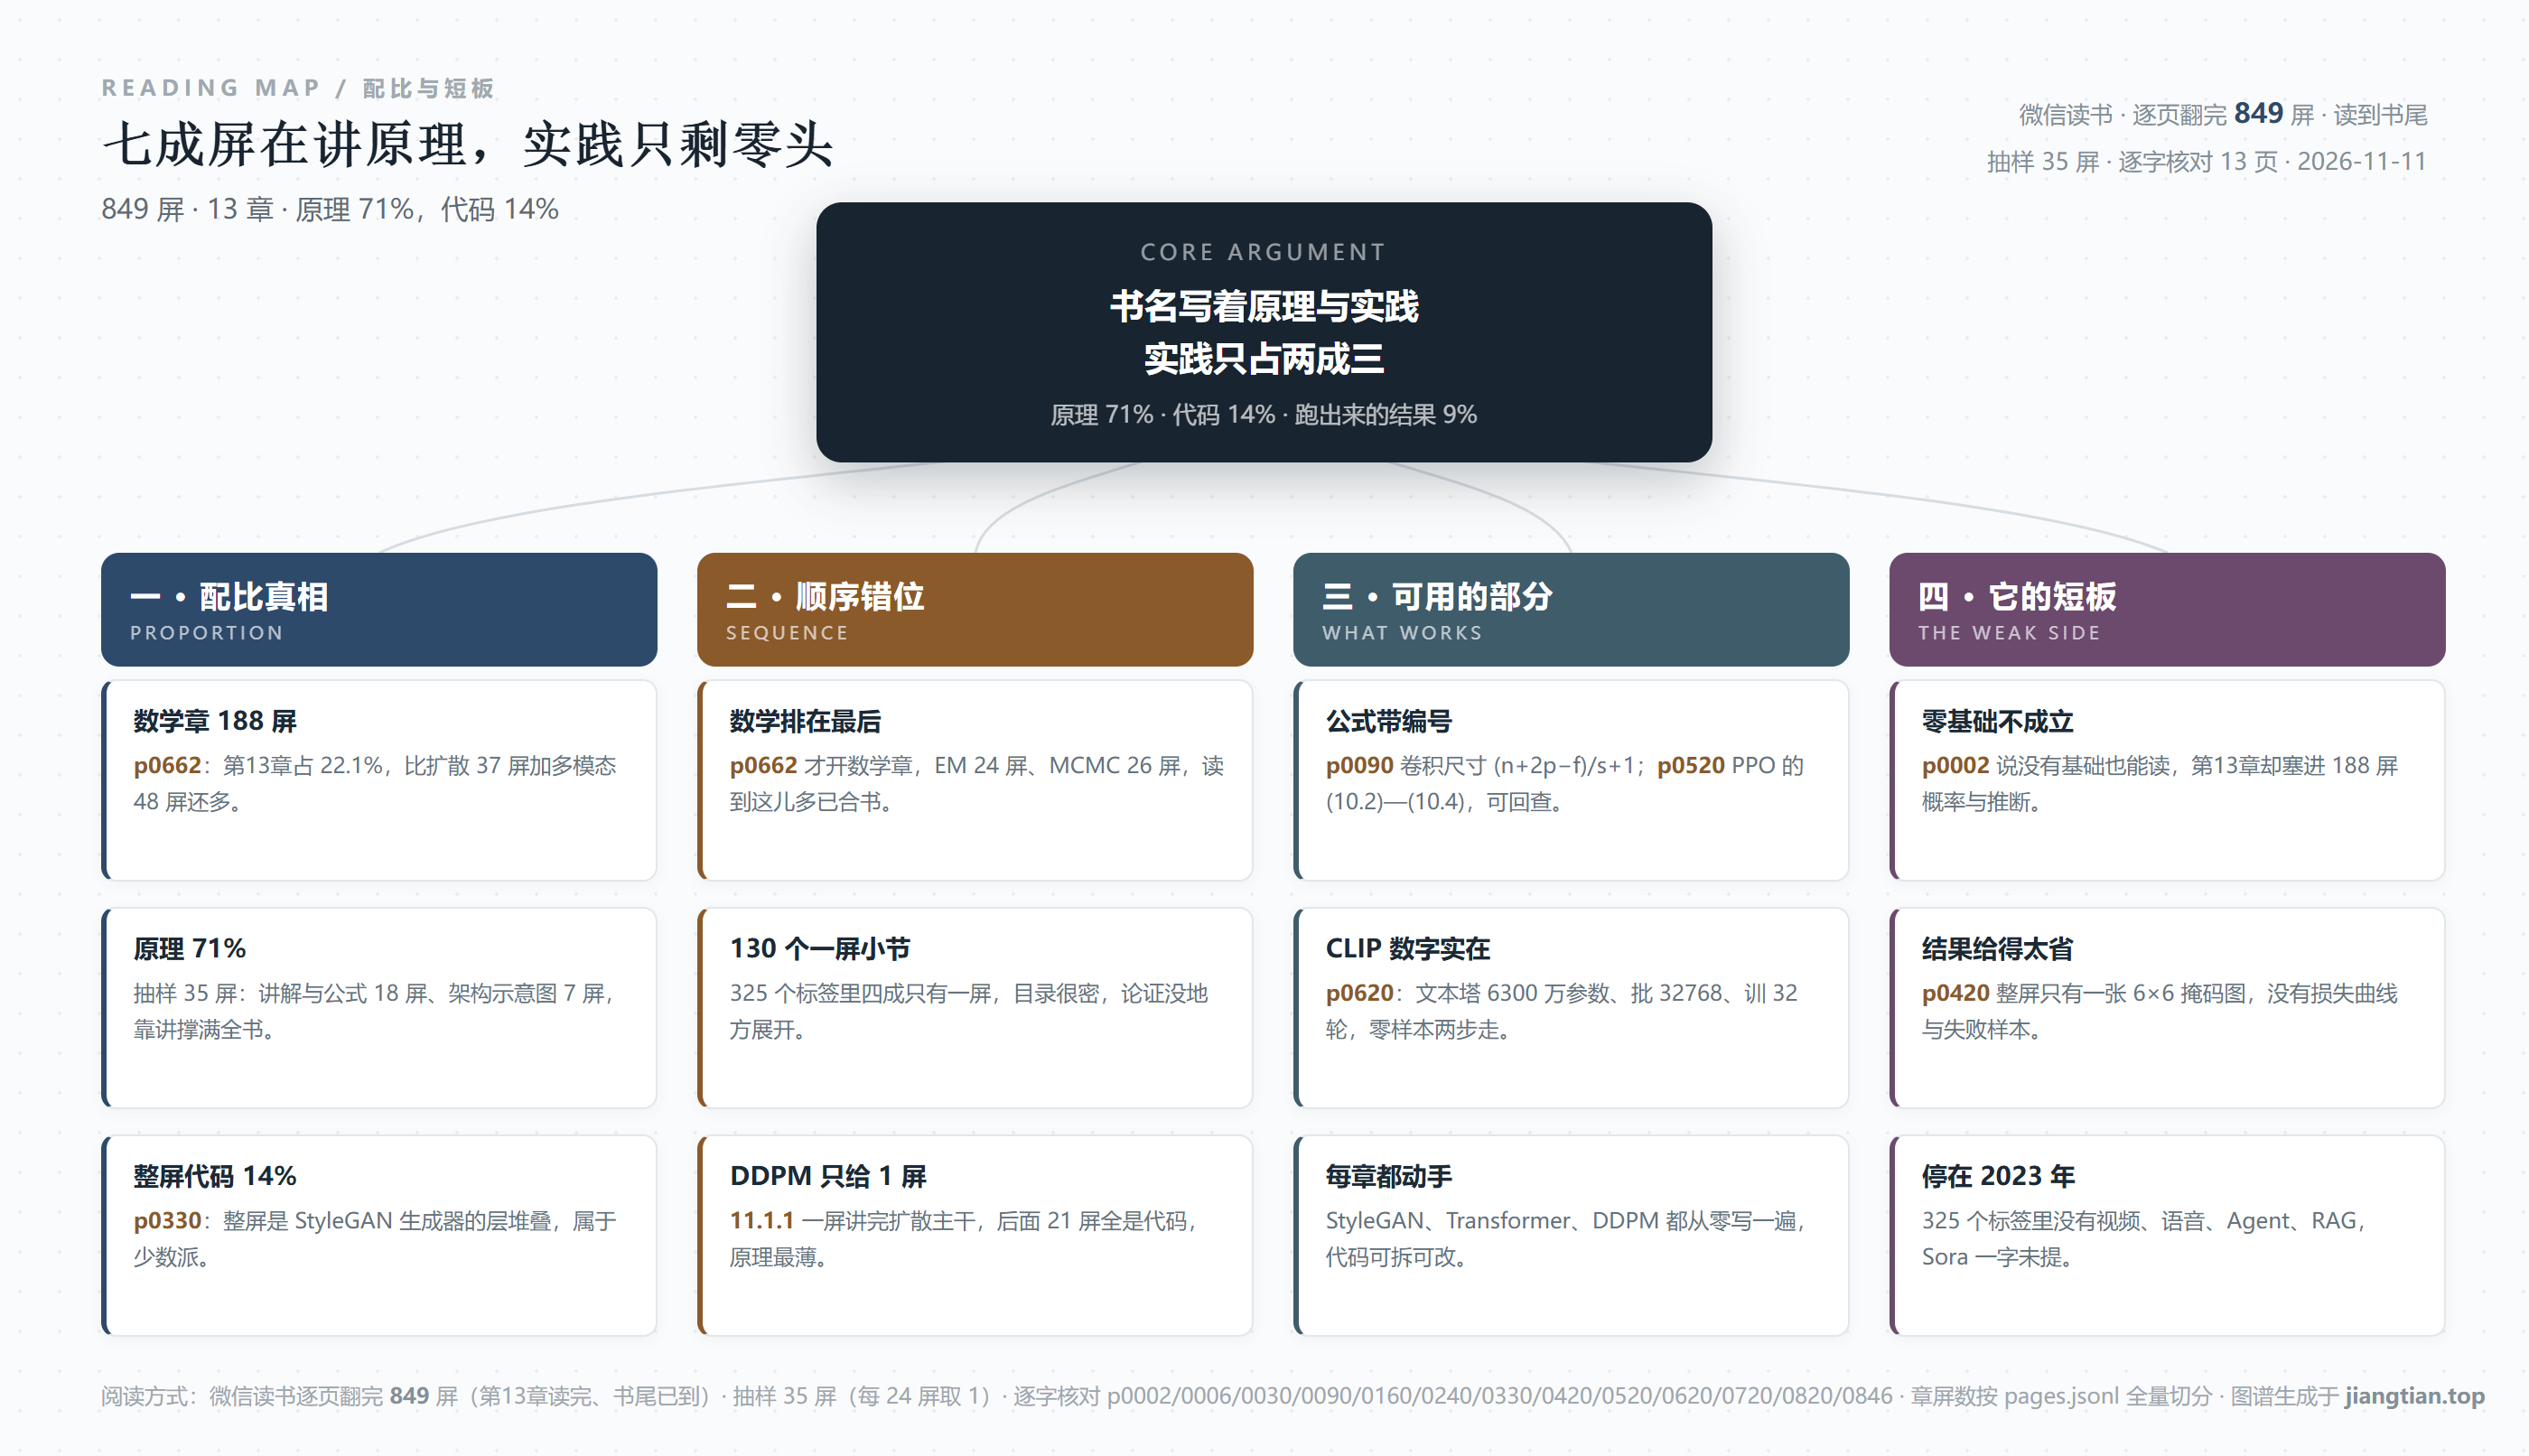
一句话收尾:它把「原理」写得很全,把「实践」写成了原理的插图——想学 AIGC 的底层逻辑,它够用;想照着它做出一个能跑的项目,它不够。
核对页:p0002(内容简介与读者定位)、p0006(前言致谢,第11–13章说明,落款吴茂贵)、p0030(1.4.2 表示学习四种方式)、p0090(式2.2 与图2-20 多通道卷积)、p0160(2.10.1 梯度更新伪代码与学习率敏感性)、p0240(4.3.3 GAN 坍塌与 KL/JS 矛盾)、p0330(StyleGAN 生成器代码)、p0420(图8-23 序列掩码)、p0520(式10.2–10.4 PPO)、p0620(CLIP 参数与零样本两步)、p0720(图13-10 各向同性高斯分布)、p0820(式13.45–13.46 贝尔曼方程)、p0846(作者简介)
统计口径:849 屏按 pages.jsonl 的 chapter 字段全量归并(十三章合计 838 屏 + 前置 7 屏 + 作者简介 1 屏 + 文后 3 屏);配比按每 24 屏取 1 抽样 35 屏目视分类,误差约 ±3 个百分点。图谱与笔记生成于 2026-11-11
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: