
《基于RAG的大模型应用开发》读书笔记:六种架构是六个补丁,不是六个方案
阅读方式:微信读书网页版,从版权页翻到第 9 章末,共 365 屏、9 章、6 分 59 秒。 九章:RAG 基础、核心知识、六种架构、优化、评估、Dify、问答系统、多模态、Agent。
讲 RAG 的书不少,大部分停在"把文档切块、丢进向量库、检索后拼进提示词"。这本书往下走了两级:架构怎么选,和怎么知道自己做得对不对。
而它讲架构的方式,我觉得是全书最有价值的地方。
一、六种架构不是六个方案,是六个补丁
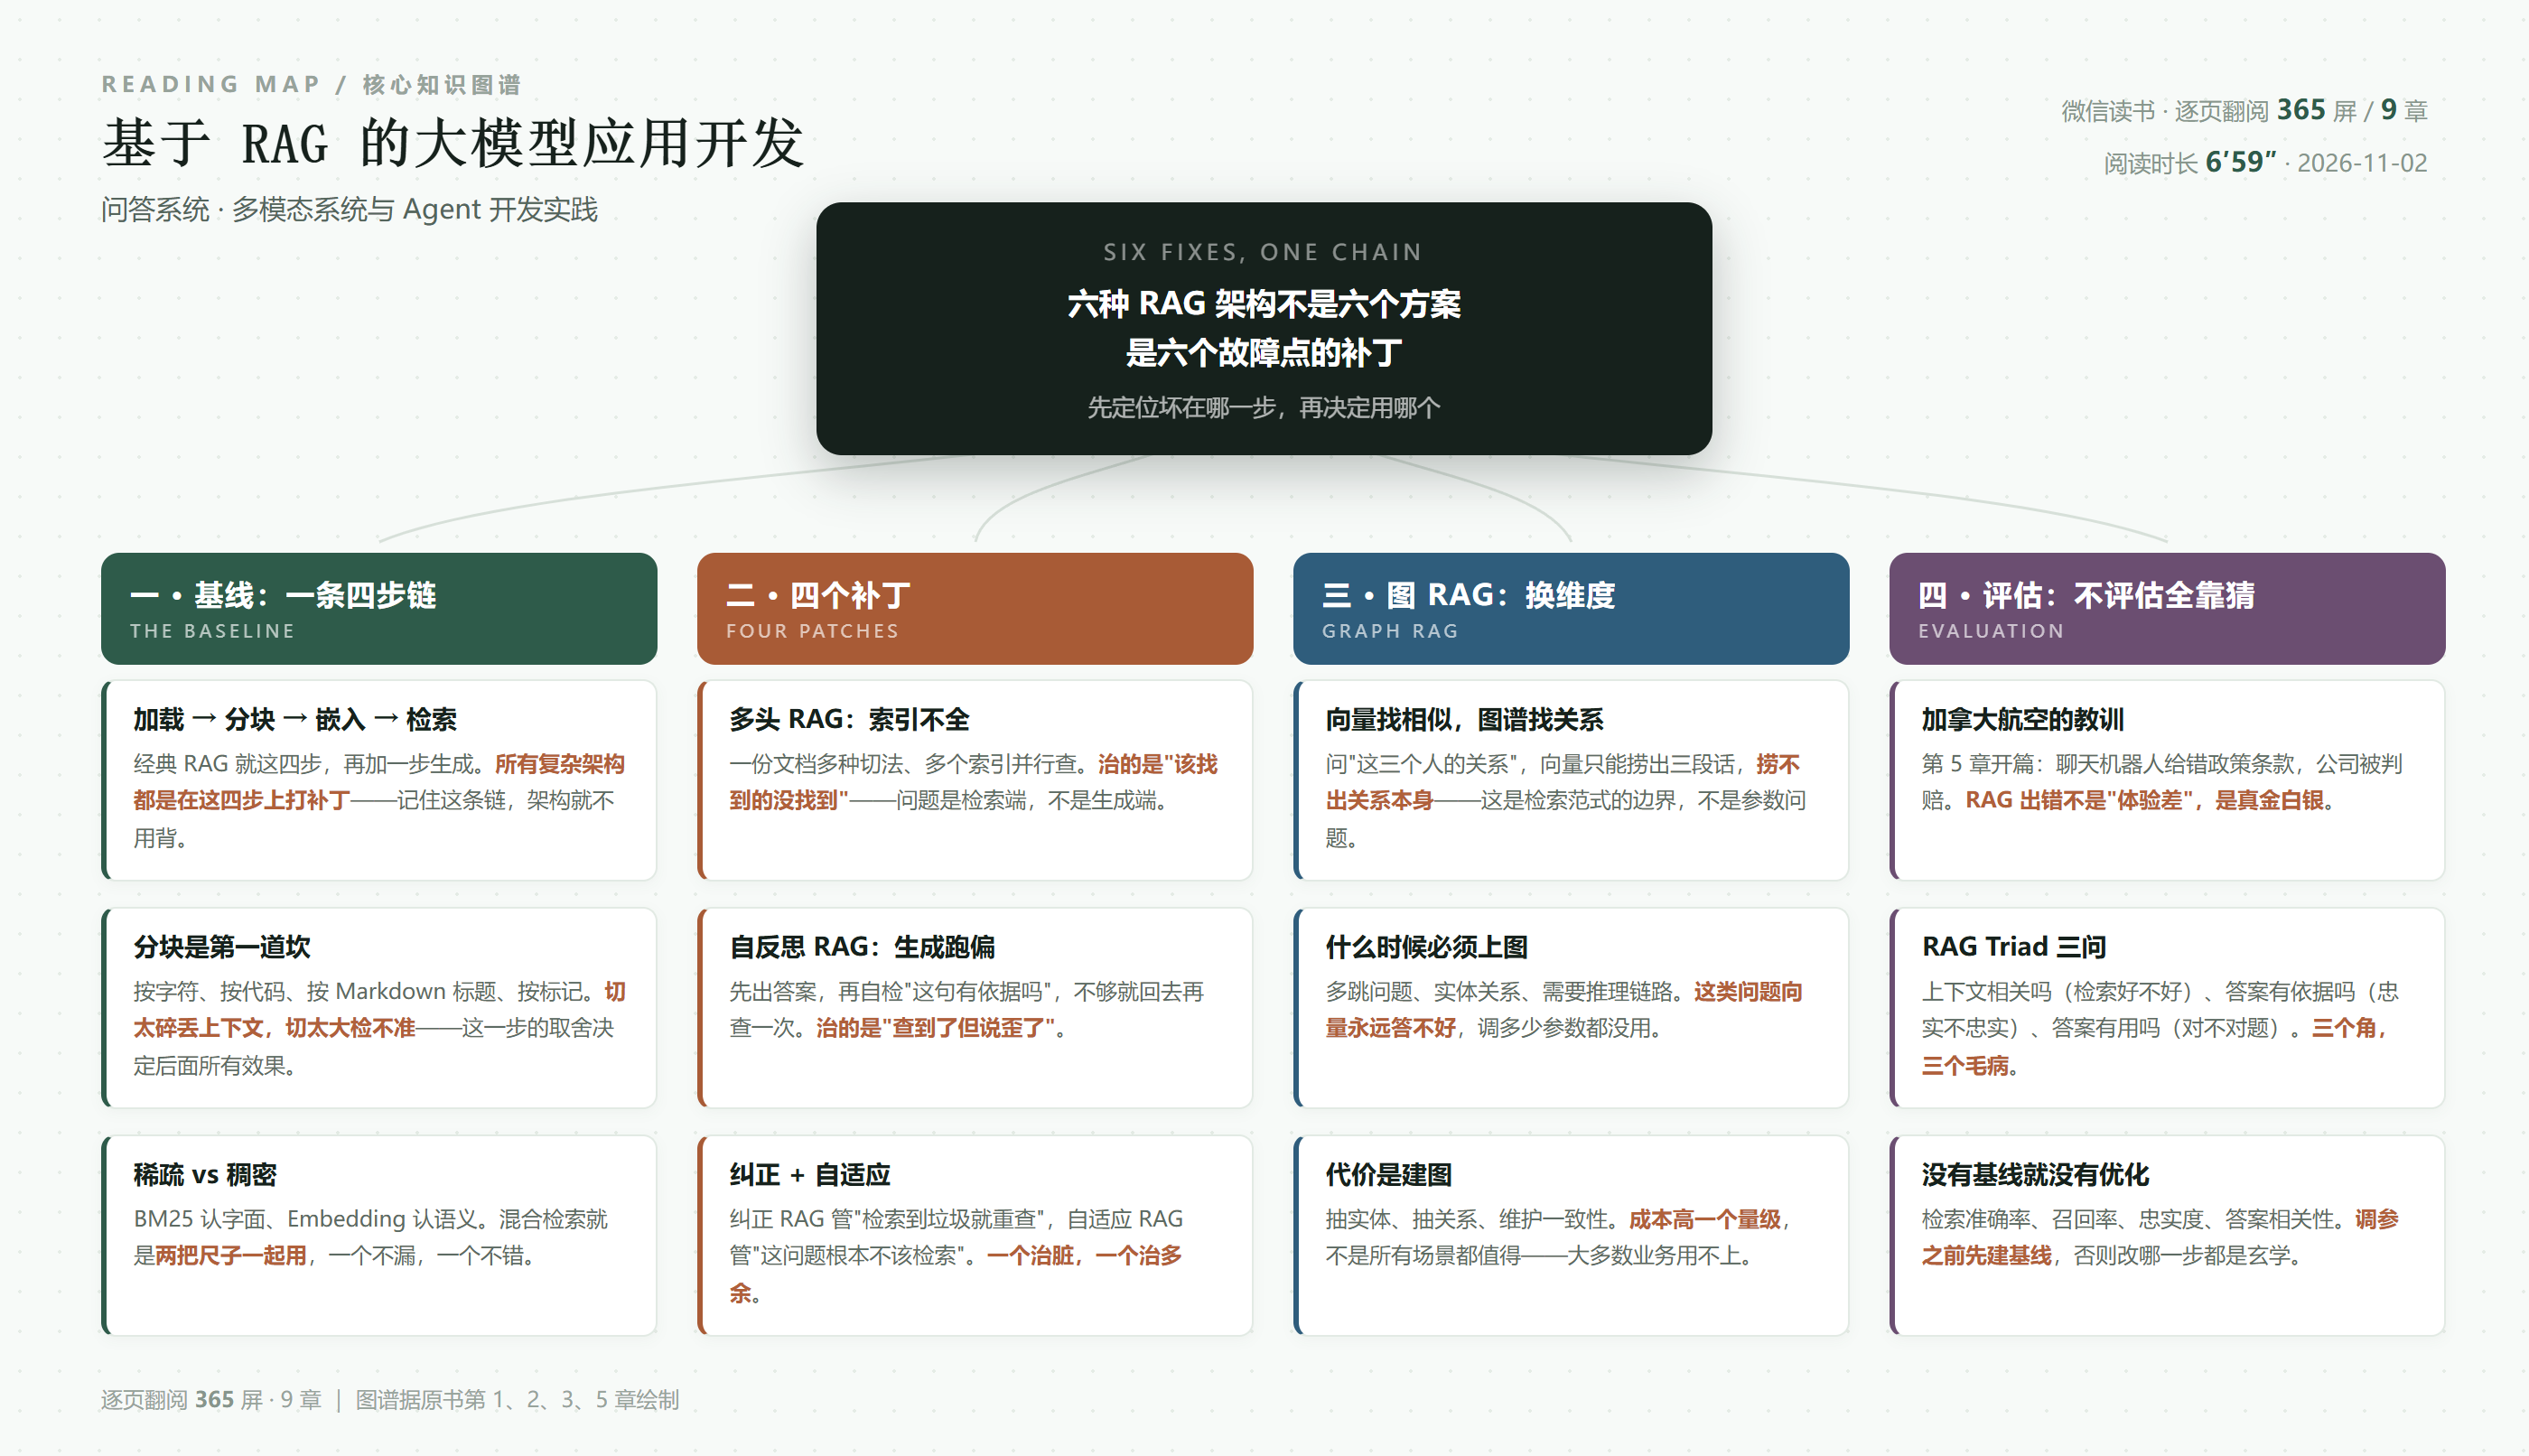
第 3 章一口气给了六种 RAG 架构:经典 RAG、多头 RAG、自反思 RAG、纠正 RAG、自适应 RAG、图 RAG。
如果按"介绍一遍 + 各自优缺点"来读,很容易读完就忘——因为六个名字长得像,听起来都对。
换个角度读就清楚了:它们是同一条链条上,六个不同位置的补丁。
基线是经典 RAG,四步:加载 → 分块 → 嵌入 → 检索,然后拼提示词生成。
这条链有一个特点:任何一步坏了,最后都是"答得不对",但从结果上看不出是哪一步坏的。 于是才有了这么多架构——每一种,都是在猜"最可能坏在哪"。
二、四个补丁,各治一处
多头 RAG 治的是"索引不全"。 一份文档用多种方式切(按段落、按章节、按语义),建多个索引,查询时并行检索再合并。
它针对的故障是:你用一把尺子切文档,就一定有一类问题切不出来。 比如按字数切,表格就被切碎了;按标题切,长段落又被拆散。多个切法就是多把尺子。
自反思 RAG 治的是"生成跑偏"。 先给答案,再让模型自检"这段话有文档依据吗",没有就带着缺口回去再查一轮。
这个补丁针对的故障很常见:检索到的东西是对的,但模型没用它,自己编了。 这就是"忠实度"问题。
纠正 RAG 治的是"检索到垃圾"。 检索结果先打分,质量差就先改写查询、重新检索,或者直接放弃检索去走别的路。
自适应 RAG 治的是"根本不该检索"。 先判断问题类型——"你好"这种闲聊不需要查文档,"上季度营收"就必须查。全查一遍既慢又容易引入噪声。
这四个补丁,我试着给它们起个更短的名字:多头治"没找全",自反思治"说歪了",纠正治"找到脏的",自适应治"白找了"。
记住这四个故障点,比记住四个架构名有用得多——因为它们对应的是你在日志里真正能看到的症状。
三、图 RAG:换的是范式,不是参数
前四个补丁都是在"向量检索"这个范式里做微调。图 RAG 换的是范式。
为什么需要它?举个具体的例子:问"这三个人是什么关系"。
向量检索会怎么做?它会找到提到这三个人的三段文字,拼给模型,让模型自己从三段话里推关系。
问题是:关系本身不是一段文字,它是文字之间的联系。 向量库存的是"片段",不存"联系"。所以这件事它在原理上就做不好,不是参数没调好。
图 RAG 的做法是:先把文档抽成实体和关系的图,检索时按图去走——找到 A,顺着边走到 B,再走到 C。关系是显式的。
所以判断标准很清楚:你的问题需要"多跳"或者需要"关系"吗? 需要,才上图;不需要,图 RAG 只会让你多花十倍的建库成本。
书里给的六种架构,我读下来最大的收获不是学会了六个方案,而是学会了一句话:先定位坏在哪一步,再决定加什么补丁。 反过来做——先选架构再找问题——几乎一定是在浪费钱。
四、评估:加拿大航空的教训
第 5 章开篇讲了个真实的案例,我认为是全书最该被记住的几页。
加拿大航空的客服聊天机器人,在回答退票政策时给出了错误信息。用户信了,去申请退款被拒,于是起诉。法院判定航空公司要为机器人的回答负责——因为机器人代表着公司。
书里的评述很克制,但意思很明确:
"这一'意外'的赔偿案例在社交媒体上迅速传播,引发了公众的关注和公司高层的内部调查。更重要的是,这也暴露了聊天机器人在面向客户的重要场景中出现失误可能导致的法律和经济风险。"
然后作者给了 RAG 的评估框架 RAG Triad,三个维度:
上下文相关性——检索出来的片段,和用户问题相关吗?(考检索)
忠实度——答案里的每句话,在上下文里找得到依据吗?(考有没有编)
答案相关性——这个答案,真的回答了用户问的那个问题吗?(考有没有答偏)
三个指标对应三角形三条边,各自指向一类故障。这个框架的好处是可定位:
上下文相关性低 → 问题在检索端,去调分块和嵌入。
忠实度高但答案相关性低 → 检索没问题,是模型答偏了,去调提示词。
忠实度低 → 模型在编,得加强约束或者加自反思。
这就把"效果不好"从一句抱怨,变成了一个可以分头排查的清单。
我认为这是这本书比同类书扎实的核心原因:它不承诺"这样做就好",它教你怎么知道自己做得不好。
五、这本书的短板
一是代码密度偏高。 365 屏里,第 2、6、7、8 章大量是代码和界面截图(Dify 的配置、Qwen2.5-VL 的调用、Faiss 的用法)。这些内容跑一遍就懂,翻过去就忘,而且版本一换就失效。
二是六种架构的对比不够直接。 每个架构都是"简介 + 架构 + 实战"三段式,但缺一张横向对比表——什么场景选哪个、成本差多少、效果提升多少。读者要自己拼。
三是评估那章虽好,但落地门槛高。 RAGAS 需要构造评估数据集(问题 + 标准答案 + 上下文),这件事在实际项目里往往没人愿意做。书里给了方法,没解决"谁来做"的问题。
它的优点是:把 RAG 从"会用"讲到了"会调"。 大部分人做 RAG 卡在"效果不够好但不知道改哪",这本书的第 3 章和第 5 章,正好各回答了一半——前者告诉你可能坏在哪,后者告诉你现在到底坏没坏。
六、一句话
RAG 的难点从来不是"把文档塞进向量库"——那半天就能跑通。难的是跑通之后发现答得不对,却不知道是哪一步坏的。六种架构是六种猜测,RAG Triad 是三个探针。先有探针,再谈架构;反过来,你会一直在给一个没病的地方吃药。
阅读记录:微信读书网页版逐页翻阅,365 屏 / 9 章 / 6 分 59 秒。
本书知识图谱见文中配图,原图地址:https://jiangtian.top/zb_users/upload/kg/rag-app-map.png
发表评论: