
外脑不是第二个大脑:《AIGC》把它拆成一座三层塔
阅读方式:微信读书网页版,从版权页翻到第 9 章末,共 334 屏、9 章、7 分 05 秒。 九章:智造时代、基础技术栈、拓展技术栈、文本生成、图像生成、应用升级、生态构建、挑战与监管、未来变革。
这本书的名字挺唬人——"让生成式 AI 成为自己的外脑"。听上去像又一本教你用提示词提高效率的工具书。
翻完 334 屏我发现它其实不是。它更像一本分层说明书:把 AIGC 从"能看见的效果"一层层拆回"能力到底从哪长出来",最后落在一句相当不留情面的判断上。
那句话我先放这儿,后面再展开:"目前大多数 AIGC 工具是娱乐性的,而不是实用性的。"
一、五级台阶:从"看懂"到"画出来"
第 2 章叫"基础技术栈",是全书的地基。作者没按"模型名字"来排,而是按能力方向排了五级:
识别 → 理解 → 输出 → 可视 → 创作。
这个顺序值得琢磨。它说明 AIGC 不是凭空出现的"生成能力",而是一条加工链的最后一环:先得看懂(识别),再得弄明白(理解),然后才谈得上说出来(输出)。
书里讲识别的关键时说得很实在:计算机视觉的本质是把像素变成结构,而这个转换的关键在于"抽什么特征"。抽错了,后面全歪。
理解与输出被放在了同一节里,因为作者认为它们是同一件事的两面:文本先切成词元再向量化,音频先切成频谱再编码。你用什么方式编码输入,就用什么方式解码输出。
最后一级"从可视到创作",作者的用词是"跳出"——跳出数据的框,进入表达的领域。我认为这句话是全书诚实度的一个标志:这一步靠的不是算法,是品味。 而品味,恰好是这本书没打算教、也教不了的部分。
二、管道与黑盒:一次彻底的范式替换
第 3 章讲拓展技术栈,其中"从管道到整体"这一节,是全书讲得最清楚的一段技术史。
过去的文本生成系统怎么做的?拆成模块,串成管道(pipeline)。
书里举的例子是老式智能问答系统,三个模块:
语义理解模块:从用户输入的非结构化文本里,抽出有意义的对象和属性,变成算法能吃的结构化数据;
答案检索模块:拿结构化数据生成查询语句(SQL 或图数据库查询),再对结果做筛选;
文本生成模块:根据筛出来的信息,拼出最终回复。
这套东西能跑,问题也很明显。作者的原话是:"过去的文本生成系统工程量较大、过程复杂,因此效果不尽如人意。"
为什么效果不好?因为每一段都在丢信息。语义理解抽错一个属性,检索就查不到;检索查到十条筛成一条,可能筛掉了真正对的那条;最后生成模块拿到的已经是三手信息。管道越长,损耗越多,而且你不知道损耗发生在哪一段。
Seq2Seq 换的就是这个思路:不要管道,要一个黑盒。 数据从一头进,结果从另一头出,中间的模块全部消失。
代价写在同一页上:如今的 GPT 模型动辄几十亿甚至上百亿参数,"过大的模型和过于复杂的计算使模型很难具备有效的可解释性"。
我把这段读成一句大白话:端到端赢了效果,输了交代。 你得到了更好的结果,同时永久失去了"为什么是这个结果"的答案。这不是技术没做好,这是这次范式替换本身的交易条件。
三、ChatGPT 不是顿悟,是三件事凑齐
第 3 章最后一节标题很直白:"一切的一切:ChatGPT"。
作者的拆法我很认同:ChatGPT 的底层是 GPT,GPT 来自 Transformer 的解码器部分,而 Transformer 是一个用注意力机制捕获上下文的 Seq2Seq 模型。所以严格说,ChatGPT 是一个标准的 Seq2Seq 模型。
那它凭什么突然就好用了?书里给的不是模型结构,而是训练方法:RLHF,基于人类反馈的强化学习,分三步——
第一步:有监督微调——用人写的优质回答,教模型"什么叫好好说话";
第二步:训练反馈模型——让人给模型的多个回答排序,训出一个能替人打分的模型;
第三步:近端策略优化——用这个打分模型当裁判,反复调教主模型。
这三步里,没有一个是在提升模型的"知识量"。它们提升的是服从度:让它按人想听的格式、语气、边界来回答。
所以"ChatGPT 为什么突然火了"这个问题,我认为书里给的答案比大多数讨论都准:它不是变聪明了,是变听话了。 而"听话"这件事,恰好是它从实验室玩具变成亿万人日常工具的那道门槛。
四、外脑最顺手的用法,是写代码
第 6 章讲应用升级,其中关于代码生成的一段,是我读这本书时唯一"拍大腿"的地方。
作者先解释了一个平时没人细想的事实:今天说的"代码",既不是 0 和 1 的机器语言,也不是汇编语言,而是高级编程语言。而高级编程语言从诞生起,设计目标就是——
"寻求一些与人类自然语言相近且能为计算机所接受的语义明确、规则明确、自然直观、通用易学的计算机语言。"
顺着这个定义往下推,结论几乎是自动的:既然高级语言本来就是"贴近自然语言的语言",那么让一个以自然语言为母语的模型去写它,本来就是顺理成章的事,不是越界。
很多程序员对 AI 写代码有种被冒犯的感觉,觉得"它凭什么"。但按这个逻辑,真正该意外的不是"AI 会写代码",而是"这件事居然花了这么多年才发生"。
书里提到的用法也很朴素:在写复杂代码之前,先向它要建议;初学者用它快速理解一段代码怎么跑。都不是"替代",是"先问一句"。
这大概就是"外脑"这个词最贴切的落点——外脑不是第二个大脑,它是一个随叫随到、永远不嫌你问题笨的同行。
五、三级台阶:我们其实还在第一级
第 9 章讲未来,作者把 AIGC 的发展划成三段,我认为这是全书最有框架感的一页:
第一阶段:完善内容生产技术——文本、图像、视频的生成,以及三者之间的跨模态转换;
第二阶段:多模态生成技术的聚合应用,代表形态是虚拟人;
第三阶段:虚拟内容生态,也就是元宇宙。
然后是一句大实话:"目前,国内外互联网公司仍然处于第一阶段。"
这句话写在这本书出版的年份,今天回看依然成立。我们这两年看到的所谓进展——更长的上下文、更顺的视频、更像人的语音——基本都还在第一阶段内部做深,没有跨到"多模态聚合"那一级。台阶之间不是量的差别,是形态的差别。
六、阿喀琉斯之踵:那一句"娱乐性大于实用性"
第 8 章第一节的标题就叫"AIGC 的阿喀琉斯之踵"。这一节,是我认为全书最值得单独摘出来的一节。
作者先承认了技术进展,然后立刻转向:"目前大多数 AIGC 工具是娱乐性的,而不是实用性的。例如,文本到图像生成模型很有趣,但人们不清楚它如何才能产生收入。"
他还提到一个规律:当一项变革性的技术出现时,市场往往对其潜在的应用和未来的增长过度乐观。 于是"AIGC 可能是下一个泡沫"的言论随之出现。
这段话写在热潮正盛的时候,说得很不讨喜。但如果你做过任何一个 AIGC 落地项目,你会知道它准得刺人:做出一个"哇"的 demo 只要一下午,把它变成一个能收到钱的流程,要一年。
硬件这一节也很硬:大规模预训练模型的算力不足,根源是"模型变得越来越复杂,致使参数的数量和计算的复杂程度呈指数级增长"。这是所有故事的物理上限——不是钱的问题,是硅的问题。
最后是代价落在谁头上。作者列出的顺序很直接:天气预报、股票行情分析这类标准化内容,市场研究、调查报告这类数据整理工作,以及简单的图文设计、排版、格式化的岗位——"那些从事内容重复性高、技能要求低的工作的员工",最先面临岗位减少。
而他给普通员工指的方向是四个词:内容生成与编辑、数据分析与解读、创意与创新、跨领域。四个词有个共同点——都是从"做"退到"判断"。
七、这本书的短板
一是技术深度不均。 334 屏里,第 2、3 章讲技术栈讲得相当细(连 Seq2Seq 和管道的历史都梳理了),但第 6 章"应用升级"、第 7 章"生态构建"就明显松散——大量"某公司推出了某产品"式的罗列,读起来像行业研报的剪贴。
二是案例的时代痕迹明显。 书里提到的工具、模型、公司,很多今天已经改名、下架或被并购(Diffusion 系工具一代换一代)。这不是作者的错,是这类书的宿命:写技术的书有半衰期,写判断的书没有。 这本书的价值恰好集中在后者。
三是"外脑"这个核心比喻,其实没兑现。 书名承诺的是"怎么把它变成自己的外脑"——一套方法论。但全书真正讲用法的只有第 6 章那一小节,其余都在讲 AIGC 是什么、从哪来、到哪去。它是一本很好的"说明书",但不是一本"使用手册"。
它的优点是:敢在热潮里说实话。 一本 2022—2023 年间写 AIGC 的书,通篇不吹"颠覆",反而专门辟一章讲硬件不够、工具偏娱乐、岗位会消失——这件事本身就比书里的技术细节更有价值。
八、一句话
"外脑"这个词容易让人误会,好像装上它,脑子就多了一个。但外脑只接管"做出来"那一段,"想清楚"那一段一个字都没少,还在你自己脑子里。 这本书真正的贡献,是把这条分界线画了出来:左边是技术栈——识别、理解、输出、可视、创作,一层层都能外包;右边是价值判断——做什么、给谁做、值不值得做,一个字都外包不出去。看清这条线,比学会十个提示词有用。
阅读记录:微信读书网页版逐页翻阅,334 屏 / 9 章 / 7 分 05 秒。
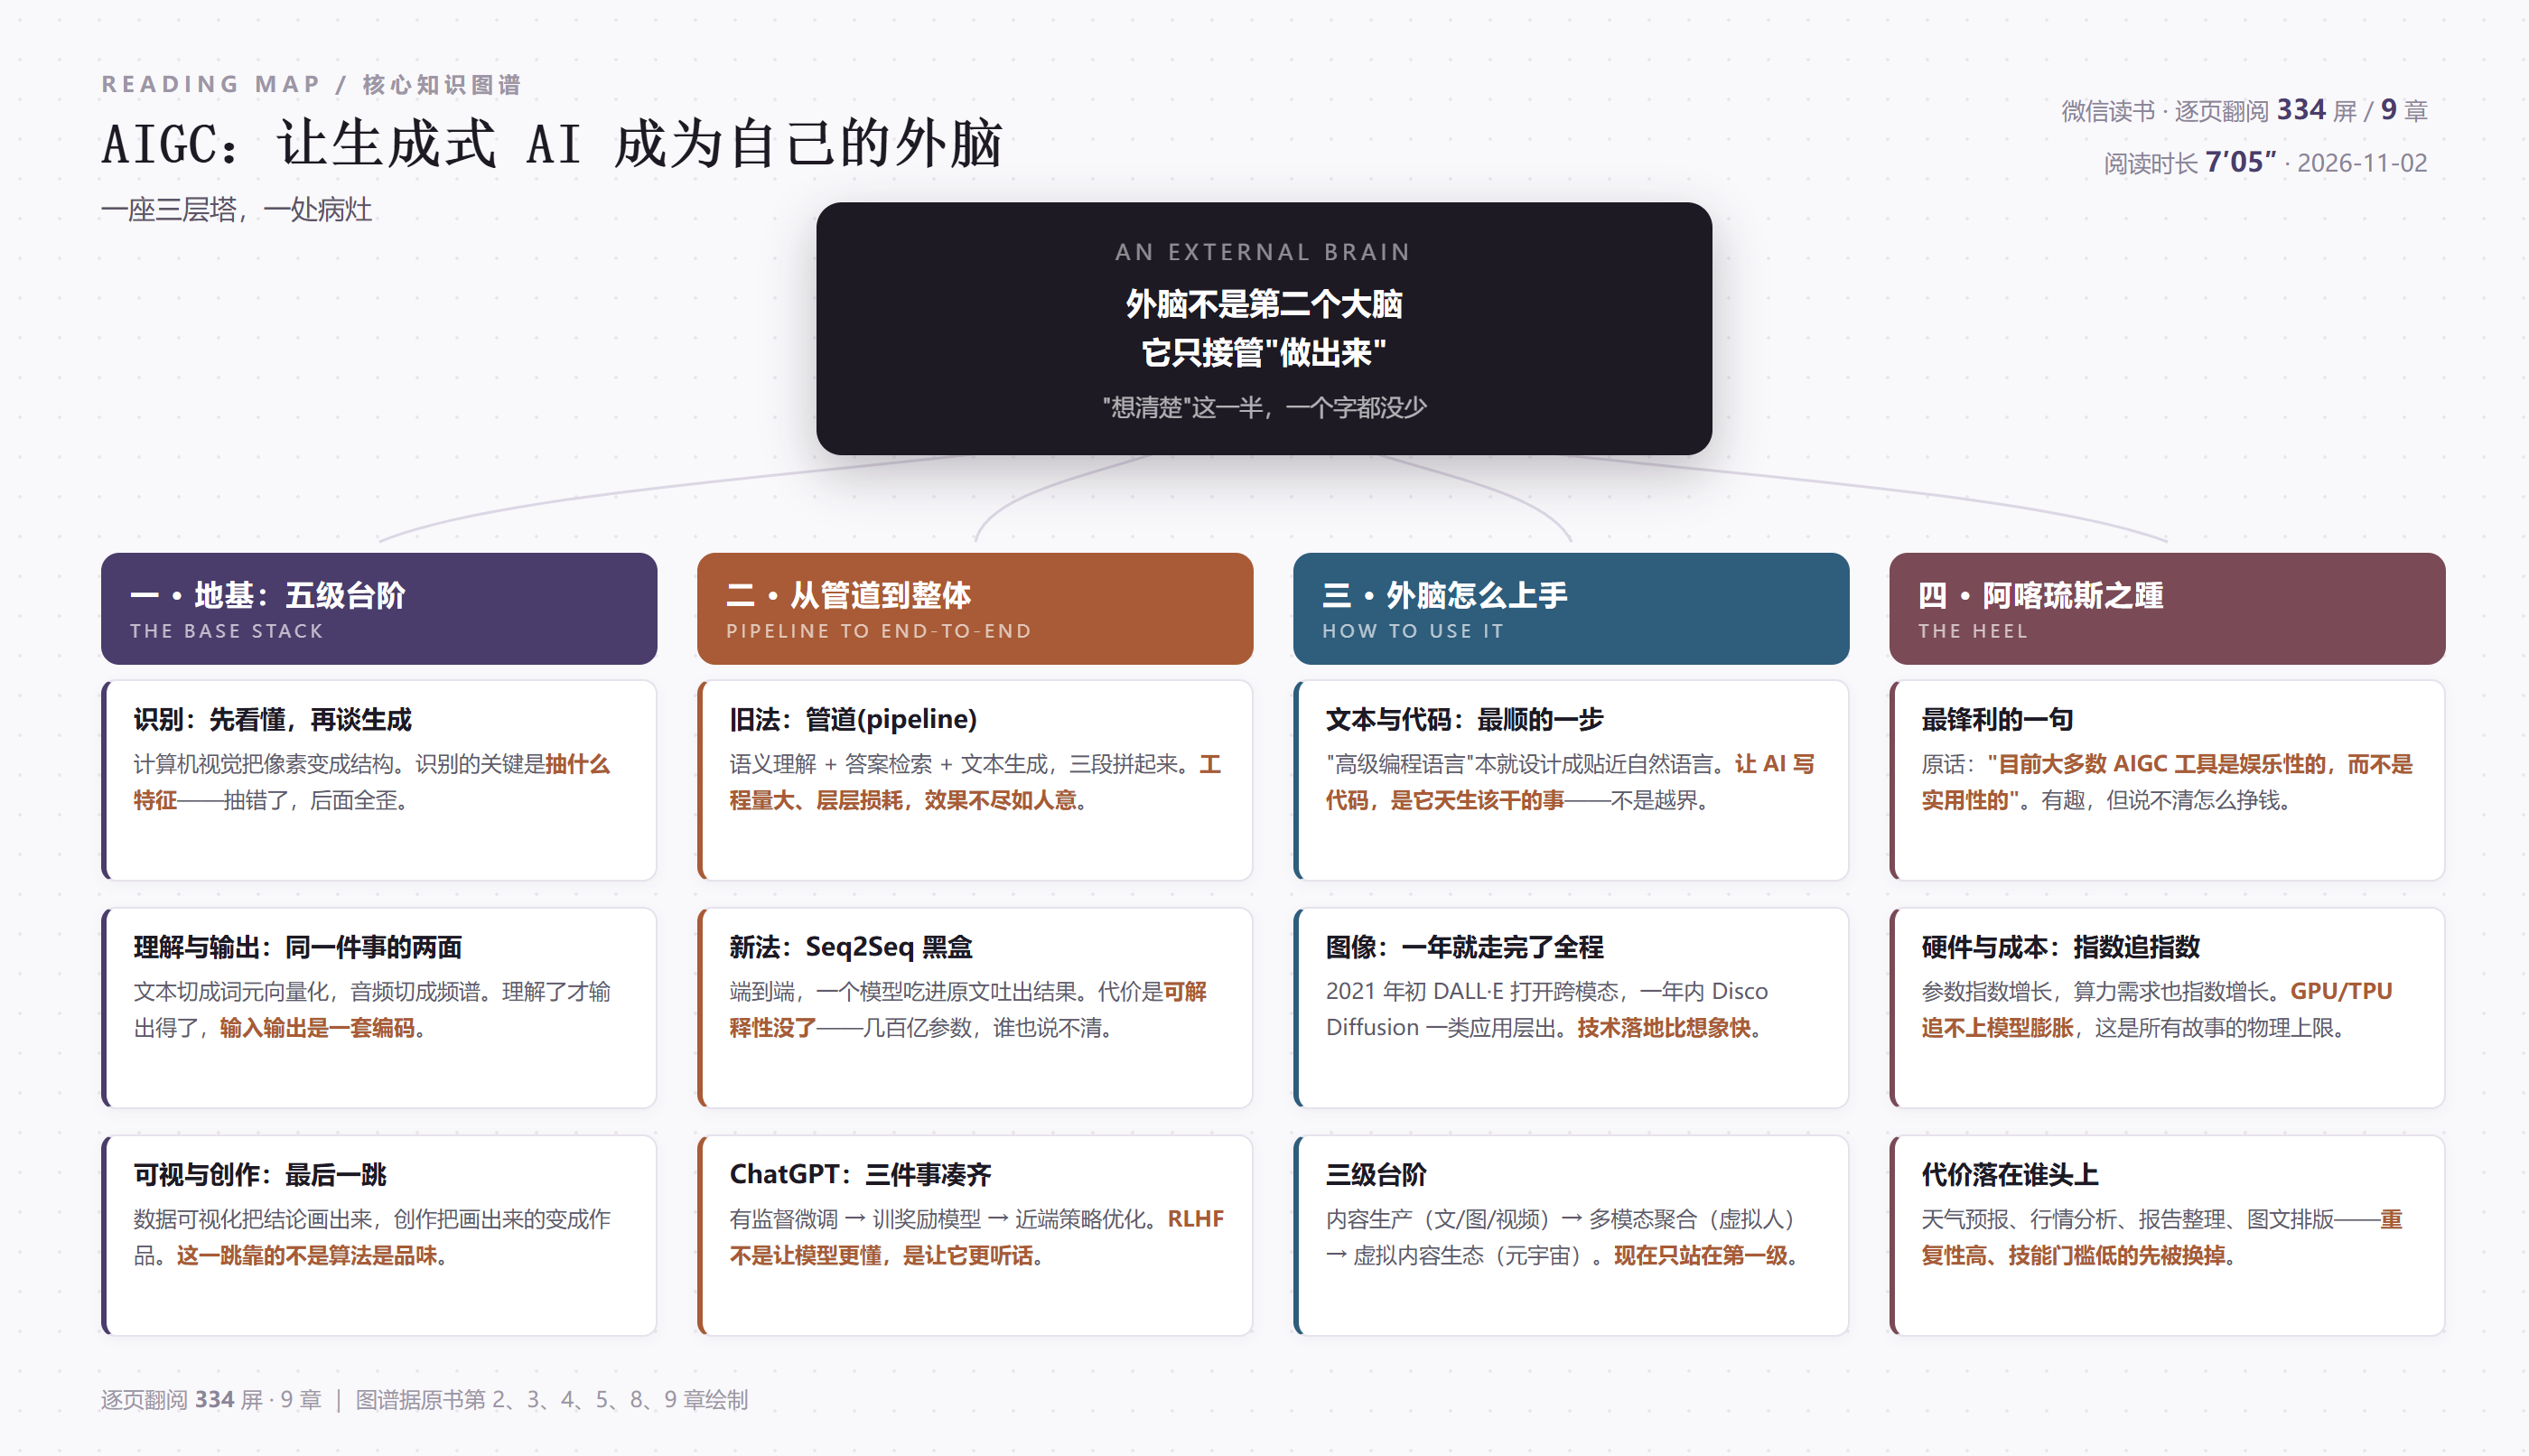
本书知识图谱见文中配图,原图地址:https://jiangtian.top/zb_users/upload/kg/ai-exobrain-map.png
发表评论: