
太早不知道怎么管,太晚就管不动了
阅读方式:微信读书网页版,从版权页翻到后记,共 281 屏、8 章、6 分 30 秒。 八章:颠覆之路、大模型背后的核心问题、技术创新机遇、做深做实、商业新变革、生活改变、治理挑战、未来前瞻。
这是我读的这一批书里,唯一一本不教你怎么用 AI 的。
它没有提示词模板,没有工具清单,没有"十分钟上手"。八个章节里,有一半在讲一件事:这东西该由谁来管。
而它给出的最有用的一样东西,不是答案,是一个比喻。
一、一艘船,两种航速
第七章开头,作者用了一个场景。我把它抄下来:
每个船员都希望这艘船能够顺利前进,但船的航速和航线规划成了问题。一些船员认为应该全速前进,尽快到达目的地,这样才能在人工智能领域取得领先优势。另一些船员则担心一味地加速可能会导致风险增加,需要更多的规制和控制。
然后他给这个分歧起了个名字:科林格里奇困境。
书里接着解释:美国船员希望通过市场的自由竞争来推动船的发展,而欧盟船员更愿意借助政府的力量来设立监管规则。
这个困境的意思,用大白话说就是:
一项技术刚出来的时候,你管得住它,但不知道该管什么;
等你看清它会带来什么后果,它已经长到管不动了。
这句话解释了为什么关于 AI 的讨论总是原地打转:喊"先管起来"的人,和喊"别管太早"的人,其实都对。 他们要的不是同一个时间点。
这本书的价值就在这儿——它没有站队,它把这两拨人的理由都摆在了桌上。
二、治理六件事,最硬的是可解释性
第七章把治理拆成六块:技术监管、内容生态、伦理先行、隐私安全、数字素养、国际监管比较。
前两块是大家都会说的。让我意外的是"技术监管"那一节,它提了一个技术味很重的方案:
通过利用 AI 去提高自身的可解释性,让 AI 能够辅助人类给出自身的数学证明或自证其安全性……在 AI 系统中嵌入可解释性算法,使其能够输出决策的解释和推理过程。
让模型自己给出"数学证明"——这个说法在工程上当然还很远,但方向是对的:监管的前提是能查,能查的前提是它肯交代。
同一节还有一条更激进的建议:减缓"AI 军备竞赛"的速度,并建议成立类似国际原子能机构(IAEA)的组织来监督全球 AI 发展。
这个类比我第一次看到时觉得有点天真——AI 没有铀,也没有离心机,怎么核查?但回头想想,IAEA 管的核心其实不是铀,是"谁在什么地方有多少"。算力、模型权重、训练数据,某种程度上也是同一种东西。
当然,这一节写于 2023 年,那时还没有人认真讨论算力出口管制会成为主要抓手。书里的判断方向对了,路径猜错了。
三、它把 2023 年钉住了
这本书有一个功能,可能作者自己都没意识到:它是一份 2023 年中的现场记录。
第六章第六节讲国际监管比较,列了美国那一年的动作:
2022 年 10 月,发布《人工智能权利法案蓝图》草案,确立指导 AI 发展的关键原则;
2023 年 4 月,商务部就相关问责措施公开征求意见,包括新模型在发布前是否应经认证;
2023 年 4 月,参议院多数党领袖舒默发起 AI 监管制度的高级别框架;
2023 年 5 月,FTC 主席表示将研究能否用现有法律解决 AI 造成的在线诈骗与隐私侵犯;
总统科技顾问委员会(PCAST)成立生成式人工智能工作组。
这一串里,我认为最该被记住的是舒默框架里的那条要求:企业需允许独立专家在公开发布或更新之前,审查和测试 AI 技术。
为什么这条最硬?因为它把监管的时点从"出事之后"挪到了"发布之前"。
事后追责是容易的——罚钱、下架、写检讨,都是事后。但模型一旦放出去,权重就收不回来了。发布前审查,是唯一能真正踩住刹车的时点。 也正因为如此,它最难落地:谁来审、审什么、审多久,每一个问题都能拖上几年。
顺带提一句,这页还写到华裔数学家陶哲轩领导白宫生成式人工智能工作组。这个细节当时很多人没注意,但它说明一件事:这一轮 AI 治理,最早被拉进来的是数学家,不是律师。
四、两处敢说真话的地方
全书最让我停顿的,是第四章引的朱松纯的一段话。原文大意是:
商业炒作是产生所谓"千模大战"现象的核心原因之一,这对正常的学术秩序造成了冲击。他认为,大模型不是通用人工智能,不满足通用人工智能的基本条件,对通用人工智能的讨论应该回归学术本身。
这句话在一本 2023 年出的、讲"AI 机遇"的书里出现,是需要一点勇气的。因为整本书的基调是乐观的,而这段话直接说:你们喊的那个东西,还不是你们以为的那个东西。
第二处更直白,是一张表。第四章表 4-1,AI 大模型产品排名,摘自 CLUE 榜单:
1. 人类(CLUE)——平均 93.09
2. GPT-4(OpenAI)——78.76
3. gpt-3.5-turbo(OpenAI)——67.98
4. 360 智脑——63.53
5. 文心一言——62.85
这张表把"人类"放在第一名,当成基准线。
这个设计很妙,也很残酷:所有模型都在人类之下,离得最近的那个还差 15 分。
而当时媒体上讨论的是什么?是"哪个模型超过了 GPT-4""谁才是国产第一"。大家争的是第二名。
我在别处没见过这么朴素又好用的坐标。它一句话就把"AI 已经超过人"的幻觉按住了:在中文理解这件事上,最好的模型大约是人类水平的八成四。
五、这本书的短板:它会过期,而且已经过期了
一是时效。 这是最要命的一条。全书的材料基本停在 2023 年中,美国的监管框架后来反复变动,模型格局也早已不是那张表的样子。现在读它,读的是一份历史文件,不是一本指南。
二是"某某表示"太多。 大量段落是"某教授表示""某院长认为",但没给数据、没给出处、没给反驳。读起来像会议综述,你知道有人这么想,但不知道这个想法有多重。
三是应用场景那两章偏愿景。 第五、六章写了教育、工业设计、机械制造、乡村振兴、健康管理、情感陪伴、数字生命……覆盖面很广,但每一节都停在"可以这样",缺一个真跑起来的案例。
它的优点是:它敢把"管"这个字放在书名里。 同一时期大部分书都在算 AI 能创造多少万亿产值,这本花了一整章讲"如果没人管会怎样"。在一堆乐观的书里,这一章的存在本身就有价值。
六、一句话
这本书最值钱的不是它给出的任何一个方案,而是它点出的那个时间差:技术跑得快,规矩写得慢,而人对后果的判断最慢。 于是每一次都卡在同一个地方——太早的时候你不知道该管什么,等到知道了,它已经大到不能动。所以别指望某个机构一次把规矩定全,能做的只有一件事:在还管得住的时候,先把"发布前能不能查"这一条立起来。
阅读记录:微信读书网页版逐页翻阅,281 屏 / 8 章 / 6 分 30 秒。
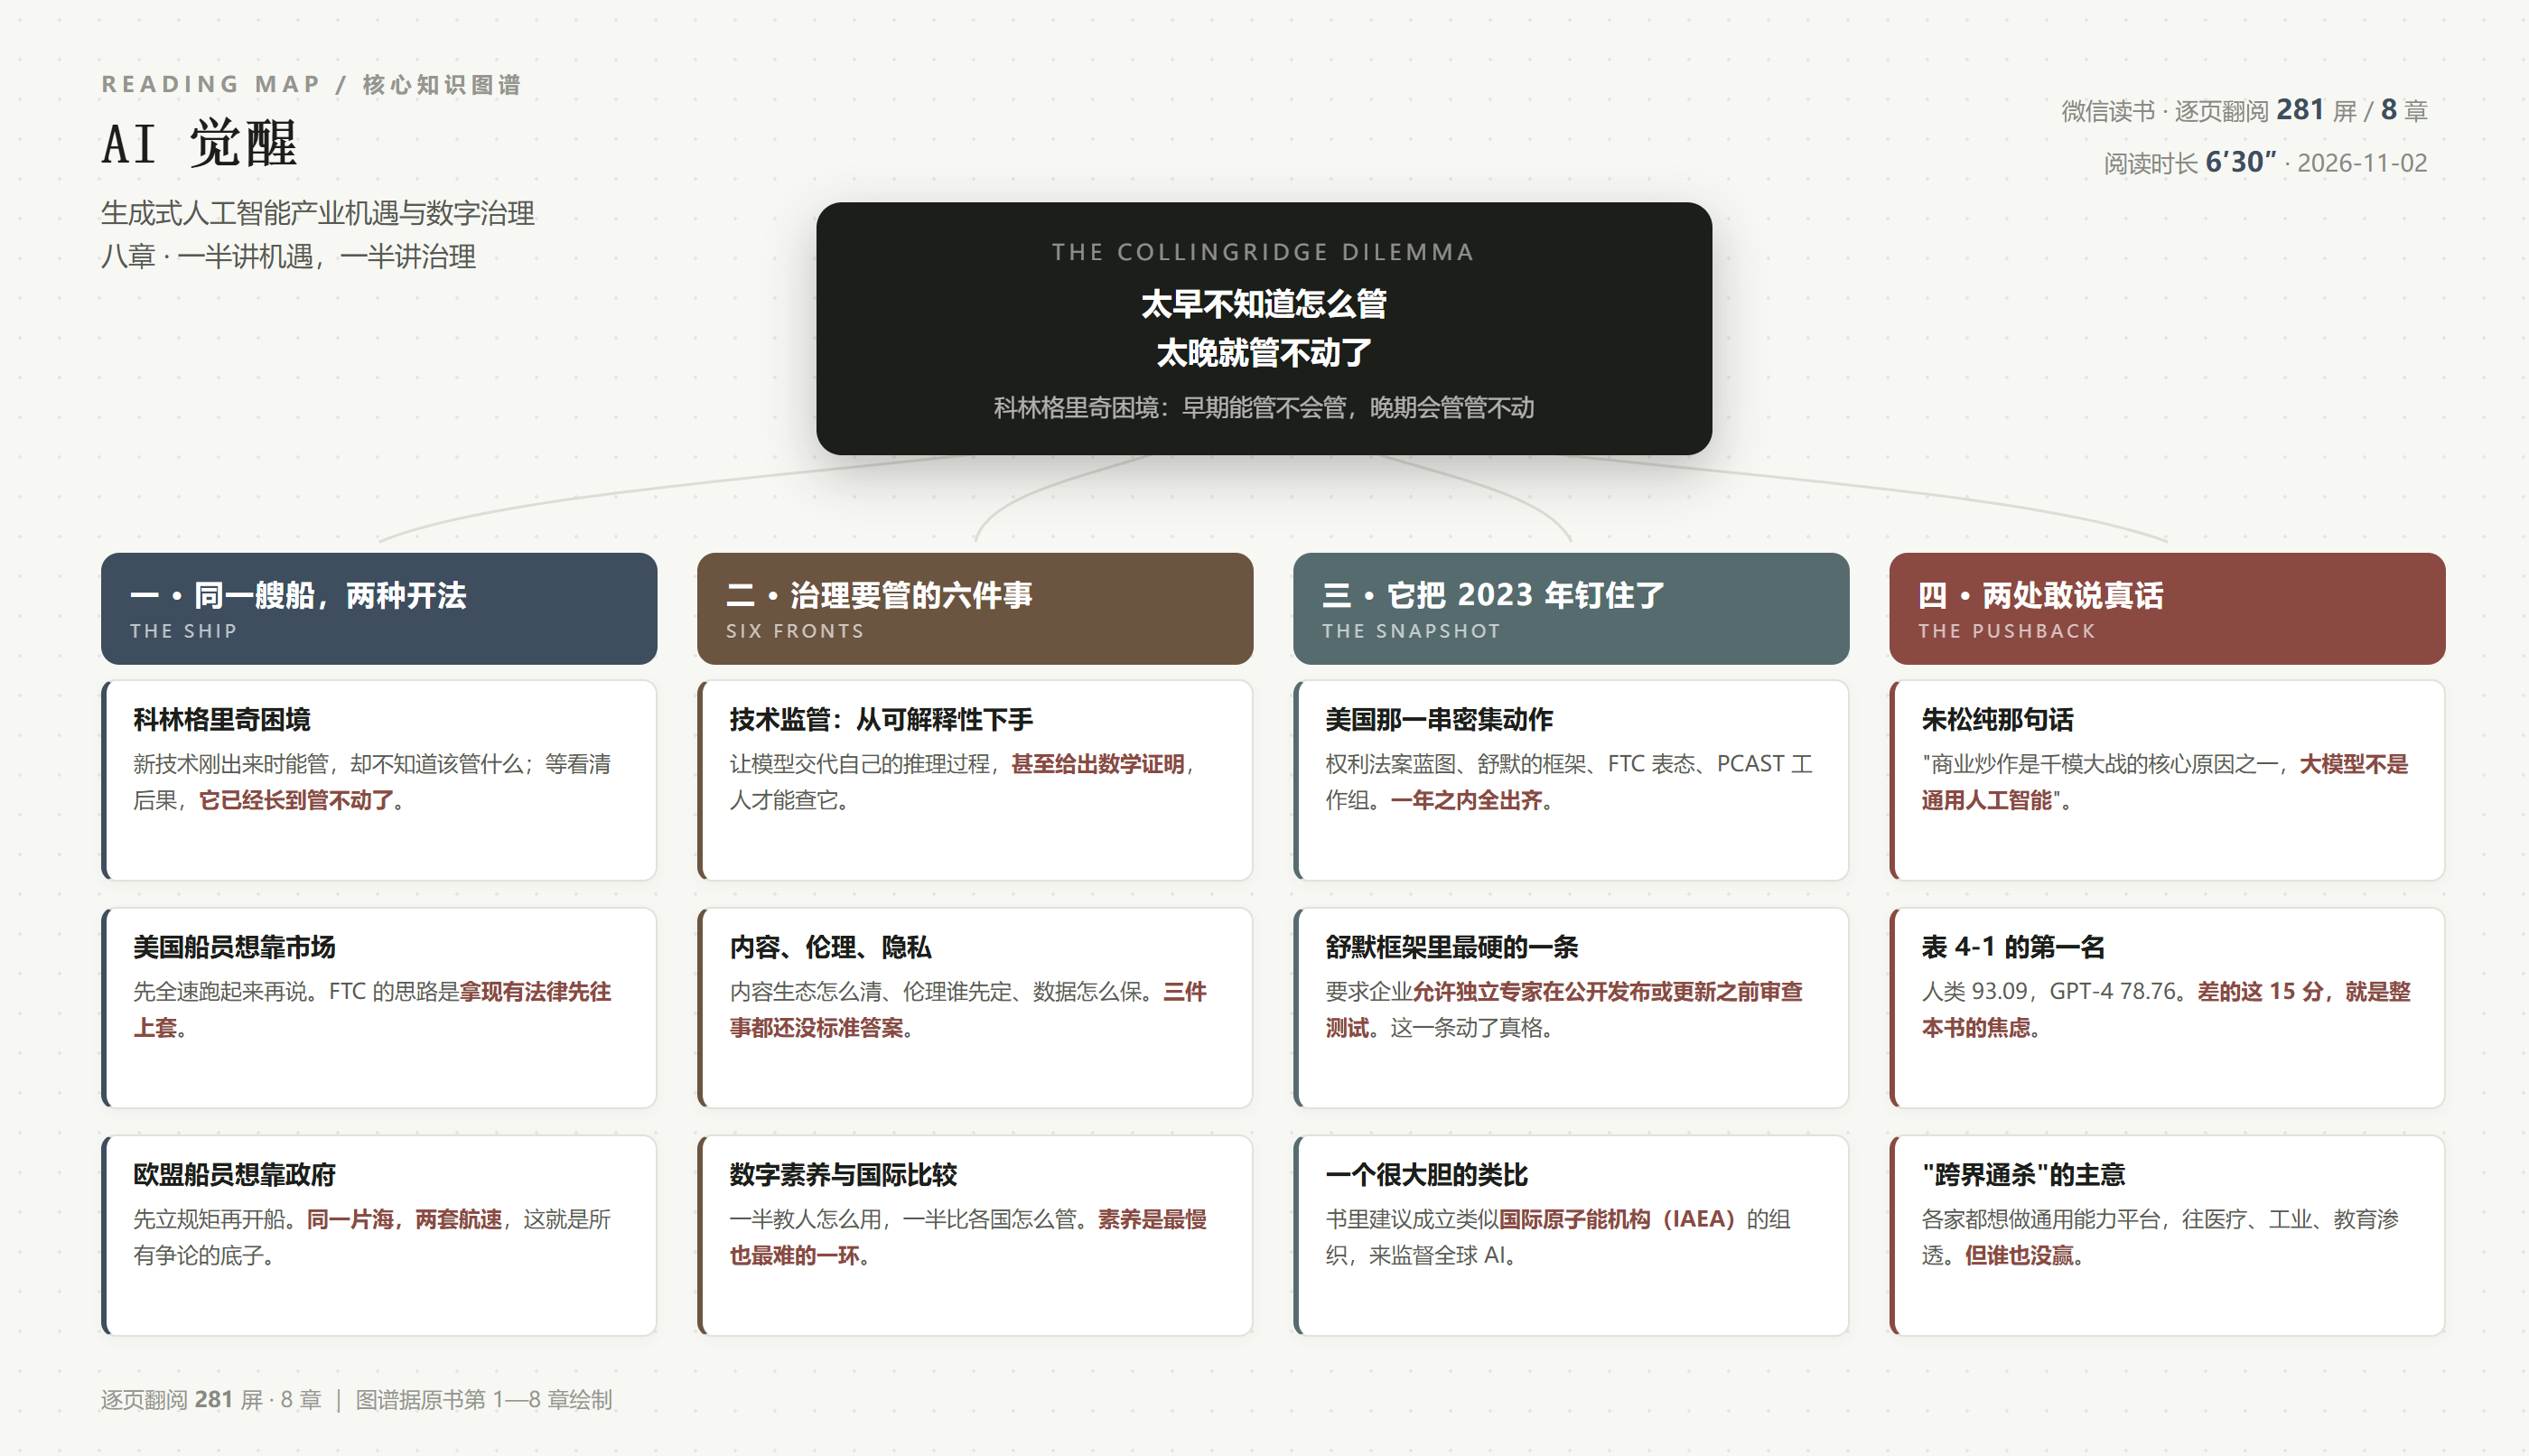
本书知识图谱见文中配图,原图地址:https://jiangtian.top/zb_users/upload/kg/ai-awakening-map.png
发表评论: