
AI绘画:Stable Diffusion从入门到精通:十档对照做完了,种子没锁
微信读书《AI绘画:Stable Diffusion从入门到精通》· 8 章 · 134 条目录 · 603 屏
逐页翻阅 603 屏 · 读至末页「后记」· 2026-11-06
说明:603 是微信读书的屏幕数,不折纸页。从 p0001「版权信息」翻到 p0603「后记」,中途没跳页。为了写这篇,我逐字核对了十处:p0094 CFG 系数、p0128 跨平台提示词、p0130「提示词没有固定的格式」、p0163 括号与权重、p0193 图 4-3 重绘幅度十档、p0270 LoRA 目录、p0273 人脸随机性、p0360 Canny 案例、p0368 反向提示词、p0579 图 8-11 参数面板。引文都出自这十处,没翻到的地方不写。
先说结论:这本书做了我在同类 SD 书里很少见到的一件事——用十张图做了一次参数扫描;然后它做了同类书里最常见的一件事——把这次扫描的唯一变量放跑了。
603 屏,8 章,134 条目录。分配是这样的:序言与前言 15 屏,第 1 章人工智能绘画概论 48 屏,第 2 章 SD 基础 46 屏,第 3 章文生图 78 屏,第 4 章图生图 79 屏,第 5 章 LoRA 74 屏,第 6 章 ControlNet 144 屏,第 7 章 SD 视频 80 屏,第 8 章综合案例 39 屏。
看到这个比例,我大概能猜到作者的用心程度排在哪里:ControlNet 一章 144 屏,占全书 24%,比后三章加起来还多;而综合案例只有 39 屏,占 6.5%,收尾收得很急。这个分配不坏——ControlNet 确实是 SD 里最难也最值钱的部分,给它四分之一篇幅是对的。问题在于它给的方式:十五种预处理,一种一张图,平均六屏,然后进下一个。
一、十档对照,没锁一个种子
p0193 是我在这本书里翻得最久的一页。它在讲图生图的重绘幅度(Denoising strength),步骤 04 的原文是:
步骤 04 测试一下图生图重绘幅度的参数,分别设置为 0、0.1、0.2、0.3、0.4、0.5、0.6、0.7、0.8、0.9,生成的图像如图 4-3 所示。
图 4-3 是十张小图排成两行,每张下面标着数值。这是标准的参数扫描,也是我在这个品类里最想看到的东西。因为重绘幅度是 SD 里最难讲清的一个参数——它不是"调大就好"或"调小就好",它是"在多大程度上允许模型改掉原图"。0.2 的时候人还在,只是妆容变了;0.7 的时候构图还在,人已经换了一个。这个变化曲线只能看,不能读,而这本书真的把它排出来了。
然后我翻到 p0273,看到一句话,把前面那张图的证据价值打了个对折:
方形的图像大概率会生成一个半身肖像,每次生成的人脸都是不固定的,有很大的随机性,如图 5-3 所示。
这句话讲的是 LoRA 用文生图打底时的问题,但它无意中把图 4-3 的实验设计否掉了。如果每次生成的人脸都不固定,那么图 4-3 里那十张脸不一样,到底是因为重绘幅度从 0.1 加到 0.2,还是因为它换了个人?读者看到 0.4 那张眼睛变小了,会以为"重绘幅度调到 0.4 会改变眼睛";其实可能只是种子变了。
要救这张图,只需要一个数字:把随机种子固定住。在 WebUI 里,种子填 -1 是随机,填一个具体数字就是锁定。锁定种子、锁定提示词、锁定步数,只改重绘幅度,那十张图的差异才能被归因到重绘幅度上。这本书里,图 4-3 的图注只写了"重绘幅度(Denoising)参数测试",没有写种子,也没有写其余参数。
我特意把这条放在第一节,是因为它不是"挑刺",它是这本书最深的一处方法论缺口:它有做实验的意识,没有做实验的规范。而这两件事之间的距离,恰好是一本"入门到精通"该跨过去的那一步。入门书可以只给结论("0.5 左右比较合适"),精通书必须给判据("在什么条件下、用什么方法、你也能测出 0.5 比较合适")。它给了十张图,但没有给你复现这十张图的方法。
二、它给的边界条件,比数值更值钱
说完最失望的一处,我要说一处它做得比大多数同类书好的:它不只给推荐值,还给失效边界。
p0094 讲 CFG 系数(提示词引导系数),原文是这样写的:
默认的 CFG 值为 7(见图 2-18),这是在创造力和提示词之间取得最佳平衡的值。通常不建议将该值设为低于 5,因为太低的值会使得提示词无法有效控制生成的图像,而将该值设为高于 16 可能会导致图像出现丑陋的伪影。
这段话里有三个层次,而且三个都对:默认值 7、下限 5、上限 16。下限的理由是"提示词无法有效控制",上限的理由是"出现伪影"——两个理由都是可观察的失效现象,不是"效果不好"这种主观判断。紧接着图注下面还补了一行:"CFG 2~6:这些值可以扩展我们的创意,但可能会失真,因为计算机有过多自我发挥的余地,无法按照提示词进行操作。"
这就是我说的"边界条件比数值值钱"。一本只告诉你"CFG 设 7"的书,你遇到问题时无处可查;一本告诉你"低于 5 会失控、高于 16 会出伪影"的书,你至少知道自己现在在哪一侧、该往哪边调。前者给的是一个点,后者给的是一条线。
同样的写法在 p0163 又出现了一次,讲权重语法:
其中 N 是一个数字,表示关键词的权重为原始权重的倍数。例如,"(关键词:1.5)"表示关键词的权重为原始权重的 1.5 倍。
建议不要采用超过 2 倍的权重,否则可能会导致生成的画面不稳定或质量急剧下降(画面可能会崩)。
"画面可能会崩"这五个字很土,但它是一个可以被验证的预言。我给这本书记的这一功,就在这类地方:它敢把"崩"写出来,而不是含糊地说"建议适度"。写工具书的人常常有一种职业性的怯懦,怕说死了被读者拿反例打脸,于是通篇"适当调整"。这本书在参数上不太怯懦,这一点值得肯定。
还有一处细节,是这本书真正的实用价值所在:它给英文提示词的时候,几乎都配了中文逐词释义。p0128 给了一段 Midjourney 作品的提示词,"Exquisite Chinese art sculpture, cranes, clouds, flowers, full of golden layers, jade, gold, cyan, traditional Chinese art, art station, intricate details, high quality, cinematic, 3D rendering, Octane, unreal engine, 8K",下面紧跟着"对应的含义:精美的中国艺术雕塑,鹤,云,花,充满金色的层,玉石,黄金,青色,中国传统艺术,艺术站,复杂的细节,高品质,电影,3D 渲染,Octane 渲染,虚幻引擎,8K"。p0368 的反向提示词也一样,"paintings, cartoon, (worst quality:1.8), (low quality:1.8)……"配了"绘画,卡通,(最差画质:1.8),(低画质:1.8)……"。
这件事看起来是小事,实际是 SD 中文书最大的门槛:读者认识 cinematic,但不一定知道它在提示词里的作用是"电影感调色"还是"电影画幅"。逐词译一遍,读者才能自己组装。这本书的"对应的含义"这四个字,全书出现了很多次,是它最朴素也最有效的教学设计。
三、把 MJ 的词搬进 SD:跨引擎搬运没人解释
但同一个 p0128,也暴露了这本书一个贯穿性的问题:它把 Midjourney 的提示词直接搬进 Stable Diffusion 用,只用一句"它在 Stable Diffusion 中的效果如图 3-13 所示"就过渡过去了,中间没有一句解释为什么可以通用。
这段提示词里,"Octane"是渲染器,"unreal engine"是游戏引擎,"8K"是分辨率——这三样在 Midjourney 里是有效的画质词,因为它们训练语料里就带着"用这些词标注的高质量图"。而在 SD 里,画质的主要来源是模型本身(大模型、LoRA、VAE)、采样器与步数,提示词里的"8K"更多是噪声。两个引擎的"画质"不是一个东西:一个是检索式的加权,一个是条件生成里的偏置。
我不是说不能搬。搬是可以的,甚至经常有效,但你得告诉读者"为什么有效"和"什么时候无效"。比如:画质词在 SD 里可以保留,但优先级低于模型选择;风格词(art station、cinematic)在 SD 里常常需要一个对应的 LoRA 才能稳定;而"Octane、unreal engine"这类 3D 渲染词,在写实模型上会把人脸推成塑料质感。这些都是有经验的用户默认知道、新手完全不知道的事。
这本书选择了跳过。而它跳过的方式很典型:它把"能出图"当成了"讲对了"的证据。图 3-13 确实出了一张还不错的图,于是这段提示词就被认定可用。但一张能看的图不是证据,它只是没有反例。真正的证据应该是:同一段提示词,删掉"Octane, unreal engine, 8K"之后,出图差多少?如果几乎一样,这三个词就是装饰;如果差很多,那它们的作用机制值得写一屏。
更矛盾的是 p0130。第 3.2 节"提示词的语法"开头第一句是:
人工智能绘画是一项新兴事物,提示词没有固定的格式。
这句话是诚实的,也是免责的。诚实在于它说的是事实:SD 的提示词确实没有语法规范,词序、权重、否定都靠经验。免责在于——说完这句之后,全书依然给了一套固定格式(画质与风格、画面内容、画面表现、功能性文本,四个板块),并且后面的案例全部按这个格式写。你不能一边说"没有固定格式",一边把一种格式当作标准答案来教,却不说明"这只是其中一种排法"。
我给这种写法起了个名字,叫"先免责再示范"。它的好处是作者安全——万一读者照做失败了,书里早写着"没有固定格式";坏处是读者失去判据——既然没有固定格式,那我写成什么样算对?一本教语法的书说"没有语法",等于把学生交还给运气。正确的说法应该是:没有官方语法,但有稳定的经验顺序,顺序影响权重的分配,先写主体后写修饰,越靠前的词权重越高——这一段,书里在 3.2.4"提示词的顺序"讲了两屏,可惜只有两屏。
四、ControlNet 144 屏:十五种预处理,一种一张图
第 6 章是全书最厚的一章,144 屏,占 24%。结构是:6.1 了解 ControlNet(12 屏,原理一屏、安装七屏、参数五屏),6.2 十五种类型与功能(103 屏),6.3 两个案例(31 屏),6.4 思考与练习(1 屏)。
我按目录把 6.2 的十五种逐个数了一遍屏数:Canny 8 屏、Depth 10 屏、局部重绘 4 屏、Lineart 9 屏、MLSD 4 屏、Normal 6 屏、OpenPose 3 屏、Reference 3 屏、Scribble 6 屏、Seg 5 屏、Shuffle 4 屏、SoftEdge 11 屏、T2IA 9 屏、Tile 4 屏、IP2P 4 屏。十五种加起来 90 屏,平均六屏一种,最长 11 屏(SoftEdge),最短 3 屏(OpenPose、Reference)。
这个颗粒度能干什么?能让你知道"有这么一种",不能让你知道"什么时候用这一种"。我抽了 Canny 和 Depth 两节读。Canny 那一节给了一个帆船案例,提示词是"Sailing, sailing on the sea, seagulls, sunshine, white clouds, high quality, high resolution"(配了中文"航海,海上航行,海鸥,阳光,白云,高画质,高分辨率"),然后是一张成品图。Depth 那一节的形式差不多:一张原图、一张深度图、一张成品图、一段提示词。
问题不在于例子少,在于缺一张对照。十五种预处理,读者最需要知道的是它们之间的差别:Canny 和 Lineart 都是提线条,什么时候选哪个?Depth 和 Normal 都是提结构,为什么有人用 Depth 有人用 Normal?Seg 和 Shuffle 都跟颜色分配有关,边界在哪?这本书一页都没做横向对照,各种之间是并列的、平行介绍,谁也不比谁更该被选。
如果让我改写 6.2 这一节,我只加一张表,四列十五行。第一列是"输入"(照片、线稿、深度图、姿态骨架、语义分区),第二列是"控制什么"(轮廓、景深、比例、骨骼、色调),第三列是"最不适合的场景",第四列是"失败时长什么样"。第三列最重要,因为十五种预处理里,每一种都有它一定会失败的情况:Canny 对毛发和树叶会把边缘糊成一团;Depth 对半透明物体判断不出前后;OpenPose 遇到遮挡的手臂会直接跳过那根骨头。读者真正需要的不是"这十五种是什么",而是"我现在这张图适合哪一种、用错了会看到什么"。
而这一章最有价值的一句话,恰恰是被埋在案例末尾的一句:线稿上色要选 invert 预处理器,而不是直接选 Lineart。(这一点我上一本读的《AI绘画:技术、创意与商业应用全解析》里,是写在"作者心得"里的。)这种"反直觉但必须知道"的知识,在 ControlNet 里不止一处,可它每次都被放在最后一屏,前面三步的正文不提。读者如果只按步骤走,会在第三步拿到一张黑白反色的图,然后怀疑自己装错了模型。
五、写死的 D 盘路径:这一章的保质期写在正文里
p0270 是 LoRA 那一章的开头附近,讲怎么设置 LoRA 目录:
打开设置选项卡,进入"Additional Networks",将目录设置为 D:\Program Files\stable-diffusion-webui\models\lora,如图 5-2 所示。请注意,这里的 D:\Program Files\ 是笔者的 Stable Diffusion 软件的安装位置,读者需要根据自己的安装目录进行相应的设置。
这段话里有两处会过期,而且过期的方式不一样。
第一处是"Additional Networks"。这是早期 WebUI 的一个扩展,用来管理 LoRA 与 LyCORIS。后来的 WebUI 版本把 LoRA 做成了内置的标签页,装过新版的人打开界面,根本找不到"Additional Networks"这一项。读者照着做,第一步就卡住,而且卡住的原因不是他笨,是书里的界面已经不是他屏幕上的界面。
第二处是那个绝对路径。作者很贴心地补了一句"读者需要根据自己的安装目录进行相应的设置",这句话救了半条命——至少读者知道要改。但它同时说明:这段文字没法照抄,只能翻译。而一本工具书的正文,如果必须被读者翻译一遍才能用,它的"可操作性"就打折了。更好的写法是给相对路径(models\lora),再补一句"在你的 WebUI 根目录下"——这样就不需要翻译。
我说"保质期写在正文里",是因为这本书的版本痕迹非常明显:整合包的安装界面、ControlNet 的选项卡编号、LoRA 的扩展入口、SadTalker 的安装步骤——每一处都是"当时的界面"。这不是作者的错,SD 生态半年一变,任何纸书都追不上。但作者可以做一件事:把"界面在哪"和"原理是什么"分开写。原理不随界面变,界面随版本变;把易变的部分收进附录或图注,把不变的部分留在正文,这本书的寿命能长一倍。它没有这么做,于是 134 条目录里,有相当一部分条目描述的是一个已经不存在的按钮。
六、综合案例:三个参数撑不起一次"从入门到精通"
第 8 章是"综合案例",39 屏,做一只凤凰。结构是:素材准备 6 屏、模型准备 7 屏(LoRA、主模型、其他模型)、提示词 2 屏、参数设置 2 屏、LoRA 调整 4 屏、图生图控制影调 4 屏、ControlNet 控制轮廓 4 屏、用脚本提高分辨率 7 屏。
一本书的最后一章,通常是它最想证明自己的地方。而这 39 屏里,参数设置只占了 2 屏。p0579 的图 8-11 是"为文生图提供的参数设置",面板上能看清的只有四个数:宽度 768、高度 1024、总批次数 1、单批数量 1,以及提示词引导系数 10。
缺的是三样最关键的东西:采样器、迭代步数、随机种子。而这三样恰恰决定了一张图能不能被复现。同样的 768×1024、同样的 CFG 10,用 Euler a 跑 20 步和用 DPM++ 2M Karras 跑 30 步,出来的凤凰不是同一只。综合案例的意义是"你可以照着做出一模一样的东西",而这本书的综合案例只能做出"一只差不多的凤凰"。
我知道有人会说:截图里可能被滚动条挡住了。这个可能性我认,因为图 8-11 只截了参数面板的上半部分。但这也正是我要批评的点:既然知道要截参数,为什么不把整块面板截全,或者在正文里补一行文字?全书 134 条目录里,"参数设置"这样的节名出现了不止一次,每次都是这样两屏、一张半截面板。这不是能力问题,是取舍问题——作者认为"看得见的部分"就够教了。
顺便给一个自检清单,六个字段,缺一个就不算可复现:主模型文件名(含哈希)、LoRA 名称与权重、采样器名称、迭代步数、CFG、随机种子。这六样写全,一张图在别人的机器上也能长回来;缺任何一样,剩下的都只是"大概像"。这本书给的是分辨率、批次数、CFG 三样,缺模型名、采样器、步数、种子四样。它其实全书都在给模型名(第 5 章讲 LoRA 时连 Civitai 的筛选条件都截了图),偏偏在最需要复现的那一章省了。
同一章里有一处做得好的:Ch.8 把流程拆成了八步,从素材到出图,每一步都以"能交出一个东西"为终点(一段提示词、一组参数、一张线稿、一张成品)。这个"每步都有交付物"的拆法,比很多书按"软件功能"拆要实用得多。如果这本书的其余七章也按这个逻辑重排,它会成为一本真正能带着做项目的书。它只在最后一章用了这个结构,前七章还是按软件面板排的。
七、目录 134 条,没有一条叫"报错"
我把 134 条目录从头到尾过了一遍。8 章,从"人工智能绘画概论"到"综合案例",中间是基础、文生图、图生图、LoRA、ControlNet、视频。结构是完整的能力阶梯,没有跳章,这一点比同类书强——我读过的 SD 书里,不少是"讲完安装直接进 ControlNet",中间的参数章节整个缺失。
但 134 条目录里,没有一条讲"报错""显存不足""装不上""跑不动"。唯一接近的是 7.4 补帧工具 EbSynth 和 7.5 SD-CN-Animation 的"1 stage 1 / 2 stage 2 / 3 stage 3"这些步骤,它们讲的是流程,不是故障。
这是这类工具书最要命的一处空白。SD 的真实体验里,出图只占三成时间,剩下七成在跟环境打架:模型下到一半断了、VAE 不匹配导致画面发灰、ControlNet 模型版本与 WebUI 版本对不上直接红字、8G 显存跑 1024×1024 必 OOM、xformers 装了反而更慢。这些事不会写在"从入门到精通"的目录里,但它们决定了一个人能不能从入门走到精通。
我给这本书补一节,标题就叫"出不了图的时候"。内容只需要三屏:第一屏,三类最常见的红字(模型不匹配、显存不足、扩展版本冲突)分别长什么样;第二屏,每一类的第一动作是什么(换模型、降分辨率、关扩展),不是原理,是动作;第三屏,一张"排查顺序表",从上到下五步,每步一句话。
这本书其实有这个能力——第 6 章讲"预处理器与模型要成对装"那几屏,细致到会告诉你少装一个就出灰图,那种颗粒度正是读者需要的。它只是没把这份细致用在"出错"上,因为出错不好看。而读者买书,买的常常不是"怎么成功",是"失败的时候翻哪一页"。
八、它的短板
收拢成四条。
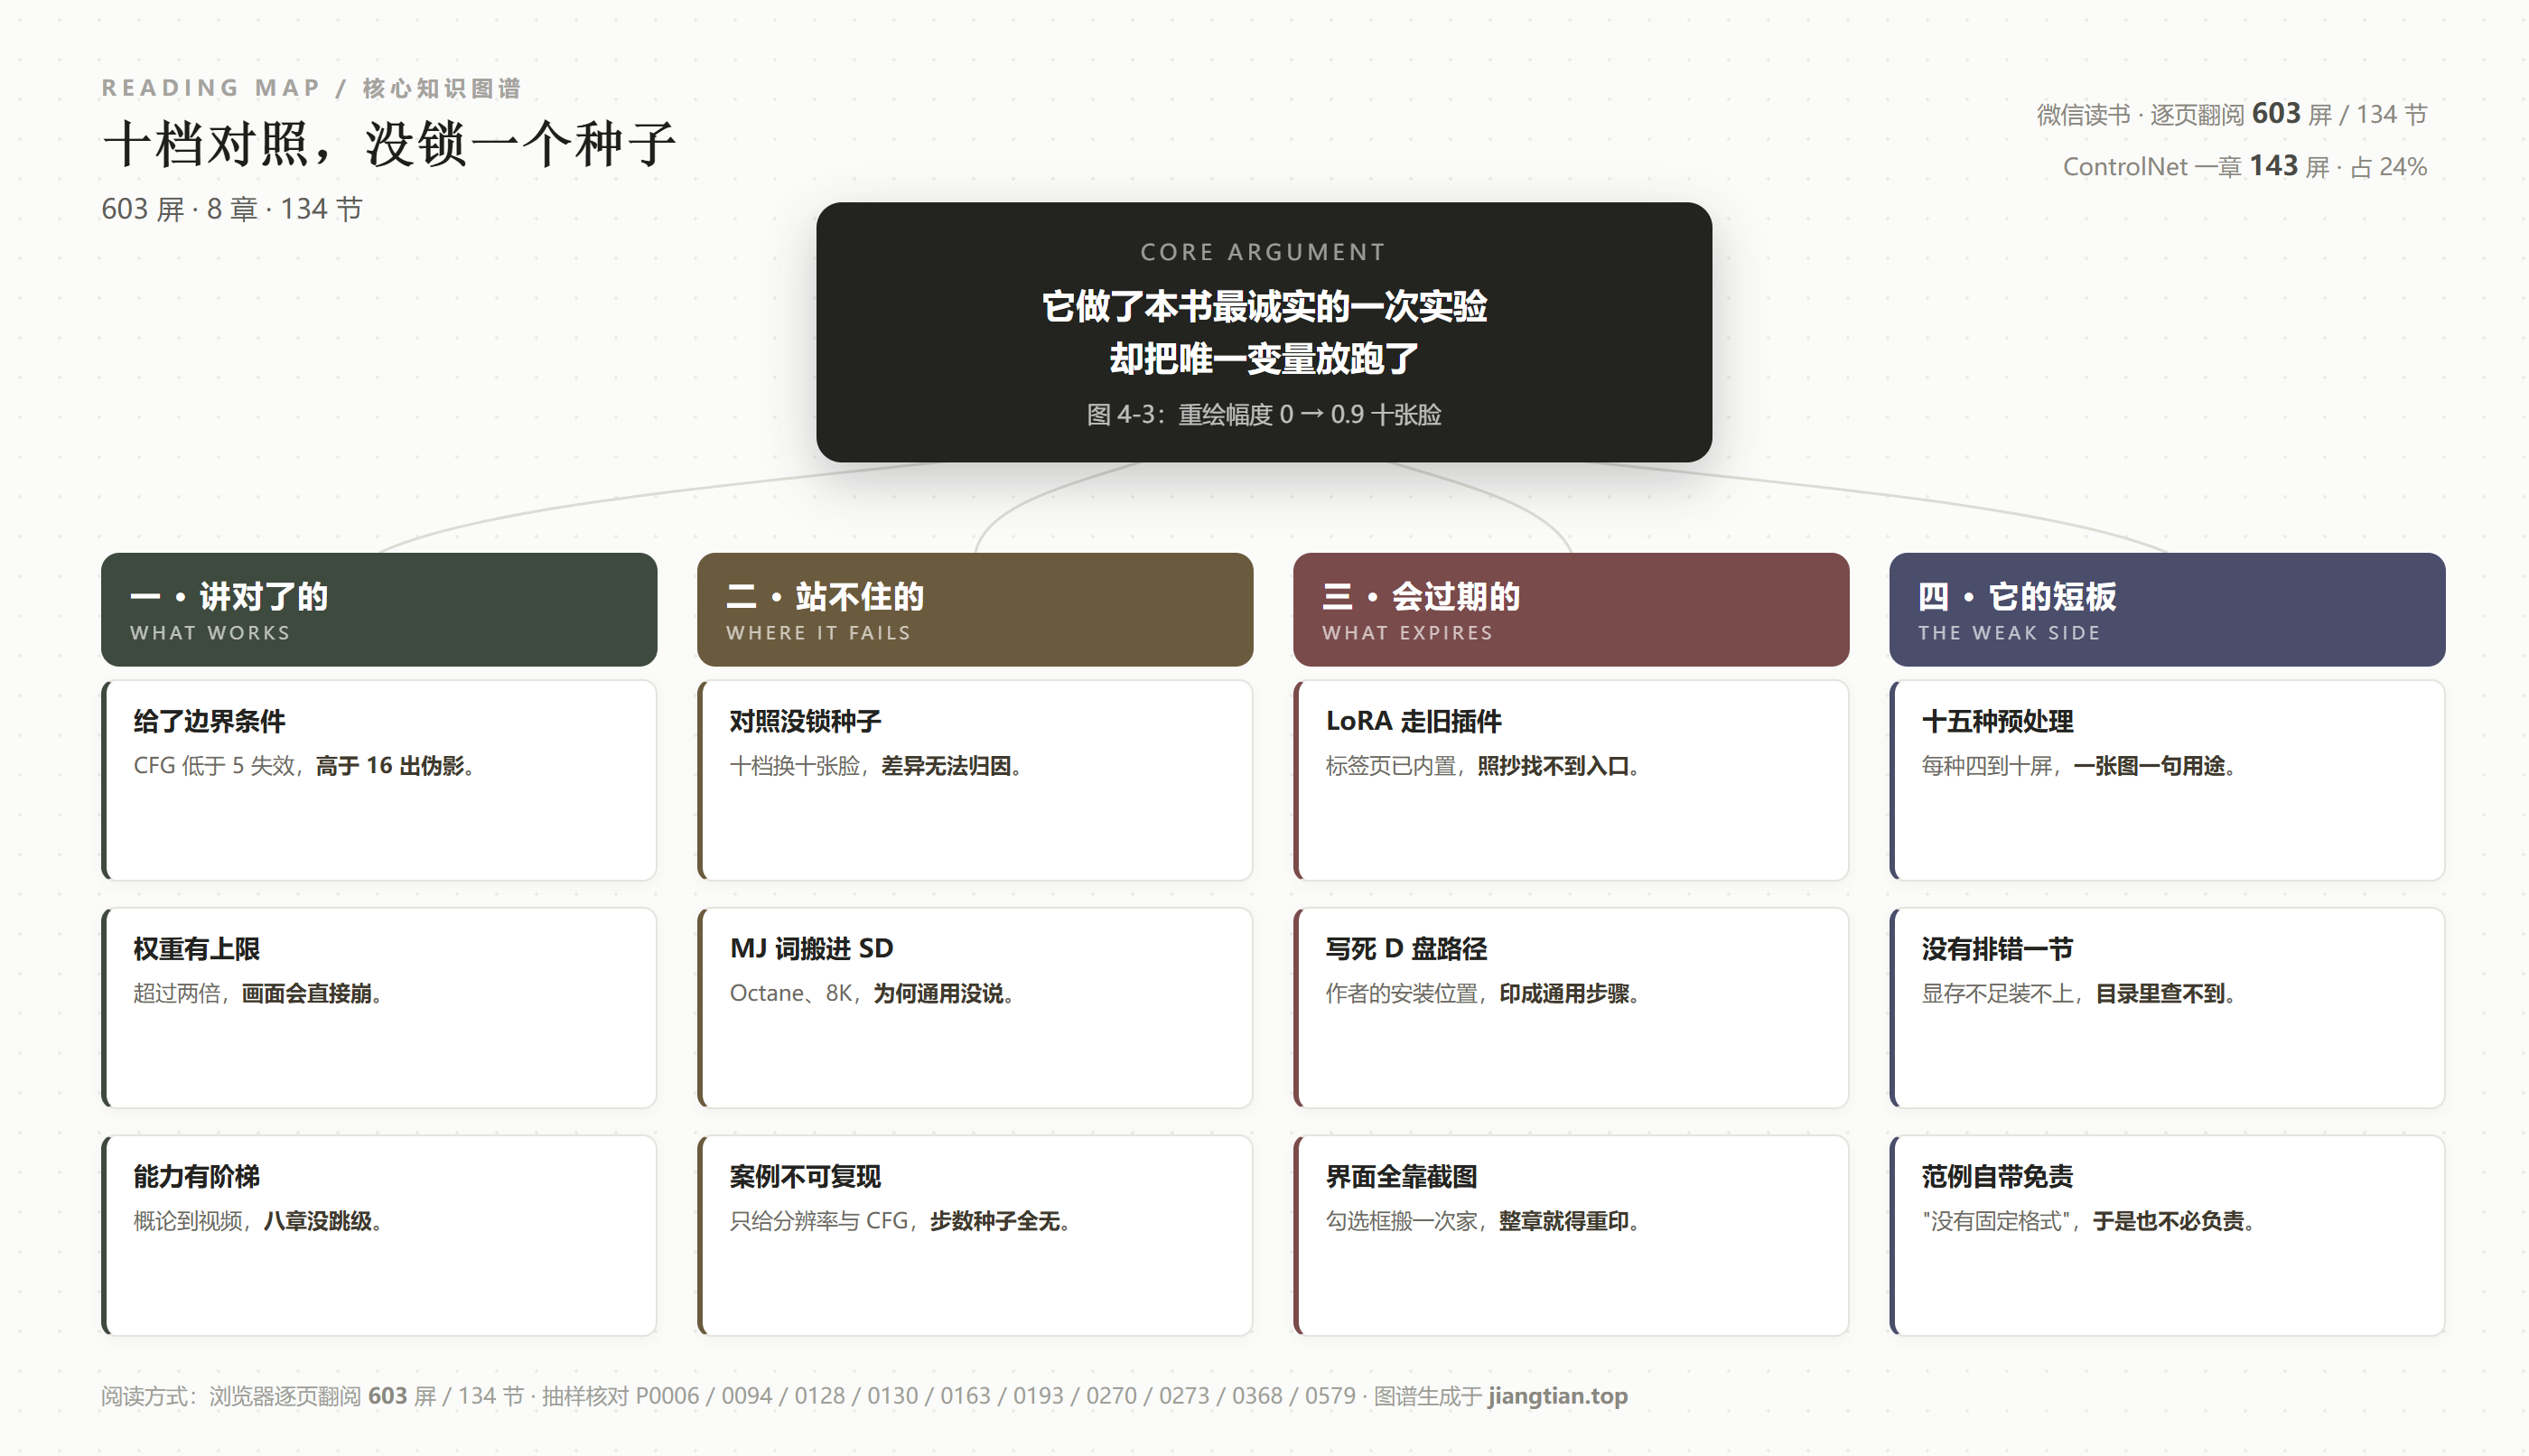
第一,实验有形式无规范。图 4-3 的十档扫描是这本书最有价值的一次尝试,但它没锁种子、没写其余参数,读者无法复现,也无法归因。这一条我不认为作者不懂——他在 p0273 明确写了"每次生成的人脸都是不固定的"——他知道随机性存在,只是在做对照时没把它固定住。知道一个变量会影响结果,却没在实验里控制它,这是方法论上的疏忽,不是知识上的欠缺。
第二,跨引擎知识不设边界。Midjourney 的提示词搬进 SD,只给结果不给解释;"提示词没有固定格式"之后又给一套固定格式,不说明这是其中一种。这两处合起来,会让读者形成一种"词写对了就行"的错觉,而 SD 的真实权重在模型、在 LoRA、在采样参数上。
第三,界面依赖过重。"Additional Networks"、写死的 D 盘路径、整合包安装截图——这些内容在出版时是对的,在读者打开书时可能已经不对。工具书的合格线是"照着做能跑通",而这本书的相当一部分步骤,需要读者先把书翻译成自己屏幕上的样子。
第四,收尾太急。前七章 564 屏,最后一章 39 屏,比例是 14:1。一本叫"从入门到精通"的书,最后那个"精通"的证据只有 39 屏,而且缺三个关键参数。读者读完前七章,知道每个零件怎么用;读完第八章,还是不知道这些零件怎么装成一台机器。
那么它适合谁?适合已经有 WebUI、能把图跑出来、但参数全靠试的人。这类人最缺的不是教程,是边界:CFG 到 16 会出伪影、权重超 2 倍会崩、重绘幅度是一根从"改妆"到"换人"的滑杆。这三条它都给了,而且给得干脆。就凭这三条,它比大多数"SD 从入门到精通"值钱。
它不适合谁?不适合还没装好环境的人(界面章节会把你带沟里),也不适合想复现某张具体作品的人(全书没有一处给全参数)。
我自己的读法是:第 2 章 2.2 那 46 屏(模型、选项卡、采样方法、步数、分辨率、CFG、种子)先通读一遍,这是全书信息密度最高的地方;然后直接跳到第 4 章看图 4-3 那十张脸,自己动手锁上种子重做一遍;第 6 章十五种预处理只看 Canny、Depth、OpenPose、Tile 四种,其余十一种等遇到再用。剩下的安装、视频、综合案例,当查表用。
最后说一句公道话。这本书让我有点为难:它的参数讲得比大多数同类书清楚(有边界、有中文对照、有上限警告),它的实验意识也比大多数同类书强(真的排了十档),但它在两件最难的事上都停在了半步——实验停在"排出来",没走到"锁住变量";教学停在"点这里",没走到"什么时候别点"。这半步的距离,正是"入门"和"精通"的距离。书名承诺的那半步,它没走完。
会排十张图的人,一定知道该锁种子。他没锁,说明这本书想给你看的是一张好看的图,不是一次能重来的实验。
阅读记录:微信读书《AI绘画:Stable Diffusion从入门到精通》· 603 屏 / 8 章 / 134 条目录 · 逐页翻阅至 p0603「后记」· 抽样核对 p0094、p0128、p0130、p0163、p0193、p0270、p0273、p0360、p0368、p0579 · 2026-11-06
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: