
《零基础开发AI Agent——手把手教你用扣子做智能体》:十一个案例全跑通,一次失败没写
微信读书《零基础开发 AI Agent——手把手教你用扣子做智能体》· 重新完整抓取 500 屏 · 118 个章节标签 · 抓取标记 reached_end=True(end_reason=last_page)
逐字核对 15 屏 · 本篇为重写:旧稿发布于 2026-11-11,当时记录 734 屏、本地索引只覆盖 287 屏,结论被迫挂在「待复核」上——那次我确实没读完就下了判断。这一轮从第一屏翻到第五百屏,断在书尾最后一页,没有缺口,也不需要再拿「索引不全」给自己的结论打折扣。
抽样点位的选法:这是一本平台教程,骨架是「认知 → 平台 → 流程策略 → 功能模块 → 十一个案例」。我按四条线抽:作者与身份(p0006,看这本书是谁写的、写给谁)、认知段(p0020 / p0078,看它用什么尺子评价一个 Agent 平台)、方法论(p0100 / p0110,全书唯一讲「怎么想」的两屏)、案例与运行(p0280 / p0286 / p0340 / p0420 / p0480,看它交付的水位)。另外核实了平台细节 p0060 / p0106 / p0136 / p0160 / p0220。章屏数不是估的,是按 pages.jsonl 的 118 个标签对 500 屏全量切分,每一屏都有归属。
先把话说清楚:这一轮我读完了这本书,读完之后对它的评价,比只读三分之二时更低。
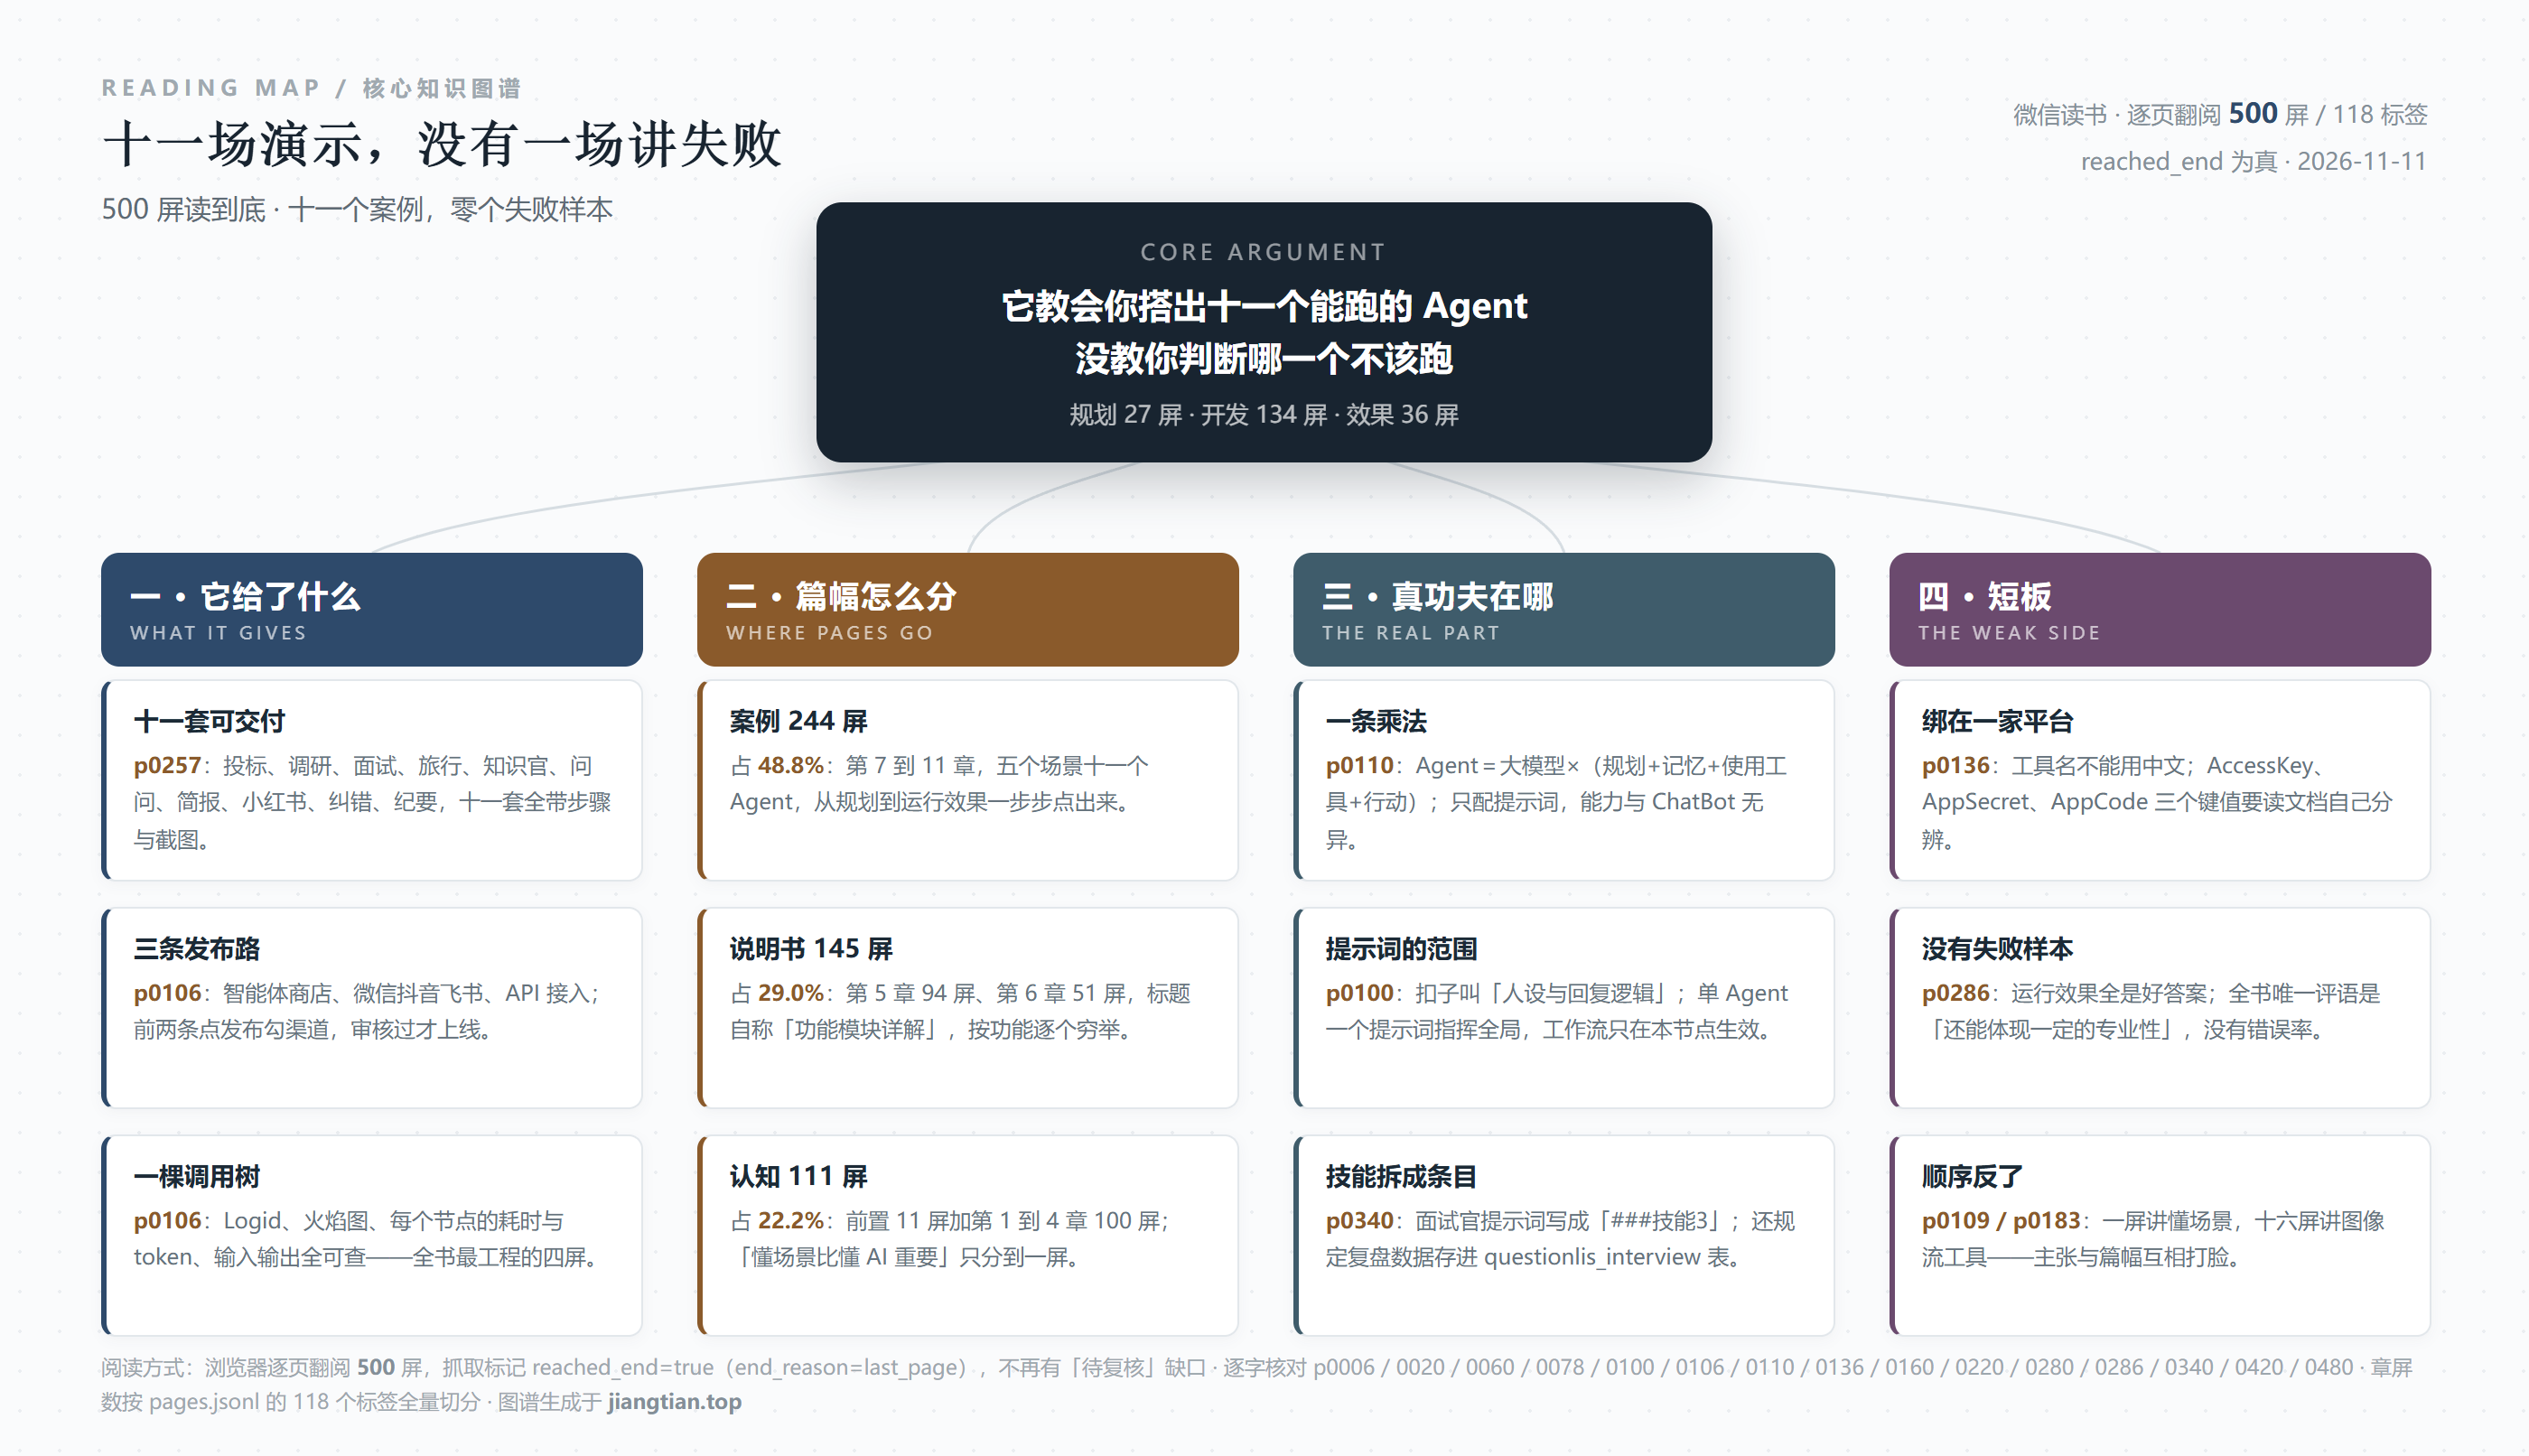
原因不是它写错了什么,而是它的篇幅分配自己说出了真话。500 屏里,讲「为什么」的认知段(前置 11 屏、第 1 至 4 章 100 屏)共 111 屏,占 22.2%;讲平台的「功能模块详解」两章(第 5 章 94 屏、第 6 章 51 屏)共 145 屏,占 29.0%;而第 7 到 11 章的十一个案例,244 屏,占 48.8%。
再往案例里面切一刀:十一个案例里,「规划 Agent」共 27 屏,「开发过程详解」共 134 屏,「运行效果」共 36 屏。也就是说,想清楚要做什么占 11.1%,动手点按钮占 54.9%,展示成果占 14.8%。规划与开发的比例是 1 比 5。
这套比例本身就是一种主张:先动手,别多想;做出来就是成功。这个主张在 2024 年、在「Agent 元年」的语境里是合理的——那时候大部分人的问题确实是「不知道怎么开始」。但 500 屏读完,我必须说清它因此漏掉了什么。
一、先看清钱花在哪:一本「施工手册」,不是一本「设计手册」
第 3 章 34 屏里,有 15 屏在梳理和对比国内外的 Agent 开发平台(3.2.1 十一屏、3.2.2 四屏)。这部分写得挺认真,它给了三个对比维度:模型支持、Agent 核心能力、操作难易度。问题出在第三个维度怎么拆。
p0078 原文:「操作难易度是衡量 Agent 开发平台对非技术开发者友好性的重要指标。一个优秀的 Agent 开发平台,应当能够提供直观、易于理解的操作页面和流程,以及高度模块化、即插即用的工具,以便让非技术开发者也能够轻松地开发出功能强大的 Agent。因此,我们从可视化程度、易理解性、即插即用性3 个方面评估 Agent 开发平台的操作难易度。」
三个子项,全是「好不好上手」。没有一项在问:这个平台做出来的东西,能不能被评测、能不能被监控、失败了能不能回滚、换了平台能不能搬走。它用「上手成本」当主尺子,就把这本书的天花板钉死了——一本以「上手」为评价中心的教程,必然把「上手」写成主要内容,于是有了那 134 屏的「开发过程详解」。
这不是批评作者不努力。第 4 章 21 屏里,4.1.1 那个「3-10 实施框架」只用了一屏(p0092),4.1.2「规划 Agent」四屏,4.1.3「设计 Agent」八屏,4.1.4「上线 Agent」四屏。一个号称「开发流程与策略」的章节,21 屏就讲完了。对比第 5 章 94 屏讲插件、工作流、图像流——这里面 5.3.2「图像流的工具详解」一个二级节就吃掉 16 屏(p0183 至 p0198)。
于是这本书的真实身份就清楚了:它是一本带十一个完整样板的施工手册。施工手册有它的价值——你照着做,确实能做出东西;但施工手册不负责告诉你这栋楼该不该盖、盖在哪儿、地基够不够。
二、它立得住的那一页:一条乘法,就是一张评估表
全书我认为最值钱的是 p0110。它给出的不是一个操作,是一个公式:
「Agent=大模型×(规划+记忆+使用工具+行动)。要想评估一个 Agent 的功能是否强大,可以看它在这 4 个方面的配置情况。」(p0110)
紧接着它把这个公式用在一个反例上:「举个例子,一个角色聊天类 Agent 如果没有配置知识库,没有使用插件,也没有工作流、数据库、记忆等,仅仅设计了提示词,那么它的能力和 ChatBot 不会有很大差别。」再往下更狠:「早期的 Agent 开发平台提供的简易 Agent,差不多就只是个性化的 ChatBot,或者只达到了 Copilot 的水平,从严格意义上来讲不能称其为真正意义上的 Agent。」(p0110)
这三句话合起来,是一个可执行的判断标准:看这个 Agent 配了几项,就知道它是 Agent 还是聊天壳。而且它是乘法不是加法——一项为零,整体归零。这个符号用得准,因为缺了「工具」,规划再强也只能空想;缺了「记忆」,每次对话都从零开始。
更值得说的一点是:作者是知道这把尺子的,他后来的案例也确实按这四项配齐了。p0160 那张工作流截图里,意图识别节点选的是 Doubao-pro-32k-functioncall-preview,往下分出知识库节点和 bingWebSearch 节点——这是「规划 + 使用工具」。p0340 的面试官提示词里,明确要求把复盘数据存进 questionlis_interview 表,字段是 grade、best_answer、worst_answer——这是「记忆」。四项不是概念,是四个可以指认的配置项。
但这里就是全书的第一个裂缝:它给了公式,没给检查表。p0110 之后,这条乘法再也没有作为工具被使用过——没有一页在问「你这个 Agent 缺哪一项」,也没有一页在讲「四项之间的优先级」。它就停在那儿,作为一句漂亮的话。一句能当尺子用的话,被当成了一句总结。
三、第二个可迁移的认知:提示词是有「管辖范围」的
p0100 讲提示词,开口第一句就把名字换了:「在开发 Agent 时,设计提示词也是很重要的环节,扣子称之为「人设与回复逻辑」。提示词是 Agent 调用大模型执行任务的指令,是 Agent 规划、思考能力的体现。」
然后它做了一个区分,这个区分在别处很少被讲清:「在单 Agent 模式下,通常只有一个提示词,Agent 要靠这个提示词来调用大模型、各类插件、知识库、数据库等功能模块,并按照预定义的格式输出结果。单 Agent 模式下的提示词,就像一个系统规划师。因此,撰写单 Agent 模式下的提示词一般会比撰写工作流模式下的提示词更复杂,难度更大,要求更高。」
而工作流模式下正相反:「只有大模型节点才需要提示词……与单 Agent 模式下的提示词指挥全局有所不同,工作流模式下的提示词只在所在的节点起作用,不影响其他节点运行。如果一个工作流中有多个大模型,就需要配置多个提示词,每个提示词都只会匹配各自节点的大模型。」(p0100)
这段的价值在于它讲的是作用域(scope)。写过代码的人对这个词很熟:一个变量的作用域决定了它在哪儿有效。这里,提示词的作用域从「全局」变成了「节点」——这不是界面差异,这是设计范式的差异。单 Agent 是「一个人干所有事」,工作流是「一条流水线上每人干一件事」。前者好写、难调;后者难写、好调。这个取舍,作者用「系统规划师」四个字点到了,虽然没展开。
p0340 接着给了这套东西的落地形态。那一屏是模拟面试官的提示词片段,结构是「###技能3:提供面试考察技巧指导」「###技能4:帮用户储存问题」,每条技能下面编号列动作,还规定了输出格式(「技巧:<具体的面试回答技巧>」「示例:<相关的实际例子>」)和数据落点(questionlis_interview 表)。
用井号分节、用编号列动作、用尖括号标占位——这是把提示词当文档写,而不是当咒语念。这是全书最像「工程」的地方之一:它承认提示词会变长、会被维护、会需要别人接手。但同样的问题又出现了:条目化之后,条目之间冲突怎么办?「技能1 要求简短回答」和「技能3 要求举例说明」撞在一起,模型听谁的?p0340 没答,全书 500 屏也没答。
四、案例篇的真实水位:134 屏教你怎么配,36 屏告诉你能跑
第 7 到 11 章,十一个案例,是这个书的主体。结构高度统一:先「规划 Agent」(1 到 4 屏),再「开发过程详解」(2 到 21 屏),再「运行效果」(2 到 7 屏),最后「举一反三」(1 到 2 屏)。
开发过程那部分,写得确实细。p0280 讲给投标助手加「链接读取」插件:「当需要获取网页、pdf、抖音视频内容时,使用该插件的「LinkReaderPlugin」工具就可以让 Agent 进行内容检索。」然后告诉你点「添加」按钮,「在一般情况下不需要修改输入参数和输出参数」。p0480 讲会议纪要助手的五个开发要点,第一条讲模型能力:「很多会议的内容往往十分丰富,无论是输入的文本量,还是输出的文本量都很大,需要选择长文本处理能力强的大模型,并且选择文本总结能力强的大模型。」
这些都是有效信息,但它们的有效期跟着界面走。真正让我停下来的是「运行效果」这一节。
七点二那个投标助手,运行效果三屏(p0285 至 p0287)。p0286 原文:「在第三轮测试中,我们不针对上传的招标文件提问,而是询问招投标方面的专业知识,以下是一些问题和答案。总体而言,答案还是能体现一定的专业性的。」接着列了问题:「制作工程项目投标文件需要注意哪些事项?」然后三条答案:遵循法律法规和招标文件要求、逐项对答复并做必要解释、开标一览表的重要性。
请注意这句话的措辞:「还是能体现一定的专业性」。这是一个带保留的判断,全书对自家产出的质量评价,最高就到这儿。没有准确率,没有失败案例,没有「这条答错了,因为检索到的段落是另一份文件」。
而「运行效果」在全部十一个案例里只有 36 屏,占全书 7.2%。36 屏里还有相当一部分是截图本身——比如 p0420 整页就是两张图:一张是「目标(Goal)/策略(Strategy)/质量指标(Measurement)」的三段说明,一张是「问问」这个 Agent 的头像和对话界面。文字判断极少。
这里要区分两个东西:演示和评测。演示是「我挑三个问题,它答得不错」;评测是「我准备五十个问题,其中二十个是它答不了的,我看它错在哪儿、错几次、错得有没有规律」。这本书给的是前者。它甚至给了做后者的工具——p0106 讲了 Logid、调用树/火焰图、每个节点的耗时与 token 消耗、输入输出区域,还写了「在排查和定位问题时,往往需要查看请求的完整调用链路」。工具给了,方法没给:看着火焰图,你该看什么指标?
五、它的短板:四条,都用页码说话
第一条,绑死在了一家平台上,而且绑得比想象中深。这不只是「界面是扣子的界面」这种表面绑定。p0136 讲用 API 文档创建插件,原话是:「图 5-15 所示为「API-1:皇历查询」的 API 密钥,有 AccessKey、AppSecret、AppCode 这 3 个键值。你可能很容易把它们弄混,需要仔细阅读 API 文档才能弄清楚具体使用哪个键值。」同一页还规定:「工具名称不能使用中文,必须是英文及相关字符。」
这两句话把「零基础」的边界画出来了:门槛没有消失,它从「写代码」挪到了「读 API 文档」。能读文档、能分辨三个密钥的人,其实已经越过了「零基础」。更硬的绑定在发布环节:p0106 说三条发布路径(智能体商店、微信抖音飞书、API 接入),「Agent 经过审核后就可以上线使用了」——能不能上线,不完全由你决定。而 p0060 已经预告了这套生态的成熟度:「Agent 开发平台最终会像 App Store 一样,构建起一整套完善的交易及会员体系。目前,大多数 Agent 开发平台采用的还是免费模式,商业化的生态还不够成熟。」生态没成熟,规则就会变;规则一变,这本书里 134 屏的操作路径就得重拍。
第二条,它教的是「照着配」,不是「自己设计」。十一个案例,每一个都能一路点下来,但没有一个在讲「如果你的需求和这个案例不一样,该改哪一处」。最能说明问题的是 p0480 的第五条开发要点:「会议纪要助手 Agent 的用户沟通页面很简单。用户不需要输入指令或进行对话,只需要上传会议纪要的记录文档即可。」
这句话是优点,也是这本书的隐喻:它做出来的很多 Agent,本质是一个带大模型的表单。上传文件、点按钮、出结果。这种 Agent 当然有用,但它的「智能」全在被固化的流程里,用户一旦提出流程外的要求,它就没有位置安放。而书里没有一页在讨论:什么时候该做表单,什么时候该做对话,什么时候该做「对话 + 表单」的混合。它把一种形态当成了唯一形态。
第三条,没有失败处理。这是我读完后最想标出来的一处空白。它在 p0110 自己承认:「目前,Agent 还处于从「好玩」到「有用」的过渡状态。Agent 在智能化、自动化、多功能化、性能稳定性等方面都需要提升。」它承认不稳定,却没给不稳定的处置方案:答错了怎么发现、发现了怎么回滚、检索不到时是拒答还是转人工、上线后指标掉了先看哪里。
能佐证这种「只报喜」的,是 p0220 讲知识库采集时的措辞:「自动采集使用起来较方便,可以直接使用,但不能进行数据标注,数据采集的成功率一般。手动采集的数据采集成功率较高,能够进行数据标注,但需要下载并安装浏览器扩展程序,使用起来较复杂。」「一般」是多少?「较高」是多高?没有数字。当一本书连采集成功率都不肯给数字时,它后面所有「运行效果」的可信度都要打折。
第四条,它的主张和它的篇幅在互相打脸。p0109 那一屏的标题是「懂场景和业务,比懂 AI 技术更重要」,正文只有一屏。p0111 讲「坚持小而美,聚焦特定的应用场景和功能」,也只有一屏,但里面有一句很硬的话:「应用场景越具体,用户越聚焦,Agent 的实现路径就越明确,其落地性就越强、价值就越大。反之,如果我们用开发软件的思维,划了复杂而广泛的应用场景和功能,那么很可能导致在技术上无法实现 Agent,或者其稳定性不佳。」
话说得这么重,篇幅给了一屏。而紧接着的第 5 章,用 16 屏讲图像流的工具(5.3.2,p0183 至 p0198),用 14 屏讲怎么照着 API 文档建插件(5.1.3,p0129 至 p0142)。一个人写书时的注意力分配,比他写的句子更能说明他真正相信什么。读者也一样:拿到这本书的人,会照着篇幅密度分配自己的注意力——他会认真读完 134 屏操作,快速扫过那一屏「懂场景更重要」,然后做出第十二个功能齐全但没人用的 Agent。
六、替作者说句公道话:这不是水平问题,是品类问题
把上面四条摆完,容易得出「这书不行」的结论。我不这么看。p0006 的作者页给了我把话说圆的信息:管锴,武汉大学管理学硕士,「拥有多年企业高层管理经验和 6 年企业管理咨询经验。致力于研究如何将 AI 技术有效地应用于企业运营中,以实现降本增效的目标」;张心雨,西北工业大学工学学士、香港理工大学管理学硕士,「曾在头部地产公司从事人力资源管理工作多年」。
两位作者是管理咨询和人力资源背景,不是工程师。这就解释了很多事:为什么全书的组织方式是「流程 + 清单 + 表格」而不是「架构 + 接口 + 状态机」;为什么它反复讲「降本增效」「可替代初级顾问」;为什么它这么擅长把一个模糊需求拆成「第一步填什么、第二步点哪里」。这是咨询顾问的核心手艺,用在写教程上,产出就是一本极其好用的操作手册。
这个背景在第 2 章留下了清晰的指纹。第 2 章叫「开发 Agent 的知识储备」,22 屏里 7 屏讲「Agent 相关术语」(2.1.3),7 屏讲「Agent 开发者的业务流程工具箱」(2.2.2),真正讲决策流程与四大能力的只有两屏(2.1.1、2.1.2)。也就是说,在作者看来,一个 Agent 开发者最该补的「知识」,是行业术语和业务流程图,不是技术。这个判断可以争,但它是自洽的:管理咨询出身的人,确实更信「把流程画清楚,问题就解决一半」;也正因为如此,这本书在「怎么把需求讲清楚」上比同类的技术书强,在「怎么验证做出来的东西」上比同类的技术书弱。
p0020 那句话说得很坦白:「不懂编程的个人开发者,也可以通过可视化的方式开发 Agent。与开发传统软件相比,开发 Agent 的难度明显降低。任何想要开发 Agent 的人都可以开发 Agent,而不限于软件公司、技术人员。」这句话是这本书的合同:它承诺的是「你可以做出来」,不是「你可以做好」。
按这份合同验收,它合格:十一个案例、每个都带完整步骤、每个都有运行效果、每个都配了「举一反三」的小结。一个人照着一周能做出一个能演示的东西,这在 2024 年是稀缺的。
但合同之外还有一件事:读者买这本书,往往不是想「做一个演示」,是想「做一个能用的东西」。这两者之间的沟,书里没有桥。而这条沟的名字,就是那 36 屏——它把「能跑」当成了终点,可「能跑」只是起点。
七、如果你已经买了:三条读法,省一半时间
第一条,三页先行,别从头读。先读 p0110 那条乘法,把四个配置项抄在纸上,当作你后面所有决策的检查表;再读 p0100 关于提示词作用域的那段,决定你要单 Agent 还是工作流;最后读 p0340,看看一份能被维护的提示词长什么样(分节、编号、指定输出格式和数据落点)。三页加起来不到两千字,但它们决定了你后面 134 屏是「照着抄」还是「照着改」。
第二条,案例只读「规划」,开发过程当手册查。每个案例的规划部分只有 1 到 4 屏,但那才是可迁移的东西:它要解决什么场景、核心功能是哪三条、为什么这么切。比如投标助手,规划两屏(p0263 至 p0264),开发二十屏(p0265 至 p0284)——二十比二,这个比例告诉你哪部分是「这本书的判断」,哪部分是「这个平台的路径」。路径会过期,判断不会。
第三条,自己补三样它没给的。一是评测集:五十条真实问题加标准答案,没有这个你改提示词全靠感觉;二是失败分类:把答错分成「没检索到」「检索到了但没用」「用了但说反了」三类,分别对应改知识库、改提示词、改工作流;三是成本核算:p0480 提到要选「长文本处理能力强的大模型」,但全书没有一页算过 token 花多少钱——而这是你上线第一个月就会撞上的账。
至于给谁:给已经在用扣子、需要一个照着走的脚手架的人,它是合格的;给要选型、要上生产、要判断「这个需求该不该用 Agent 做」的人,它帮不上忙。后一种人需要的不是功能清单,是失败模式清单——而那正好是这本书 500 屏里唯一空着的一栏。
一句话:它把十一个 Agent 从零搭到了能跑,却没在任何一页告诉你,跑不动的时候该看哪儿。
口径说明:章屏数按 pages.jsonl 的 118 个标签对 500 屏全量切分——前置 11、第 1 章 23、第 2 章 22、第 3 章 34、第 4 章 21、第 5 章 94、第 6 章 51、第 7 章 71、第 8 章 41、第 9 章 54、第 10 章 39、第 11 章 39;案例篇(第 7 至 11 章)244 屏 = 48.8%,功能模块两章 145 屏 = 29.0%,认知段 111 屏 = 22.2%;案例内部「规划」27 屏、「开发过程详解」134 屏、「运行效果」36 屏。本篇为重写,首版发布于 2026-11-11(当时记录 734 屏、索引覆盖 287 屏,判为待复核);本轮为完整重抓,全书 500 屏读完 · 笔记与图谱生成于 2026-11-11
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。
发表评论: