
上下文工程不是给更多,是按距离排序
阅读方式:微信读书网页版,从 Preface 翻到第二部分导言,共 291 屏、6 分 44 秒(中英对照,前四章完整)。
结构:第 1 章上下文工程、第 2 章 Claude Code 概要、第 3 章核心命令、第 4 章 MCP 与插件,随后是第二部分的路线预告(自动化、子代理、输出风格、工作流)。
这是我读的第三本讲"上下文工程"的书,前两本是讲原理和多智能体的。这一本不一样:它讲的是一套已经跑在产品里的实现。
Claude Code 不是先有理论再做产品,它是先被几十万人用着,然后有人回头去看它到底是怎么管上下文的。第 1 章提到一个叫 HookHub 的项目,做的就是这件事——研究它如何协调任务、管理上下文,实现超出简单单步交互的功能。
而它给出的答案,跟我预想的不太一样。
一、上下文工程的本质是排序,不是塞满
大多数人理解的"给足上下文",是往对话里加资料。这本书里 Claude Code 的做法恰恰相反:它按"距离"决定权重。
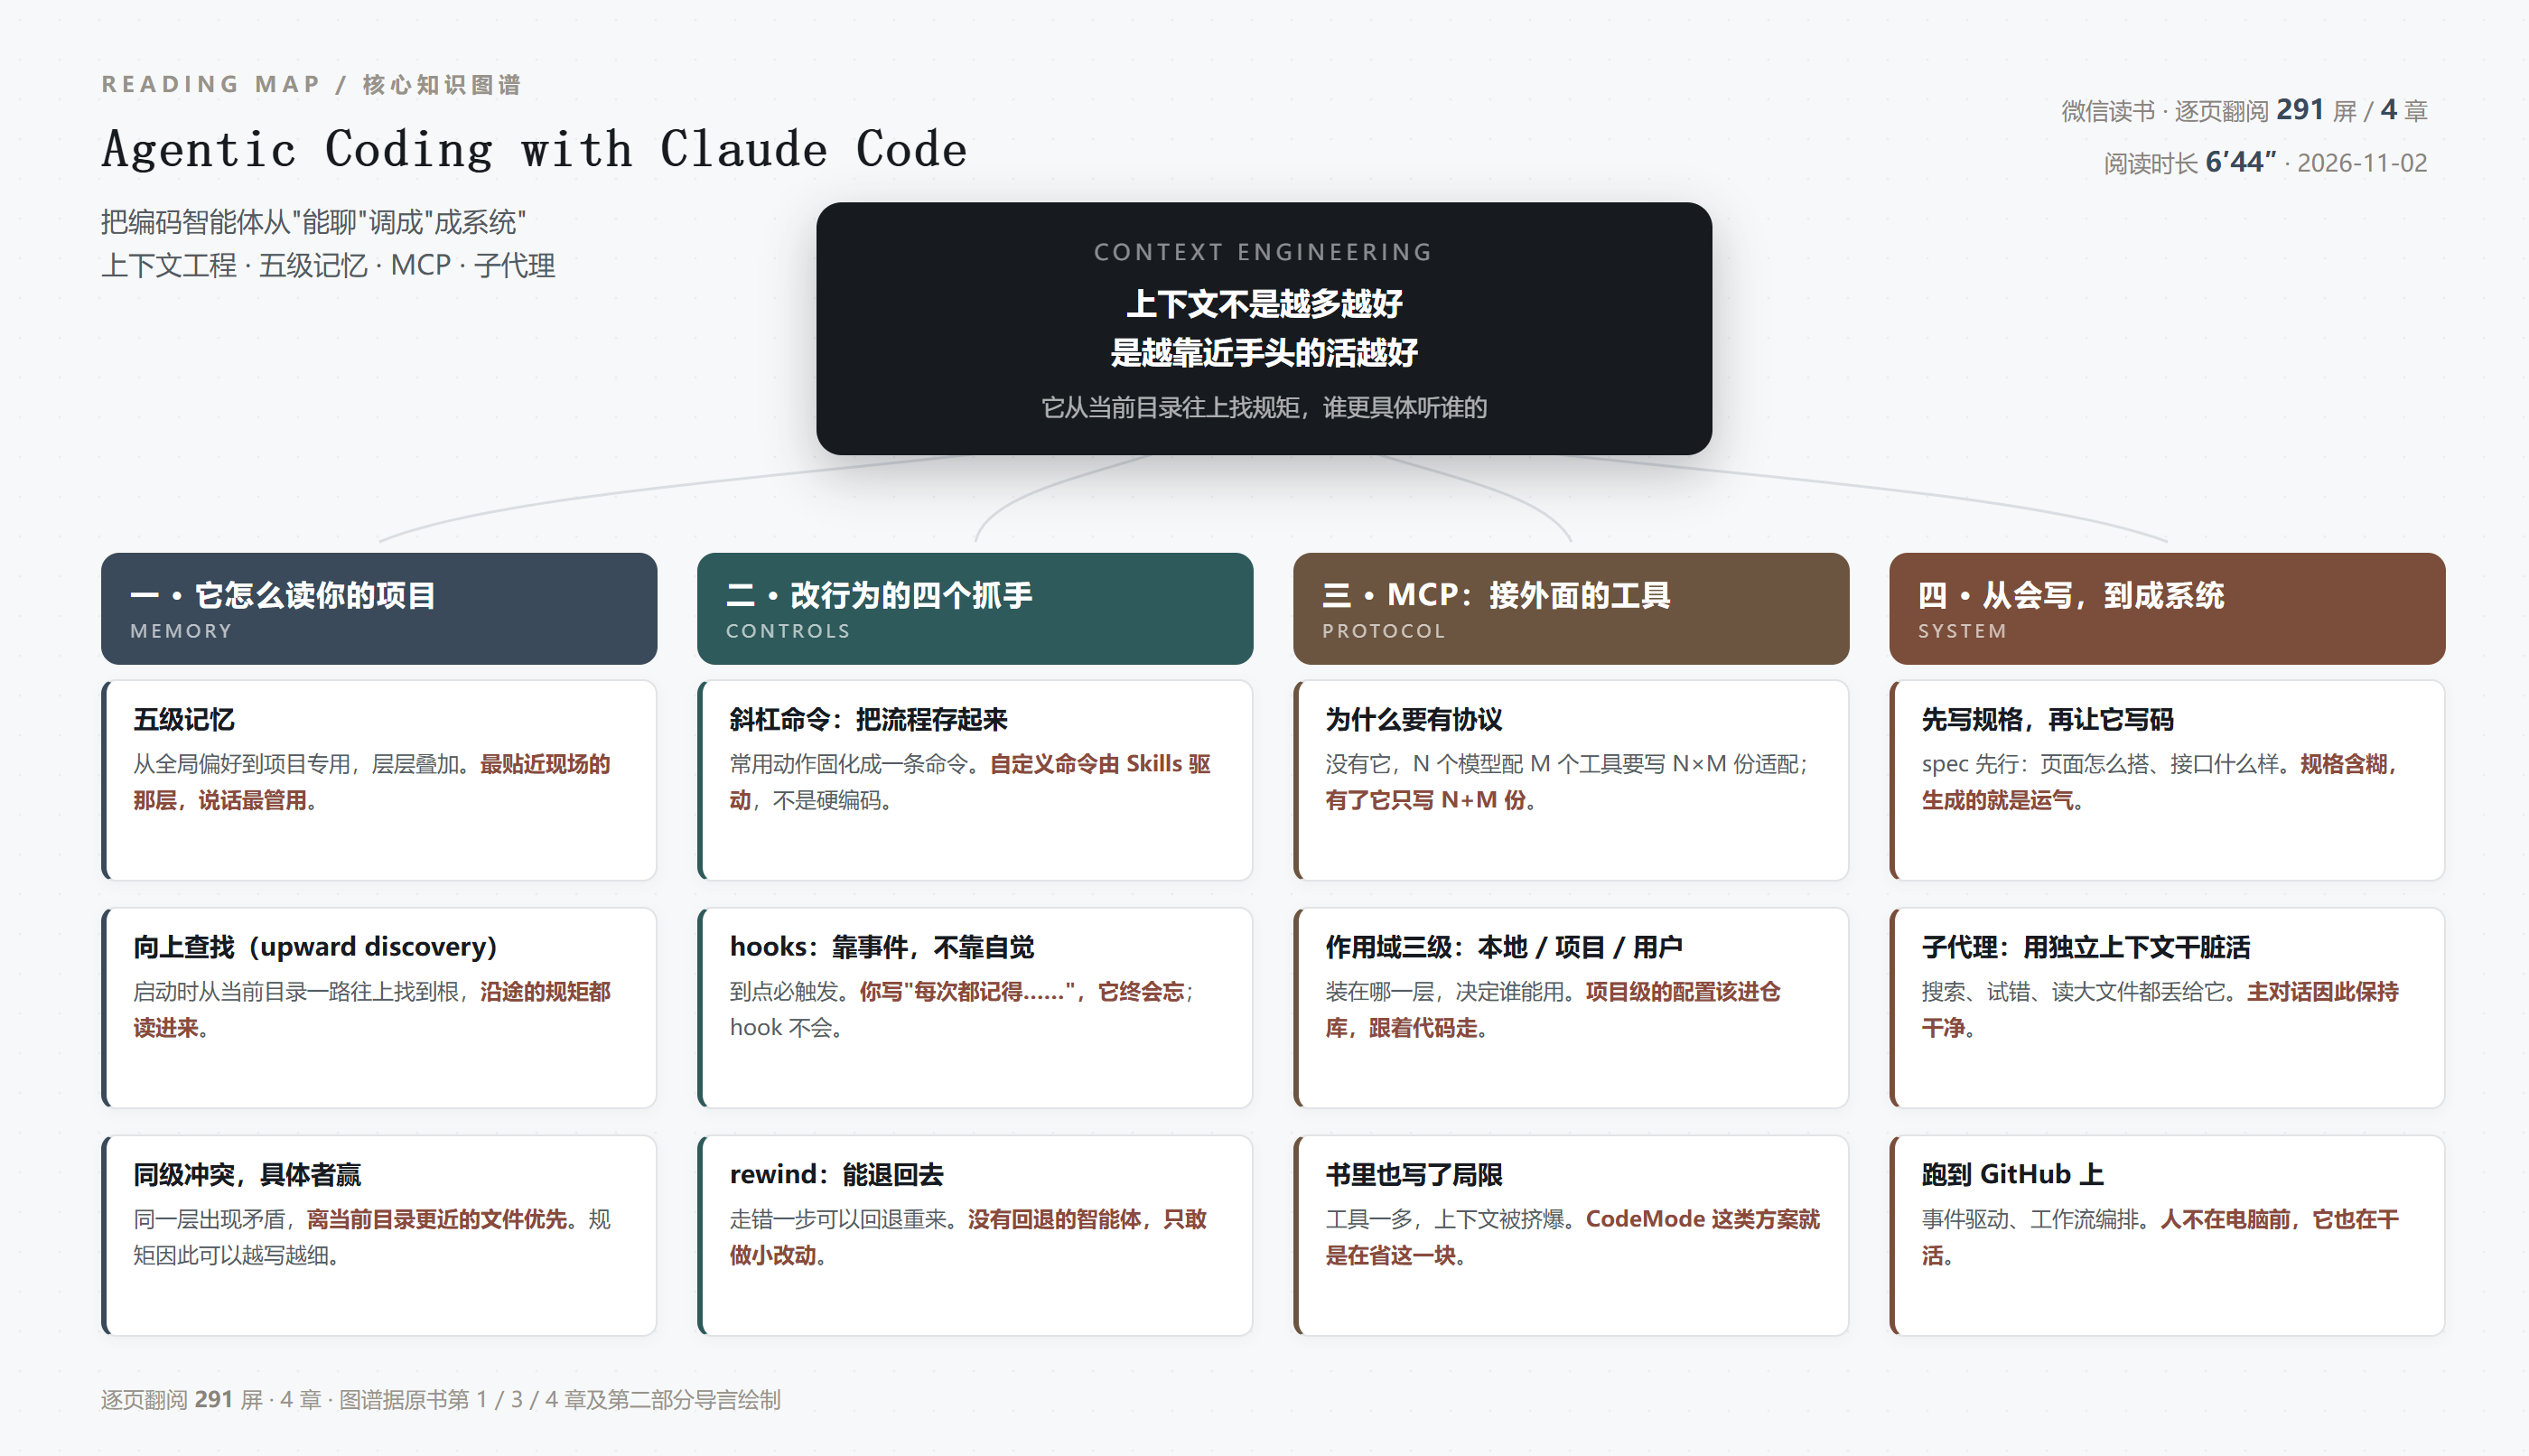
第 3 章讲 memory,给了很具体的一套机制。它有几个层级的记忆文件,我只挑最清楚的两条:
项目专用内存:./CLAUDE.local.md,仅限个人使用,Git 会自动忽略。
向上查找:启动时从当前工作目录开始,逐级向上搜索到文件系统的根目录。
同级冲突:更具体的文件(离当前工作目录更近的)优先被处理。
三条合起来,是一套很朴素的设计:越靠近你手头这摊活的规矩,说话越管用。
这跟"把公司所有规范一次性喂给它"是两个思路。后者的问题不是信息不够,是信息太多,重要的话被淹了。 而按目录距离排序,等于给每条规则标了权重——你在哪个子目录里干活,就自动加载那层最相关的规矩。
我认为这套设计比任何"提示词框架"都值得抄。它回答了一个所有做智能体的人都会撞上的问题:规则越写越多,怎么保证它还记得最重要的那条?
答案是:别让它记,让它按距离找。
二、四个抓手,一个共同点
第 3 章基本是一份命令清单:定价与套餐、斜杠命令、hooks、memory、rewind、自定义斜杠命令、自动生成提交信息的改进。
四个抓手值得单独说,因为它们解决的是四种不同的失败。
斜杠命令——把常用流程存起来。省的是重复输入。
自定义斜杠命令(由 Skills 驱动)——这一句信息量最大。命令是外壳,Skill 才是内容。 也就是说,工具的扩展方式不是"加更多内置命令",而是"让用户写 Skill,命令只是它的入口"。
hooks——到点必触发。这一类解决的是"它老忘"。你在提示词里写"每次改完都要跑测试",它会在第三次忘掉;hook 不会,因为 hook 不是请求,是约束。
rewind——能退回去。这个功能不显眼,但它决定了一件事:你敢不敢让它做大改动。 没有回退的智能体,用户只敢让它改一行——那不是能力问题,是信任问题。
四个抓手放一起看,共同点是:它们都不指望模型"记住",全部做成外部机制。 命令是存下来的流程,Skill 是写下来的知识,hook 是挂上去的钩子,rewind 是留出来的退路。
这本书最实用的一句经验,我认为就是这个:凡是要"每次都做到"的事,都不要写在提示词里。
三、MCP:从 N×M 到 N+M,然后是新的麻烦
第 4 章讲 MCP,逻辑很干脆:为什么要有协议?
没有协议的时候,N 个模型要接 M 个工具,得写 N×M 份适配;有了协议,只需要 N+M 份。这是协议存在的唯一理由,也是它最大的价值。
书里给了 MCP 的核心架构、怎么连、怎么列出和检查已装的服务、作用域怎么选、项目级配置怎么写。作用域那一节叫"cheat sheet",很实用——本地、项目、用户三级,装在项目级的那份该进仓库,跟着代码走,谁拉下来都一致。
但它没停在"真香"。后面单独一节讲 MCP 当前的局限,并提了 Cloudflare 的 CodeMode 作为应对。
局限是什么?工具一多,上下文就被工具描述吃掉了。 你挂了二十个 MCP 服务,每个服务带几个工具,光"这些工具叫什么、参数是什么"就占掉一大块上下文——还没开始干活,预算已经花了一半。
CodeMode 这类思路是把工具调用变成写代码,用一段代码代替一堆工具说明。这跟前面那条"按距离排序"是同一个道理:上下文是预算,不是仓库。
四、从"会用"到"成系统"
第二部分的导言不长,但把路线说清了。原话我抄一句:"As systems grow more complex, structure becomes essential."(系统越复杂,结构就越不可少。)
接着是四件事:
用 MCP 把外部工具和服务接进来
用 GitHub 工作流和事件驱动做自动化
用子代理(subagents)隔离上下文,让执行更安全
用输出风格与配置模式塑造行为、保证一致性
"子代理隔离上下文"这一条,我认为是全书最该被抄走的设计。
什么意思?主对话的上下文很贵,也很脆。搜索代码、读大文件、反复试错,这些"脏活"会迅速把上下文填满,让主对话失去焦点。 做法是把脏活丢给一个独立上下文的子代理,它自己折腾完,只把结论交回来。
换个说法:不是让一个人干所有事,是让一个人只跟几个"助手"说话。 主对话始终干净,判断力就不会被噪声拖垮。
导言最后一句也值得记:目标是设计出"deliberate, controlled, and scalable"(有意图的、可控的、可扩展的)工作流。三个词,正好是"玩具"和"系统"的区别。
五、这本书的短板
一是版本绑得太死。 定价与套餐、命令形式、hook 的配置格式、MCP 的作用域——这些全在快速变化。这本书的保鲜期,我估计不到一年。
二是中英对照反而累。 每段英文下面接一段中文,读起来像在校对而不是在读书,中文翻译也有生硬处(比如把 spec-driven 印成"pec-driven")。
三是操作步骤占比过高。 大量篇幅是命令清单和配置片段,当作手册查很好用,从头读到尾会很闷。
四是正文里混着出版方的营销页。 扫码领 PDF、领代码包这类插页夹在章节中间,读着读着就被打断一次。
它的长处也很突出:它写的是一套真在被用的东西,不是一套应该这样的构想。 前面那些讲上下文工程的书告诉你"上下文有限",这本书告诉你"所以我们按目录距离给它排序"。后者能直接抄,前者只能点头。
六、一句话
上下文工程不是"给更多",是"按距离排序"。你对智能体说的每一句话都在竞争它有限的注意力,所以规矩要写在离活最近的地方,脏活要扔进别的上下文,而"每次都做到"的事,永远别托付给提示词——写成 hook,它会一直记得;写在提示词里,它迟早会忘。
阅读记录:微信读书网页版逐页翻阅,291 屏 / 6 分 44 秒,前 4 章 + 第二部分导言。
本书知识图谱见文中配图,原图地址:https://jiangtian.top/zb_users/upload/kg/agentic-coding-claude-map.png
发表评论: