
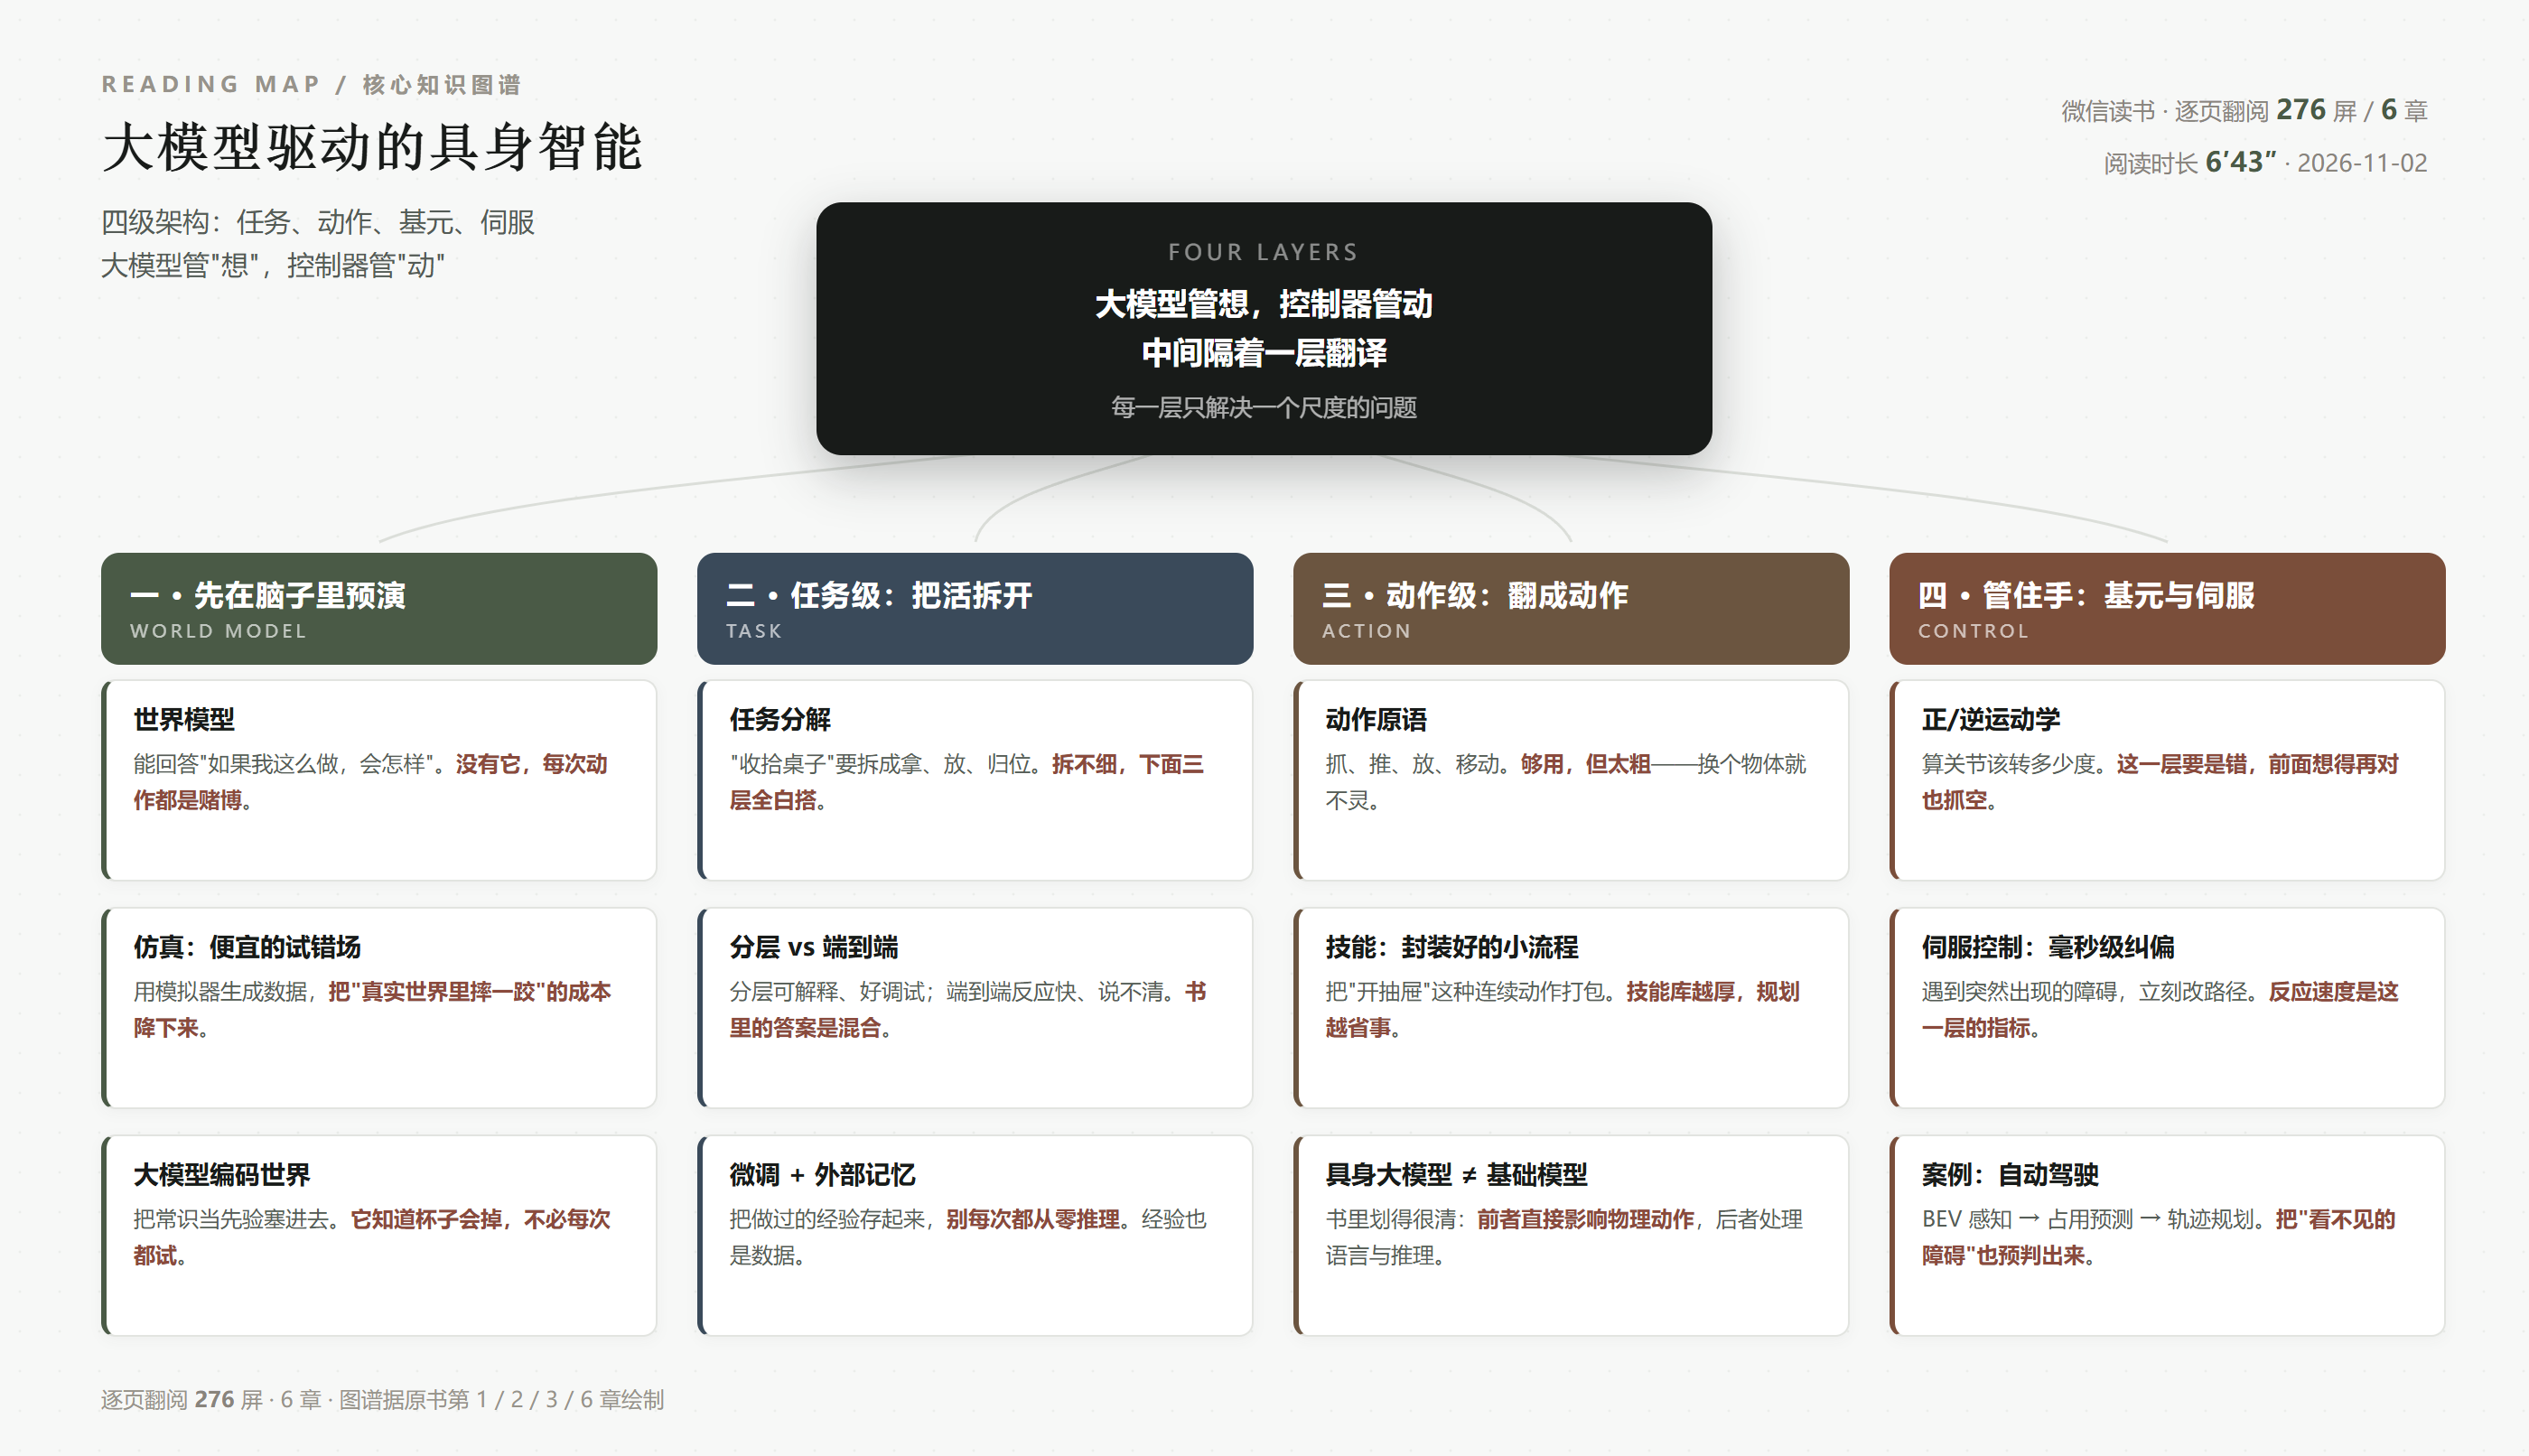
大模型管想,控制器管动,中间隔着一层翻译
阅读方式:微信读书网页版,从第 1 章翻到第 6 章末,共 276 屏、6 分 43 秒。
结构:世界模型 → 机器人系统架构 → 基于大模型的混合控制架构 → 任务级规划 → 分层动作级规划 → 自动驾驶等案例。
这本书解答了一个我一直没想清楚的问题:给机器人接一个大模型,为什么还不够?
按直觉,大模型已经能听懂"把桌上的杯子拿过来",那它指挥机械臂去拿,不就行了。
读完第一章就明白问题在哪:"拿过来"是任务,"伸手、对准、闭合、抬起"是动作,"每个关节转多少度"是控制。 大模型只擅长第一段。
这本书把这三段之间的落差,切成了四级架构。它的价值不在讲大模型,在讲中间那几层翻译。
一、世界模型:先在脑子里预演一遍
第 1 章 1.3 节讲世界模型,两个小节标题就把话说完了:什么是世界模型、世界模型在具身智能中的作用。
它的功能可以用一句话概括:能回答"如果我这么做,接下来会怎样"。
为什么这件事关键?因为物理世界的试错成本极高。你在仿真里让机器人摔一万次都没关系,在真实世界里摔一次可能就是几万块。世界模型提供的正是"不真摔也能学到东西"的能力。
书里接着讲两条实现路线:大模型编码世界、多模态大模型构建世界模拟器。前者是把常识当先验塞进去——它知道杯子会掉、门要向外拉,不必每次都试一遍;后者是让模型直接生成可交互的场景。
还有一个很实在的点:书里说为了解决数据不足,通常用仿真生成数据,这类方法不仅扩展了数据集,还降低了在真实世界中进行试错的成本。
这句话背后是一笔很清楚的账:具身智能的瓶颈不是模型不够大,是"能用来学的动作数据"太少。 互联网上有万亿段文字,但没有万亿次"伸手抓杯子"的记录。所以仿真不是辅助手段,是主要数据来源。
二、三级范式与四级控制
第 2 章讲机器人系统架构,给了三种设计范式:层次范式、反应范式、混合范式。
这三种范式的区别,其实就是"想"和"动"谁说了算:
层次范式——先规划完整条路径,再执行。想得周全,但反应慢。
反应范式——不规划,见什么躲什么。反应快,但走不出复杂任务。
混合范式——高层规划、低层反应。书里的答案是它。
而"混合"具体怎么混,第 3 章给出了很干净的四级:
任务级——大模型做规划,拆步骤
动作级——把步骤翻成动作序列(具身大模型在这一层)
基元级——正/逆运动学,算关节角
伺服级——毫秒级闭环纠偏
这里有一个我认为全书最该被记住的区分。书里明确说:基础模型能处理多种复杂任务,应用范围广;而具身大模型不同,它主要应用于动作级规划,直接影响机器人或系统的物理动作。
换句话说:能聊天的模型和能动手的模型,不是一个东西。 前者输出文字,后者输出动作——输出的东西不一样,训练数据、评价标准、失败代价全都不一样。
这也解释了为什么"接个大模型"不管用:它输出的是"应该先抓杯柄",而机械臂要的是七个关节的角度序列。中间那段翻译,没有现成的模型能干,得专门造。
三、任务级:难在拆得够细
第 4 章讲任务级规划,第一件事是任务分解。
"收拾桌子"要拆成:走到桌前、识别物体、抓取、移动到指定位置、松手、返回。拆不细,下面三层全白搭。
这一章还讲了两件很有意思的事。
一是分层与端到端的取舍。 书里两边都讲了,没有一边倒。端到端的优点是省掉中间环节、反应快;分层的好处是每一步都可解释、坏了能定位。而它最终落在"混合"上——高层分层,低层端到端。
这个取舍其实很务实:高层错了可以查,低层错了只能重训。 所以把可解释性留给高层,把速度留给低层。
二是微调与外部记忆。 4.3 节讲"具身经验的获取",接着讲怎么把经验存下来。这个思路跟人一样:做过的事别每次都从零推理,存成记忆,下次直接取。
四、动作级:原语不够用
第 5 章讲分层动作级规划,开头就把工具的局限摊开了:动作原语及其局限性。
动作原语是什么?抓、推、放、移动。它们够用,但太粗。 书里紧接着给了解法:技能——把"开抽屉"这种连续动作打包成一个可复用的单元。
但技能也有局限:换个物体、换个场景就不灵了。 所以后面才有"基于技能的单步动作级规划",还有低成本方案(书里提了 GPTR 的工作流程)。
这一段的逻辑我读得很顺,因为它和软件工程里的事一模一样:函数太原子,写起来啰嗦;封装成模块好用,但复用性有边界;最后总要在"细"和"通用"之间找平衡。
第 6 章的案例讲自动驾驶,把四级架构落到了具体系统上。流程是:多视角图像 → 鸟瞰图(BEV) → 语义分割(道路、行人、车道线)→ 占用预测(每个网格未来会不会被占)→ 轨迹规划。
书里有一段我印象很深,讲它怎么处理遮挡:系统不仅能识别可见物体,还能预测那些由于遮挡而不可见的潜在障碍物,为安全导航提供支持。
这正是世界模型的用处——不是看见才躲,是预判那里可能有东西。
五、这本书的短板
一是偏架构综述,工程细节少。 四级架构讲得清楚,但"具体怎么实现"多数停在第 2 章那种"选 A 还是 B"的层面,缺少可复现的实验配置。
二是术语与公式密度高。 正逆运动学、自由度、执行器、控制网络……没有机器人背景的读者,会在第 3 章后半段开始吃力。
三是案例集中在一个方向。 自动驾驶讲得细,人形机器人、机械臂的实操案例偏少,而后者才是"具身智能"最受关注的部分。
四是有些章节像论文综述。 引用密集、观点并列,读起来知道"有这些做法",但不知道"该选哪个"。
它的长处是结构:四级架构这个切法,本身就是一个可复用的思考工具。 拿到任何一个"AI 要控制物理世界"的场景(机器人、车、无人机、产线设备),都可以先问:你这套系统,任务级在哪、动作级在哪、基元级在哪、伺服级在哪?哪一层是空的?
六、一句话
大模型让机器人"听得懂人话",但要让它"拿得稳一个杯子",靠的还是那套几十年的控制理论。真正的难点不在两头,在中间那层翻译——把一句人话,翻成一串关节角。这层翻得好不好,决定了机器人是"会表演"还是"能干活"。而所有"AI 落地"的行业,缺的往往都是这一层。
阅读记录:微信读书网页版逐页翻阅,276 屏 / 6 分 43 秒,6 章。
本书知识图谱见文中配图,原图地址:https://jiangtian.top/zb_users/upload/kg/embodied-ai-arch-map.png
发表评论: