
它不是在写文章,是在猜下一个字
微信读书《大模型是怎样跑起来的(轻科技)》· 张其来
逐页翻阅 31 屏 · 读至 "全书完" · 会员卡可读的付费书 · 2026-11-03
这本书只有 31 屏。翻到最后一页时,页面弹出"全书完"和"标记读完"按钮,下面还有推荐值 79.8%、337 人点评的评分区——是一本读完的小册子,不是试读。
顺带交代一句:我自己的抓取脚本最初把它判成了"付费墙试读"而跳过,理由荒唐得很——"少于 60 屏"。屏数少不等于没读完,短篇本来就短。这个判据我已经改成"是否读到书尾标志"了。
它的好处是不装。开篇就把大模型从"神秘"拉回"机械":
更接近事实的说法是——它会根据已经看到的文字,计算下一个最可能出现的片段。算出一个,就把这个片段接到前文后面,再继续计算下一个。这个过程重复得足够快,最后我们看到的就是一段完整回答。
紧接着一个更狠的比喻:
大模型并不是从某个抽屉里取出一篇现成文章,也不是像人一样先形成完整想法,再一句句表达出来。它更像是在进行一场高速文字接龙:看前文,猜后文;猜出一个,再接着猜下一个。
然后它把整本书切成两个问题,一条软件线、一条硬件线:
软件层面:我们输入的是自然语言,它怎样一步步变成模型能处理的数字,又怎样从数字变回文字?
硬件层面:这些计算为什么这么庞大,又为什么能在几秒钟内完成?
全书就沿着这两条线走,31 屏,没有一句废话。
一、字怎么变成数
三步,写得非常干脆。
切分。一句话可能被切成"中/国/首/都/是",也可能是"中国/首都/是"。不同模型切法不一样,"但目标相同,把自然语言拆成模型能处理的基本片段"。
编号。模型内部有一本词表,每个 Token 对应一个编号。到这里,文字已经变成了一串整数。
但作者马上补了一句要命的提醒:
但整数本身没有多少意义。编号 1234 和编号 5678,只能说明它们在词表里的位置不同,并不能说明它们的语义关系。
变向量。所以有了第三步——把编号展开成一组数字,放进一个很大的语义空间里。"语义相近的 Token,在这个空间里的位置往往更接近;语义差得远的 Token,位置也更远。"
这一步是全书的转折点。前两步都只是"编码",到向量这里,机器才第一次拥有了"意思"这个概念——虽然只是一种几何意义上的意思:它不知道"苹果"是水果,它只知道"苹果"离"香蕉"比离"汽车"近。
二、怎么猜下一个字
书里用一张手绘图把这件事钉住了:横轴是候选字,纵轴是概率。以"中国首都是___"为例,北 68%、上 17%、东 9%、京 6%。
旁边配了个旋钮,标着"温度",一头写"稳",一头写"活"。
是在选择下一个 Token 时,允许了一定程度的不确定性。
这个旋钮解释了很多日常困惑:为什么同一个问题问两遍,答案措辞会变;为什么把温度调到最低,输出就变得死板重复。它不是"知道"答案,它是把倾向摊开成一张概率表,再从里面抽一个。
那这张概率表凭什么准?靠注意力。作者举的例子很朴素——"中国首都是"这句话里,要判断"是"后面该接什么,就得回头看"中国"和"首都"。模型让当前的 Token 去吸收这些重要上下文,"让它不再是一个孤立的『是』,而是一个带着『中国首都』语境的『是』"。
注意力机制也是这样,不是所有上下文都同样重要,模型会给不同 Token 分配不同的参考权重。
这一句值得单独记下来。它解释了为什么提示词里"把最重要的要求放前面/放明确"是有用的——权重不是平摊的,注意力会挑。
三、凭什么算得动
硬件那半本,最漂亮的一张图是"动作一致,数据不同"——五个小人站在桌前,每人算一道乘法(3×5、7×2、4×9、6×8、9×1)。动作完全一样,只是数字不同。
这就是并行的全部秘密。GPU 不是比 CPU 更"聪明",它只是把同一种运算铺开成千上万份同时做。
再往里一层是 Tensor Core:
它不是一个个数慢慢算,而是可以一次处理一小块矩阵,把很多乘加操作打包完成。
而大模型最重的计算恰好全是矩阵乘法——注意力要算矩阵、参数层要算矩阵、最后生成词表分数还要算矩阵。所以这个"专门车间"才成了刚需。
这一节读下来,会得到一个反直觉的结论:大模型的"智能"在软件层,但它的"可行"在硬件层。如果矩阵乘法没有专用硬件,今天这些模型一个都跑不起来——不是慢一点,是慢到不可用。
四、为什么第一个字慢,后面就快了
这是我读这本书收获最大的一段。它解释了一个每个人都遇到过、却很少有人追问的现象:按下回车后,屏幕上先空着,然后字才一个个往外冒。
你按下回车后,第一个字迟迟不出现,通常是因为模型正在 Prefill。它要先读完你的输入,把上下文处理好。
第一个字出现后,后面开始一个字一个字往外冒,这是 Decode。每一步都要读取历史缓存,计算下一个 Token,再输出。
更关键的是它对瓶颈的判断:
Decode 阶段的计算量不一定最大,但它很依赖数据搬运。尤其是上下文很长时,每一步都要从显存里取出大量历史信息。此时,瓶颈可能不是算不过来,而是搬数据太忙。
前面还有一句更凝练的:
不是模型不想记住,而是记住需要空间,回看需要带宽。
这两句话,把"为什么长上下文那么贵"从玄学变成了工程账:你多给的那几万 token,不是多占了一点存储,而是每生成一个字都要重新搬一遍。对话越长越慢,原因往往不在算力,在搬运。
这也顺手解释了两件事:为什么"先把长文档压缩成摘要再喂"经常比"直接全文塞进去"更好;为什么同样的模型,换个上下文长度,体感速度差好几倍。
五、最后,它敢说不确定
结尾回到开篇的问题:大模型真的会思考吗?作者的回答两头都不讨好,但很诚实:
如果把思考理解成人类大脑里的主观体验,那大模型并没有这样的体验。它没有意识,也没有自己的目的。它不会像人一样先在心里产生一个念头,再把念头说出来。
但如果从外部表现看,它又确实能完成很多看似需要思考的任务。
这并不矛盾。大模型的能力,来自训练中形成的语言规律,也来自巨大参数空间里的复杂组合。
然后给了三条可操作的判断标准:问题足够常见、语言规律足够稳定,回答就显得可靠;需要最新信息、严格事实、精确计算,或涉及复杂现实判断,就可能出错;提示写得清楚、背景给得充分,表现往往更好。
书里那幅图的标题我很喜欢——"更实用的问题:它的依据是什么?靠不靠谱?要不要验证?"
与其争论机器会不会思考,不如每次都问这三个问题。前者没有答案,后者每次都有答案。这大概就是这本书真正想留下的东西:不是知识,是一个提问的习惯。
六、它在这个书架里的位置
如果说这一轮读的多数书都在教你"怎么用"——搭智能体、写提示词、选框架、做 RAG——这本是往回退一步,告诉你底下那台机器到底在干什么。
它更像一张地图而不是一本手册。读完你不会因此会调参、会部署、会选型,但你会有一套稳定的心智模型:那些让你觉得神奇的瞬间,其实是一串概率、一次并行、一趟数据搬运。
而"知道底下在发生什么",恰恰是判断力的来源。遇到模型胡说,你不会只说"它笨",你会想到这是概率分布里被抽中的低概率分支;遇到长文档变慢,你不会只怪网络,你会想到 Prefill 和搬运。
七、短板也说清楚
31 屏,注定讲不深。它没有反向传播的数学,没有具体架构参数,没有一行代码,也没有讲清楚"训练"到底怎么把随机权重变成有用的权重——这一块它只用"训练中形成的语言规律"一句带过。
所以它适合两类人:完全不懂但想懂的入门者,以及用了很久却一直"黑箱操作"的实践者。对前者它足够友好,对后者它能把散落的使用直觉串成一条线。
如果你已经能徒手推导 attention,这本可以跳过;如果你每天在用大模型、却说不清它为什么这样回答,那这 31 屏性价比极高。
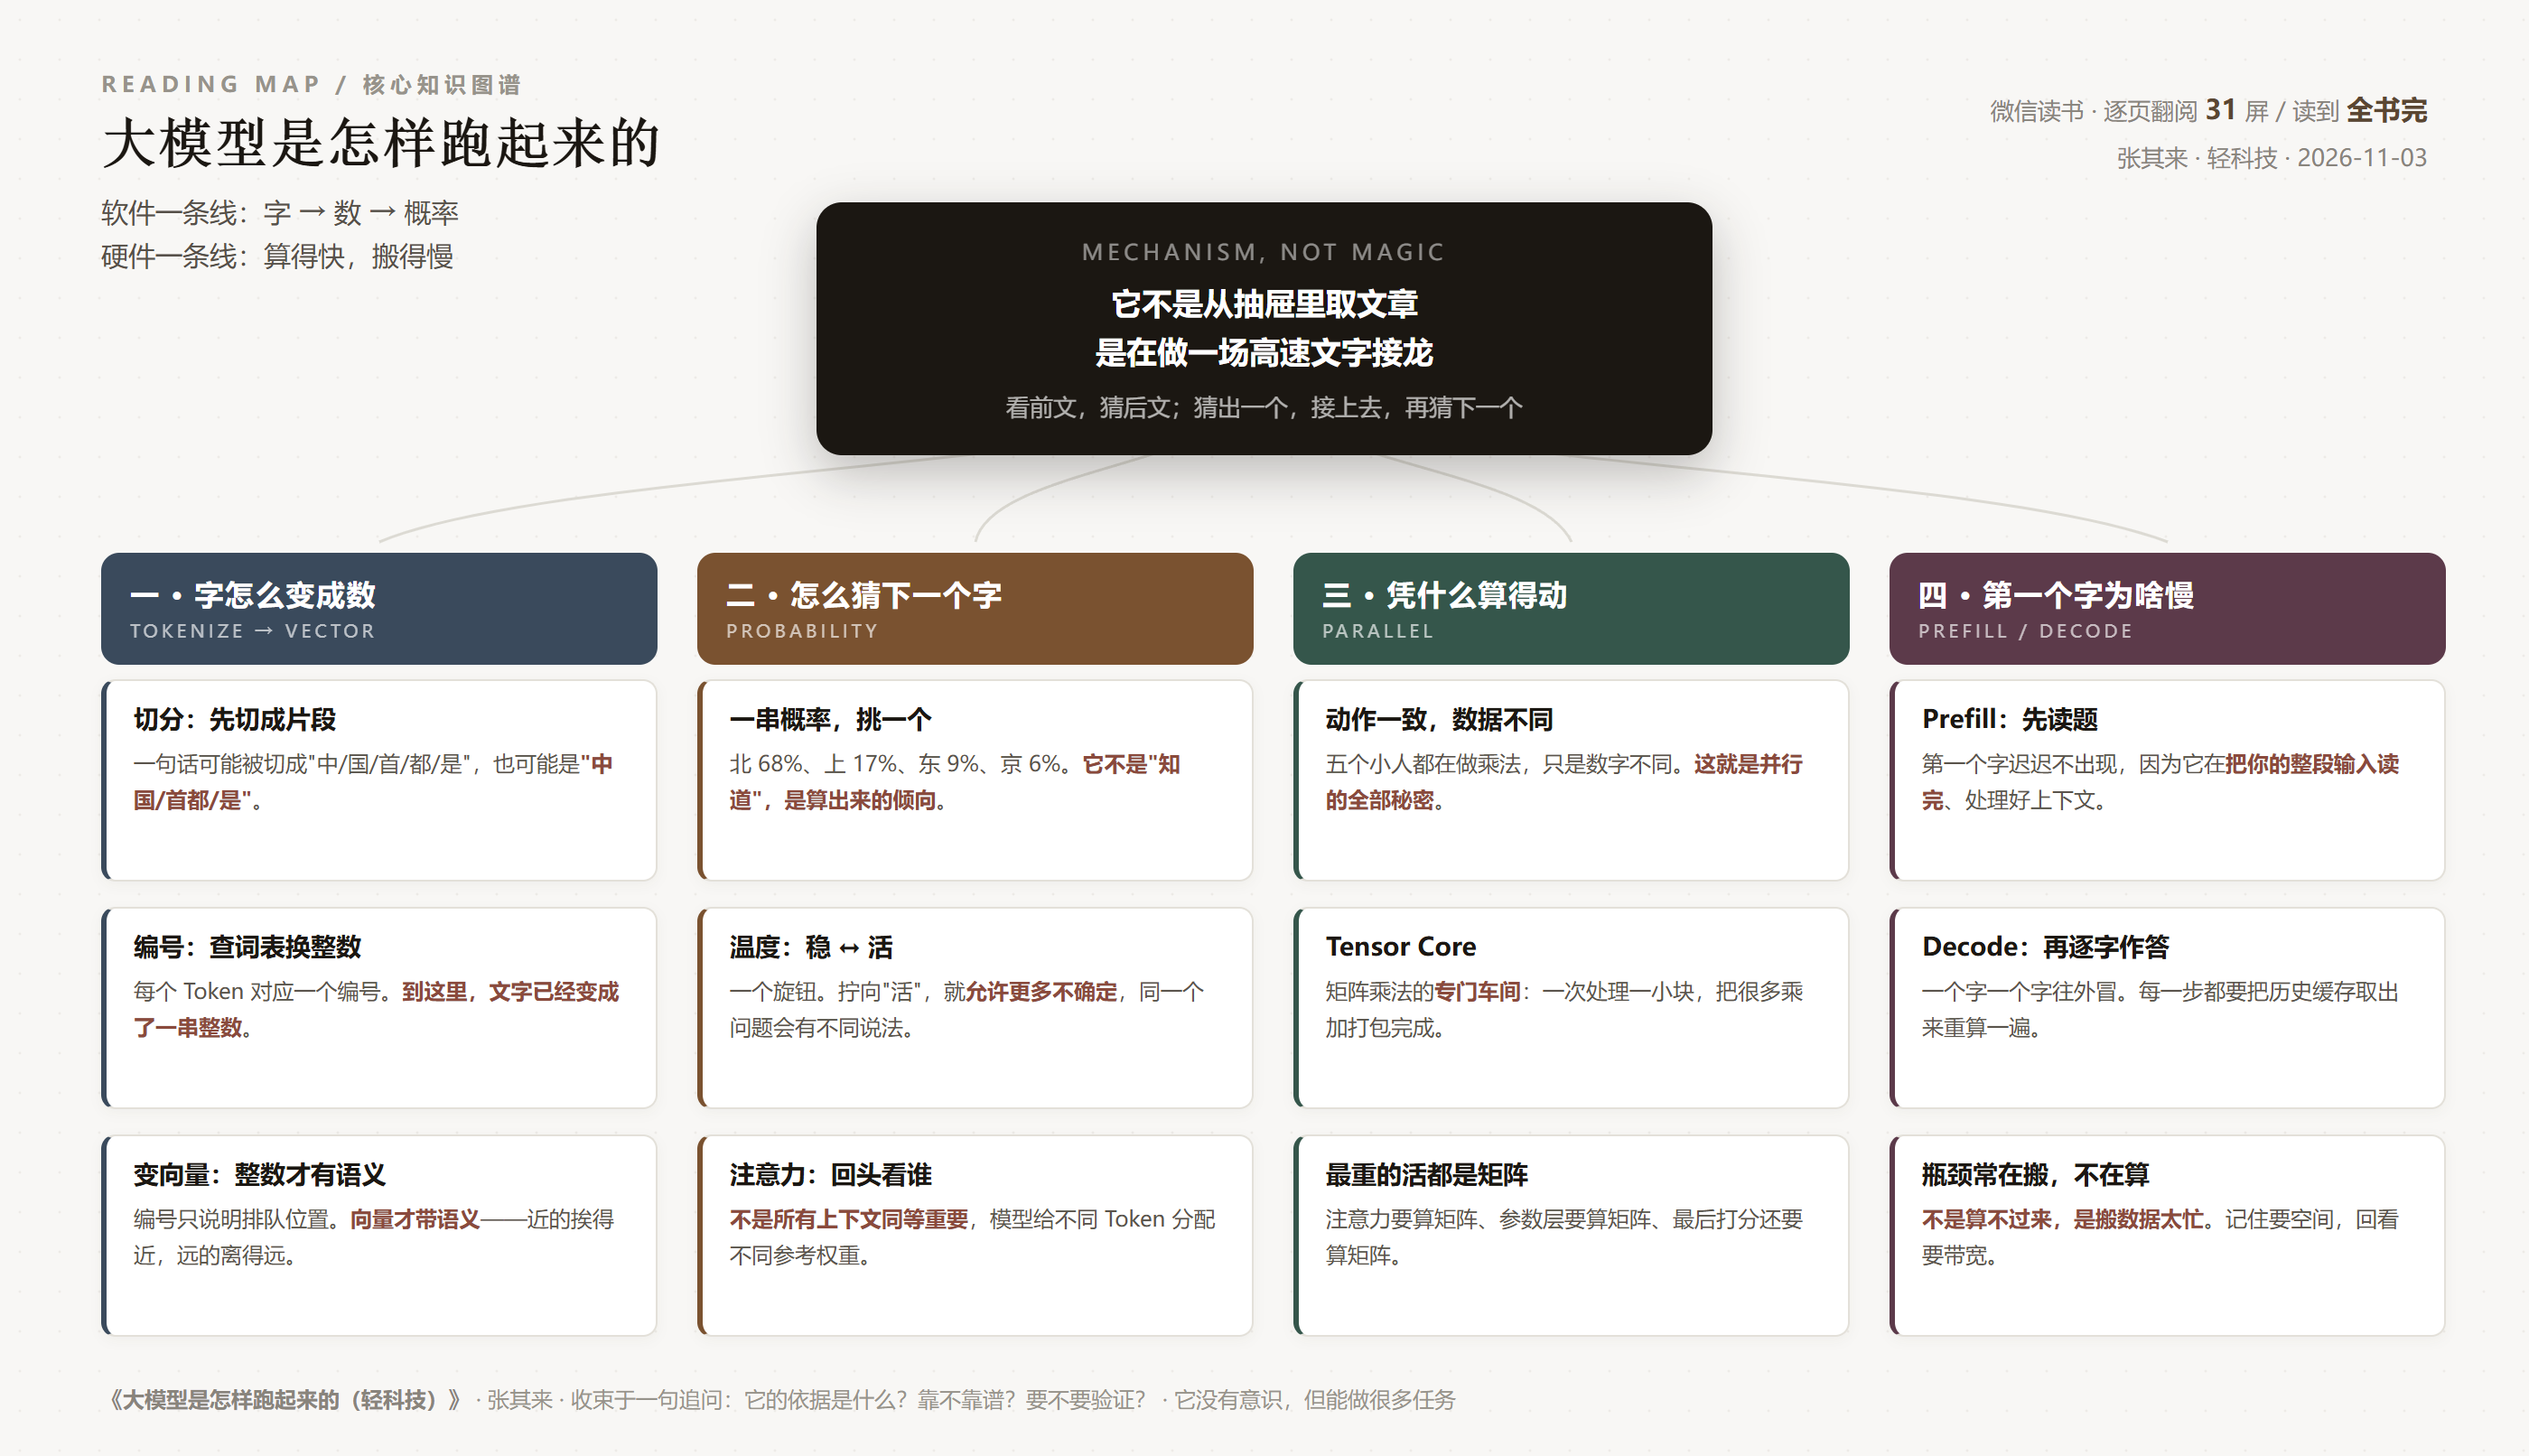
阅读记录:微信读书《大模型是怎样跑起来的(轻科技)》(张其来),逐页翻阅 31 屏,读至"全书完",会员卡可读的付费书。核对依据:末屏出现"全书完 / 标记读完"与评分区。2026-11-03。
发表评论: