
把黑盒拆成可以自己拧的螺丝
微信读书《Happy-LLM:从零开始构建大模型》· 朱信忠 宋志学 等
逐页翻阅 278 屏 · 6 章 · 读到第 6 章训练实践 · 2026-11-03
刚读完一本讲"大模型怎么跑"的科普小册子,紧接着读这本,衔接得刚好——上一本告诉你那台机器在干什么,这本告诉你那台机器可以自己造一台。
书的定位很明确:不讲应用、不教调 API、不堆术语。它沿着一条路往下走,从"词怎么变成向量"一直走到"用 DeepSpeed 训一个自己的小模型"。六个章节,一层扣一层,中间没有跳步。
一、先修一条来路
第 1 章不讲大模型,讲 NLP 的旧账:分词、词性标注、文本分类、实体识别、关系抽取、文本摘要、机器翻译、自动问答。八个小节,一个任务两页,节奏很快。
然后落到"文本表示的发展历程",四步:词向量 → 语言模型 → Word2Vec → ELMo。
这四步的意义在于:它解释了为什么 Transformer 是必然出现的。
Word2Vec 时代,一个词只有一个向量——"苹果"在"我吃了一个苹果"和"苹果发布了新手机"里是同一个向量。这显然不对。ELMo 开始让向量随上下文变,但用的还是循环结构,跑不快。
于是 2017 年那个转折来了:用注意力取代循环。不是为了效果更好,而是为了能并行——不能并行,就养不起大模型。这一点书里没有大张旗鼓地强调,但它是整本书的暗线。
二、把注意力讲成"查字典"
这是我在这本书里最喜欢的一段。注意力机制被讲烂了,公式谁都会抄,但很少有人说清"Q、K、V 到底是什么关系"。这本书用了一个类比,一句话就通了:
此时,字典的键就是注意力机制中的 Key,而字典的值就是注意力机制中的 Value。字典支持我们进行精确的字符串匹配。例如,如果想要查找的值(也就是 Query)为"apple",则可以直接通过对 Query 与 Key 进行匹配来得到对应的 Value。
但真实语言不是精确查表。所以书里往前推了一步:
但是,如果我们想要匹配的 Query 包含多个 Key 呢?例如,假设我们想要查找"fruit",此时我们应该对 apple 和 banana 进行匹配,但不能匹配到 chair。因此,我们往往会选择对 Key 所对应的 Value 进行组合,从而得到最终的 Value。
然后给了一组具体的权重和算式:
{"apple": 0.6, "banana": 0.4, "chair": 0}
Value = 0.6×10 + 0.4×5 + 0×2 = 8
给不同 Key 所赋予的不同权重,就是我们所说的注意力分数,也就是为了查询到 Query,我们应该赋予每一个 Key 多少注意力。
看到这里我才真正明白"注意力"这三个字不是比喻,是字面意思的加权平均。所谓"模型在关注什么",就是它给每个 Key 打了多少分;所谓"多头的意义",就是同时用几套不同的打分标准去查同一本字典。
书里接着往下拆:自注意力(自己查自己)、掩码自注意力(不许偷看后面)、多头注意力(几套标准并行)。三个概念串成一条线,不再需要死记。
三、搭模型之前,先认识零件
第 2 章后半段讲编码器-解码器架构,但真正有价值的是它顺手把几个"到处都在用、却很少有人解释"的零件讲清了:
层归一化——把每一层的输出拉回稳定范围,否则深了以后数值会炸。
残差连接——让梯度有一条捷径回去,否则深了以后根本训不动。
位置编码——注意力本身没有顺序概念,得把"第几个字"这个信息额外塞进去。
这三个零件凑齐,加上嵌入层,才有一个完整的 Transformer。第 2.3 节直接把整个模型搭了一遍,代码不长,但是从零到能跑的那种完整。
四、三种骨架,一道选择题
第 3 章把预训练语言模型分成三类,这个分法比很多资料都清楚:
仅编码器(BERT 系):双向看全句,擅长"读懂",不擅长"写出"。分类、抽取、检索是主场。RoBERTa 改了训练策略,ALBERT 砍了参数量。
编码器-解码器(T5):先读完整段,再整段输出。翻译、摘要这类"整进整出"的任务最合身。
仅解码器(GPT / LLaMA / GLM):一个字接一个字往后写。今天所有主流大模型都走这条路——不是因为它理论上最优,而是因为它最适合"一个模型干所有事"。
这个选择背后的逻辑值得记住:架构不是选最强的,是选最通用的。仅解码器把一切任务都改写成"接着往下写",于是只需要一种训练方式、一种推理方式、一套工程栈。
五、三阶段:预训练、SFT、RLHF
第 4 章把训练流程切成三段,讲得克制但准确。其中最扎心的是 SFT 那一节:
高质量的指令数据集获取难度较大。不同于预训练使用的无监督语料,SFT 使用的指令数据集是有监督语料,除去需要设计广泛、合理的指令,还需要对指令回复进行人工标注,并保证标注的高质量。事实上,ChatGPT 的成功很大一部分原因在于其高质量的人工标注数据。
然后补了一句更现实的话:人工标注成本极高,罕有企业开源。所以有了用 GPT-4 生成指令数据的路子——Alpaca 就是这么来的:一些种子 Prompt,让强模型生成更多指令和回复。
书里给了 SFT 数据的三个键,简单到有点意外:
{"instruction": "输入的用户指令", "input": "执行该用户指令可能需要补充的输入,没有则置空", "output": "模型应该给出的回复"}
就这么三个字段。所有"让模型学会听话"的努力,最后都落在这三个字段的质量上。这也解释了为什么很多人微调效果不好——不是 LoRA 参数调错了,是那几千条 instruction 写得太水。
六、第 5 章:真的动手搭一个 LLaMA2
这是全书最硬的一章,也是它区别于其他"原理书"的地方——不是讲 LLaMA2 长什么样,是逐行把它写出来。
顺序很清楚:定义超参数 → RMSNorm → Attention 模块 → MLP 模块 → 解码器层 → 完整模型。
代码里有几个细节值得单独拎出来:
- Flash Attention 是可选加速。书里的实现会先检测环境:
hasattr(torch.nn.functional, 'scaled_dot_product_attention'),不支持就退回手写注意力,并打一行警告 "using slow attention. Flash Attention requires PyTorch >= 2.0"。这种"能快就快、不能快也能跑"的写法,比只给最优解的教程实用得多。 - 因果掩码是一个上三角矩阵。用
torch.triu(mask, diagonal=1)造出来,填-inf,再register_buffer注册成缓冲区——这样它跟着模型走 GPU,但不参与梯度。 - GQA 体现在 head 数量上。Q 用
n_local_heads,K/V 用n_local_kv_heads,两者不等,这就是分组查询注意力的实现方式——省显存的关键。
第 5 章还有两节容易被跳过但很关键:训练分词器(字符级、子词级,自己训一个)和预训练一个小型 LLM(下载数据、训练分词器、建数据集、预训练、SFT、生成文本)。
整条链路走完一遍,你对"大模型"的理解会从"一个黑盒 API"变成"一堆可以自己拧的螺丝"。
七、第 6 章:从能跑到跑得动
最后一章换了个视角:单卡能跑 ≠ 工程可用。三个台阶——
Transformers 框架:初始化模型、处理预训练数据、用 Trainer 类训练。这是"标准做法"。
DeepSpeed:分布式训练,把模型切开放到多卡上。这是"规模做法"。
LoRA 与 peft:只训一小块低秩增量,把微调成本打下来。这是"省钱做法"。
LoRA 那节的原理讲得干脆:冻结原权重,旁路挂两个小矩阵 A 和 B,让它们的乘积去逼近权重的改变量。可训练参数量从原来的 d×d 降到 d×r + r×d,r 通常取 8 或 16。改动量被压成低秩,而低秩足以表达"风格和知识"这类偏移。
八、它的短板
说几句实话。
它不适合纯小白。第 2 章的公式密度不低,第 5 章的代码需要能读 PyTorch。如果你连 tensor 的 shape 都没感觉,前半本会卡住。
它也不是查阅手册。书的叙事是线性的,一层接一层,跳读会断。想查某个具体 API,不如直接看文档。
训练部分偏向"跑通"而非"跑好"。它给了 DeepSpeed 和 peft 的用法,但没深入讲数据配比、学习率调度、loss 曲线的诊断。真要训一个可用的模型,这些才是决定成败的地方。
但它做到了另一件更难的事:把"大模型"这件被包装得过度神秘的事,还原成一串可以执行的行。读完你不会因此成为算法工程师,但你会知道每一层在算什么、每一行代码在改什么、以及为什么有些设计非如此不可。
对于一个每天在用大模型的人来说,这种"知道底下有什么"的感觉,比多会几个提示词技巧值钱得多。
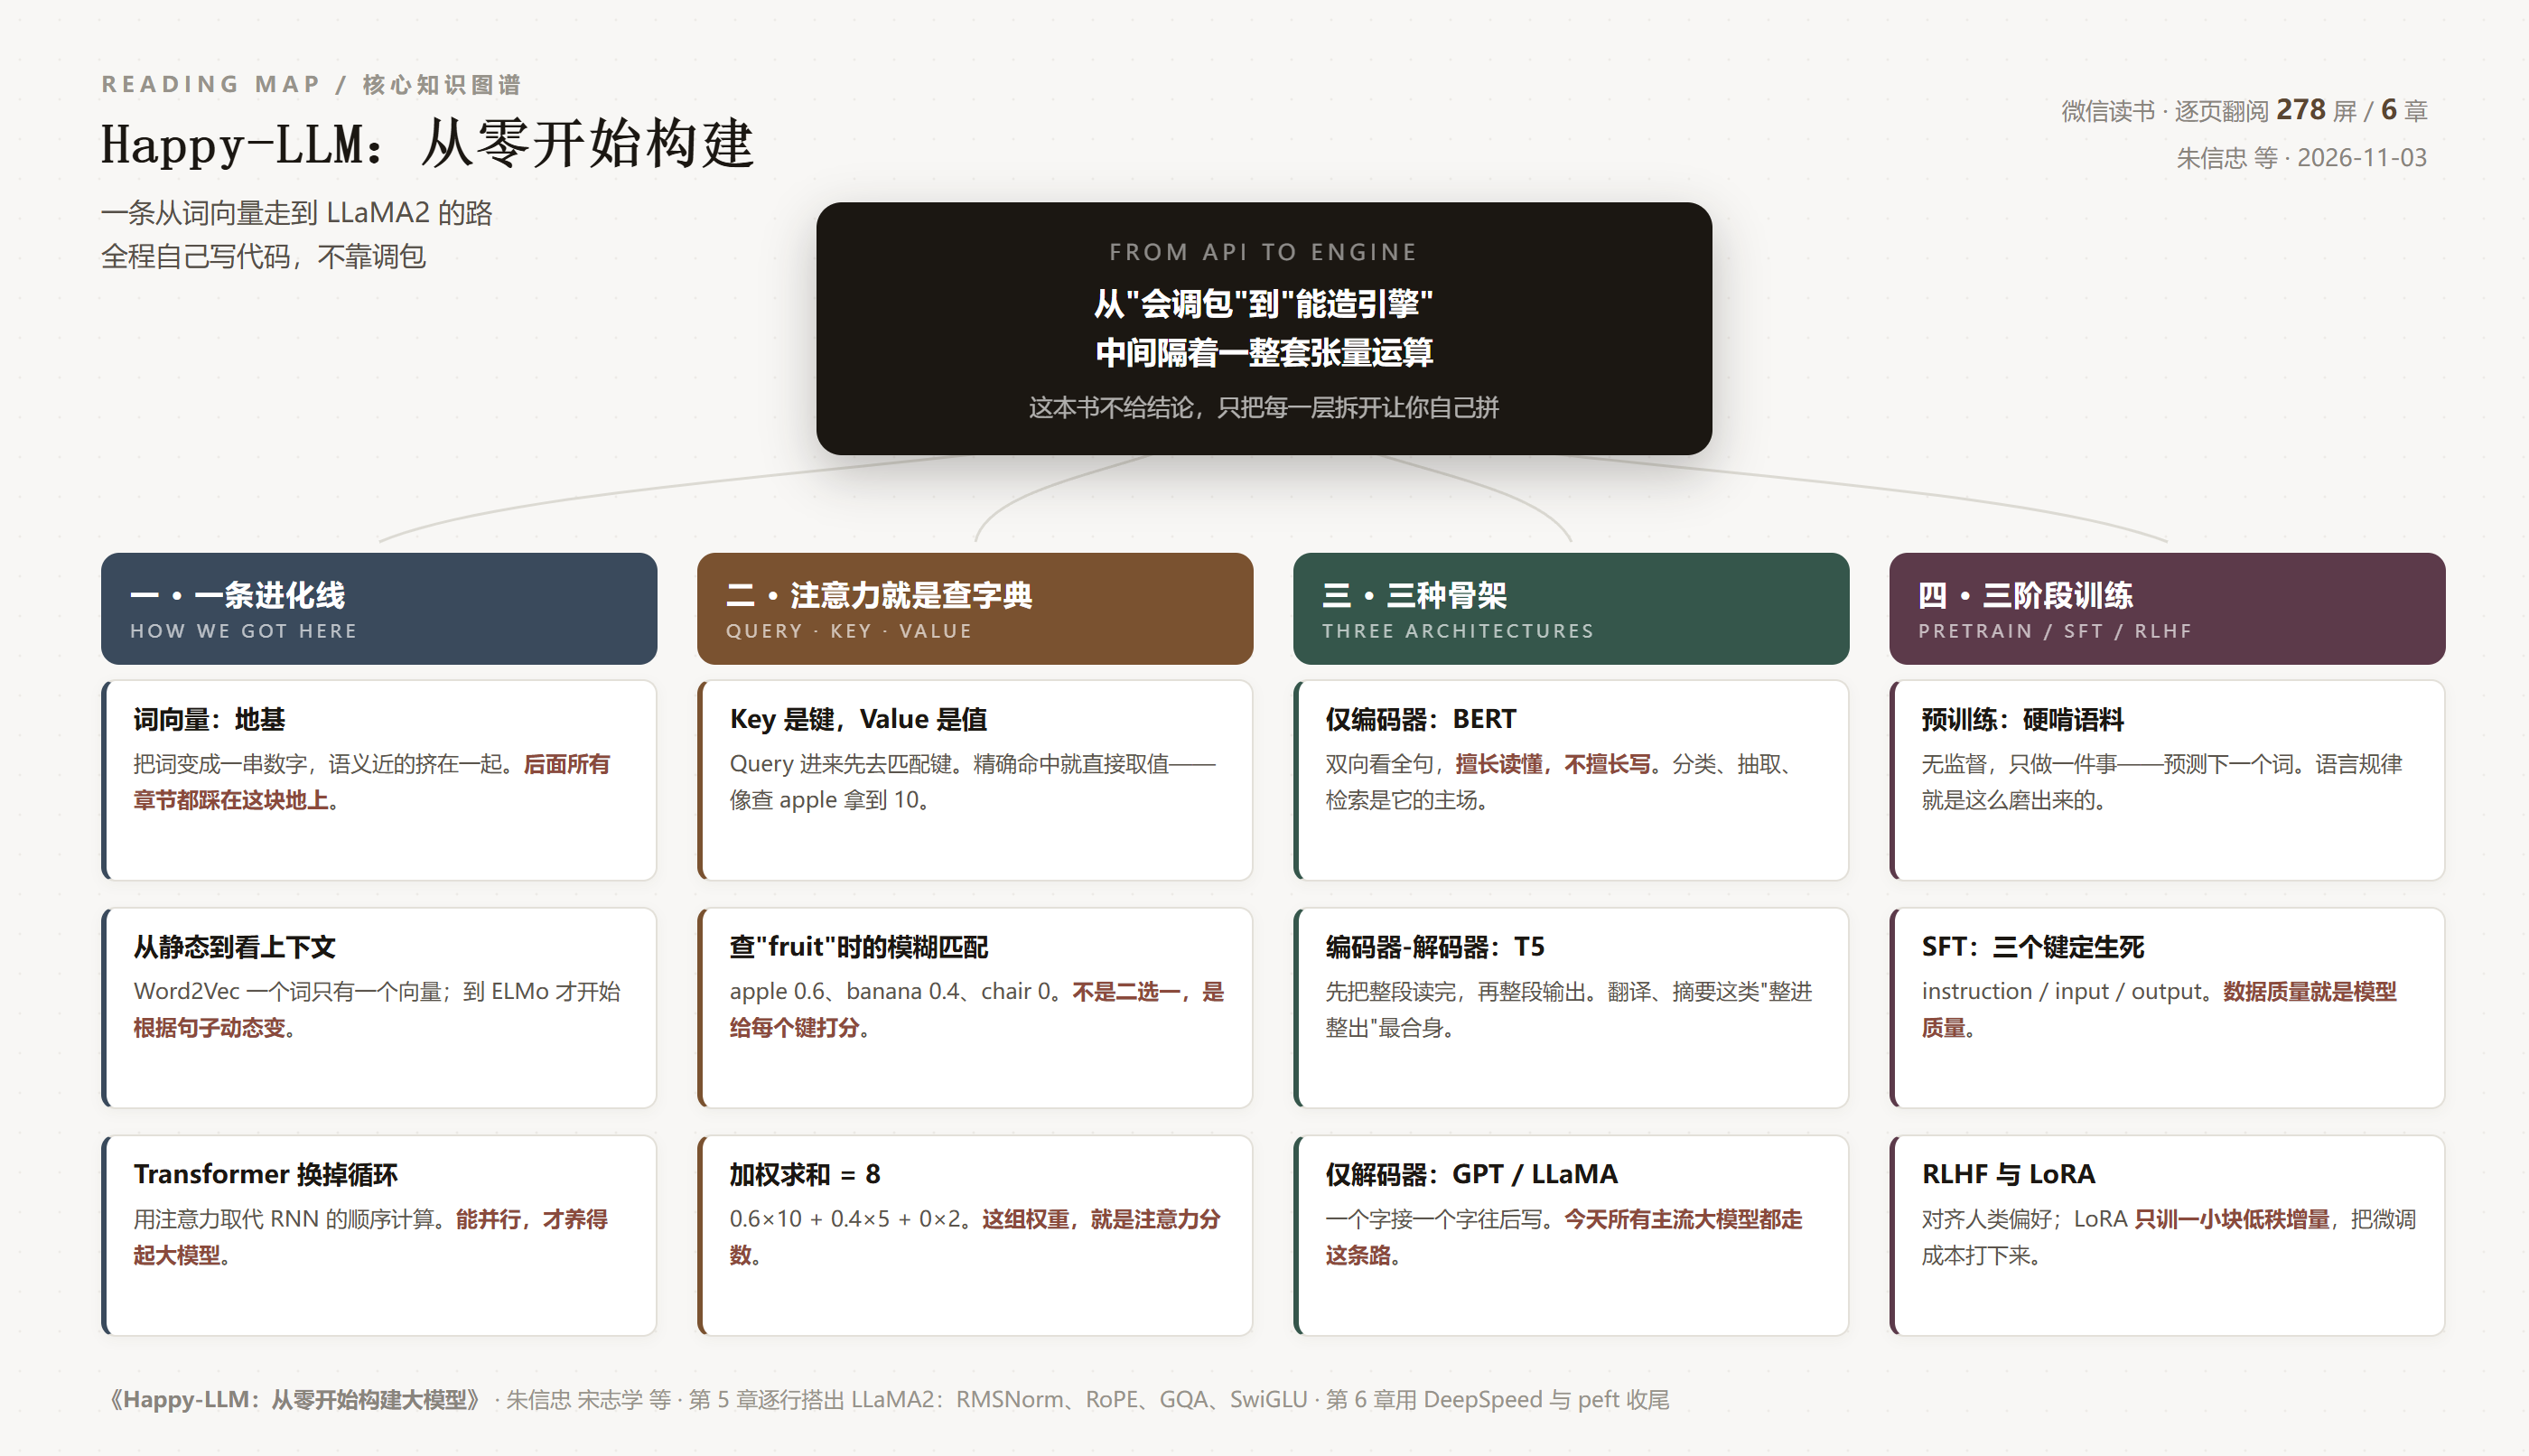
阅读记录:微信读书《Happy-LLM:从零开始构建大模型》(朱信忠、宋志学 等),逐页翻阅 278 屏,6 章 86 个目录节点,读至第 6 章大模型训练流程实践。2026-11-03。
发表评论: