
Harness 工程:上限不在模型,在你给它搭的脚手架
微信读书《Harness 工程:从上下文管理到 Agent 系统构建》
逐页翻阅 401 屏 · 7 章 · 2026-11-03
说明:这本书不是概念书,七章里有六章半在带代码。我读的重点放在"为什么这么设计",代码只挑骨架看。
先说结论:这本书讲的事,和大多数人理解的"AI 应用开发"不是一个层面。
多数人关心的是模型——哪个更强、哪个更便宜、上下文窗口多大。这本书从头到尾在讲另一件事:同一个模型,你把它放进什么样的壳子里,它能干的活差一个量级。
它把这个壳子叫 Harness,中文勉强对应"脚手架"或"挽具"。全书七章,其实是在一层层把这个壳子搭起来。
一、从"怎么问"到"该让它看见什么"
第 1 章做的第一件事,是把上下文工程和提示词工程的区别讲清楚。这个区分很多文章提过,但这本书讲得比较硬:它把上下文拆成了具体的几个组成部分——系统指令、工具定义、对话历史、外部文档、记忆。
拆开之后,一个结论就自然出来了:写提示词只是这里面很小的一块。
你精心打磨的那段提示词,可能只占这一轮输入的百分之几。剩下百分之九十,是工具描述、历史记录、召回的文件、上次的结论。这些东西怎么组织、什么该留、什么该扔,才是决定成败的地方。
书里有一句我印象很深:
多智能体不只是分工协作的工程实践,更是上下文工程在复杂任务场景下的自然延伸。它通过构建多个语义边界清晰、上下文纯净的 Agent 单元,让 LLM 能在更可控、更专注的环境中发挥最大效能。
这句话把 MAS(多智能体系统)的动机说透了。拆 Agent 不是为了"人多力量大",是为了让每一份上下文都干净。
书里举的例子很直白:一个 Agent 干三类活,上下文里就混着三类工具、三类规则、三类记忆,互相干扰;拆成三个 Agent 之后,每个只带自己那一份,总上下文长度翻了三倍,但每一份都纯。
这是个反直觉的账:总量变大了,噪音反而变小了。
二、五个"元驱动":让它先想清楚,再动手
第 2 章是全书最像教科书的一章,讲了五个可复用的模块:意图识别、计划模式、反思模式、CodeAct、Human-in-the-loop。
作者管它们叫"元驱动"——不是业务功能,是驱动业务功能的底层动作。
意图识别排第一位,是有道理的。用户说一句话,可能是问事实、可能是指令、可能是抱怨、可能是闲聊。如果这一步分类错了,后面工具越强,错得越离谱。书里没把它当成"分类任务"轻描淡写,而是当成一道必须先过的闸门。
计划模式的做法是先让模型出一个大纲,写进状态对象的 plan 字段,再交给执行节点按大纲跑。这个设计的价值不在"计划更好",在于计划变成了可检查的中间产物——它落在状态里,人能看见,也能改。
反思模式是执行完回头挑自己的错。书里给的实现很朴素:同一份结果,换个提示再让模型审一遍。朴素,但有效,因为它把一个串行动作变成了两个可观测的节点。
CodeAct 是这五个里最实用的一个。它的主张是:与其给模型二十个细碎工具,不如给它一个能执行代码的环境,让它写一段代码一次算完。理由是——工具的颗粒度决定了调用的次数,调用次数决定了上下文膨胀的速度。
Human-in-the-loop 那节有个测试案例我很喜欢:用户说"买苹果",没说数量。模型没有硬猜一个数字,而是调用一个名为 ask_user 的"人类工具",把问题抛回来:您想买多少?用户输入 3,流程恢复,继续算价。
这个案例小,但它踩在一个真问题上:模型最危险的时候,不是它不会,是它不会却装作会。给它一个"停下来问"的出口,比调高它的自信阈值有用得多。
三、DeepResearch:把这五个模块拼起来长什么样
第 3 章拿 DeepResearch 做了个完整案例。这本书的写法是"先给零件,再给整机",这一章就是整机。
它拆了两条路线:一条是从 DeepSearch 做起——先解决"搜得准",再解决"想得深";另一条是用 Sequential Thinking 方案,让模型把思考过程显式地一段段写出来,串成链条。
两条路线的差别其实是一个取舍:搜得广,还是想得深。前者靠检索质量,后者靠推理结构。
书里没有回避一个问题:这类产品跑一次要几十分钟,中间调用几十上百次模型。它不是"一次问答",是"一个能被观察和中断的长任务"。所以它对前面那五个模块的依赖是刚性的——没有计划、没有反思、没有中途干预,跑偏了没人知道。
这也解释了为什么这本书反复强调 Agent Loop。能长跑的不是模型,是那个 while。
四、记忆:把"记住什么"从提示词里拿出来
第 4 章讲记忆工程。核心观点是:记忆不该是"把历史对话都塞进去",那是最笨的做法。
真正的记忆系统要回答三个问题:记什么、存在哪、什么时候取。
书里用 Mem0 作为标准化实现的例子,讲了它的分层——短期的工作记忆、长期的事实记忆、以及按会话或按用户隔离的作用域。后面还给了容器化的分布式部署方案,这部分偏运维,但它的存在本身说明一件事:记忆已经是个服务,不是一个变量。
我读这一章的收获是一个判断标准:如果你的"记忆"是靠在提示词里追加历史实现的,那它一定会在某一天突然崩掉——不是慢慢变差,是突然崩掉,因为窗口满了。
五、Skills:上下文卸载的艺术
第 5 章是我认为全书最有价值的一章,标题起得也最好——"上下文卸载的艺术"。
它讲的问题很具体:一个大项目里,规范、文档、最佳实践加起来几十万字。如果一次性塞进系统提示,会发生什么?
作者的答案很干脆:不仅会迅速耗尽上下文窗口,还会引入大量无关噪声。而且是在任务还没开始的时候就耗尽。
Skills 的解法叫"渐进式加载",分两级:
第一级,在 Agent 启动初始化时,只扫描 Skills 文件夹,读取每个 Skill 下 SKILL.md 里的元数据——名字、一句话描述、什么时候该用。
第二级,当 Agent 在处理具体业务、判断需要用某个 Skill 时,才通过工具调用把全文读进来。
这个设计的精妙之处在于:它把"知道有这个能力"和"拥有这个能力的内容"拆成了两件事。前者很便宜(一行字),后者很贵(几千字)。绝大多数时候,你只需要前者。
书里还给了一个零代码的实操:用 SKILL.md 加一个 references 目录,做一个"运维巡检 Skill"。里面定义了 CPU、内存、磁盘各项指标怎么取、健康阈值是多少、异常怎么判、建议怎么写。
我看到那张参考文件截图时有点触动——它其实不是"提示词",它是一份被结构化了的运维手册。每一条指标后面都标了数据来源(用哪个 psutil 函数取),防的就是"指标缺失导致推理失败"。
这一点,比"教你怎么写提示词"高一个层级。写提示词是在教模型说话,写 Skill 是在给它装业务知识。
六、复现 Claude Code:Harness 的四根柱子
第 6 章是全书的重头戏,标题就叫"复现 Claude Code 核心设计模式"。它拆了四件事,我认为这四件就是 Harness 的四根柱子。
第一根,Agent Loop。书里给的循环很朴素:调用模型 → 看它要不要调工具 → 调 → 把结果塞回上下文 → 再调用。加了 Read、Write、Edit、Bash 四个文件工具,按 tool_call 的名字分发。
朴素到什么程度?朴素到你会怀疑"就这?"。但书里那句"Agent 可以长时间工作的核心"是认真的——真正让 Agent 能连干两小时的,不是模型多聪明,是那个不退出循环的 while 加上一套能自我纠错的工具返回。
第二根,上下文管理。这一节拆的是 Claude Code 怎么决定"什么时候压缩、压缩掉什么"。原则是保近不保远、保结论不保过程、保任务状态不保闲聊。
第三根,持久化与异步。任务和依赖关系写成 JSON 落盘。书里有个演示:在新开的对话里让 Agent 列出任务,它照样能读出磁盘上那份文件,把 #1 → #2 → #3 的依赖图复述出来。
这个演示看着平淡,但它解决的是 Agent 最尴尬的问题:聊到一半窗口满了,或者进程挂了,之前干的活全没了。落盘之后,换一个会话还能接着干。
同一节还讲了后台任务:耗时的操作(装依赖、构建镜像)扔到后台,前台继续响应。这个改动很小,体验差别很大——Agent 卡住不动的绝大多数时候,不是在思考,是在等一个命令跑完。
第四根,Agent Teams。主 Agent 把活派给子 Agent,子 Agent 在自己的上下文里循环,干完只把结论交回。书里那个例子:子 Agent 写 test.py、跑测试、失败、改、再跑,全程主 Agent 看不见中间过程,只收到一句"文件已创建,测试通过"。
这就是第一节那句"上下文纯净"的落地。隔离不是省事,是降噪。
七、Claw 类产品:这套东西已经长成了产品
最后一章讲 Claw 类产品(Claude Code 一系的开源复刻)的核心架构,还带着做了一个 NanoClaw。
这一章的价值不在代码,在于它把前面六章的东西拼成了一个完整闭环:上下文工程解决"给它看什么",五个元驱动解决"它怎么想",记忆和 Skills 解决"它记得什么、会什么",Harness 解决"它怎么一直干下去"。
四层叠起来,才是一个能干活的系统。少任何一层,都会在某个具体场景里翻车:
没有上下文管理,跑二十分钟就崩;没有计划与反思,跑偏了不自知;没有记忆,每次都要重新交代;没有 Skills,专业活干不了;没有持久化,一断就重来。
八、它的短板
代码密度太高,且偏实现细节。七章里有六章带大段代码,很多页是"第 3 行做什么、第 5 行做什么"的逐行注释。想读思想的人会被淹,想抄代码的人又发现它用的是特定 SDK(比如通义的 llm_Tongyi),换个模型要改不少地方。
部分实现是教学版,不是生产版。比如反思模式就是"再问一遍",真实系统里要处理的是"审错了怎么办"。书里对这类边界条件给得不多。
它假设你已经知道为什么要做 Agent。全书没有花篇幅论证"这东西值不值得做",直接进入"怎么做"。对还在观望的读者,门槛偏高。
但它做对了一件很难的事:把"AI 应用开发"从"调 API"拉到了"系统工程"的层面。市面上大多数书停在"提示词怎么写",这本直接告诉你——提示词只是入口,后面还有五层脚手架。
而这一层的差别,恰恰是"能演示"和"能交付"的差别。
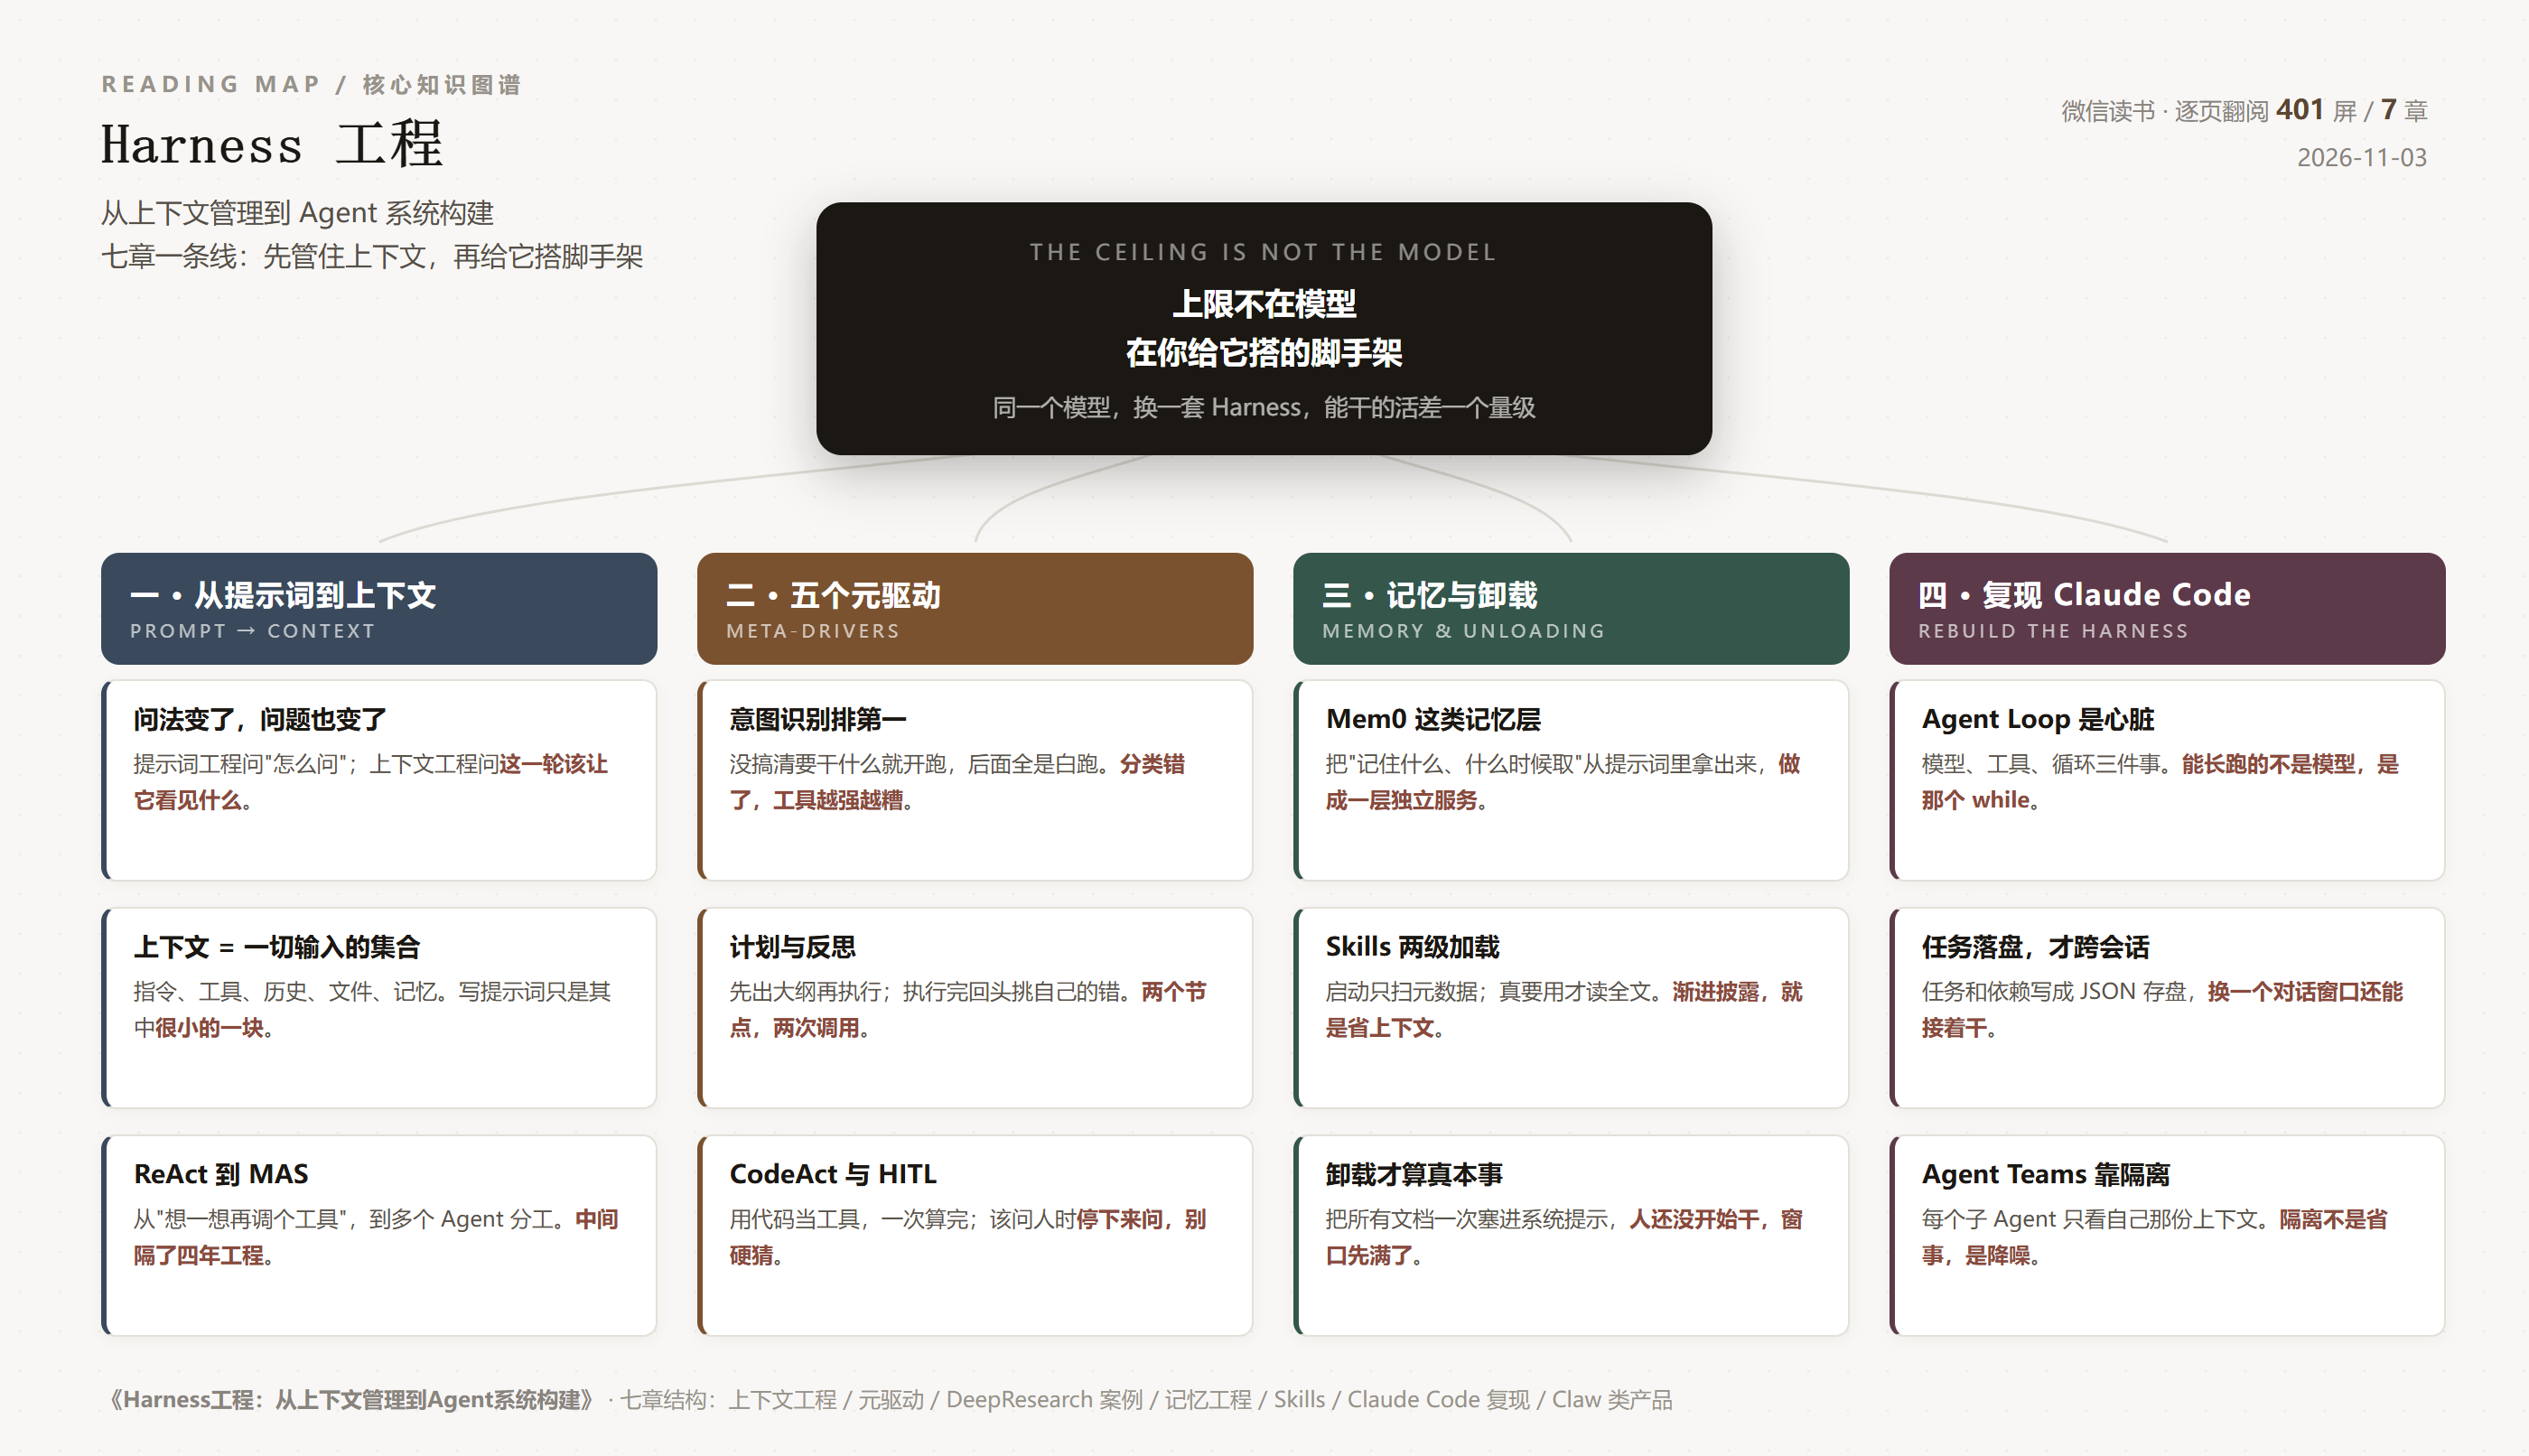
一句话总结:这本书真正在教的事,是怎么把一个会说话的模型,关进一个能长期干活的笼子。
阅读记录:《Harness 工程:从上下文管理到 Agent 系统构建》,微信读书逐页翻阅 401 屏,七章读完,读至第 7 章 NanoClaw 实践。2026-11-03。
发表评论: