
上下文工程:模型缺的不是字数,是一个能承重的骨架
微信读书《Context Engineering for Multi-Agent Systems》
逐页翻阅 1042 屏 · 10 章 · 2026-11-03
说明:这是一本英文书,微信读书版本每页都是英文原文加中文译文对照,所以屏数偏多,实际内容约当五百屏。全书跟着代码走,Pinecone + OpenAI + Colab。
这本书开头做了一件我很喜欢的事:它不给你讲定义,它给你看同一句话在五个层级下的五种输出。
同一只猫、同一个动作、同一个要求,只是喂进去的上下文一层层加厚。你会亲眼看到输出从"套话"变成"有结构的一段话"。这个演示比任何定义都有说服力。
而它给出的判断很尖锐:上下文工程不是"多给点信息",是"给出结构"。
一、五个层级:从"没背景"到"语义蓝图"
第 1 章把上下文分成五级,我觉得这个分级可以直接拿来当自检表用。
Level 1:零上下文。一句简单指令,没有任何背景。模型只能按训练数据里最可能的走法往下猜。书里的判断很狠——产出的结果是通用或老套的。
演示里那句"猫玩毛线球"的补全,微软 Copilot 给出的是"毛线球一路滚过地板,滚到沙发下的皱收据那里,它把收据拨来拨去,像对待垃圾兔王国里最珍贵的宝物"。作者说得很清楚:如果我们要的是精确回答,这种输出就叫幻觉。它不差,只是它写的不是你要的。
Level 2:线性上下文。加一条线索,准确性提升,但模型仍然没有风格、目的、方向。
Level 3:目标导向。告诉它这段文字要干什么用。这一步开始,输出开始"往一个方向收"。
Level 4:角色化上下文。给它一个身份,或者给涉及的对象分配角色。
Level 5:语义蓝图。这是全书的核心概念,也是它区别于其他"提示词技巧"的地方。
二、语义蓝图:把"谁对谁做了什么"画出来
Level 5 的做法,是拿语义角色标注(SRL,Semantic Role Labeling)来重构上下文。
简单说:一句话不是一个词串,是一组角色关系——谁(施事)、对谁(受事)、做了什么(动作)、在什么条件下(时间、地点、方式)。SRL 把这些角色标出来,然后书里用 Python 把它们画成一张 stemma 图(一种句法关系图)。
画出来之后做什么?染色,再喂回去。
演示里,模型拿到染色后的结构,写出了这样一句:"He then played with the red ball, his shadow flickering defiantly beneath the looming tick of the grandfather clock, as if daring time itself to strike."——红色的球、爷爷钟的滴答、影子的挑衅,全都落在原来那组角色上。
作者的结论是:我们提供的结构,一路穿透进了叙事。
这一段是全书写得最漂亮的地方。它把一个很抽象的说法——"给模型结构,它就会照着结构走"——变成了可以看见的东西:左边一张角色图,右边一段按图写出来的句子。
我认为这里藏着一个更普适的道理:模型不是不理解你的意思,它是没有"承重的骨架"。你不给骨架,它就用统计平均值糊一个;你给骨架,它就在骨架上长肉。
三、用 MCP 搭一个多 Agent 系统
第 2 章开始动手。它用 MCP(Model Context Protocol)搭 MAS,顺序是:先架构工作流,再初始化客户端,然后定义协议,再建各个 Agent,最后写编排器(Orchestrator)。
这个顺序值得记一下。多数人搭 Agent 系统是"先写 Agent,撞墙了才想协议"。这本书反过来,先把协议钉死,Agent 才有共同语言。
更值得记的是它加的两样东西:消息校验(Validating MCP messages)和 Agent 专业化控制(agent specialization controls)。
意思是:Agent 之间传的话也要验,不能默认对方说的格式是对的;每个 Agent 还要有边界,不能越界去干别人的活。
书里最后给了一个带验证循环的编排器。作者的理由很实在——没有校验的系统,只能跑演示;能跑长任务的系统,一定有一圈圈的自检。
四、双 RAG 与"可验证的引用"
第 3 章讲双 RAG 的 MAS,第 7 章把它升级成一个 NASA 风格的研究助手——高保真 RAG 加防御。
其中有一个细节,我认为是全书最实用的一条工程规范:
数据导入脚本负责处理原始文档。它将文本分割成易于处理的片段,并为每个片段添加来源元数据。这些元数据对于实现高保真度的检索增强功能至关重要,有助于生成可验证的引用信息。
这句话的分量在于最后四个字:可验证的引用。
大多数 RAG 系统只做"检索到相关片段 → 塞进上下文 → 生成答案"。这条路能跑通,但它有个致命弱点:你无法判断这段答案是来自文档,还是模型自己编的。
加上来源元数据之后,每个片段都能回溯到原文的哪一段。答案里带引用,引用能点开核对——这才是"有依据",否则只是"看起来有依据"。
而这一步的成本低得惊人:在切片的时候顺手多存几个字段而已。绝大多数 RAG 做不好,不是模型不行,是切片的时候偷了懒。
五、摘要 Agent:专门雇一个人去删东西
第 6 章有个很有意思的设计:Summarizer Agent。
它的职责单一——把别的 Agent 产出的长内容压短。为什么要单独设一个 Agent 干这事?因为上下文是有成本的,而且成本是双份的:一份是钱(Token 计费),一份是延迟(Token 越多,生成越慢)。
书里讲延迟那一节,有一段我觉得说到了本质:
这种现象并非我们系统所独有。你可能已经注意到,像 OpenAI 的 ChatGPT 或谷歌的 Gemini 这样的主流平台,在处理需要推理过程的复杂多方面问题时,其响应时间也要比回答简单问题要长。它们的内部架构越来越类似于我们正在构建的多智能体、思维链式系统。这些系统通过内部路由、工具使用和事实核查等流程,在牺牲一定速度的同时,提升了准确性、可靠性和可解释性。
这段话把我一直隐约感觉到但没想清的事说明白了:那些大平台不是"一个模型在回答",它们内部也在一层层加流程。你能感觉到的"这次它想了很久",很可能就是它在内部跑了路由、检索、核查。
而这也给了一个很实用的取舍标准:简单问题走快路,复杂问题走慢路。书里给的优化手段也朴素:并行独立的 Agent 调用、缓存常用结果、简单任务派给更小更快的模型。
六、审核、策略、以及"上线才算数"
第 8 章讲审核(moderation)、延迟和策略驱动的 AI。第 10 章收成一个"生产就绪蓝图"。
这一部分的价值不在技术,在于它把"能跑"和"能上"之间的差距摆出来了:内容分级、越界拦截、延迟预算、成本上限、可解释性、责任归属。
书里有一句我同意的话,大意是——当系统出问题时,站出来的应该是懂架构的人,而不是那个盯着控制面板、一脸困惑、不知道发生了什么的操作员。
这句话说的其实是同一个东西:上下文工程做到最后,交付的不只是效果,还有"出事时能查"。
七、它的短板
它是 code-along 类型的书。十章基本都在带代码,Pinecone、OpenAI、Colab、Notebook 一路走下来。想读思想的人会觉得它碎,想跑通的人又会发现它绑定了特定服务商,换一套就得改。
语义蓝图那一章惊艳,但后面没接住。SRL 染色这个思路非常漂亮,可它在后续章节里的复用程度不高,更多是作为一个"演示"存在,没有变成贯穿全书的工程方法。这是个遗憾。
1042 屏里有相当一部分是双语对照的重复。英文一段、中文一段,实际信息密度大约折半。这不是书的问题,是平台排版的问题,但读的时候要有心理准备。
但它做到了一件很难的事:它把"上下文工程"从一句口号,拆成了五级台阶、一张图、一套协议、一个引擎、一份上线清单。
读完至少你会知道自己在第几级——以及下一级要补什么。
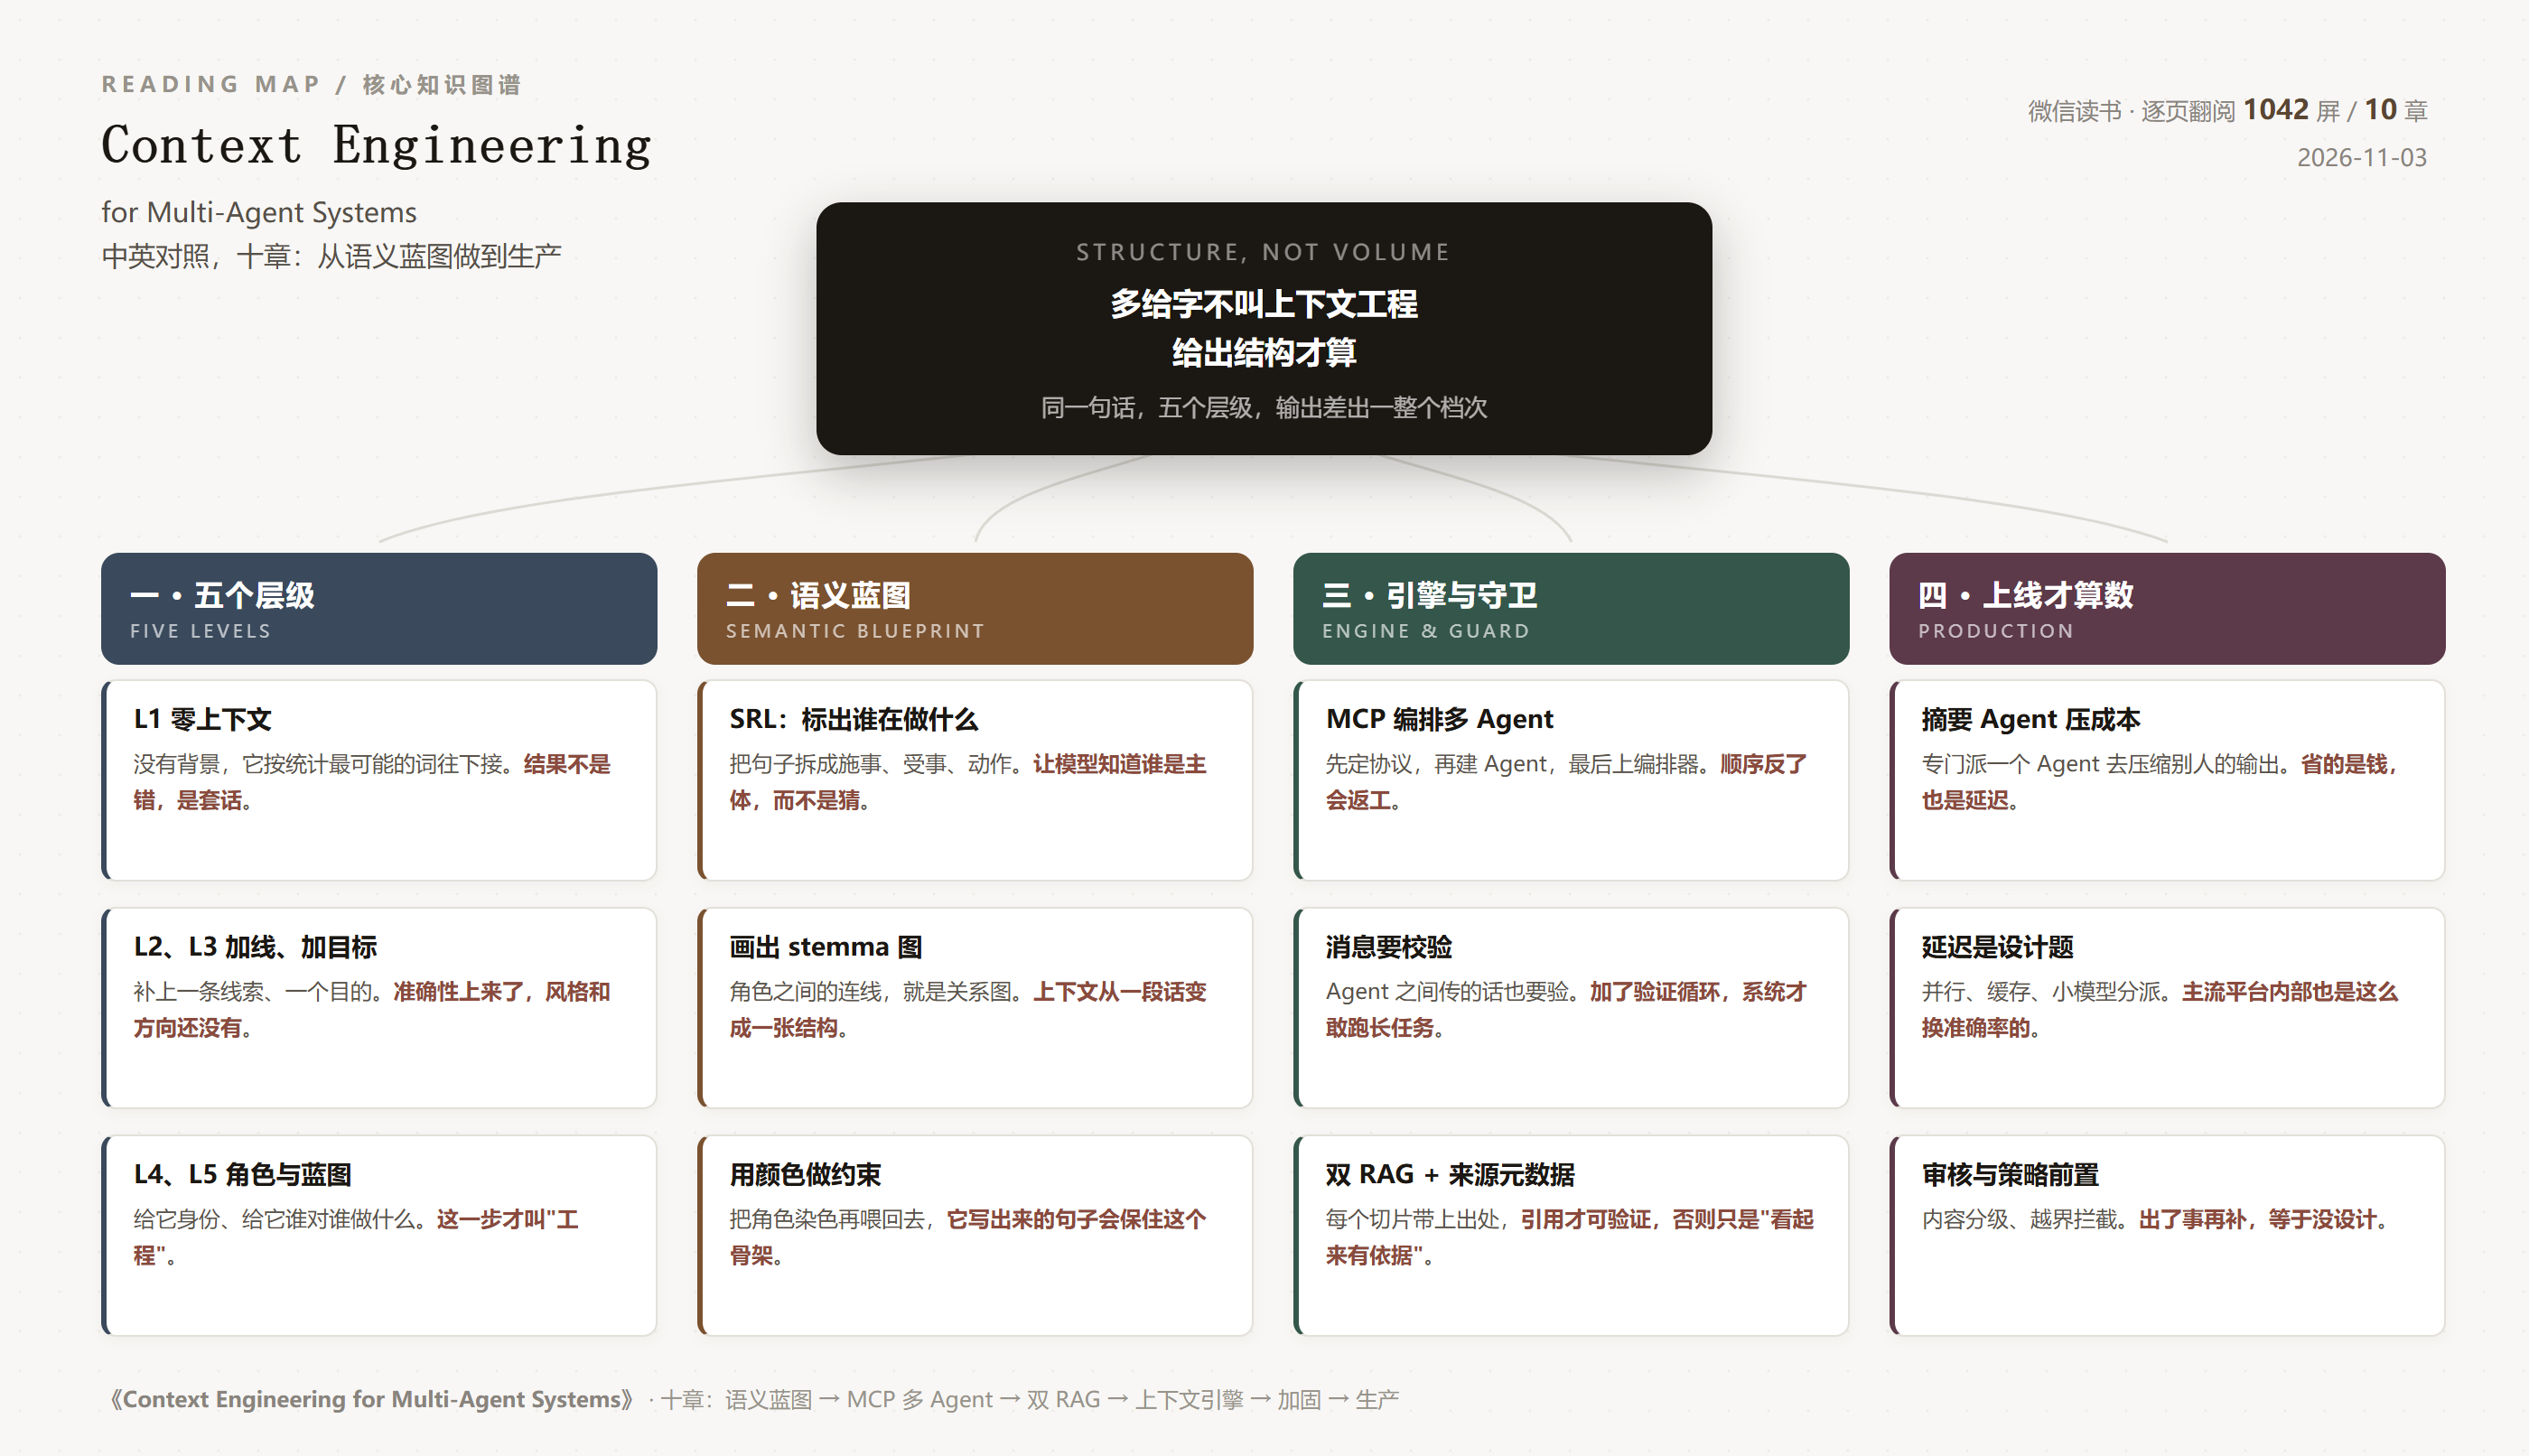
一句话总结:模型缺的从来不是字数,是一个能承重的骨架。
阅读记录:《Context Engineering for Multi-Agent Systems》,微信读书逐页翻阅 1042 屏(中英对照),十章读完,读至第 10 章生产蓝图。2026-11-03。
发表评论: