
大模型工程化:模型不是瓶颈,数据才是
微信读书《大模型工程化:AI驱动下的数据体系》· 戴诗峰、谢思发、李飞宏 等著(腾讯游戏数据团队)
逐页翻阅 488 屏 · 6 部分 16 章 · 2026-11-03
说明:这本书我按"目录通览 + 关键页精读"的方式过了一遍,488 屏的页码顺序对着目录核过。读完之后我的判断很明确:它是一本好书,但被书名骗了一半。前八章讲的其实是数据中台的存量知识,大模型到第 9 章才真正上桌。下面我说清楚它真正值钱的是哪几十页,以及它为什么不敢把最该给的东西给出来。
先给结论:这本书最有价值的部分,不是它讲的"大模型怎么用",而是它回答了一个绝大多数 AI 落地项目绕着走的问题——业务问一句话,凭什么你的数据答得上来?
"大模型工程化"这五个字,市面上常见的写法是提示词工程、RAG 调参、Agent 编排、微调与蒸馏。这类书写得快、卖得动,因为读者焦虑。这本书走的是另一条路:它把大模型当成一个"新的数据消费者",然后追问——现有的数据体系伺候得起这个消费者吗?
答案当然是否定的。而它给出的应对不是"再上一个向量库",是把整个数据资产的定义重写一遍。这是本书的骨架,也是它区别于同类书的地方。
一、先说清楚:这是一本"数据书",不是"模型书"
我得把这个话说在前面,因为它决定你该不该买。
全书六部分:大模型技术的发展与应用、大模型与数据体系、关键基础设施、数据资产、自研领域大模型的技术原理、工程化原理,最后落到游戏领域应用。真正在讲"模型"的,是第四部分的三章——需求理解算法、需求匹配算法、需求转译算法。这在 488 屏里大概只占一小块。剩下的篇幅,讲的是数据建模、湖仓一体、数据冷热分层、物化视图、数据治理标准。
这些内容重不重要?极重要。但它们是数据中台时代就已经成型的知识体系,只是因为大模型来了,被重新排列了一次。
我举个最直接的例子。书里讲物理模型设计,仍然老老实实从 ODS 讲起:
ODS 层:操作数据层(Operational Data Store, ODS),主要用于原始数据在数据平台的落地,提供基础原始数据,可减少对业务系统的影响。……DWD 层:明细数据层(Data Warehouse Detail, DWD)包含了一系列由 ODS 层数据经过清洗、过滤和连接等操作后得到的规范化明细数据。……DWS 层:数据轻度汇总层(Data Warehouse Summary, DWS)按粒度、维度对明细数据进行统计汇总,为上层数据分析和算法应用生成公共指标。
这段话没有一处提到大模型。它讲的是 2010 年代的数仓分层,而且讲得挺标准。再看讲湖仓底座那一节,图 3.3 是 Hadoop 架构图,正文的解释是:
管控节点的 ResourceManager 和单机处理节点的 NodeManager 共同协作,实现了 Hadoop 集群的资源管理和任务执行;管控节点的 NameNode 和单机处理节点的各个 DataNodes 协作,实现了分布式存储和管理。
这是教科书式的 Hadoop 讲解。它没错,但它也说明了一件事:这本书的底座是老底座。大模型没有推翻它,只是给它压了一个新需求。
所以更准确的书名应该是《数据体系工程化(大模型时代版)》。这不是贬义——恰恰相反,我认为愿意花两百页去讲底座的书,比愿意花两百页去讲提示词的书诚实得多。但它有一个直接后果:如果你是冲着"学怎么调模型"来的,这本书会让你失望;如果你是冲着"我的 RAG 为什么总是答不准"来的,这本书可能正中要害。
二、它真正解决的那个问题:需求也是资产
全书最核心的一节是 4.3"重塑数据资产的思路"。这一节的逻辑链条我完整抄下来,因为它值得逐字读:
基于 AI 的能力,通过更广义的资产标准,解决非结构化标准缺失问题;通过更灵活的资产建设,解决建设和治理成本高的问题;通过更量化的资产运营,解决运营目标不一致的问题。
三句话对应三个动作,而这三个动作里,第一个是真正的观念转变。
传统的数据资产是什么?是库表。表在哪、字段叫什么、什么粒度、多热、多快——书里第 5 章把这些做成了参数化的标准,"粒度参数""热度参数""速度参数"。这套东西在数据中台里已经跑了十年,成熟、可执行、可审计。
但它有一个死穴:它只认结构化的东西。一段工单对话、一份行业调研、一条玩家反馈,这些非结构化的、恰恰是大模型最擅长的输入,在老的资产体系里没有位置。它们躺在文件服务器里,被当成"资料"而不是"资产",因为没法纳入表管理体系。这就是书里说的"缺失非结构化标准"。
这本书的解法不是"给非结构化数据也建一张表",而是把资产的外延扩大成三类:库表资产、需求资产、特征资产。图 4.8 把这三类并列画在一起,后面第 5、6、7 章分别给出标准、建设、运营三段式。
我认为"需求资产"这个概念是全书最有野心的一笔。它把"业务方想要什么"本身当成一种要被建模、被存储、被复用的资产,而不是每次重新问一遍的口头需求。书里具体拆成了三层:结构化需求、行业知识资产、AI 可理解需求。
这个排序是有讲究的。结构化需求解决"能不能算",行业知识资产解决"算得对不对",AI 可理解需求解决"模型能不能读懂"。前两个是数据中台的旧活,第三个才是新活。而第三个恰恰是最难的:你要把一句"上周新服玩家的付费转化怎么样"翻译成模型能吃的形式,中间要处理同义词、口径、时间基准、粒度对齐——这些没有一样是模型自己能搞定的。
还有一类资产没有被单列成章,但反复出现:特征。书里把特征分成个人特征和公共特征,第 6 章分别给了建设路径。这个区分看着像常识,实际是踩过坑的——个人特征口径一旦变更,影响面是单点;公共特征口径变更,影响的是所有下游模型。很多公司的特征平台死在第二类上,因为改一个公共特征没人敢签字。
第 6 章 6.4 的"AI 辅助库表资产建设"是全书少见的把 AI 用在"自己家门口"的一节,三步:成本模型训练、物化视图候选集生成、物化视图推荐。这里的思路值得学:不是让模型去猜该建什么视图,而是先训练一个成本模型预测"建了这个视图能省多少",再用它去排序候选集。把一个开放问题收敛成一个可算的排序问题,这是工程思维,不是模型思维。同类书里,这一步经常被简化成"让大模型推荐",然后就没有然后了。
我的判断是:这一节的价值,五年后回头看会比现在更高。因为当所有人都能用上同一个模型的时候,差别只在数据组织方式上。而"需求也当资产管理"这个思路,目前还没有成为行业共识。
三、第 9 到 11 章才是心脏,但它们来得太晚
整本书的算法部分只有三章:需求理解、需求匹配、需求转译。这三章加起来,是"从一句人话到一行 SQL"的完整链路。我认为这是全书技术含量最高的地方,也是被埋得最深的地方——它在第 300 多屏,前面已经翻过了两百多屏的湖仓和治理。
先看需求理解。书里没有直接讲"把句子切成词",而是先讲意图。原文写得很清楚:
用户的需求往往都会直接或隐含地体现某种特定的意图,例如,在游戏领域,用户最关心的是游戏的玩家活跃和收入情况。因此,为了明确用户的意图,本节引入意图召回算法,通过识别用户的意图来召回满足用户需求的相关资产表。
图 10.15 把意图召回拆成四个模块:构建意图召回方案、构建意图类目、构建意图识别规则、构建意图识别模型。
这个拆法值得说两句。它没有一上来就训练一个分类器,而是先做"方案"和"类目",最后才做"模型"。这个顺序在工业界是对的,在教科书里是反的。因为类目是业务知识,模型只是把类目自动化;类目错了,再准的模型也只是把错的东西分得更快。很多团队做 Text2SQL 做不出来,卡的不是模型精度,是他们的意图类目根本没有覆盖真实提问的长尾。
更值得注意的是,"构建意图识别规则"被放在模型前面。这说明作者不打算一步到位的全模型化。规则和模型并存不是过渡期的将就,而是数据类系统的常态——规则负责确定性高的高频场景(财务口径、监管口径这种一丝不能错的),模型负责长尾。承认这一点,比宣称"我们用大模型全面替代了规则引擎"要专业得多。
再看表 8.1,这是全书少数几张"历史表",讲句子表征模型的演进:2014 年的 PV、2015 年的 Skip-Thoughts、2016 年的 PARAGRAM-PHRASE XXL 和 SDAE、2017 年的 SIF 和 InferSent、2018 年的 Quick-Thoughts 与 USE、2019 年的 Sentence-BERT。四类模型并列:词聚合、语序连贯性、语义对比、混合多任务。
这张表放在"数据资产标准"这一部分里,位置有点怪,但内容是对的。它想说的是:在 Sentence-BERT 之前,把一句话变成一个向量这件事,大家试了五六条路,全都不够好。这解释了为什么语义检索在 2019 年之前一直不好用,也解释了为什么 RAG 是 2023 年才爆发而不是 2020 年——底座不是突然变强的,是一步步攒出来的。
四、从"讲意图"到"出 SQL":第 16 章那两张图值得单独看
全书我最想看的是落地效果,而唯一给出"前后对照"的地方在第 16 章,游戏领域应用。图 16.18 和图 16.19 是两张截图:左边是人写的自然语言数据包,右边是系统生成的 SQL。
书里对图 16.19 的说明只有一句,但这一句信息量很大:
数据包 2 的代码逻辑则是获取次日活跃的用户明细。在数据包 2 的执行逻辑中,"次日"已经被 AI 自动替换成具体日期。
"次日"替换成具体日期——就这五个字,我觉得是整本书最实在的一处工程细节。
为什么?因为所有做 Text2SQL 的人都会在这里摔一跤。语言里的时间全是相对的:今天、昨天、次日、上周、上个月、最近七天、这个季度。"次日"在人看来毫无歧义,在 SQL 里它是一个必须被解析成具体日期区间的表达式,而且这个解析要跟着运行时变化——今天跑是 11 月 3 日,明天跑就得多一天。如果这一层没做好,你生成的 SQL 语法完全正确、能跑通、结果全错,而且错得很难被发现,因为没人会怀疑一条能执行的 SQL。
这个案例也让我确认了一件事:这本书的真实成色不在"大模型"三个字上,在这些脏活上。它敢把"次日怎么变成日期"这种一点都不性感的问题写进书里,说明作者是真在一线趟过。判断一本工程书值不值钱,有个很简单的标准:它有没有写那些"写出来显得不高级"的细节。
五、图 4.8 与三段式:这本书的骨架长什么样
图文对照:全书的知识骨架
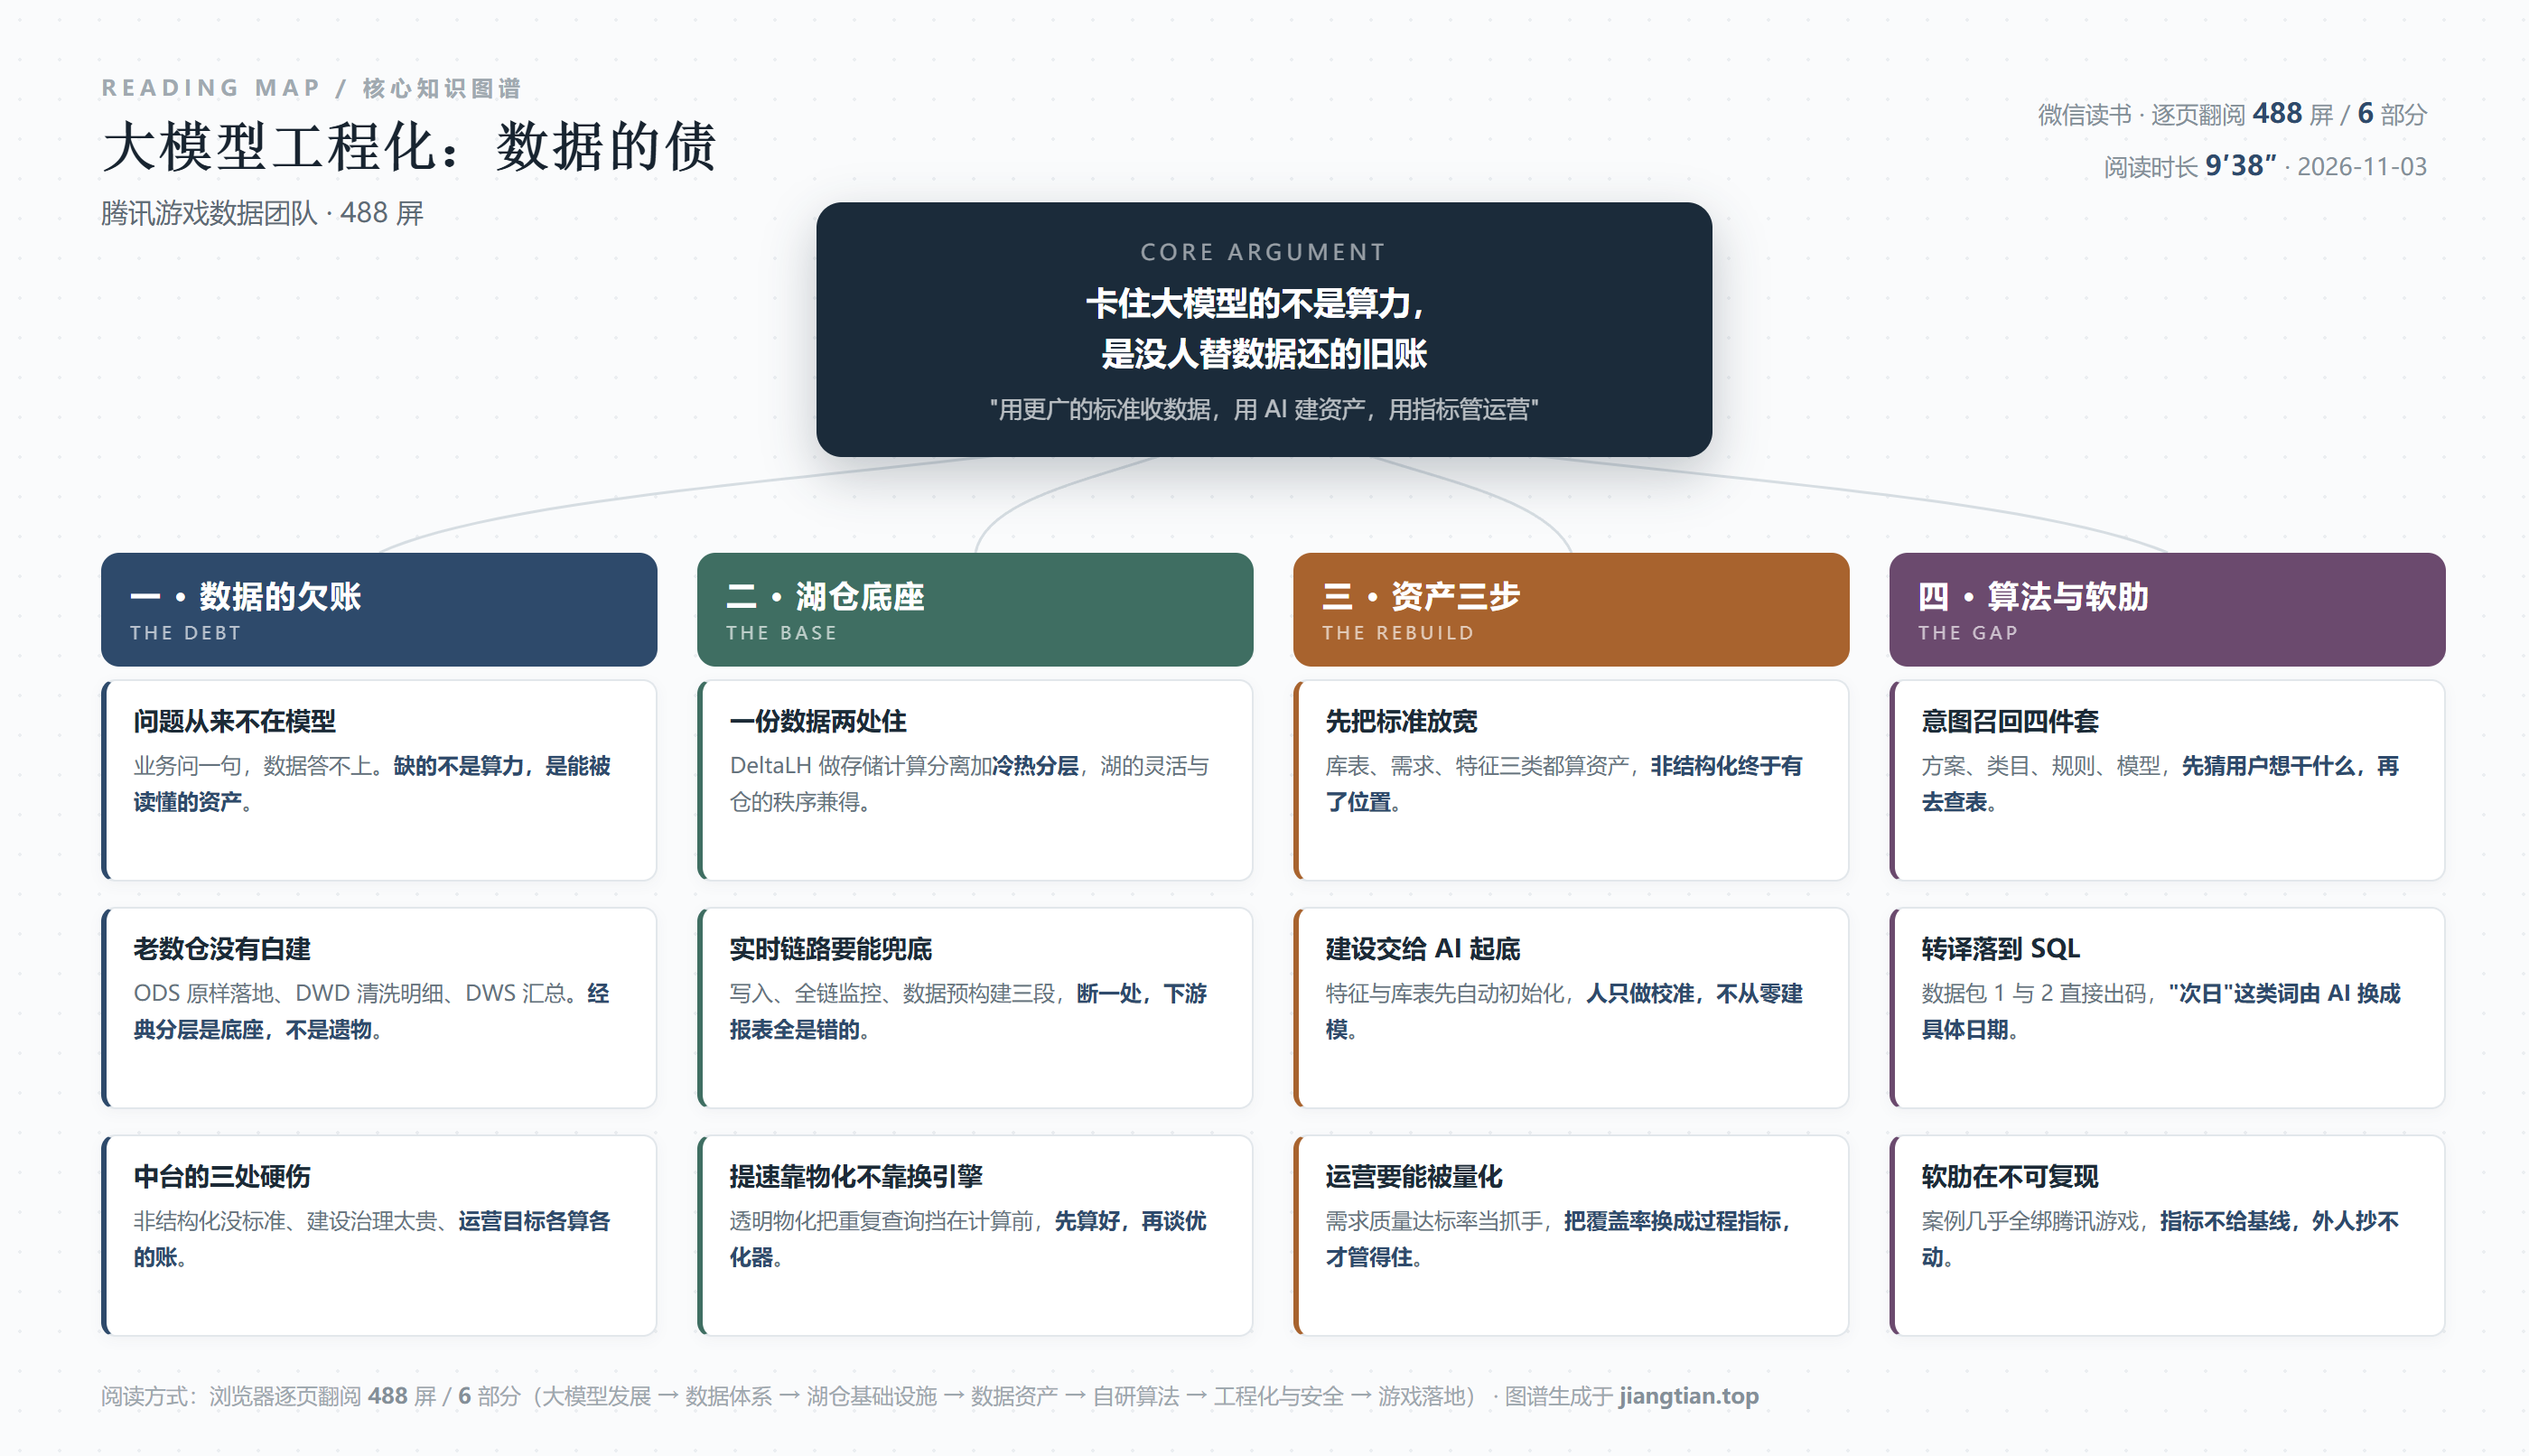
上面这张图是我按全书逻辑重排的。左边两列是"为什么",右边两列是"怎么办"和"哪里不行"。如果你只有十分钟,看这张图比翻目录有效。
但我想强调的是它的中轴:标准 → 建设 → 运营。这三段在书里分别对应第 5、6、7 章,而且三段之间是闭环的——运营产出的指标反过来修订标准,标准再指导建设。
这个闭环设计得不错,但书里也露了一个破绽。第 7 章讲运营目标时提到,过去大家盯的是"资产覆盖率"这个结果性指标,而作者主张建立"过程性运营指标体系",因为覆盖率达标不代表资产可用。这个批评是对的,我完全同意——覆盖率是个典型的"能汇报但不能用"的指标,它衡量的是你有没有把东西登记进系统,不衡量登记进去的东西有没有人用。
问题在于,作者提出"需求质量达标率"作为替代,却没有给出这个指标的计算公式在真实业务里的分布。达标线定在 80% 还是 95%?分母是全部需求还是抽样需求?一个季度提升五个点需要投入多少人?这些数字一个都没有。运营指标体系最怕的就是"有了指标但没有基线",因为它会立刻退化成新的汇报口径。
六、工程化与安全:写得最薄的一块
第 5 部分叫"大模型的工程化原理",三章:技术筹备、建设要点、安全策略。说实话,这部分是我最期待、也最失望的部分。
先说它做对的地方。第 15 章讲安全,列的几条我认为都踩在点上:代码审计与自动化测试(用静态分析查缓冲区溢出、SQL 注入,用动态分析查运行时异常)、系统配置与权限管理(最小权限原则、安全硬化)、监控告警方案(图 15.8 拆成数据收集、异常监控、告警机制、自动化响应四段)。这几条放在大模型项目里都对——尤其是最小权限,因为 Agent 最危险的地方就在于它拿着一个权限过大的连接去执行自动生成的 SQL。
再说问题。第 14 章给的代码示例,我读了两段,深度不够。
一段是"访问控制代理",书里的定义是:
访问控制代理是对访问资源(如数据库)行为进行控制的一种设计模式。访问控制代理可以在访问资源之前进行额外的操作,如权限检查、日志记录和缓存等。
概念没问题。但落到代码清单 14.3,实现方式是"在 Python 中用装饰器(Decorators)在函数调用前进行访问控制校验",文件路径是 src/Utility/unscape_helper.py。
这就是一段标准的 Python 装饰器教学。它演示的是"怎么用 @wraps 写一个包装函数",不是"怎么治理一个会自己生成 SQL 的 Agent 的权限"。真正的难点在于:Agent 生成的 SQL 是运行时才有的,你要在拿到 SQL 之后、执行之前做解析和拦截——判它读了哪几张表、有没有 DML、有没有全表扫描、会不会把用户表整表导出。这些是 SQL 解析层面的活,一个装饰器解决不了。
另一段是那个 explain 方法,逻辑是拿到 query 后 cursor.execute("EXPLAIN {query}"),成功返回 {"code":0,"errmsg":"success"}。这段代码的问题不在写法,在它的错误处理把 explain 的失败和查询的失败混成了一个 code。对一个要给大模型当工具的组件来说,错误信息必须是结构化的、能回喂给模型让它自己改的,一句 errmsg 是不够的。
我说这些不是在挑刺。我的意思是:这本书定位是"工程化",那么它对"工程"这部分的要求就应该比对"原理"更高。而实际上它的原理部分(第 9–11 章)扎实,工程部分(第 13–15 章)偏薄。这个失衡很明显。
七、它的短板
该说的好话我说完了。现在说这本书的问题,一共五条,按严重程度排。
第一,也是最大的问题:它几乎不可复现。整本书的核心技术栈是 DeltaLH——腾讯自研的湖仓一体引擎,存储计算分离、数据冷热分层、湖仓一体化,这些能力都长在这个引擎上。你能读到它的设计思路,但你下载不到它。同理,落地场景全是游戏,案例里的表名是玩家、角色、付费,指标是 DAU 和收入。一个做电商或者做金融的读者,把"玩家活跃"换成"用户下单"之后,会发现能迁移的只有方法论,所有具体参数都要重推。
第二,全书的量化结果接近于零。这是我最不能接受的一点。它提了"需求质量达标率",提了"物化视图推荐",提了"成本模型训练",但没有任何一处给出"改造前 vs 改造后"的对照数据:准确率从多少到多少、查询延迟降了多少、人力省了多少。一本工程书最硬的通货就是数字,而这本书在最该给数字的地方全部留白。没有基线的指标体系,和没有指标体系,区别不大。
第三,目录结构混乱到影响使用。全书混用"部分"和"章"两级,而且大量小节直接以 1.3.1、2.2.1、3.1.1 这类编号挂在"第 1 部分"下面,头上没有章标题。你翻目录时会看到"第 1 部分 大模型技术的发展与应用"下面直接是"1.1 大模型的发展历程",再往下跳到"第 2 章 大模型与数据体系"——第一部分的第 1 章标题在整个目录里是缺位的。全书 157 条目录项,这种断层反复出现。作为一本要当手册翻的书,这是硬伤。
第四,"大模型"含量不足,且有凑章嫌疑。前面已经说过,前八章是数据中台的存量知识。更具体地说,第 1 章讲大模型发展历程和市场规模,这部分内容的半衰期极短——书里引用的市场规模数字,两年后基本作废。把它放在开篇,等于让全书的时效性被最快过期的部分绑架。
第五,安全章节没有正面回答 Agent 特有的风险。第 15 章讲的代码审计、最小权限、监控告警,都是通用安全实践,搬到任何一个后端系统上都成立。而 Agent 真正的风险是新的:提示词注入导致工具被滥用、模型幻觉生成合法但错误的查询、多轮上下文里权限被逐步放大。这三样书里都没有专门讨论。用通用安全框架回答新问题,形式上完整,实质上缺席。
八、这本书该给谁看
我的建议分三种人。
如果你在做 RAG 或者 Text2SQL,并且已经卡住了——买。这本书第 4 到第 7 章讲的东西,正好是你卡住的地方。你会发现模型不是瓶颈,资产组织才是。尤其"需求资产"那一套,市面上讲得这么细的书不多。
如果你是数据平台的负责人——买,但要带着怀疑读。它的三段式框架可以直接拿去改你们的资产管理制度,但所有指标都要自己重定基线,别照抄。
如果你想学怎么搭 Agent、怎么调提示词、怎么选框架——别买。这本书基本不涉及这些,你会觉得被骗。
最后说一句我读这本书最大的收获。它让我把一个问题重新想了一遍:为什么大模型落地这么难?
流行的答案是"模型还不够强"。这本书给的答案是另一个:因为大部分公司的数据,从来没有为"被追问"而组织过。报表系统是为"定期出数"设计的,数仓分层是为"稳定复用"设计的,两者都假设提问的人是懂口径的专家。而大模型带来的是不懂口径、随时追问、还会追问三次的提问者。这个变化不是模型侧能解决的,只能回到数据侧重做一遍。
这个判断我认。它比"再等等更强的模型"要诚实得多,也要难得多。
一句话收尾:它把一个不性感的问题摆到了台面上——大模型的天花板,是十年前那套没人愿意重做的数据建模。
阅读记录:《大模型工程化:AI驱动下的数据体系》,戴诗峰、谢思发、李飞宏 等著(腾讯游戏数据团队),微信读书逐页翻阅 488 屏,全书 6 部分、157 条目录项。重点核对了 ODS/DWD/DWS 分层定义(图 2.6)、Hadoop 架构说明(图 3.3)、4.3 重塑数据资产思路与图 4.8 三段式、表 8.1 句子表征模型演进(2014 PV → 2019 Sentence-BERT)、图 10.15 意图召回四模块、代码清单 14.3 访问控制代理与 explain 实现、15.2.4 监控告警方案(图 15.8)、图 16.18 与 16.19 数据包生成 SQL 示例。2026-11-03。
发表评论: