
AI Agent开发实战:能跑通不等于能上线
微信读书《AI Agent开发实战:从基础原理到企业级应用》· 郑天民 著
逐页翻阅 463 屏 · 8 章 3 篇 · 2026-11-03
说明:这本书写得比我预期的实。它不是那种"讲完概念贴一段伪代码"的书,案例代码托管在 GitHub 上,我按它的路径核过几段,能看出是跑过的东西。但"能跑通"和"能上线"之间差着一段距离,这本书恰好在那个距离上停住了脚。下面我说清楚它哪三章值得逐字读,以及为什么第 6 章的名字叫"企业级"而内容其实还在演示层。
先给结论:这是一本合格的实战书,但它最大的价值不在教你写 Agent,而在教你"怎么判断一个 Agent 该被拆成什么样"。
2024 年之后,讲 Agent 的书多得像雨后春笋,绝大多数死在同一个地方:把"调用一个工具"写成了"智能体",然后花两百页讲提示词。这本书没有走这条捷径,它从第 1 章就把 Agent 定义成一个"开发模式"而不是一个"产品形态",这个起手式决定了后面八章不会有太多水。
一、骨架很清楚:基础、实现、应用三段
全书三篇八章,结构几乎是教科书式的整齐:
基础篇两章——第 1 章讲 Agent 的开发模式,第 2 章讲 LLM 和 Agent 的关系。实现篇三章——通用型、知识型、多模态,正好对应"会动手""会查资料""会看会听"三种能力。应用篇三章——企业级工程化、多 Agent 系统、多 Agent 实战案例。
这个三段划分的好处是:你在任何一个阶段卡住,都能定位到具体一章。做不出工具调用看第 3 章,检索答不准看第 4 章,语音和图像串不起来看第 5 章。一本技术书能做到"当手册查",已经及格了。
但它的划分也暴露了一个问题。三篇的关系是"能力递进",而工程实践里这三件事是同时发生的——你不可能先做完通用型 Agent,再去做知识型。真实的项目里,第一天就要同时面对工具、检索和模态。所以这本书适合"学",不太适合"照着搭"。
二、1.5.4 那一节,做了件很少见的事:正面比较
全书我认为最值钱的一段在第 1 章 1.5.4"多 Agent 框架"。这一节它把 LangGraph、LlamaIndex、AutoGen、CrewAI 摆在一起比。市面上的书要么只讲一个框架(通常是自己的偏好),要么各讲一遍互不相干,肯做横向比较的不多。
它的比较落在一个很具体的点上:同一件事,两个框架分别怎么组织。原文的说法是,LlamaIndex 的工作流里定义了一个附加步骤 prepare_agent,负责把用户输入转成 ChatMessage 格式并存进历史,而 LangGraph 里同样的目的,是用"位于图结构之外的 run_agent 方法"实现的。书里还直接说了句"你可以对此进行简单的对比"。
这个细节很小,但它指出的差别很大。LangGraph 是"图即程序"——所有流程都要被画进节点和边里,图外的东西在框架视野之外;LlamaIndex 是"步骤即对象"——每一步都是一个可命名的独立单元,可以在任意位置被插入。前者约束强、可视化好、适合审计;后者灵活、适合快速拼装、但流程容易散。
我的判断:这个差别在生产环境里会放大成两种完全不同的维护成本。用 LangGraph,你六个月后回来看那个图,能说出每一步在干什么;用 LlamaIndex,你六个月后回来看代码,可能得从头读一遍才知道流程长什么样。而反过来,当产品经理说"在第三步和第四步之间加一个校验"时,LlamaIndex 是加一行,LangGraph 是改边、改节点、可能还要改状态结构。
书里没有把话说到这个份上,它只给了事实,判断留给读者。这既是克制,也是遗憾——一本实战书最该给的恰恰是这种"我会怎么选"的判断,而不是把选项列清楚就走。
三、三种形态的分水岭:工具、知识、模态
第 3、4、5 章是全书的主体。三章分别对应 Agent 的三类外部世界接口,我认为这个划分比"按框架分"高明得多,因为框架会换,接口不会。
第 3 章通用型,核心是工具调用。它给的例子是 ReAct 那套经典组合:定义 code_interpreter 工具,内部用 PythonREPLTool 执行代码,再把结果返回。代码清单的写法是先 @tool 装饰,再 create_react_agent 组装,最后 AgentExecutor 加 invoke 执行。
这段代码本身没什么稀奇,稀奇的是它对 PythonREPLTool 的解释。书里说这是一个"工具类",用于执行 Python 代码,"它允许将 Python 代码作为输入,并返回执行结果"。
我要在这里说一句可能不太好听的话:让模型执行任意 Python 代码,是这一整类书里最被轻描淡写的高危操作。书里把它写成"借助 PythonREPLTool,我们定义了一个可以执行 Python 命令的工具组件",语气轻松得像在介绍一个计算器。但在真实部署里,这个工具等于把你的运行环境交给了一个会幻觉的东西。它可能删文件、可能发起网络请求、可能读环境变量——书里没有讨论沙箱、没有讨论超时、没有讨论资源限制。
这不是这本书独有的问题,但它是所有"实战书"都该补的一课:给 Agent 开一个执行通道,等于给它开一个攻击面。代码示例可以简单,风险提示不能省略。
顺带说一句它对提示词的交代。ReAct Agent 用的那段提示词不是手写的,书里明确说可以从 LangChain Hub 获取,并且"开发人员也可以对这些提示词进行修改,从而满足自身的开发需求"。
这一点其实挺重要,因为很多人以为 ReAct 得自己从头写一大段思维链。实际上是框架内置了一套调优过的提示模板,你拿到的默认版本已经是别人调过的。这解释了一个常见困惑:为什么照着论文自己写 ReAct,效果总不如框架里带的好——因为框架替你承担了提示词工程,论文里那套写法是给论文的实验环境用的。但书里也只说了"可以修改",没说"改之前要先固定评测集,否则你无法判断改动是变好还是变坏"。这句话如果写进去,这一节的价值还要高一档。
第 4 章知识型,核心是检索。这一章的写法比较规矩,讲文档切片、向量化、召回、拼上下文。我没有看到什么特别新的东西,但它的顺序是对的:先讲"知识从哪来",再讲"怎么切",最后讲"怎么拼"。很多书反过来,先讲向量库怎么选,读到一半你不知道自己在优化什么。
但这一章也漏了知识型 Agent 最要命的一环:答不出来的能力。检索系统最危险的失败不是"没找到",是"找到了一条半相关的东西,然后模型很自信地拿它编了一个答案"。用户看到的是流畅的段落,看不到底下那条勉强及格的召回结果。书里把 RAG 的链路讲全了,却没有给"置信度不够时如何拒答"留一节。
这不是吹毛求疵。企业场景里,一个会说"这个我不知道"的 Agent 可以上线,一个从不承认自己不知道的 Agent 不能上线——因为前者的错误是可控的,后者的错误会被当成事实传下去。
第 5 章多模态,是全书技术上最费劲的一章,也是最容易被低估的一章。我下面单独说。
四、多模态那一章,真正的难点不是模型,是消息类型
这一章讲的是图片和语音怎么进 Agent。我原本以为重点会是"用哪个多模态模型",结果它把大量篇幅花在了一个更底层的问题上:聊天历史该怎么重组。
原文说得很细:
这里出现了两组 HumanMessage 和 AIMessage 聊天消息。……而 LLM 的另一类消息是 SystemMessage,专门用于定义有关 LLM 在此对话中的角色、应该执行什么样的行为、以何种风格回答等指示。显然,当我们调用 process_with_images 方法时,传入的 message_content 字段应该是一个 SystemMessage(系统消息)。为此,我们需要将聊天历史记录转换为一个具有系统消息含义的字符串。
这段话翻译成人话是:多模态接口不认你原来的对话结构,你得把历史压成一段文字,塞进系统消息里。然后代码清单 5-23 给了一个例子,history 被拼成 {'chat_history': [...], 'input': '图中描述了上海的哪些标志性建筑?'} 这样的结构。
我看到这里的时候停了一下。因为这件事的后果比书里写的大得多。
你一旦把历史压成一段字符串塞进系统消息,就同时丢掉了三样东西:轮次边界、消息角色、可裁剪性。轮次边界丢了,模型分不清哪句是用户说的、哪句是它自己说的;角色丢了,它就分不清"用户在提问"和"用户在引用一段别人说的话";可裁剪性丢了,上下文超长时你没法按轮次丢弃旧消息,只能截断字符串——而截断字符串很容易把一句关键约束切掉一半。
这是个典型的工程折衷:接口不支持,你就得自己造一层适配,而这一层适配的成本会以"莫名其妙的答非所问"的形式,在三个月后回来找你。书里把这一步如实写出来了,但没有提醒读者这一步有代价。这是我觉得它最可惜的地方——它明明已经站在了那个坑边上,却没有说"这里有坑"。
语音部分相对扎实。代码清单 6-21 用 input_from_mic 收麦,audio_recorder 里设了 pause_threshold=3.0、icon_size、recording_color 这些参数,收上来的音频存进 Streamlit 的 session_state,再用 read_audio 转成文本,与 LLM 交互。后面还有 perform_tts 做文本转语音。
这条链路是通的,而且有个细节值得夸:它把音频字节存在 session_state.audio_bytes 里,而不是存转写后的文本。这个选择是对的——存原始音频,你后面才能重跑识别、换模型、做质检;存文本,一旦识别错了就再也回不去了。很多教程图省事存文本,等到要排查"为什么它答错了"的时候,才发现证据已经没了。
五、企业级那章:名字和内容之间有一段距离
图文对照:全书的知识骨架
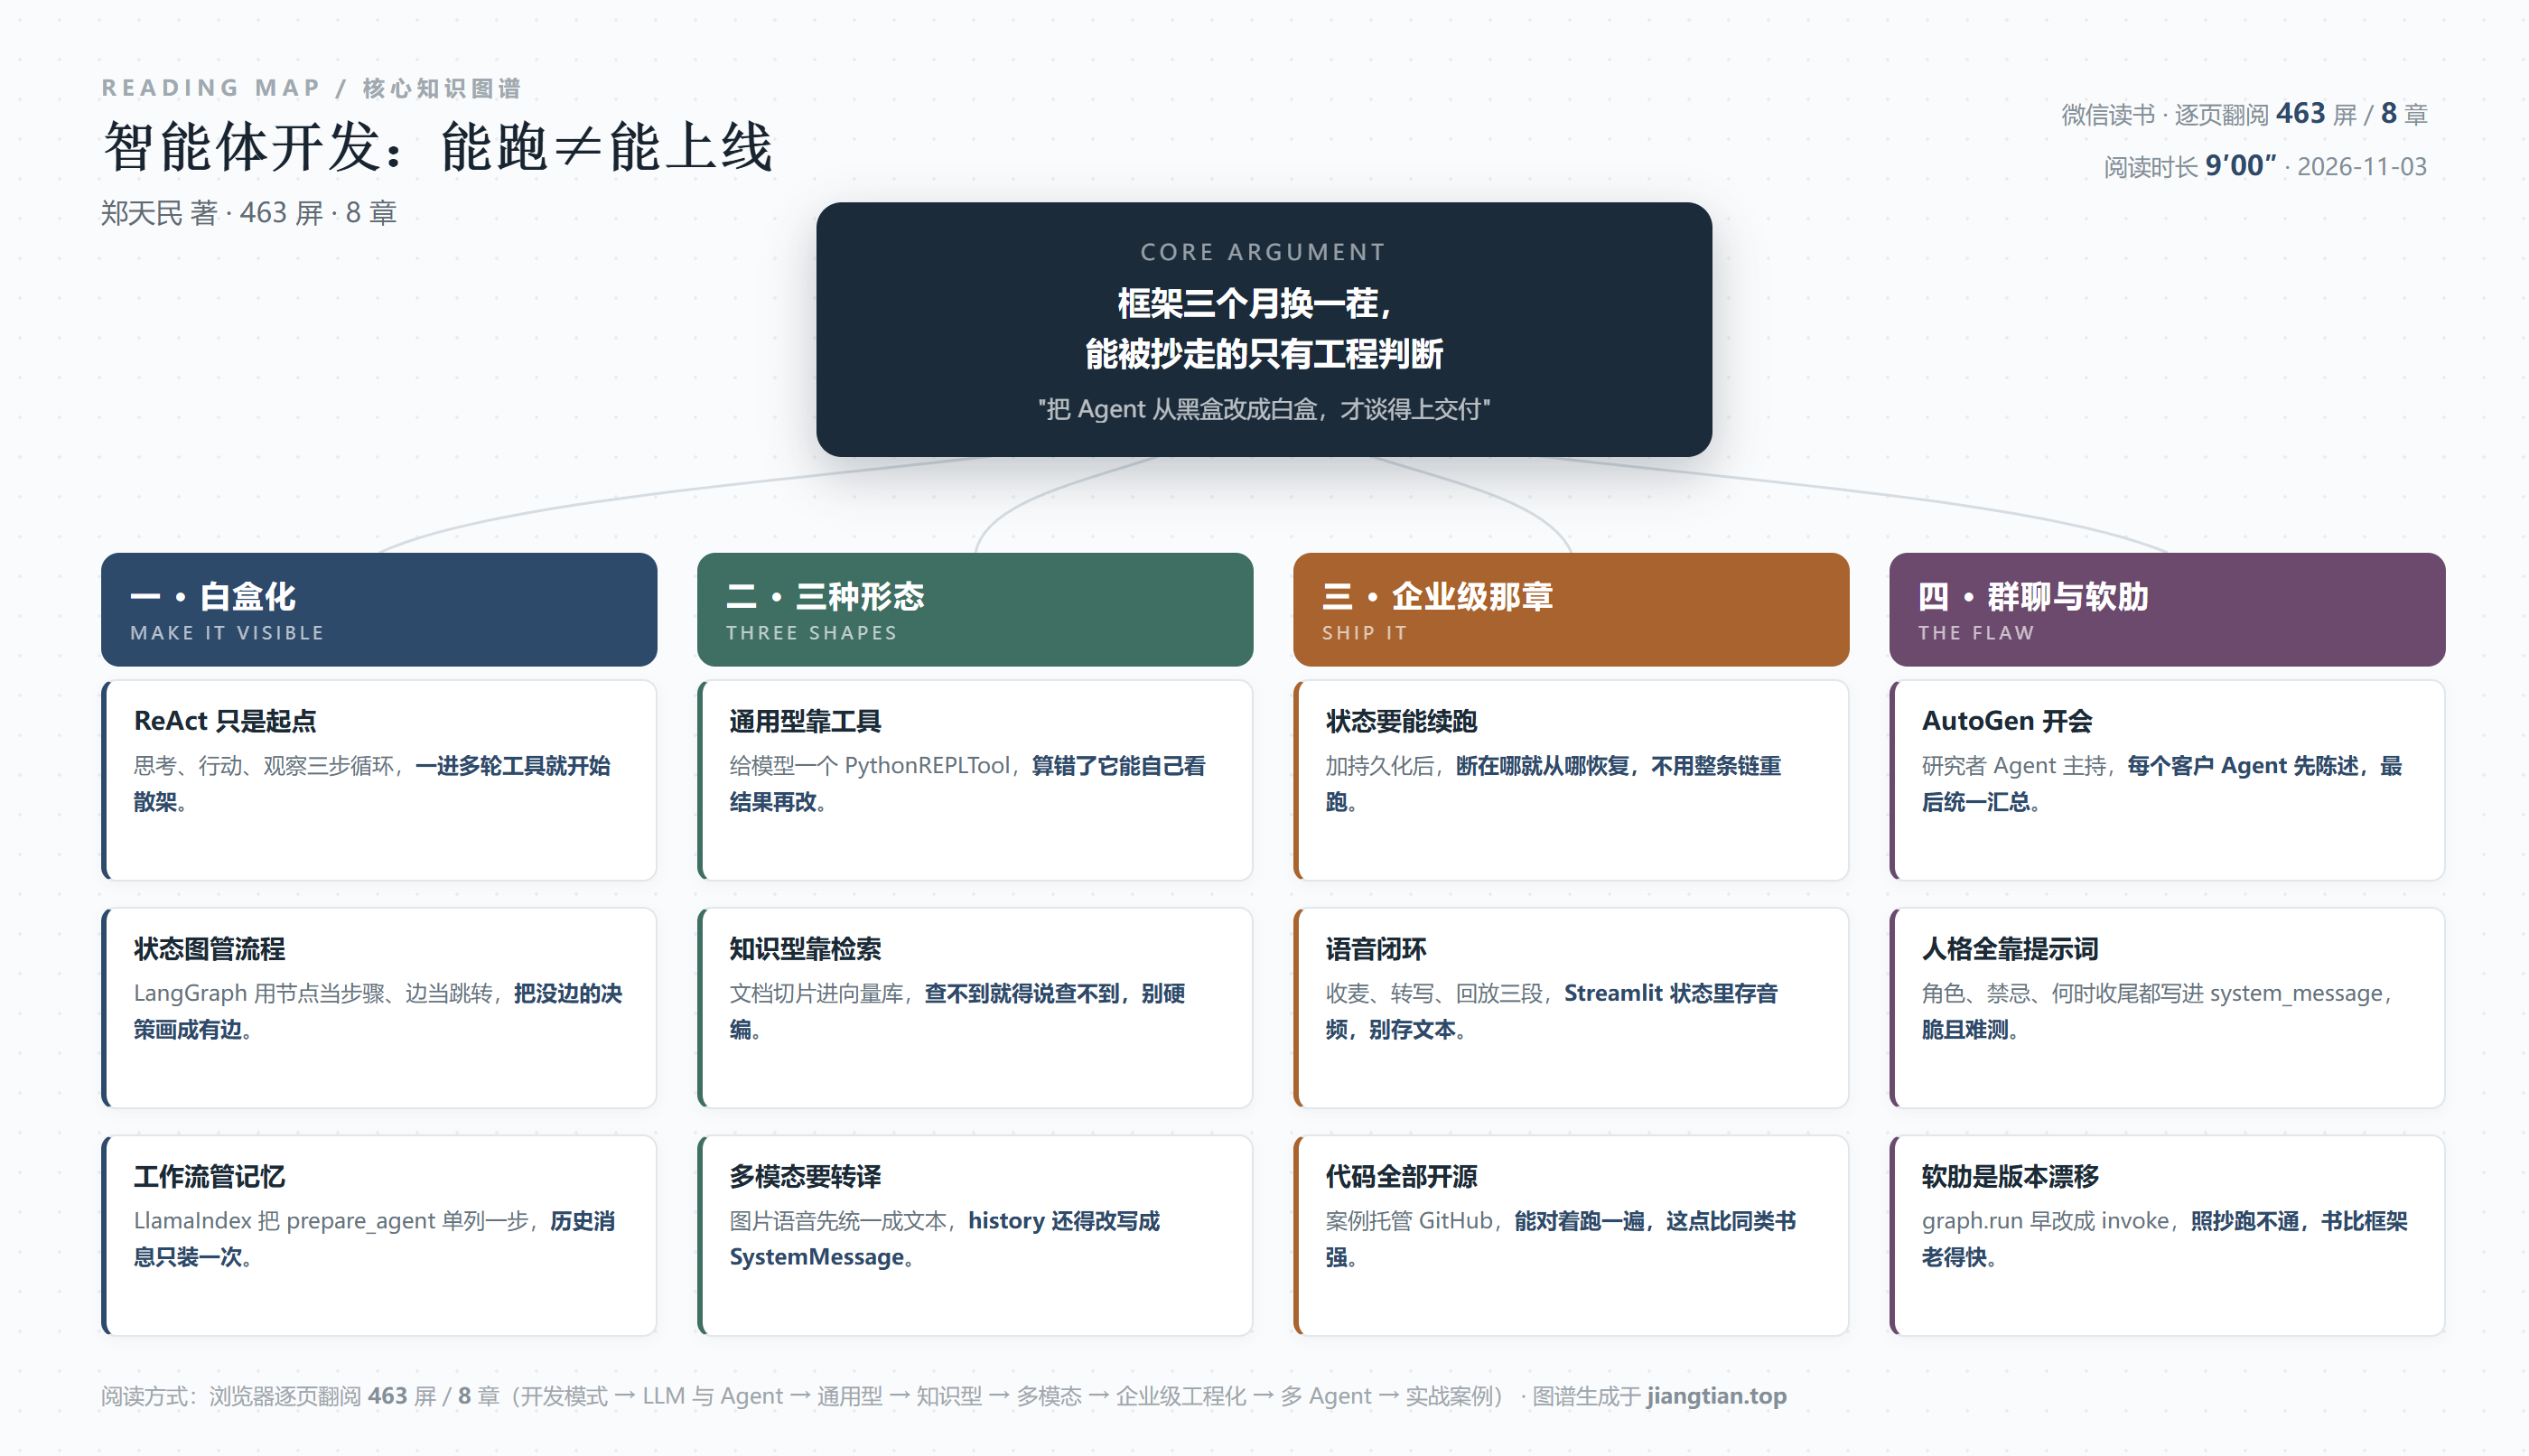
第 6 章标题叫"企业级 Agent 工程化技术"。我抱着很大期待翻进去,读完之后的判断是:它讲的是"能演示的工程化",不是"能运维的工程化"。
它做对的地方有两处。
第一处是持久化。代码清单 8-11 给了一个 LangGraph 的持久化方案,思路是定义 save_state 和 load_state 两个函数,把图的状态序列化成 json 落到本地文件,跑之前先 load。书里的表述是"可以将状态保存到本地文件或数据库中"。
这个思路是对的:Agent 长流程最怕的就是中途挂了要重跑,因为重跑意味着重新烧一遍 token、重新调一遍工具、可能还会重复触发副作用。有状态检查点,才能做到"断在哪从哪续"。这个能力在产品化阶段是刚需,不是优化项。
但代码本身有个问题,我必须指出来。那段代码用的是 graph.run((), save_state=True),而 LangGraph 现在的写法是先 compile,再用 invoke,状态持久化靠的是 checkpointer 参数,不是 save_state=True 这个开关。也就是说,这段代码如果照抄,第一步就会报错——graph.run 早就改名了,save_state 这个参数也从来没有过。
这可能只是排版或版本记录的问题,也可能是作者写书时用的是内部封装。但后果是一样的:读者照着敲,敲不通,然后开始怀疑自己。一本实战书的代码不能跑,是硬伤,比观点错误更伤,因为读者买它就是为了跑通。
第二处做对的地方是它对"断点"这件事的重视。虽然实现方式过时,但它至少意识到"Agent 是有状态的、会中断的、需要恢复的"。绝大多数讲 Agent 的文章把 Agent 当成一个无状态的函数调用,这个认知偏差会导致系统设计从一开始就错。
它没做到的地方更多。可观测性、成本控制、并发、评估,这四件事一样都没讲。而这四件事恰恰是"企业级"三个字真正的门槛:
可观测性——一个跑了十二步的 Agent 失败了,你怎么知道败在第几步、当时的上下文是什么、模型看到了什么?没有 trace,你只能靠猜。
成本控制——多 Agent 群聊的 token 消耗是单 Agent 的数倍,一次失败的会话可能烧掉几十块钱。没有预算上限和熔断,一次流量高峰就能烧掉一个月预算。
并发——Streamlit 那套写法在单用户演示时毫无问题,一旦十个人同时用,session_state 和全局变量就开始互相污染。
评估——你怎么知道改了提示词之后是变好了还是变坏了?没有评测集,所有改动都是玄学。
这四样缺失,让第 6 章的"企业级"变成了一个形容词。它不是作者不用心,是这类书的通病:写"能跑起来"容易,写"跑一年不出事"难,而后者才是工程。
六、多 Agent:AutoGen 群聊里的组织学
第 7、8 章讲多 Agent,这是全书最有意思的部分,因为它处理的其实不是技术问题,是组织问题。
案例是客户洞察:多个客户 Agent 各自陈述,由一个研究者 Agent 主持和汇总,最后生成统一的分析。这个结构非常像真实的用户访谈——先分别问,再交叉问,最后主持人收口。书里说得很明确,要把各个 Agent 的输入"进行聚合,提交给一个汇总 Agent 进行统一分析,生成最终的客户洞察内容"。
代码清单 7-35 是研究者 Agent 的定义。这段 system_message 写得相当长,我抄一段:
你是一位拥有心理学博士学位的顶尖产品研究员,过去 20 年在顶级创意、媒体和商业咨询公司从事研究和观察工作。你的角色负责向个体客户提问并收集洞察内容。设计问题以揭示客户的偏好、挑战和反馈。在开始任务之前,分辨小组成员名单和发言顺序,避免成员之间相互交谈并产生认知偏见。在会议结束后,请在清晰简洁的笔记中提供对研究结果的总结,而不是在开始时进行总结。
这段提示词写得很好,好到能看出作者真的做过用户研究。"避免成员之间相互交谈并产生认知偏见"——这是个非常内行的要求,因为焦点小组最大的失真就来自从众效应,一个人说了"我觉得挺好看",后面三个都会往这个方向靠。把这条写进 prompt,说明作者知道自己在解决什么。
但恰恰是这段好提示词,暴露了这本书最深的方法论问题:它把所有的行为约束都押在了提示词上。
发言顺序靠 prompt 保证,不交谈靠 prompt 保证,最后总结靠 prompt 保证,连"什么时候结束"都靠 termination_msg 里那个判断函数保证——书里的写法是检测消息里有没有 "TERMINATE" 这个字符串。
这套机制在生产里有多脆,试过的人都知道。模型今天愿意遵守,明天版本更新就不一定了;它遵守了八轮,第九轮可能就忘了;它在简单任务上遵守,任务一复杂就开始自作主张。而提示词没有强制力,你不能对一段自然语言说"你必须"。
还有一个成本问题,书里没有提。多 Agent 群聊的 token 消耗不是线性增长的——每一轮里,每个 Agent 都要读一遍全部历史。四个人聊十轮,读的量是单 Agent 的几十倍。而"一直聊到有人说 TERMINATE"这种终止条件,意味着最长轮次没有硬上限。演示时聊五轮很优雅,生产里聊到三十轮就是账单事故。
真正稳的做法是把约束外置成结构:发言顺序由编排层轮转决定,不让模型自己选;Agent 之间禁止直连,所有消息必须经过主持者中转;结束条件由代码判断而不是由模型输出一个标记词。这些在 AutoGen 里都能做,但书里选了最省事的那种写法——把所有规则写进 system_message。
我理解为什么这么写:省事、直观、演示效果好。但这本书叫"实战",实战里最不该做的就是"把可靠性押在提示词上"。
七、它的短板
按严重程度排,四条。
第一,代码与框架版本的漂移,是这本书最致命的短板。graph.run 改名、save_state 参数不存在,这不是笔误级别的问题,是"照抄跑不通"级别的问题。而 Agent 领域的框架平均三个月一次破坏性更新,一本书从写作到上架要一年,等读者拿到手,书里的代码已经落后了一个大版本。这不是作者一个人的困境,是整个技术书品类的困境。但解法是有的:把代码全部放 GitHub 并持续维护,在书里明确标注版本号和最后验证日期。这本书做到了前半(代码确实开源了,地址写在序言里),没做到后半(我没有在书里看到任何一处标注"本代码在 X 版本验证")。
第二,"企业级"名不副实。第 6 章的实际内容是语音交互、Streamlit 界面、状态持久化,这三样加起来是"一个能演示的原型",不是"一个能上线的系统"。可观测性、成本、并发、评估四件事全部缺席。这个落差不是细节问题,是承诺问题——读者冲着"企业级"三个字买,拿到的却是"能跑起来"。
第三,安全几乎不谈。让模型执行任意 Python 代码(PythonREPLTool),书里一句风险提示都没有。多 Agent 之间互相传消息、消息内容可能被注入,也没有讨论。这不是苛求——一本教人搭系统的书,至少该有一节讲"哪些操作必须放进沙箱"。
第四,缺少"失败案例"。八章下来,每一个案例都是成功的:工具调用成功、检索召回成功、多 Agent 协作成功。但实战里 80% 的时间在调试失败——工具调错了、检索召回了错的文档、多 Agent 陷入无限对话。这些才是读者真正会遇到的,书里几乎没有。一本实战书的价值,某种程度上等于它写了多少失败。
八、怎么用这本书
我的建议很具体。
把它当"框架选型的参考书",值。1.5.4 那一节的横向比较,加上第 3 到 5 章按能力形态的划分,能帮你想清楚"我这个场景该用什么结构"。这部分不依赖版本,三五年后还有效。
把它当"代码模板",要小心。照抄之前先对一遍你装的框架版本,尤其是 LangGraph 相关的部分,改名和接口变更最多。把它当"思路模板"而不是"代码模板",风险小很多。
别指望它教你上线。可观测性、成本、评估这三块,得另找材料。这本书的终点是"跑通一个 Demo",起点是"知道 Agent 是什么"。
最后说一个我读完之后想得比较久的点。
这本书的方法论其实很朴素:把 Agent 从黑盒改成白盒。ReAct 的思考—行动—观察是个黑盒循环,你看不见它下一步要干什么;LangGraph 的状态图把它画成节点和边,你就能看见;AutoGen 的群聊是另一种黑盒,主持人 Agent 把它收口成结构化的输出。
这条线贯穿全书,而且我认为它是对的。因为所有能被工程化的东西,前提都是能被观察;所有不能被观察的东西,只能靠信仰。Agent 现在最大的问题不是不够聪明,是太不透明——它答对了你不知道为什么对,答错了你也不知道错在哪。这本书从头到尾在做的事,就是把这份不透明一点点削薄。
它没削完,但它削的方向是对的。
一句话收尾:它教会你怎么让 Agent 跑起来,但没教会你怎么让它跑得住——而后者才是"实战"两个字的全部重量。
阅读记录:《AI Agent开发实战:从基础原理到企业级应用》,郑天民 著,2025 年 7 月于杭州钱江世纪城,微信读书逐页翻阅 463 屏,全书 8 章分基础、实现、应用三篇。重点核对了 1.5.4 多 Agent 框架横向比较(LangGraph 的 run_agent 与 LlamaIndex 的 prepare_agent)、ReAct 与 PythonREPLTool 代码清单、代码清单 5-23 聊天历史合并与 SystemMessage 改造、代码清单 6-21 基于 input_from_mic 的语音采集、代码清单 7-35 研究者 Agent 定义、代码清单 8-11 LangGraph 持久化。案例代码见作者 GitHub 仓库 tianminzheng/agent-application-development。2026-11-03。
发表评论: