
AI未来进行式:它敢写 2042,却不敢写 2028
微信读书《AI 未来进行式(豆包的情感陪伴、机器人的情绪价值、宇树科技……AI 未来全部预言)》· 微信读书网页版逐页翻阅
670 屏,10 个故事,每个故事后面接「开复导读 + 开复解读 + 技术科普」· 2026-11-04
说明:这本书是李开复与科幻作家陈楸帆合著,正文落款「2022 年 上海」,十个故事都设定在 2042 年。我逐页核对的位置:P0006(自动驾驶插图与"存储成本降到一千五百万分之一、算力提升万亿倍")、P0020(序的收尾与 2042 的设定)、P0055(深度学习与"千人之千面")、P0230(陈楠夜闯医院)、P0420("瓦肯 7"实验室)、P0470(量子计算与费曼那句话)、P0535("UBI 会是一剂良方吗")、P0605(对 GDPR 的批评)、P0630("被偷走的一代")。这是抽样核对,不是通读全书每一屏;凡引用都出自上述页面,凡判断都是我的。
先说结论:这本书的十个故事写得比它的解读好,而它的解读里,凡涉及"技术会怎样",判断都稳;凡涉及"社会该怎样",判断就急。
它自己在序里把标准立好了——"科幻小说的最大价值并不是给出答案,而是提出问题"。这句话拿来评价这本书,一半准确:问题它提得相当好,答案它给得太快,而且给答案的地方往往只有一两段,前面没有论证,后面没有代价。
下面我先说它做对的那一半,再说它急着下判断的那几处。
一、它做对的那一半:把技术写成"一天"
P0230 是我在整本书里读得最慢的一页。陈楸帆写陈楠半夜去医院看病人,一路上的关卡是这么过的:地面上的发光箭头把人导到发热通道,"避免因聚集而导致的传染";第二道关口要扫数字健康档案,靠生物感应贴膜或 smartstream,与云端的记录做比对;然后是扫描仪,"镜头闪烁红蓝两色指示灯,自动闸门打开了一道缝,又颤颤巍巍地合上,又打开。轴承吱呀乱响,就像机器也会关节炎发作一样"。
后面那句是全书最好的一处细节。它不是修辞,是一个判据:一个系统用久了会磨损,磨损以"偶发卡顿"的形式表现,而偶发卡顿在关键流程里就是漏洞。陈楠就是趁那一下挤进去的。
所有关于"AI 接管基础设施"的乐观叙事,都跳过了磨损这一层。它们写的是"系统会自动识别、自动放行",写的是设计状态;而真实世界里的系统永远处在维护状态——传感器会脏、模型会漂、备件会缺。把一个人挡在门外的不是算法错了,是轴承响了。这种细节,只有写小说的人愿意写,因为它对论证没有用,对真实有用。
P0420 那间实验室是另一处。作者给它起名叫"瓦肯 7",理由是"这里的每一个人都像电影《星际迷航》里的瓦肯人一样,高度崇尚理性与逻辑。一切缺乏证据的猜测都会被嗤之以鼻,被斥为科幻小说般的狂想"。
我读这句时停顿了很久。这是一次自嘲:一本用小说预测未来的书,把"缺乏证据的猜测"判为狂想,等于把自己的方法判了刑。但它同时是一次自警——一个只认证据的组织,恰恰会错过那些还没有证据的早期信号。而所有真正的风险,在早期都没有证据。
这本书把这两种东西放在同一页上,说明作者知道自己在做什么。这是它比一般"AI 科普"高明的地方:它不假装技术在真空里运行,它知道技术落地要经过医院走廊、闸机、备用电源和一群疲惫的人。
二、解读里的硬数字:算力涨了一万亿倍,存储降了一千五百万分之一
P0006 给了两个数字,用来解释"深度学习为什么是现在":
深度学习是一种能够基于海量数据完成自主学习的软件技术。其实,这项技术在多年前就已经出现了,但近几年,在大数据和大算力的条件逐步成熟的情况下,深度学习才得以发挥出排山倒海的威力。数字时代发展迅猛,与近 40 年前我刚踏入 AI 领域时相比,如今我们的数据存储成本仅为当时的一千五百万分之一,拥有的算力提升了万亿倍。
P0055 把这个判断补全了:深度学习"最初灵感来源于人类的大脑",落地方式是"千人之千面"——淘宝首页按你的浏览痕迹加相似用户的痕迹推荐商品,抖音按停留时长决定下一条放什么,"同一个内容,可能在你眼里根本一文不值,但我会觉得很有价值"。
这两页合起来,是这本书最扎实的部分:它没有把深度学习的成功说成"智能的胜利",而是说成"算力和数据的胜利"。这个说法在 2022 年是清醒的,到今天也没过时。
但这两个数字很容易被误读,我得把话说清楚。
它们解释的是"过去为什么能成",不是"未来会怎样"。万亿倍是四十年积累的结果,不是年化复利的承诺;一千五百万分之一的成本下降,来自存储介质的代际更替,不是每年都会发生的事情。读者很容易顺着这两个数字往下推:"再等二十年,算力再涨万亿倍,所以 2042 年的故事都会实现。"这个推论是错的——因为约束早就换了。今天卡住大模型的不是算力单价,是电力、是高质量语料、是许可和责任归属。算力曲线再陡,也绕不过这三样。
书里其实给了一条更可靠的判断方式,只是它自己没强调。P0470 讲量子计算时,作者没有预测"哪一年能通用",而是预测"先落在哪个领域":模拟分子结构、做药物研发。理由是费曼那句话——"如果你想模拟大自然,你最好让它以量子的方式运行"。
我认为这是全书写得最专业的一条,因为它只承诺顺序,不承诺时间。量子系统的状态空间随粒子数指数增长,经典计算机模拟分子轨道的成本会爆炸,这是原理上的硬约束,不依赖任何工程进度。所以"它先用在必须精确模拟量子系统的地方"这个判断,几乎不会错;而"它在 2042 年能通用"这个判断,谁都可能错。
预测顺序比预测时间可靠得多。这是这本书应该多用、却用得最少的一种写法。十个故事全都在预测时间(2042),只有这一节在预测顺序。
三、"UBI 会是一剂良方吗":这一节自己拆了自己的台
P0535 的标题就是这个问题。它前半段的事实层写得很清楚:
根据 UBI 计划的理念,政府为每个公民提供标准津贴,这种津贴的发放并不考虑公民个体的需求、就业状况或职业技能水平,其资金来自对超级企业、超级富豪的征税。
在 2020 年美国总统大选前,候选人之一杨安泽提出了一种名为「自由红利」的 UBI 的变体政策作为自己竞选的理论基石,并把它视为对抗 AI 和自动化浪潮的一剂良方。
然后作者表态:
我认为,人类必须想办法缩小不断扩大的贫富差距,在这个过程中,UBI 未尝不是一种虽然简单但行之有效的机制。不过,UBI 的无条件分发原则,也会带来财政分配过于「随意」以及浪费公共资源的风险,对此有些提议指出,应该在 UBI 的基础上附加发放的条件,或者将公民个体的需求考虑在内,这将直接提升 UBI 计划的实施效果。
这段话把 UBI 拆了。
UBI 的定义性特征就是"无条件"——不问收入、不问就业、不问技能,作者自己前一页刚写完这一点。它的全部优点都建立在这三个"不问"上:行政成本极低(不需要一套审核机构去判断谁够条件)、没有污名(不需要向人证明自己惨)、没有悬崖效应(多挣一块钱不会突然失去资格)。这三样不是附加好处,它们就是 UBI 之所以被单独拿出来讨论的理由。
一旦"附加发放条件",你就必须回答:谁来判断这个条件满足了没有?答案只能是一个审核机构。于是行政成本回来了,污名回来了,"漏发"和"错发"这两个老问题也回来了——而这两个问题恰恰是现行福利制度最被诟病的地方。
更关键的是作者给的理由:"浪费公共资源"。"浪费"这个判断需要一个标准,而标准需要一个判断者。如果判断者是审核机构,那你就回到了 UBI 想取代的那套东西;如果判断者是市场,那就不叫 UBI 了。他想要 UBI 的名字,不想要 UBI 的代价。
同一章后面讲"如何化解 AI 时代的人类工作危机"时,作者回到"授人以渔"。这四个字单独看没问题,但它和 UBI 不是一回事,也不能互相替代。UBI 解决的是"这个月怎么活",培训解决的是"明年怎么活"。前者不能等——一个人断粮等不到明年;后者不能省——只发钱不给出路,三五年后还是同一个问题。用后者去否定前者的"无条件",等于要求一个失业的人在断粮之前先学会新技能。这个要求听起来励志,做起来是残忍的。
顺便说,这一节还暴露出这本书的一个结构性毛病:它经常把"两条都重要"写成"一条替代另一条"。因为篇幅有限,它必须给出一个立场,于是把复杂的选择压成了一个二选一。读者读完记住的是"UBI 要加条件",而不是"现金兜底和技能培训要同时做,且节奏不同"。
四、GDPR 那一段,是全书最需要反驳的地方
P0605 讨论隐私监管。作者对 GDPR 提了两点批评,第一点我认,第二点我认为错了,而且错得比较要紧。
第一点:
当我们打开欧洲的网站或者 App 时,它们经常会弹出隐私条款窗口,要求我们授权。这种做法,一方面会对用户造成极大的干扰;另一方面,因为绝大多数用户都是未经思考就「同意」授权,所以并没有真正实现保护用户数据的目的。
这一点成立。知情同意这套机制在实践中已经退化成"点一下继续",用户既不读也不懂,同意变成了形式。用它来说明"这套设计在工程上失效",是站得住的批评,而且是一个很具体、可以被观察到的批评。
第二点:
此外,GDPR 还要求,如果用户对 AI 的判断不满,用户有上诉请求人类仲裁的权利。但是由于人类在决策方面远远不如 AI,这反而会造成混乱。
这句话把两件事混成了一件事:准确率和可申诉性。
人类在特定任务上的准确率确实可能不如 AI——看片子、查条款、算利率,这些都是。但申诉机制要解决的不是"谁更准",是"错了之后有没有一条路"。这两个问题在不同的层面上:一个关于期望,一个关于尾部。
一条没有申诉通道的自动决策,它的错误不是"更少",是"不可纠正"。而不可纠正的错误会系统性地落在同一批人身上——因为模型学的是历史分布,历史分布里本来就有偏见。被拒绝贷款的人、被标记为高风险的患者、被系统判为作弊的考生,他们不是随机分布的,他们集中在历史数据里"看起来不太对"的那部分人身上。准确率 99% 的系统,落在剩下的 1% 身上的错误是 100%。
这不是理论担忧,可以举一个所有人都懂的例子:银行的自动风控比柜员"准",坏账率确实更低。但如果你的账户被误判冻结,你需要一个人来听你说,需要在三天内而不是三个月内解决。把这个通道关掉,不是提高效率,是把误差的代价全部转移给被误判的人——而那个人往往是最没有能力承担的人。
所以这一段的真正问题不是立场偏保守,是它用工程指标(准确率)去裁决一个制度问题(救济权)。这两套语言不能互换。作者在这里其实知道自己要什么——他后面提出用"可信 AI"来替代监管,主张"与其舍本逐末,因对隐私方面的担忧而全然舍弃 AI 能带来的便利,不如等到技术成熟时,尝试构建一个值得信赖的'可信 AI'"。
"等到技术成熟时"——这句话是全书最需要被追问的一句。谁来定义成熟?在等到成熟之前,那些被系统误判的人怎么办?这本书对技术的时间表很谨慎(量子计算只说顺序不说年份),对制度的等待却很慷慨(可以先等到成熟)。这个不对称,是它整本书的底色。
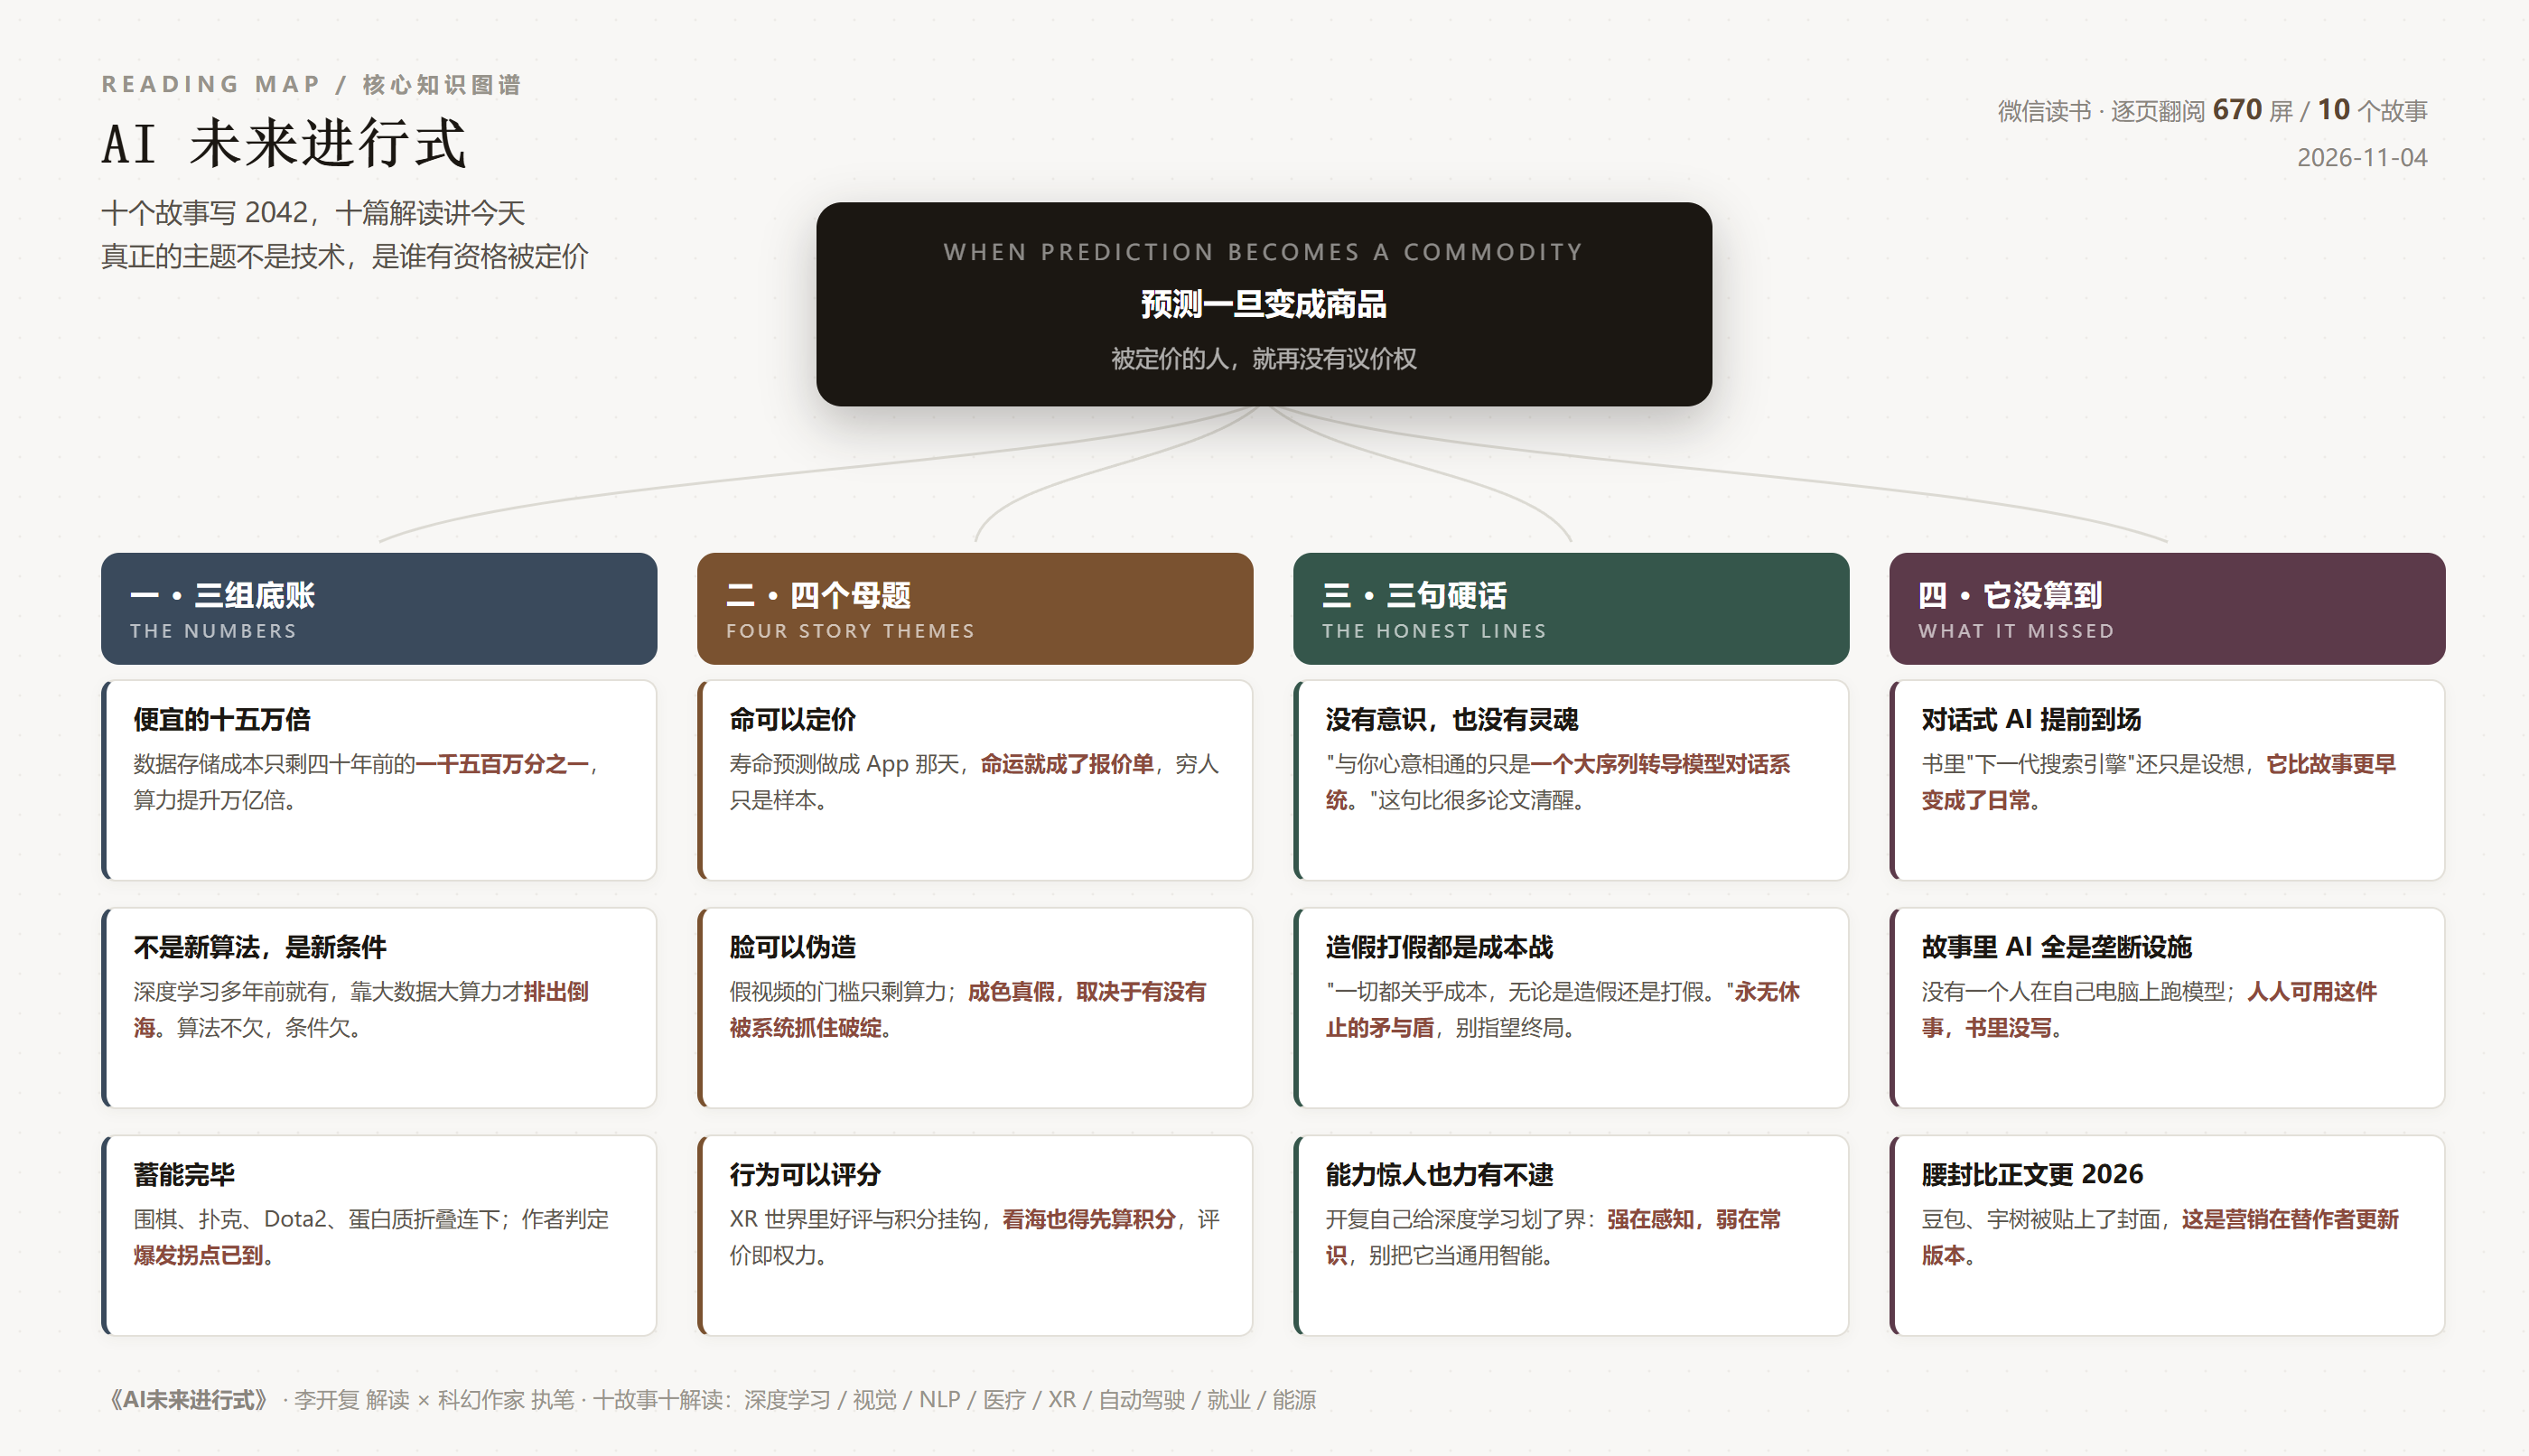
图文对照:四条线,和它绕开的那一格
下面这张图是我读完画的结构图。前三列是它真正给了东西的地方:小说提供的场景、解读提供的硬数字、以及它始终绕开的那几件事。第四列是短板。
五、它的短板
第一,副标题是后贴上去的,而且贴得比正文新。这是我在核对书名时发现的:微信读书这一版的书名后面挂着一长串——"豆包的情感陪伴、机器人的情绪价值、宇树科技……AI 未来全部预言"。但正文最后一页的落款是"2022 年 上海",序里说的是"十扇通往 2042 年的时空之门"。
2022 年写书的时候,豆包还不存在,宇树也还没进入大众视野。也就是说,你看到的这一版书的卖点,是 2022 年的正文加一行后来贴上的标签。这不是内容造假——书里没有假装自己写过豆包——但它确实改变了读者的预期:你冲着"豆包的情感陪伴"点进来,读到的是一篇 2022 年想象的陪伴机器人故事。
我把它写进短板,不是因为营销可耻(这类改装在电子书里很常见),而是因为它制造了一个具体的误读风险:读者会把书里的判断当成"对当下的判断",其实那是对四年前的技术状态的判断。书里所有"目前""已经""正在"都没有日期,这就让误读变得更容易。
第二,科普是按词典铺开的,不是按论证推进的。每个故事后面接一段技术解读,解读的结构基本是"这是什么—它怎么工作—它能用在哪"。深度学习讲一遍、计算机视觉和 CNN 讲一遍、NLP 和自监督讲一遍、XR 讲一遍、量子讲一遍。这种写法的好处是可以跳读,坏处是十篇之间没有递进:第三篇讲 NLP 基础,和第七篇讲量子基础,是并列关系,不是推进关系。
读到最后,你得到的是十个技术词条,而不是一个"AI 会怎么改变社会"的整体论证。一本书如果没有一个贯穿的论证,它的章节顺序就是可交换的——你把第三篇和第七篇对调,读者不会察觉。这是判断一本书有没有骨架的最简单办法,这本书没有通过这个测试。
第三,两种调性不咬合。小说部分经常用"技术救一个人"收尾:P0630 里,老人乔安娜靠一副 XR 眼镜找回了自己,临走前说"我就是人们所说的'被偷走的一代'";P0558 里,维克多被带进一间"和莫斯科别墅一模一样"的度假屋,墙面能改凹凸、能投影。这些结尾给的是安慰——技术夺走了什么,也能还回来一点。
而解读部分谈的是系统性风险:就业、隐私、自主武器、数据垄断。这些给的是警告。
安慰和警告放在一本书里不是不行,但它们得对上话。这本书里没有:故事结尾的情绪是"还好有人被救回来了",解读开头的论点是"这个系统会伤害很多人"。读者读完一篇,情绪落在安慰上,翻过去读到警告,会本能地觉得那是另一个话题。
第四,缺时间戳,也缺不确定性标注。书里对未来的表述,语气几乎是一样的确定:会、将、必然。但它对技术成熟度的把握其实是分层的——量子计算它只说顺序,UBI 它只说方向,自动驾驶它说"真正的自动驾驶什么时候才会出现"(这一节标题本身就在承认不确定)。这些分层没有在文字上标出来,读者只能靠自己分辨哪句是判断、哪句是猜测。
第五,我这是一次抽样。670 屏我只逐页核对了十处(P0006、P0020、P0055、P0230、P0420、P0470、P0535、P0605、P0630、P0558),其余是翻目录和跳读。所以上面所有批评,都只对这十处负责。这一点我得说清楚,否则就是以偏概全。
六、为什么"2042"这个数字反而是弱点
这本书的十个故事全部设定在 2042 年,序里说这是"十扇通往 2042 年的时空之门"。二十年是一个很方便的距离:近到可以谈技术细节(都是现有技术的延长线),远到不必为任何一个具体预测负责——2042 年之前,没人来对账。
我把这种写法叫"预测的免责结构"。真正难的预测不是"2042 年会怎样",是"2028 年会怎样"。因为 2028 年太近,说错了会被打脸;2042 年足够远,说错了可以解释成"还没到"。
更实质的问题是:只有终点,没有拐点。十个故事都是从"技术已经普及"开始写的。中间那二十年——技术怎么从实验室走到每家每户、中间失败了几次、监管怎么跟上、成本怎么降下来——全部省略。而这二十年恰恰是唯一对读者有用的部分,因为读者的所有决策都发生在这一段里。
举个具体的。故事里 2042 年的医院,进门要扫数字健康档案,闸机能识别、能拦截、能自动分流。从今天走到这个场景,至少要过四关:设备互联的标准要统一(现在各家医院的系统互不认账)、数据跨机构流转要合规(一份病历出了院门就算出境)、医院要愿意为改造通道掏钱(这笔钱不产生收入)、出了事故要有人负责(是设备商、是医院、还是写模型的人)。这四关,每一关都可能卡上十年。
小说跳过了它们,所以读起来很顺。但它也因此没有告诉你任何一件明天能做的事。一个好的未来故事,应该让人看到"下一步在哪";这本书的故事让人看到的是"终点长什么样"。
这也解释了为什么它的解读部分反而比小说有用:解读至少给了当下的技术状态——量子计算最先落在模拟分子、深度学习靠数据和算力放大、XR 的两大瓶颈是裸眼显示和脑机接口。这些东西可以拿去判断今天,而小说只能拿去激发想象。想象有价值,但它不能替代判断。
七、怎么读它
小说部分当"场景库"读。想不出 AI 会怎么进医院、进法庭、进家庭的时候,翻一篇。它给的是画面,不是结论。画面比结论耐用——十年后结论会过期,画面不会。
解读部分当"名词表"读。CNN、NLP、XR、量子计算、UBI、GDPR,每个都有一节讲清楚是什么。当工具书查,别当论证读。查的时候顺手记一下:这一节有没有给日期?没有日期的那句,别当成现在仍然成立。
遇到"我认为"三个字,停一下。这本书的分歧点几乎都在"我认为"后面:UBI 要不要附加条件、GDPR 该不该给用户人类仲裁权、隐私监管该不该等到"技术成熟"。前面的事实层可以信,后面的判断要自己过一遍——尤其是我在第三、四节反驳的那两处。
把序里那句话当自我评价,别当宣传语。"科幻小说的最大价值并不是给出答案,而是提出问题"——作为自我评价,它准确;作为宣传语,它不准确,因为这本书给的答案不少,只是质量参差。
这本书真正立住的地方,是它敢把未来写成一天:闸机响、轴承磨、有人半夜跑过停车场。它真正露怯的地方,是它敢写 2042,却不肯写 2028。因为写 2042 只需要想象力,写 2028 需要判断力,而判断力是要负责的——你说 2028 年会发生什么,两年后就有人来对账。
所以读这本书最好的姿势,是把它的故事当问题,把它的判断当议题:它提出的每一个"未来会怎样",都该被翻译成一个"所以我明天该做什么"。翻译得出来的,才算读懂了;翻译不出来的,那只是一个好看的画面。
阅读记录:《AI 未来进行式(豆包的情感陪伴、机器人的情绪价值、宇树科技……AI 未来全部预言)》李开复 / 陈楸帆 · 微信读书网页版逐页翻页截图 · 全书 670 屏、10 个故事 · 阅读用时约 14 分 47 秒 · 2026-11-04(正文落款 2022 年 上海)
核对页:P0006(自动驾驶插图、"存储成本降为一千五百万分之一、算力提升万亿倍")、P0020(序的收尾、"十扇通往 2042 年的时空之门"、落款)、P0055(深度学习与"千人之千面"、淘宝与抖音)、P0230(陈楠夜闯医院、闸机与医护机器人)、P0420("瓦肯 7"实验室)、P0470(量子计算、费曼、量子霸权)、P0535(UBI 与杨安泽"自由红利")、P0605(对 GDPR 与"人类仲裁权"的批评、"可信 AI")、P0630("被偷走的一代"与 XR 眼镜)、P0558(沙丘度假屋与 3D 打印墙面)
发表评论: