
Stable Diffusion AI绘画创意与实战:参数给了,复现没铺
微信读书《Stable Diffusion AI绘画创意与实战》(德轩)· 微信读书网页版逐页翻阅
614 屏,13 章、151 条目录 · 2026-11-04
说明:我核对的位置是 P0003(作者简介)、P0006(前言)、P0080(embedding 与图 2-52)、P0150(图 3-12 高清修复参数面板)、P0230(4.4.2 蒙版透明度、图 4-76)、P0350(图 7-61 OpenPose 与"局限"那句)、P0480(图 10-6 场景线稿)、P0560(图 11-5、11-6 与"chilloutmix 可以在 C 站搜索得到")、P0590(12.2 图片风格转换与二维码)、P0605(13.3 结尾)、P0612(13.7 从机器学习到以人为本)。这是抽样核对,不是通读每一屏;凡引用都出自上述页面,凡判断都是我的。
这本书有一个很少见的优点:它愿意告诉你"为什么"。多数 SD 教程只教你把模型文件扔进五个文件夹,然后照着参数表填数;这本书会先花两章讲扩散模型怎么学、CLIP 怎么把文字和图像放进同一个空间、五类模型各管哪一段。这个顺序是对的——先给心智模型,再给操作。
它也有一个很少见的缺点:它每一页都在告诉你"参数是几",却几乎没有一页告诉你"这个数为什么是几、错了会怎样"。
这两件事合起来,就是我对它的全部评价:它是一本合格的原理书,加上一本不合格的复现手册。
一、先把功劳说清楚:它讲清了五类模型各管一段
翻开目录,结构是清楚的:第 1 到第 7 章是"软件基础篇",第 8 到第 12 章是"案例实战篇",第 13 章讲伦理与审美。基础篇里最值钱的是 2.4 和 2.5 两节。
2.4 讲扩散模型原理,拆成三个小问题:"模型是如何学习的""生成图片时,发生了什么""CLIP:图片和描述词的关系如何建立"。这三个问题,正好是 SD 的三层:训练、采样、条件控制。把这三层分开讲,读者才能理解为什么"提示词"能起作用——不是因为它是一句咒语,而是因为 CLIP 在训练时已经把文本和图像编码进了同一个向量空间,你的词落在这个空间里的某个点上,采样就从那个点附近开始走。
2.5 讲五类模型:大模型、embedding、hypernetwork、LoRA、VAE。这一段是全书最硬的部分,因为它解决了一个所有新手都会撞上的困惑——models 文件夹下面为什么有五个子文件夹,每个里面放什么。
P0080 对 embedding 的解释是这样的:"嵌入技术(embedding)在文件容量极小的情况下,成功地引导了 Stable Diffusion 生成更符合期望的图片,同时还保持了较好的生成效果。这项技术通过将多个提示词打包成一个向量,实现了高效的输入方式。"
这段描述准确,而且抓住了关键:embedding 是文本侧的偏置,不是模型本体。所以它只有几十 KB,却能把一长串提示词压成一个词。理解了这一点,你就知道为什么"换个 embedding"能改变画风,而不需要换大模型。
我给这一段很高的评价。理由不是它写得深,而是它写得可迁移。学会这一层,你去看 ComfyUI、SDXL、Flux 这些后来的东西,都能自己定位:它改的是采样器、是文本编码器、还是 latent 的分辨率。而没有这一层的读者,只能一直追教程。
不过这一层也暴露了这本书的一个通病:原理讲到"是什么"就停了,没有折回操作。比如 2.4.3 讲了 CLIP 把图像和描述词放进同一个空间,那么接下来最该回答的问题就是:"既然提示词落在了这个空间里,那为什么有些词有用、有些词几乎没用?"答案其实就藏在 CLIP 的训练语料里——它在英文图文对上训练,所以英文提示词的命中率天然高于中文;它对具体的名词和材质敏感,对抽象的情绪词不敏感。这两条结论,能直接指导读者怎么写提示词。书里没写。
二、4.3 与 4.4:全书最细的十页,也是全书最像"手艺"的十页
局部重绘这一章,是这本书真正显出功底的地方。它把"改一张图里的一个局部"拆成了五个参数:蒙版模糊、蒙版模式、蒙版蒙住的内容、重绘区域、仅蒙版模式的边缘预留像素。P0230 又补上第六个:蒙版透明度。
为什么要拆这么细?因为不拆,改出来的图边缘一定有接缝。人在看图时对边缘极其敏感,一条不该有的硬边,就足以让整张图显得假。这五个参数,本质上都在处理同一件事:让新生成的内容和旧图在边界上连续。
P0230 的原文是这样写的:"例如还用作上个例子中的图片举例,如果想把模特换条黄裙子,把要换的部分用画笔涂上黄色,蒙版透明度设置为 0,重绘幅度拉到最低,通过计算机视角来看,会发现原图被黄色百分之百覆盖。如果把透明度拉高,蒙版就会出现透明度,拉得越高越透明。"
这段讲的是对的,但它停在"手感"这一层。截图里那个滑杆停在 39,正文没有解释 39 和 0 的差别在哪里,也没有告诉你"透明度高了会出现什么坏事"。而真实的经验是:透明度太低,蒙版边缘会出现一圈没被重绘的旧像素,像贴了一张纸;透明度太高,边缘会吃掉周围的纹理,衣服会渗到皮肤上。这个"两头都会坏"的区间,才是读者最需要的。
不过我得说句公道话:能把参数拆到"边缘预留像素"这一层的教材,市面上不多。多数教程讲局部重绘,只讲"涂一下、点生成"。这本书愿意把六个参数逐个过一遍,说明作者是真改过图的。
这里面最容易被跳过、其实最影响结果的是"重绘区域"。选"全图",模型会看整张图再补那一块,上下文最完整,代价是慢,而且可能顺手把蒙版外的东西也改了;选"仅蒙版",只处理涂过的那一小块,快,但模型看不到周围的纹理和光照,补出来的东西容易"浮"在画面上。书里给了这个选项,也给了"边缘预留像素"这个补救参数,但没把这两者的取舍讲成一句话。
如果我来写这一页,我会加一句判据:改动区域的尺寸小于画面十分之一时用"仅蒙版",把边缘预留像素调到 32 以上;超过十分之一就老老实实用"全图"。这类判据不需要跑图就能验证——你只要试两次,看接缝在哪出现。教材缺的就是这一句,而它恰恰是读者最想要的那一句。
三、"可以在 C 站搜索得到":复现断在第一颗螺丝上
P0560 讲室内设计案例,第一步是这样写的:
01 打开 WebUI,选择"chilloutmix"模型(可以在 C 站搜索得到)。
02 提示词界面如图 11-6 所示。
这句话是全书的缩影,也是全书最大的硬伤。
"可以在 C 站搜索得到"——搜得到,不等于下得到同一个。模型站的同一个名字下面,往往挂着十几个版本;作者上传过 v1、v2、v3,读者点进去默认下到最新的一版;有的模型被作者改名、下架、甚至整个账号注销。你按图索骥下回来一个叫 chilloutmix 的文件,画出来的东西和书里那张图不是一个风格,然后你会怀疑是自己参数填错了,接着开始无休止地调参——而真相是,你从一开始用的就不是同一颗螺丝。
这不是苛责。工程上有一个很简单的标准:如果一个流程无法被别人复现,它就不叫方法,只叫示范。示范的价值是激励("你看能做到"),方法的价值是迁移("你照着做也能得到")。这本书在案例篇里,通篇是示范。
更耐人寻味的是,作者其实知道哈希这回事。P0350 那张 ControlNet 的截图里,模型那一栏明明白白写着 control_v11p_sd15_openpose [cab727d4]——后面那串方括号就是模型文件的哈希前缀,是 WebUI 自动带上的。截图里带着它,正文里却只说"去 C 站搜"。这说明不是不懂,是没把它当成读者会需要的东西。
正确的写法其实很便宜:给出文件名、文件大小、上传者、下载日期,四样里任意三样就能对上。要求再高一点,给 SHA256 的前八位。一句话的成本,能省掉读者三个小时的排查。
顺着这一条,我给自己定了一个"三件套",做任何一张要复用、要交稿、要写进文章的图,都记下来:模型哈希 + 完整参数(含 seed)+ 软件版本号。前两个决定这张图能不能再做一遍,第三个决定半年后还打不打得开。这三样加起来不超过两行字,但它把"作品"变成了"资产"——作品只能看,资产能被别人接着做。
这本书教了怎么做出一张图,没教怎么让这张图变成资产。这是它和真正的工程实践之间,最远的一段距离。
四、截图见证式教学:每个参数都有值,没有一张 A/B
P0150 是全书最典型的一页。一张参数面板的截图(图 3-12),红框圈出"高清修复",旁边一行小字"从 512x512 调整至 1024x1024"。面板上的数是:采样迭代步数 25、采样方法 Euler a、放大算法 R-ESRGAN 4x+、放大倍数 2、重绘幅度 0.7、宽度 512、高度 512、生成批次 1、每批数量 1、提示词相关性 7。
十个参数,十个值,全部给到位了。然后呢?
然后没有然后。这一页没有告诉你为什么是 25 而不是 30,为什么是 0.7 而不是 0.5,为什么是 R-ESRGAN 4x+ 而不是 ESRGAN 或 SwinIR。更没有给你看:同一张图、同一个种子,重绘幅度 0.3、0.5、0.7、0.9 四张并排长什么样。
而这恰恰是参数教学唯一有效的形式。因为参数的意义不在数值本身,在边界:0.5 以下结构不变只改细节,0.75 以上结构开始漂,0.9 以上基本是重画。这条边界,用四张同种子的对照图一眼就能看出来,用四页文字讲不清。
为什么作者没做?我猜是成本。跑四组对照要生成、挑图、排版,还要保证四张图在同一页上大小一致;而截一张参数面板,只需要按一次截图键。成本决定了教法,教法决定了读者能不能学会。这本书的每一个参数页,都停在了成本最低的那一步。
所以我把这本书定性为"参数书"而不是"教学书"。参数书的合格线是给值,教学书的合格线是给区间和代价。它过了第一条,没过第二条。
五、时效:一张 2023 年的地图,却没标年份
下面这段是我的推断,依据全部来自截图,读者可以自己核对。
界面是 WebUI 1.x 的英文原版布局,标签页还是"文生图/图生图/附加功能/图片信息/模型合并/训练/设置/扩展"那一套;采样器列表排到 UniPC 为止;ControlNet 用的是 sd15 权重(control_v11p_sd15_openpose);默认分辨率是 512×512,高清修复的目标是 1024;案例用的写实人像模型是 chilloutmix。这几条加在一起,指向同一个代际:SD 1.5 生态。
这些内容在当时都是对的,今天也不算错——SD1.5 依然在跑,生态依然最全。问题不在内容,在没有标日期。
全书我没有找到一句"本书截稿于某年某月",也没有一节讲"换到 SDXL 之后哪些参数要重调"。而这两件事,对读者来说是要花钱的:按 512×512 出图再放大到 1024 的流程,搬到原生 1024 的 SDXL 上,会得到构图崩坏、人物重复的图;R-ESRGAN 4x+ 那套放大逻辑,放到 SDXL 上属于过度放大,细节会被"编"出来而不是"补"出来。
工具书的时效不是缺点,是属性——所有工具书都会过期。但不标日期是缺点,因为它让读者误以为手里的地图是新的。一张标了年份的旧地图仍然有用,你可以据此判断哪些路可能已经改了;一张没标年份的旧地图,会让人一直走到断头路才反应过来。
同一类缺口还出现在采样器那一页。图 3-12 的采样器列表排了二十来个(Euler a、LMS、Heun、DPM2、DPM++ 2M、DPM++ SDE、UniPC……),正文教你怎么选,但没给"多少步之后不再变好"这条经验。而这条经验比采样器的名字重要得多:步数从 20 加到 40,画面会变;从 40 加到 80,多数情况下只是多花一倍时间。一个读者如果不知道拐点在哪,就会一直往上加,把时间花在没有回报的地方。
这三处缺口——没标年份、没给步数拐点、没给参数区间——是同一件事的三个面:这本书把"值"当成了知识,把"界"留给了读者自己撞。而边界,才是知识里最贵的部分。
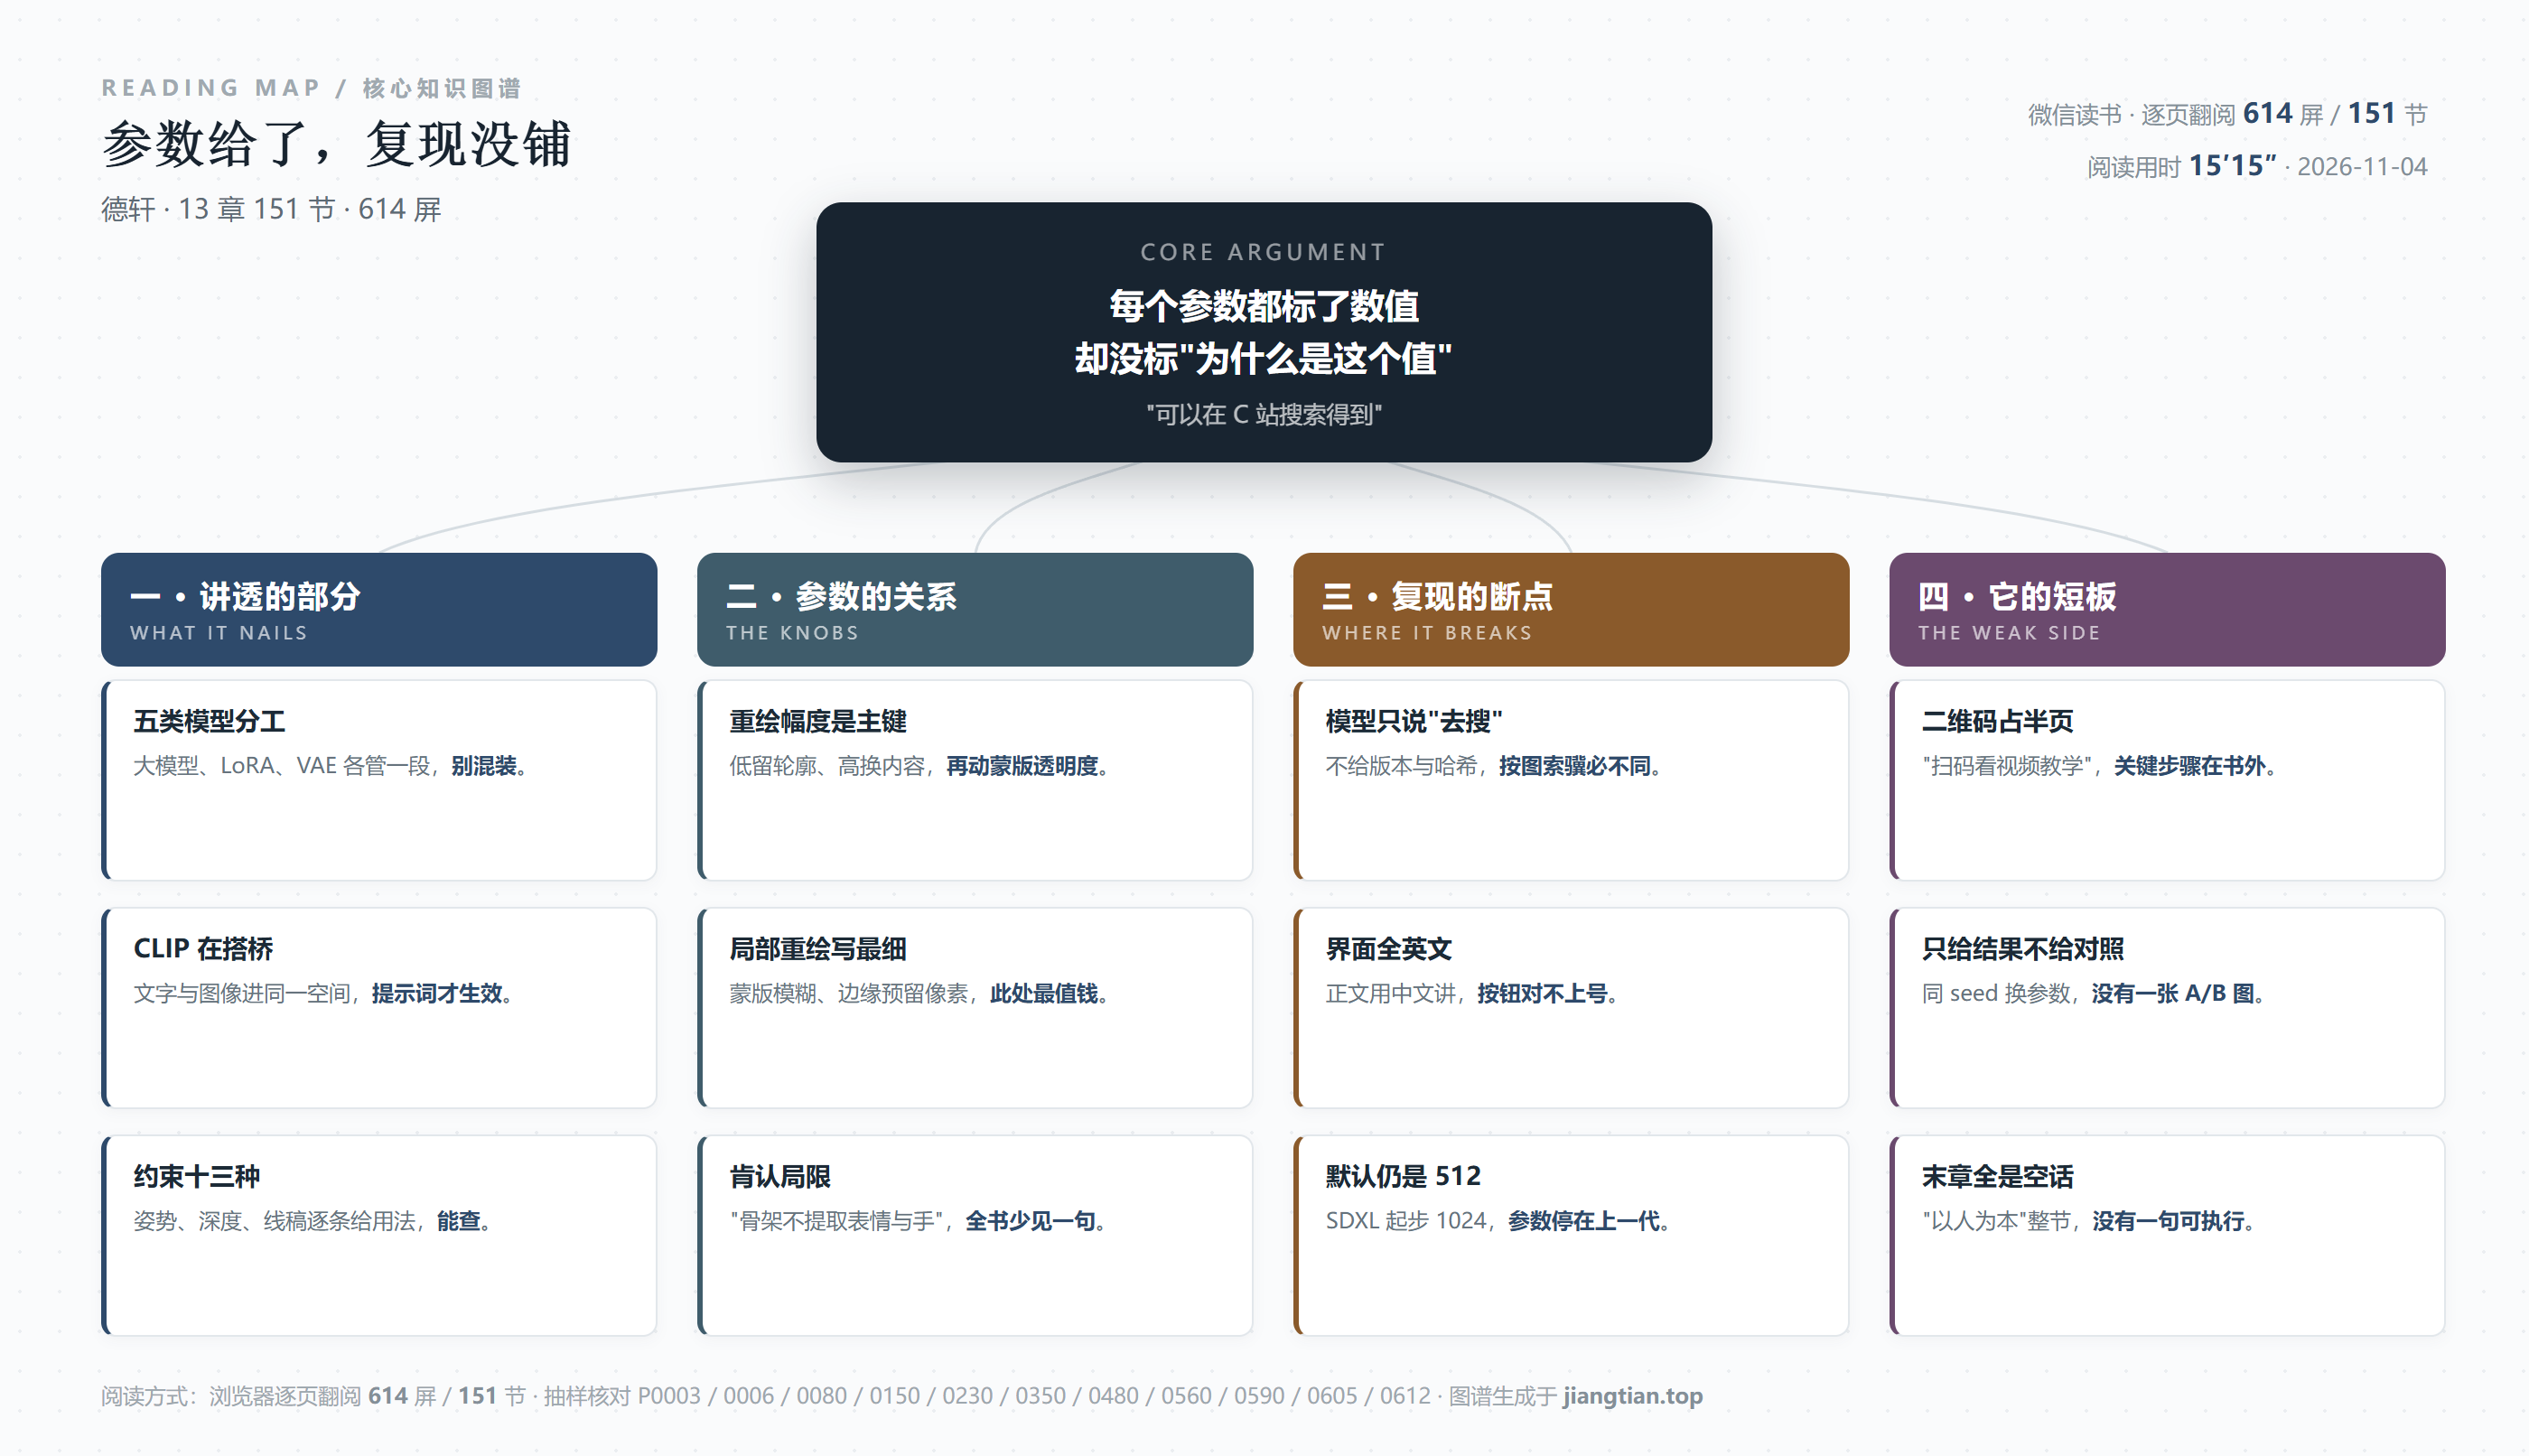
全书脉络与短板,一张图看完了:
六、案例篇:能出图,不等于能交付
第 8 到 12 章按行业分:游戏(角色多视图、原画、场景、图标)、电子商务(AI 模特、指定脸部特征、放大修复)、插画(线稿、上色、小说插图、扩图、海报)、建筑(室内无线稿、室内有线稿、建筑单体、半鸟瞰、景观)、其他(照片修复、风格转换)。
这个行业划分是准的。SD 真正跑通的,就是这四个行业加一堆零散需求。作者没有硬凑"医疗""金融"这类场景,说明他知道边界在哪。
但每个案例的写法完全一样:一张参数截图,一段操作步骤,一张成品图,一句"出图效果如图 X 所示"。
缺的那一块,是交付。游戏要的不是一张好看的立绘,是同一套比例、同一套光照下的多视图,是能进引擎的贴图尺寸;电商要的不是氛围图,是白底、可换色、能过平台审核的模特图;插画要的不是 JPEG,是分层 PSD 和可编辑的文字区;建筑要的不是概念图,是透视能对上线稿的图。这些规格,一节都没写。
而这些规格,正是"会用工具的人"和"能接单的人"之间那道门。会出图的人现在很多,能把图交成客户要的格式的人不多。教材如果只教前半段,学生毕业时会做图,不会交货。
我抽到的 P0480 是个具体例子。那是 10.1 节"线稿生成"的案例图(图 10-6),画面是一间教室的灰度图:课桌、窗、百叶帘、挂在墙上的画,线条和明暗都在。作为"线稿"它很好看。但作为给上色用的底稿,它可能太满了——上色需要留白,明暗关系一旦被 AI 定死,上色的人就只剩下"填色",没有"塑造"的余地。这是我的判断,书里没有讨论"线稿的疏密该到什么程度",也没有讨论"什么该由 AI 决定、什么该留给下一道工序"。
这个缺口,比参数写得不够细要严重。因为参数可以自己试出来,工序的分界线得有人告诉你。
把交付要求摊开看会更清楚。电商那张图,要求是白底或纯色底、模特姿态能被换、肤色不能被调成同一种、尺寸要能裁成 1:1 和 3:4 两版、平台审核不能判定为"虚假宣传";游戏那套多视图,要求是四个角度共用同一套比例与光照、裙摆与发梢的走向要能对上、贴图尺寸是二的幂、最好分层;插画那张,要求是能导 PSD、文字区留空、线稿与上色分离。这些都不是"生成"能解决的,全是"生成之后怎么整理"。
而整理这件事,恰恰是 AI 最不擅长、人最值钱的地方。一本书如果只教生成,它教的是这行里最容易被替代的一段。
七、它的短板
第一,二维码占了版面。P0590 是 12.2 节"图片风格转换"的开头,整页最显眼的位置放了一个二维码,底下写着"扫码看视频教学"。二维码本身没错,很多教材都这么做。但它放在这里,等于承认这段文字讲不清:一段"把三次元女孩照片转成二次元风格"的操作,书的正文只给了两句概述,剩下的交给视频。
问题在于,视频不可检索、不可复制参数、不可引用、不可跨设备对照。你想回到"重绘幅度 0.5 那一版",只能在进度条上 dragging。一本书把关键步骤外包给视频,书的独立价值就被削掉一块——它从"教材"退化成了"课程的说明书"。而这本 614 屏的书里,我看到不止一处这样的二维码。
第二,中英两套词并行。图 3-12 的面板是英文:Sampling steps、Sampler、Denoising strength、CFG Scale、Mask transparency;正文是中文:采样迭代步数、采样方法、重绘幅度、提示词相关性、蒙版透明度。同一件事,两套名字,读者要在脑子里做实时翻译。
这不是排版问题,是本地化没做。对已经上手的人是小事,对刚装完软件的人是大事——他打开界面找不到"重绘幅度"四个字,只能去猜哪个是。教材的门槛,常常就抬在这类地方。
第三,末章的空话与前面的好判断不成比例。目录里 13.5 叫"工作重心的转变:从创作到选择"。这是一个具体的、可检验的判断:AI 把生成的成本压到接近零之后,人的工作从"做出来"移到"挑出来",价值从手移到眼。这一句,比整章其他内容加起来都值钱。
而 13.7"从机器学习到以人为本",用了一整节的篇幅讲这样的话:"AI 绘画应该被视为一种工具,而不是替代人类创造力的工具""艺术创作的本质是源自人类的情感、思想与文化""在追求技术进步的同时,不能忽视艺术中的人文因素"。
这些话都对,但没有一句可执行。什么叫"不能忽视人文因素"?是在提示词里加一句"有情感"?是在交付前请人看一眼?还是给客户一份说明"这张图是 AI 生成的"?三个答案对应三种完全不同的做法,书里一个都没选。
同一章里,好的那节和空的那节,占的页数差不多。这是我觉得最可惜的地方:作者显然知道哪句更值钱,但他给了空话同样的版面。
第四,没有一张失败的图。全书案例都是成品:干净的、完整的、能当封面的。没有一张手崩了、结构重了、风格漂了的图,也没有一段"这一版为什么不能用"。
而 SD 的日常,八成时间在处理坏图。新手第一次生成出六根手指时,他需要的不是"重绘幅度调到 0.7",是一句"这是模型在训练时对 occlusion 的学习不足导致的,改局部重绘比重新生成便宜"。这种话,全书没有。
一本教实操的书不教失败,读者第一次崩图时就没有词汇描述它,只能凭感觉乱调。失败不是意外,是这门手艺的主要工作内容。把它从书里删掉,等于把工作里最难的那一半删掉。
第五,没有成本数据。我抽到的案例页里,没有一处标注"这个案例生成了几张才挑出一张""单张耗时多少""显存占用多少"。而这三样,是决定"要不要用这套流程接活"的全部依据。
一张能交的图,废图率是多少?拍脑袋说 5:1,那就意味着客户付一张图的价钱,你要跑五张的时间和电费;说 20:1,那这个报价根本不成立。这个数每个模型、每个题材都不同,正因为不同,才更该由教材给一个区间,让读者知道自己在什么量级上工作。没有这个量级,所有"效率提升"的说法都无法落地。
八、怎么用这本书
前七章当地图,别当步骤。2.4 和 2.5 建心智模型(扩散怎么走、五类模型各管什么),3.x 认参数,4.3 与 4.4 学蒙版,7.1 学约束。这四块五年后还有效,因为它们讲的是原理和关系,不是某个版本的按钮在哪。
8 到 12 章当灵感库。看它能做什么、行业里哪些活已经被跑通,然后关掉书自己做。别照着抄流程——模型对不上,参数就对不上,抄了也复现不出来。
每个参数自己补一张 A/B。固定 seed,只改一个值,出四张,存到一个文件夹里,命名成"参数名_值"。做完二十次,你会有一套自己的参数直觉,比读二十页有用得多。这件事成本很低,一次十分钟,而它正是这本书没做的事。
去招聘网站补"交付规格"。搜"AI 绘画师",看二十条岗位要求里反复出现的分辨率、格式、软件组合、协作流程。那里写的比任何教材都准,因为写要求的人真的在验收。
遇到"可以在 C 站搜索得到",停一下。把模型的文件名、大小、哈希前八位记在笔记里。这一条能省掉你未来三个小时的排查,也能让你在半年后还想得起这张图是怎么来的。
最后补一句读法:把这本书当"上一代的字典",别当"这一代的教程"。字典的用法是查,不是读。你想知道蒙版模糊是干什么的、五类模型怎么分工、ControlNet 的十三种约束各管什么,它答得比多数新教程清楚,因为这些概念没怎么变过。你想知道今天该用什么分辨率、哪个模型现在最好用、工作流该用 WebUI 还是节点式的 ComfyUI,它一句都答不了,因为它的截图停在了上一代。
分清这两件事,这本 614 屏的书就还有一半可用;分不清,你会把一半的时间花在复现一张 2023 年的图上,然后误以为自己学不会。
这本书把参数讲成了知识,却没有把复现讲成方法——而这两者之间隔着的,正是它一张都没放的那些失败图。
阅读记录:《Stable Diffusion AI绘画创意与实战》德轩 · 微信读书网页版逐页翻页截图 · 13 章 151 条目录 · 614 屏 · 阅读用时约 15 分 15 秒 · 2026-11-04
核对页:P0003(作者简介:B 站 AI 板块博主、累计培训学员 5 万+)、P0006(前言:文生图/图生图/插件应用与 GAN、VAE 等技术)、P0080(embedding 打包提示词为向量、图 2-52)、P0150(图 3-12 高清修复参数面板:步数 25、Euler a、R-ESRGAN 4x+、重绘 0.7、CFG 7、512→1024)、P0230(4.4.2 蒙版透明度、图 4-76)、P0350(图 7-61 openpose 与 control_v11p_sd15_openpose[cab727d4]、"不提取表情与手部特征")、P0480(图 10-6 教室场景线稿)、P0560(图 11-5 室内线稿、图 11-6、"chilloutmix(可以在 C 站搜索得到)")、P0590(12.2 图片风格转换、二维码"扫码看视频教学")、P0605(13.3 结尾"总而言之")、P0612(13.7 从机器学习到以人为本)
发表评论: