
这就是 ChatGPT:为什么"猜下一个词"能猜出像懂的样子
微信读书《这就是ChatGPT》· 斯蒂芬·沃尔夫勒姆(Stephen Wolfram)
逐页翻阅 171 屏 · 读完至末页"全书完" · 2026-11-05
说明:本书很短,我从第 1 屏翻到第 171 屏,末页确认出现"全书完"(推荐值 73.5%,1736 人点评)。正文之前另有一篇长篇导读,讲 BERT 与 GPT 的路线之争、OpenAI 的组织选择,那部分不是作者写的。下面引用的都是正文段落。
关于 ChatGPT 的书,我读过不少。绝大多数在回答"它能干什么",少数在回答"它是什么"。这本书是唯一一本认真回答"为什么这么笨的办法居然能行"的。
作者是 Stephen Wolfram,写 Mathematica 的那个人。这个身份决定了这本书的写法:他不从"人工智能"讲起,他从一个纯数学问题讲起——给定一段文本,怎么让机器决定下一个词。
一、他先把最朴素的办法推到死路
第一步是最笨的:数一数,在大量文本里,"cat" 后面最常跟哪个词。作者给出的结果是这样的(中文版照排):
cat through / cat for the book / cat at safety / cat throughout / cat on the theory……
毫无意义。接着他往前走一步:不只看一个词,看词对。结果立刻"合理"了一点——"cat through shipping variety" 这种句子虽然还是怪,但已经像人话的骨架了。
然后是这本书里我最喜欢的一段推理。他说,如果 n 元词能无限长,我们基本上就"得到一个 ChatGPT"了。但问题在于:
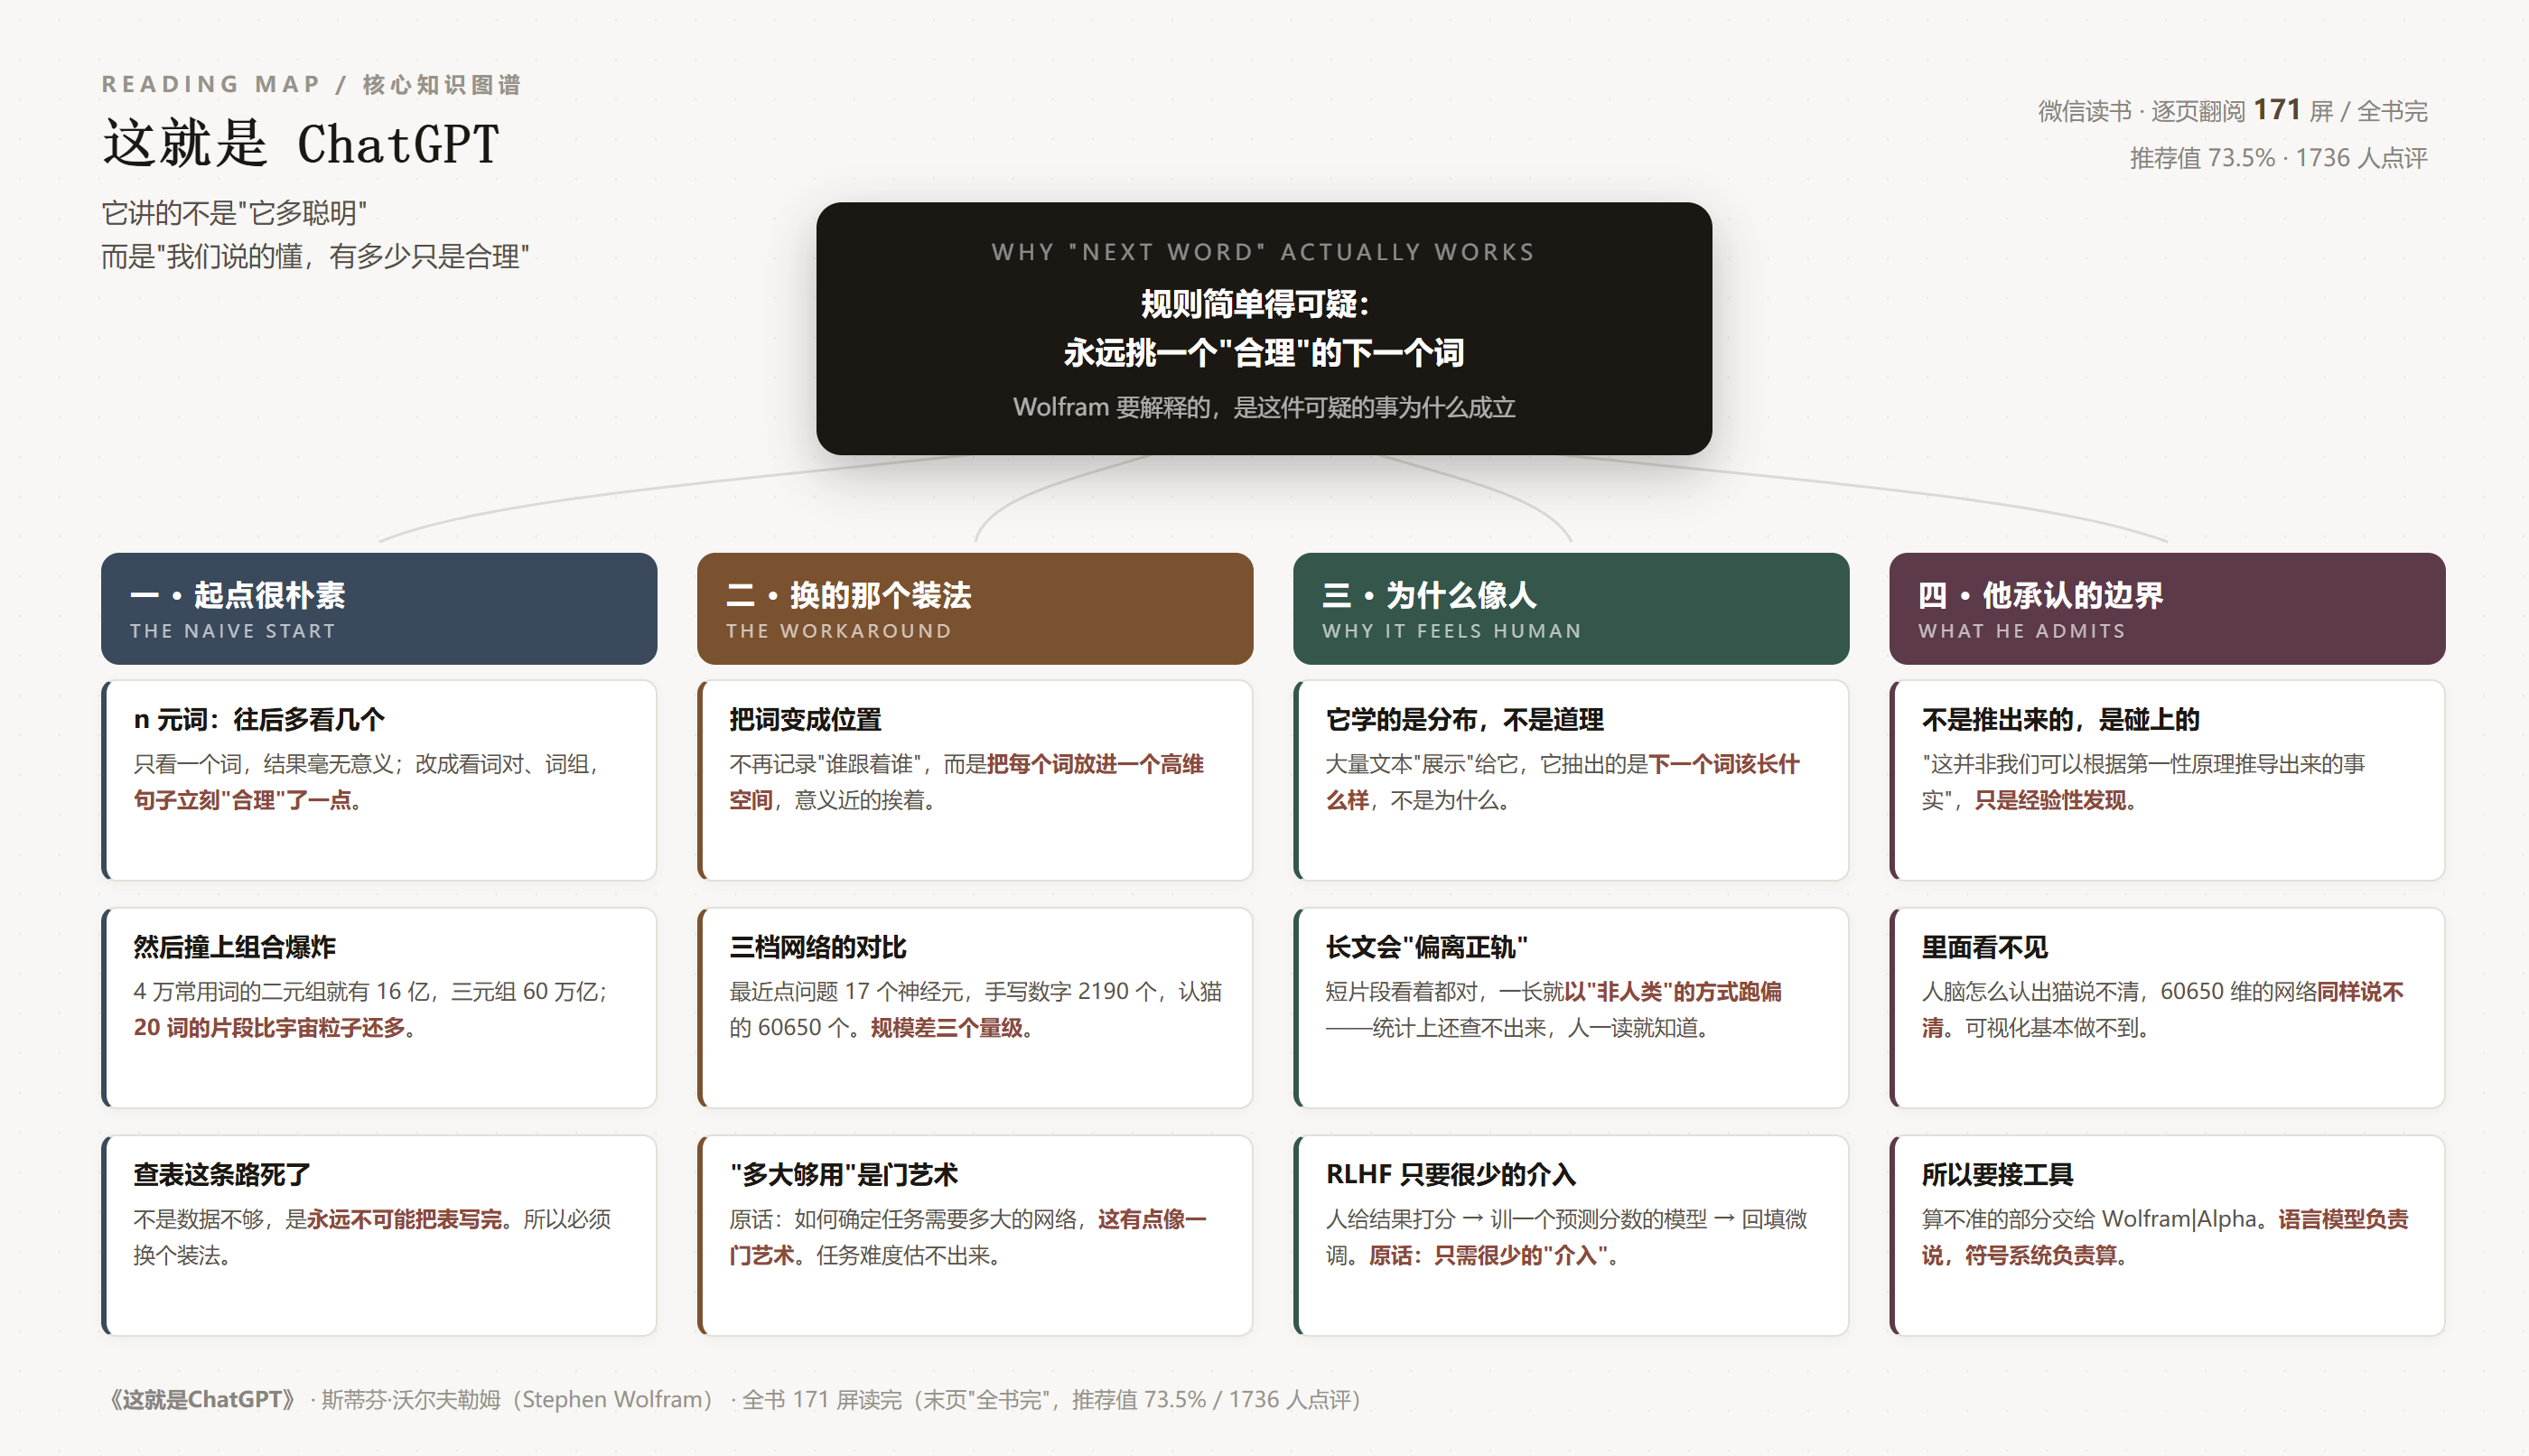
即使只有 4 万个常用词,可能的二元词的数量也已经达到了 16 亿,而可能的三元词的数量则达到了 60 万亿。因此,我们无法根据已有的文本估计所有这些三元词的概率。当涉及包含 20 个词的"文章片段"时,可能的 20 元词的数量会大于宇宙中的粒子数量,所以从某种意义上说,永远无法把它们全部写下来。
"20 个词的组合比宇宙粒子还多"——这句话把一个技术困境讲成了常识。我读到这里才真正明白,为什么"抄语料"这条路走不通:不是数据不够多,是这张表在数学上就写不完。
这也是这本书最值钱的地方。它不是在给你一个结论,它是把一条路走到尽头给你看,让你自己承认"必须换个办法"。
二、换的那个办法:把词放进空间里
换法子的核心一句话:不再记录"谁跟着谁",而是把每个词放到一个高维空间里的某个位置,让意思相近的词挨在一起。
这样,"下一个词是什么"就变成了"离当前位置最近的一批点在哪里"。它不需要穷举组合,它需要的是一条几何规则。
作者在这里给了一组我很喜欢的数字对比。三个任务、三种网络规模:
在上面用于解决"最近点"问题的最终网络中,有 17 个神经元;在用于识别手写数字的网络中,有 2190 个神经元;而在用于识别猫和狗的网络中,有 60650 个神经元。
17、2190、60650。三个量级的差距。而紧接着的一句话,是我认为全书最诚实的一处:
但是,如何确定特定的任务需要多大的神经网络呢?这有点像一门艺术。在某种程度上,关键是要知道"任务有多难"。但是类人任务的难度通常很难估计。
"这有点像一门艺术"——一个数学家在讲深度学习时肯说出这句话,比任何"我们已掌握通用方法"的宣称都可信。它承认了这里还有大量试错,没有理论指导你该建多大。
三、"看起来合理"这四个字,是全书的钥匙
讲完结构,作者转到训练。他的描述方式很朴素:训练就是把大量文本"展示"给网络看,让它学会该在什么地方接什么。
然后是全书最关键的一段判断——他把 ChatGPT 的失败模式说清楚了:
尽管这些结果通常看起来合理,但它们很容易(特别是在较长的文本片段中)以"非人类"的方式"偏离正轨"。这不是通过对文本进行传统的统计可以轻易检测到的。但是,实际阅读文本的人很容易注意到。
这段话值得一句一句拆。
"通常看起来合理"——它优化的目标是"合理",不是"正确"。这两个词在短句里几乎重合,在长文里会分叉。
"特别是在较长的文本片段中"——错误不是均匀分布的,它随长度累积。所以"它前面说得挺好"不能作为"它后面也对"的证据。
"以'非人类'的方式偏离正轨"——这是我最欣赏的一个说法。它跑偏的方式不像人会犯的错:人会记混事实,但它会漂移到一种"语言上通顺、指向上失焦"的状态。
"统计检测不到,读的人很容易注意到"——这句话解释了为什么所有自动评测都测不出"AI 味"。因为 AI 味不在统计特征里,它在阅读体验里。
接着他讲 RLHF,讲得比大多数科普都清楚:先让人给结果打分,再训练一个模型去预测这个分数,然后用这个预测模型回头去调原来的网络。他还加了一句很轻但很重要的话:
有趣的是,"原本训练好的网络"似乎只需要很少的"介入"就能在特定方向上有效地进步。
只需要很少的介入。这句话的意思是:它本来就已经会了,人做的只是把它往某个方向轻轻推一下。这既能解释为什么对齐做得这么快,也解释了为什么对齐这么脆——因为你推的只是一个已经很满的分布,而不是在教它新东西。
四、他自己划了两条边界,都没有藏
第一条边界是关于"这东西是怎么来的":
结果表明,它的做法相当符合人类的思维方式。正如上面所说的,这并不是我们可以"根据第一性原理推导"出来的事实。这只是一些经验性的发现,至少在某些领域是正确的。
"这不是第一性原理推导出来的,只是经验性发现"——一个以推导为职业的人愿意这么写,我认为这是全书的分量所在。今天很多人把"神经网络有效"当成一条定律在讲,其实它更像一条被反复验证但没人能证明的经验。
第二条边界是关于"里面到底在干什么"。他先问了一个极好的问题:你怎么知道一张图是猫?你说"我看到它尖尖的耳朵",但你没办法说清你是怎么把这个判断做出来的。人脑内部看不见。然后他补了一句:
但是(至少目前还)没有办法去大脑"内部"看看它是如何想明白的。那么,对于(人工)神经网络呢?……即使要对其进行基本的可视化,通常也非常困难。
人的黑箱和机器的黑箱,是同一种黑箱。这句话把一个常被当作"AI 缺陷"的问题,还原成了"智能本身的特性"。我不确定这是否能让人安心,但它至少是诚实的。
也正因为算不准,书的后半部分讲了工具调用:让语言模型去调 Wolfram|Alpha 做计算和查证,模型只负责把话说顺。"语言模型负责说,符号系统负责算"——这条分工在 2026 年的今天已经成了行业标准做法,而这本书写在它成为标准之前。
五、它的短板
第一,它解释的是 2023 年初的那个 ChatGPT,结论有一部分已经过期。全书的核心论断是"它不做逻辑推理,它只做合理续写"。这在 GPT-3.5 身上完全成立。但今天这批会先"想"再答的推理模型,恰恰是在这一点上做了推进——它们把"多花点算力去想"变成了流程的一部分。书里没有这一层,所以读的时候要自己补上:"合理续写"仍然是底层机制,但已经不再是全部机制。
第二,它完全不给用法。171 屏里没有一句"你可以让它干这个"。对想拿它当工具书的人是浪费,对想搞懂原理的人是正好。买之前最好先想清楚自己要哪个。
第三,正文之前那篇长导读和正文不是一回事。导读讲的是 BERT 与 GPT 的路线之争、OpenAI 为什么砍掉机器人项目、"Open"这个名字的讽刺——这些内容本身有价值,但它的语气是评论式的,和正文那种"从第一原理推给你看"的风格断裂。我读的时候差点以为买错了书。建议直接从正文开始,回头再看导读。
第四,它没有回答那个最实用的问题:既然它只是"看起来合理",那我怎么判断哪句是合理、哪句是编的?书里给了失败模式的描述(长文本漂移、非人类式偏轨),但没给任何可操作的检查办法。这是从"理解"到"使用"之间缺的那一步,得靠读者自己补。
六、一句话
如果你只带走一句:它不是在找正确答案,是在找"下一个看起来合理的词"——而我们平时说的"懂",有相当一部分其实也只是"合理"。
这本书最大的价值不是让你更懂 AI,是让你在读到一段流畅得不像话的文字时,会停半秒,问一句:这是懂,还是合理?
阅读记录:《这就是ChatGPT》,斯蒂芬·沃尔夫勒姆(Stephen Wolfram),微信读书网页版逐页翻阅 171 屏,2026-11-05,末页确认"全书完",推荐值 73.5%(1736 人点评)。
抽样页:p0006(导读:BERT 与 GPT 路线之争)、p0040(n 元词与组合爆炸)、p0062(神经元数量三档与"认猫"之问)、p0075(网络规模"是门艺术")、p0110(基础训练之外的 RLHF)、p0160(Wolfram|Alpha 工具调用)、p0171(全书完页)。
发表评论: