
《AI智能体搭建与应用(基于Coze)(慕课版)》:搭得出来,判不出来
微信读书《AI智能体搭建与应用(基于Coze)(慕课版)》· 乔海晔、杨志明 主编 · 蔡嘉婧、刘伟奇 副主编 · 前言落款 2026 年 3 月
逐页翻阅 2272 屏 · 9 个项目 45 条目录 · 2026-11-05
说明:本书 9 个项目,我从第 1 屏翻到第 2272 屏。抽样逐页核对的是 p0006(前言与编写组织)、p0120(项目三 输入需求)、p0330(图 5-11 意图识别节点)、p0450(图 7-19/7-20 头像生成节点)、p0820(代码节点限制)、p1300(图 7-48 发布渠道)、p1600(图 4-33 试运行结果)、p1980(项目三 输出需求)、p2180(智能体与扣子应用之别)、p2240(前端数据绑定)。下文凡引号内的句子,均为截图原文照抄;凡是我推断的,会写明"我推断"。
先说结论,一句话:这是目前 Coze 类教材里"流程"讲得最全的一本,也是"失败"讲得最少的一本。
它的骨架很规整——9 个项目,项目一认识概念,项目二拆核心模块(大模型、规划、记忆、技能),项目三讲搭建全流程,项目四到项目八是五个场景(内容生成、电商客服、视觉设计、新媒体运营、办公/生活/学习),项目九收在多智能体协同。这个结构是教材编辑的思路:先概念、再方法、最后场景。教学上站得住。
但一本教人"搭智能体"的书,真正该被检验的不是它能不能带你走完一遍流程,而是它有没有告诉你——走完之后,怎么知道这一步是对的。这是两件完全不同的事。这本书把前一件做到了接近满分,后一件只给了一句话。
一、它把"需求"放在工具前面,这个顺序很少见
同类书通常从"注册账号、认识界面"开始,第三页就在教你拖节点。这本书的第三项目直接叫"智能体搭建全流程",任务一不是搭,是"确认搭建需求"。
更少见的是它真的把需求拆成了三档:输入需求、功能需求、输出需求。输入这一档还给了技术规范,原话是:
智能体应支持文本、语音、文件等多种输入形式,适配网页、App、微信等多终端传输;明确传输限制,如文本≤500字符、文件≤10MB;多模态输入需分通道处理。
同一页前面还有一句更实用的:拆解流程时"仅保留实现功能所必需的数据,如订单查询仅需订单号与用户ID,删除冗余信息以减轻用户操作负担"。
为什么我认为这个顺序值得单开一节讲?因为绝大多数智能体做砸,不是因为节点拖错了,而是因为一开始就没想清楚"用户会给什么、我给回什么"。你先选插件、先挑模型,做出来的东西一定长成"能聊天";你先定输入输出,做出来的才可能长成"能干活"。
不过要说明:它对需求的处理停在"写清楚",没到"可验收"。三档需求里,"功能需求"这一档我翻到的部分是分类说明(核心功能、辅助功能),没有一条写成可测的形式。这两件事差得很远——写清楚是给作者自己看的,可验收是给甲方和测试看的。
还有个小的体例裂缝,说明这一节的骨架可能是在不同时间拼起来的。讲"二、功能需求"时,正文写的是:
功能需求是连接输入需求与交互需求的关键,明确智能体能力范围,为搭建与测试智能体提供依据。
这里突然冒出第四个词——"交互需求"。可这一节从头到尾分的是输入、功能、输出三档,没有"交互需求"这一节,也没有交代它和功能需求什么关系。到了后面的"四、输出需求",又写"需与输入需求、功能需求匹配",交互需求再次消失。
这不是大错,但它是一处可验证的编辑痕迹:作者脑子里其实是四层(输入、功能、交互、输出),落到纸面成了三层,中间那个词只在过渡句里露了一下面。教材最怕这种"作者知道、读者不知道"的落差——读者顺着目录找"交互需求"找不到,只能自己猜。
二、全书最硬的一页,是一串数字
我抽样十页里,最值钱的是讲代码节点的那一页(p0820)。它写的全是平台边界,一句废话没有:
……为60s,每个工作流最多添加50个代码节点。
异常设置:默认超时或异常时中断工作流,用户也可自定义超时时间(0.1~60s)、重试次数(最多1次),或者设置返回指定内容、执行异常分支。
输出参数需与代码中return对象的参数名、类型完全一致,用户可根据需求保留必要参数。当设置返回指定内容或执行异常分支时,会额外返回isSuccess(执行状态)和errorBody(异常详情)两个参数,用于排查问题。
这段为什么硬?因为它不是"教你点哪里",而是告诉你这个平台的物理定律:一个代码节点最多跑 60 秒,一个工作流最多 50 个代码节点,失败最多重试一次。
三条限制合起来,其实定义了你能做的事的上限。60 秒意味着这里面不能放批量处理——想给 500 条评论逐条打标签再汇总,一次跑不完;50 个节点意味着流程不能无限细分;重试一次意味着任何依赖外部接口的节点都必须自己能兜住失败,因为平台只帮你兜一次。这些推论书里没写,但它是那三个数字的直接后果。我把这段当成本书的"硬货"标准:凡是肯给你数字的地方,作者是真的在这个平台上跑过。
还有一条容易被跳过的:"重试次数(最多1次)"。一次意味着什么?意味着平台只帮你兜一次,第二次失败就直接走异常分支。所以任何调外部接口的节点——查订单、调天气、发消息——都必须自己写好失败后的退路:给用户一句人话,而不是把 errorBody 甩到对话框里。作者在后面补了 isSuccess 和 errorBody 两个返回参数"用于排查问题",这半句其实是在提示你:异常是要自己处理的。但他没把这句话展开成"怎么处理",于是"最多 1 次"这个数字,读者看完只会记住一个限制,记不住一个责任。
同类的还有输入那一节的"文本≤500字符、文件≤10MB"。这两个数字比任何"注意控制输入长度"的提醒都有用——它直接告诉你,用户粘一篇三千字的产品说明进来,你就得先做切分。
三、它只教到"能跑通",没教到"跑对"
项目四讲"图文生成智能体",试运行的示例是让智能体做一份"土豆炖牛肉"的八步图文。图 4-33 里八张分步图配八行文案:烧开水、浸泡擦干牛肉、油锅煸炒、准备清水、切配葱姜蒜、牛肉切块、下锅翻炒、砂锅炖。文案和图基本对得上,作为演示很漂亮。
紧接着正文有一句,我认为是全书关于"出错"的全部篇幅:
若出现文案与图片不匹配、图片生成错误等问题,返回工作流编排页面修改对应节点;
这句话写得诚实——它承认会出错。但它把三类完全不同的故障,归到了同一个动作上:"回去改节点"。
而真实的排查完全不是这样。文案与图不匹配,可能是三种原因:提示词没把"第几步做什么"约束住;图像模型不认识"煸炒至表面微黄"这种中式烹饪描述;或者变量引用错了——把第 3 步的文案接到了第 5 步的图上。第一种要改提示词结构,第二种要换描述方式甚至换模型,第三种要去检查节点连线。三种错的改法互不通用,而书里给的动作只有一个。
这就是我说它"只教到能跑通"的意思。跑通是一个二值结果:出图了、没报错。跑对是一个连续判断:八张图里错两张算不算对?文案对但顺序错算不算对?教材如果不教第二种判断,学生就只会做"能演示"的东西。
同一个毛病,在全书最像"智能体"的那一节里重复了一次。项目五讲意图识别节点,定义抄得很准:
根据扣子官方文档介绍,意图识别是指通过大语言模型理解和判断用户的意图或目的。扣子对话流的意图识别节点可通过内置的大语言模型对指定内容进行意图识别和分类,从而使用不同分支进行处理。
接下来是操作:在"意图匹配"栏里填分类内容,打开"会话历史"功能,"设置合适的会话轮数"。
"合适的"这三个字,是全书出现频率最高、信息量最低的形容词。会话轮数不是一个可以"合适"的东西,它是一个明码标价的取舍:历史越长,指代消解越准("那个呢""换成大的"这类话才接得上),但每次调用的 token 越多、延迟越高、账单越贵。轮数从 3 调到 10,准确率可能涨两三个点,成本可能翻一倍。这个权衡关系,教材一句话就能交代清楚,而它用了一个形容词带过。
更关键的缺项是边界样本。真实的客服对话,一句话里同时含咨询和投诉是常态("这个多少钱,另外上次的退款还没到")。意图识别节点在这一句上会分到哪一类、分错之后怎么兜,书里没写。而这类样本恰恰是意图分类从 85% 走到 95% 的全部难点所在——剩下那 15%,八成都是这种一句话两件事的。
四、图 7-48 里有一句话,正文没接住
这是全书我最想说的一处。
项目七讲新媒体运营智能体的"多平台分发",图 7-48 是发布渠道的选择界面。截图里四行一目了然:扣子商店"已授权";豆包"未授权",后面跟一行灰色小字——大意是使用的模型和插件不支持在豆包分享,发布到豆包后仅自己可见;飞书"未授权";微信展开成小程序、微信客服、微信服务号、微信订阅号四个通道,其中订阅号"已授权"、显示为可勾选。
正文对这一屏的处理是一句话:勾选"微信订阅号"复选框,然后发布。
那句灰字,是这张图里信息密度最高的一行。它说的是:发布不是复制粘贴,是渠道适配。同一个智能体,在 A 渠道能跑,在 B 渠道可能因为"用了这个渠道不支持的模型或插件"而只能自己看见。这意味着发布前要做的不是点按钮,而是先查一遍:我做的东西依赖哪些模型和插件,目标渠道认不认。
作者把屏幕截下来了,却没把这句读出来。这不是粗心,是"截图见证式写作"的通病——图比文字知道得多,而写的人只看了自己想看的那一块。很多读者照着做完,把智能体发到某个渠道,打开发现只有自己能看到,回头翻书,答案其实早在第 1300 屏的那张图里。
顺带说一个我在两本书之间撞见的小矛盾:本书截图里的渠道只有扣子商店、豆包、飞书、微信四项,而同一套丛书里的另一本《AIGC新媒体运营实战技能》正文写的是"扣子平台支持将智能体发布到飞书、微信、抖音、豆包等渠道"。我无法判断是渠道上线时间不同,还是其中一本写错了。但这类"同一平台、两本书两种说法"的情况,恰恰说明把渠道清单写进正文是有风险的——它半年就变一次。
五、"准确率≥90%"这行字,后面少了三个前提
项目三"输出需求"那一节,作者给了量化标准,其中一句是:
如语法纠错智能体准确率≥90%,外部信息需标注来源以保证可追溯。
"外部信息需标注来源"这半句是好的,甚至可以说是全书最专业的一处——它把"可追溯"当成了输出的一部分,而不是可选项。但前半句的 90%,缺了三个前提。
第一,测什么集。多少条样本、从哪来、谁标的、有没有包含"不该改"的句子。语法纠错这个任务有个特点:错的句子好找,对的句子难找。如果测试集里全是病句,模型见到什么都改,准确率照样能上 90%。
第二,怎么算。一句话里有三个错,改对两个、误改一个,算对还是错?逐字算还是逐句算?口径不同,同一个模型能算出 62% 也能算出 88%。
第三,谁判。人工判还是模型判。让模型判自己的输出,等于让学生自己批卷子——这一条在教材里尤其要写清楚,因为学生最容易被"AI 说它对了"骗过去。
更关键的是:语法纠错真正难的不是"改对错的",是"不动对的"。一个把所有"的/地/得"统一改成"的"的系统,召回率很高,误改率也高,用户用两次就不用了。所以合格的指标至少该是两条——改对率(该改的改了多少)和误改率(不该改的改了多少),单看一个"准确率",等于只看一半。
我在这里不是吹毛求疵。教材教学生写一个数字,就应该教学生这个数字怎么被质疑。否则学生进入工作岗位,会拿着自己算的 90% 去汇报,而甲方一问"测试集多大"就哑了。
六、九个项目,只有客服那一个有"调试"
翻目录能看出一个很有意思的不对称。项目五(电商客服)的三个任务是:构建知识库、构建智能体、调试与优化智能体。其余八个项目的任务序列都是"设计功能 → 搭建 → 发布/应用",没有调试。
为什么偏偏是客服?我推断(这个词我用得很谨慎,因为书上没解释)是因为客服的输出有明确的对错:答错了要赔钱、要挨投诉。而其他场景——生成文案、出海报、做标志——只要"看起来像那么回事",就算完成。
这个不对称恰好暴露了全书的价值取向:以"能演示"为终点,而不是以"能上线"为终点。做教学案例这无可厚非,因为课堂时间有限;但如果读者把这本书当成落地手册,就会在第一章撞墙——真实的智能体项目,调试的时间通常比搭建长得多。
该给的肯定也要给。项目五开头区分"智能体"和"扣子应用",是全书概念讲得最清楚的一处:
智能体是扣子开发平台的核心功能,它以大语言模型为基础,通过系统提示词、插件、知识库等组件的组合,实现复杂的业务逻辑处理。扣子应用则是依托于大模型技术创建的,具备完整业务逻辑和可视化用户界面的独立AI项目,其特点之一是有明确的输入和输出。客户服务场景下的对话较多,且客户输入的对话内容无法预测,因此,扣子智能体相对来说更加契合开发需求。
这段话最后一句是判断——"对话多且输入不可预测,所以选智能体"。这比列一张对比表有用得多,因为它是从场景特征倒推形态,而不是让你背两者的定义差别。全书如果有十处这样的段落,这本书的分量会完全不同。
顺着这条线,项目六(视觉设计)又往前走了一步,讲怎么把工作流装进一个有界面的"应用"里:
在扣子应用中,后端功能通过设计业务逻辑(也就是工作流)实现,前端用户界面通过一系列组件搭建而成。完成前端、后端形式与功能的设计后,还需要通过数据绑定,将两者联系起来。
接着给的是最具体的一步——把界面上那个头像组件,绑到系统变量上:来源填 {{userInfo.avatarUrl}} 和 {{userInfo.nickName}}。这一屏(p2240)我第一次看的时候是有点意外的:一本讲"智能体"的书,肯花篇幅讲前端组件的取数路径,说明作者确实做过"能给别人用的东西",而不是停在对话框里自娱自乐。
但同样是"只教绑上、不教绑不上"。这套界面至少有三种必然出现的情况没写:用户没设头像时 avatarUrl 是空的(界面上就是一个破图)、数据还没回来时的加载态、接口失败时的兜底态。这三种状态占用户对产品的印象可能不到 3% 的时间,却决定了这 3% 里产品是"专业"还是"半成品"。而这恰好是"能不能上线"的分水岭——比任何节点配置都更像真活儿。
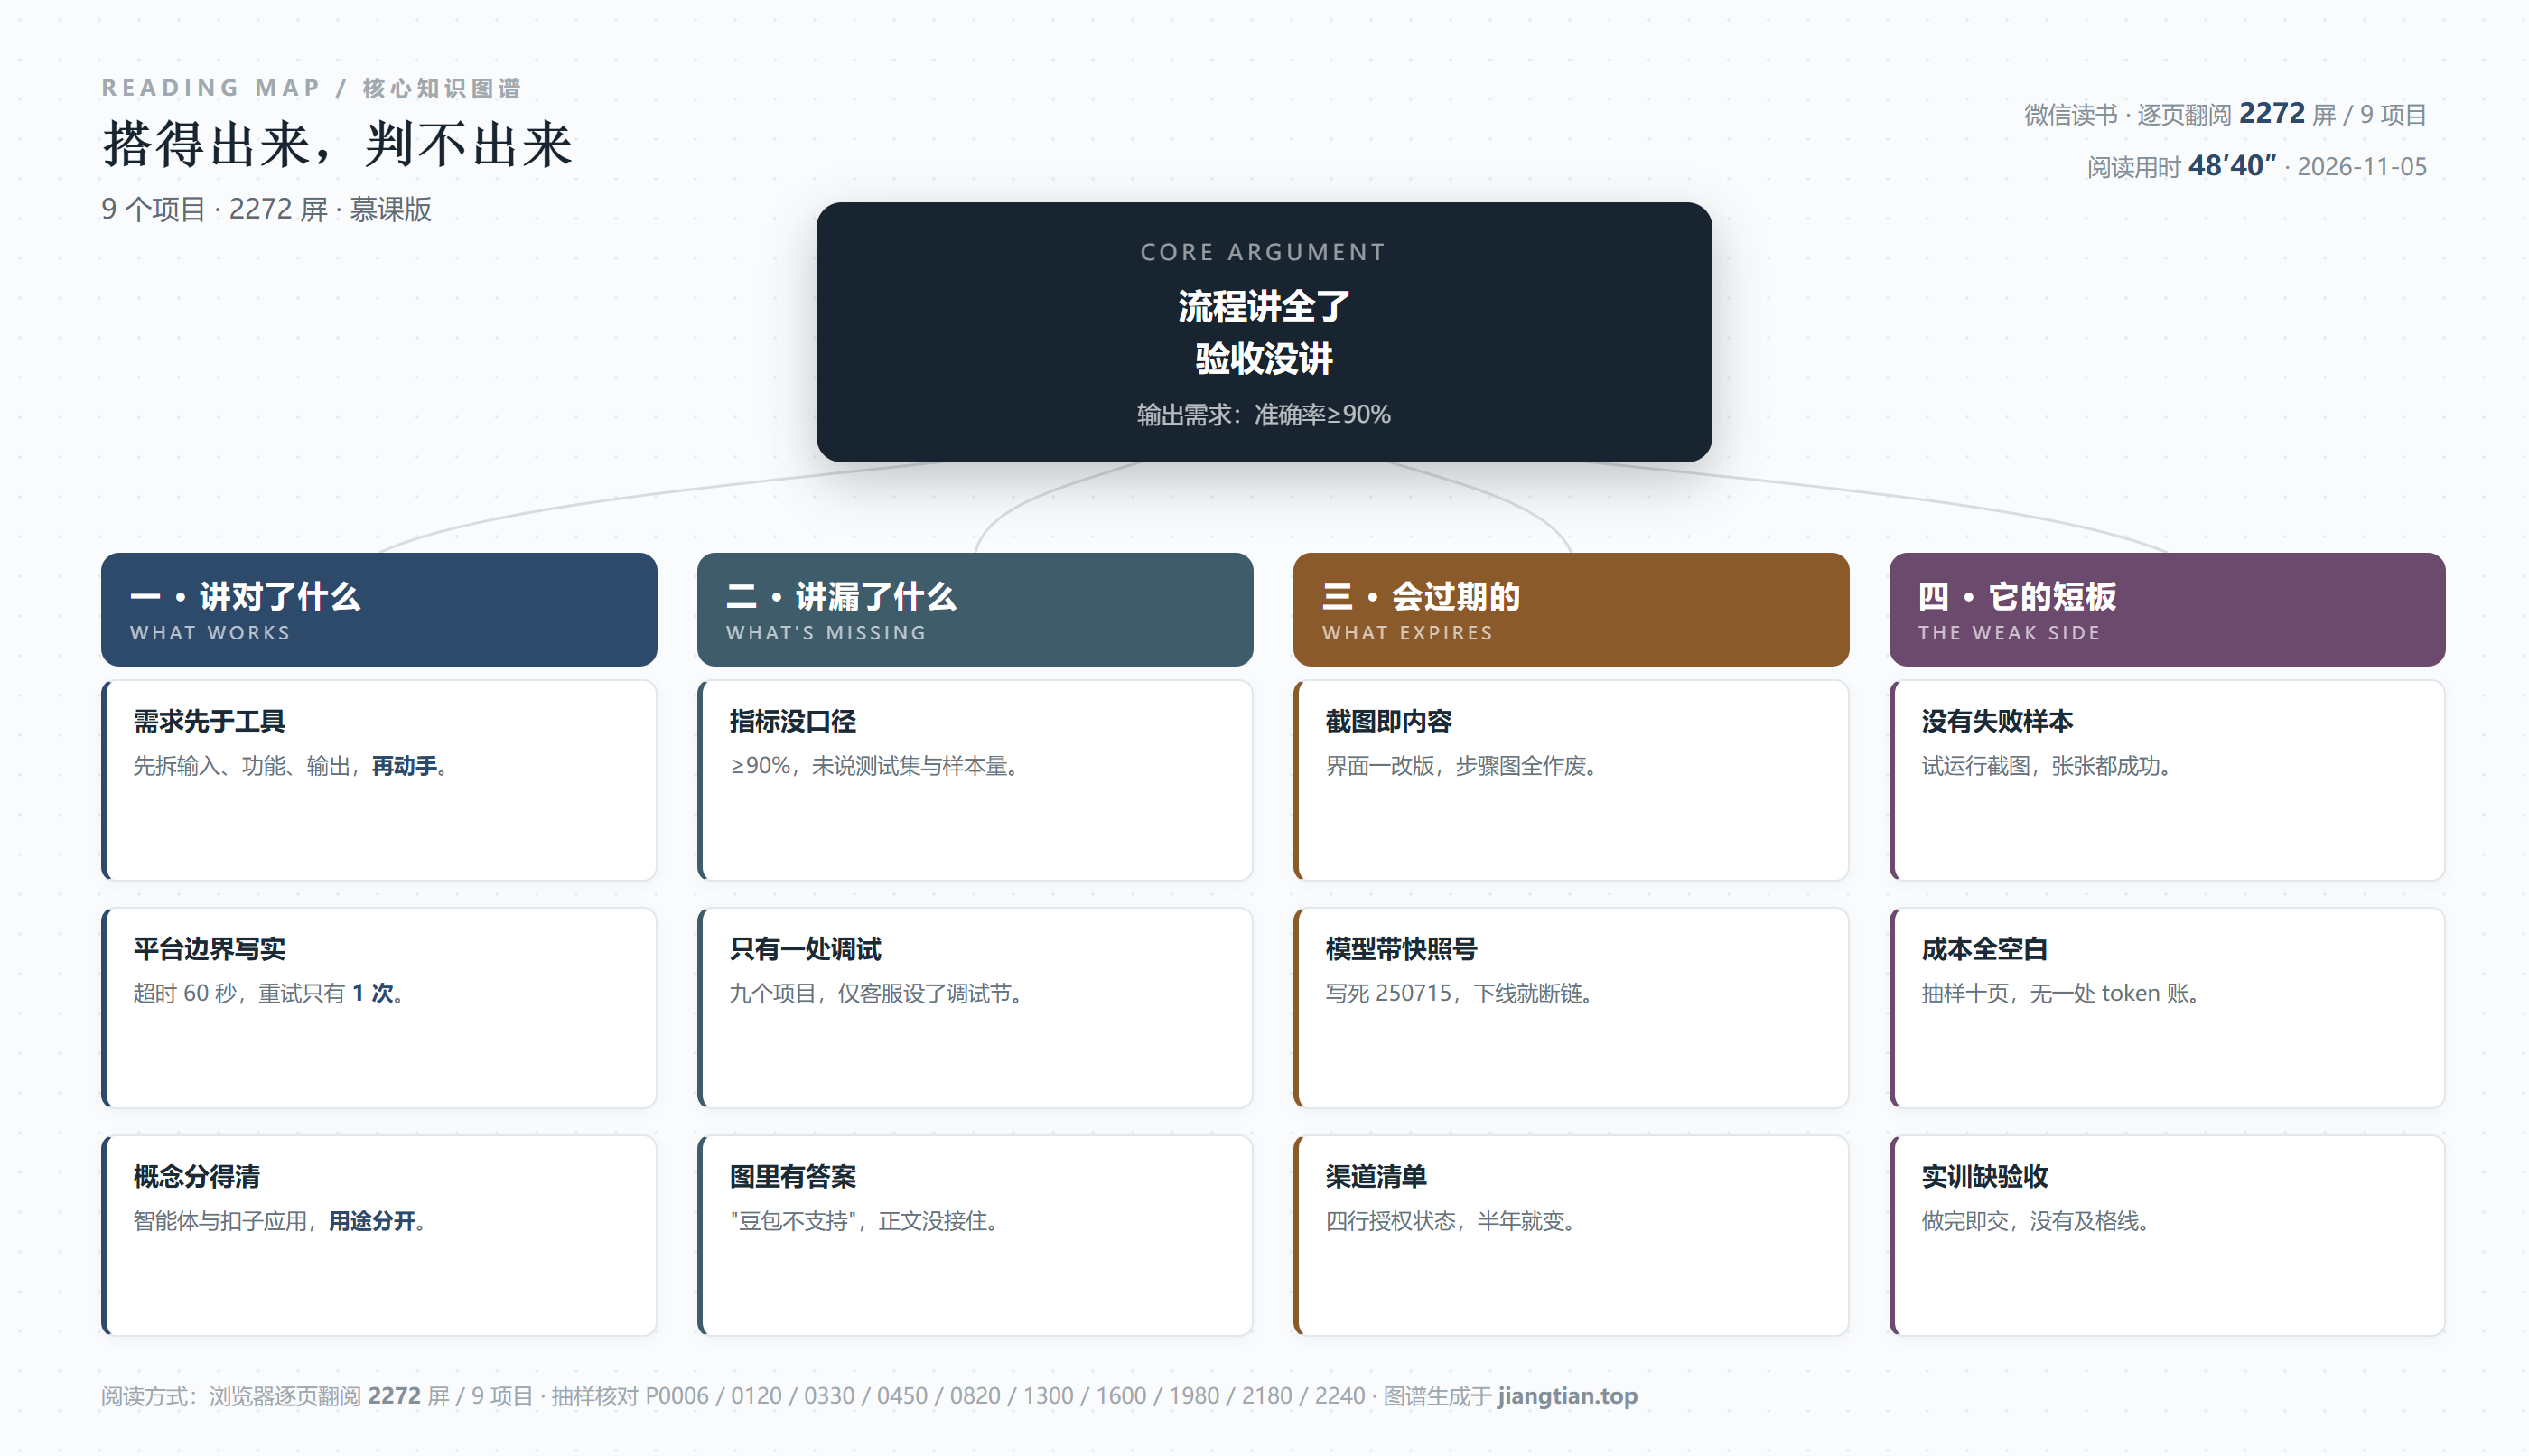
下面是这本书的结构图,四列分别是它做对的、它漏掉的、它会过期的、以及我判断的短板:
七、它的短板
按规矩,这一节我不留面子。
第一,全书没有一张失败的截图。我抽看的每一次"试运行",结果都是正确、漂亮、可展示的。可真实搭建的过程中,第一次跑通之前通常要改十几次,撞的坑高度集中:变量名和节点输出对不上、意图分类在边界样本上乱跳、知识库切片切断了半句话。这三处恰恰是新手 80% 的时间花的地方,书里一处没写。教学书可以只给成功案例,但至少该有一节叫"它不工作时长什么样"。
第二,成本一笔没算。我抽看的十页里,没有出现 token、延迟、并发、额度任何一个词。而这三件事决定一个智能体能不能真上线:客服智能体一天多少轮对话、一轮消耗多少 token、免费额度够撑几天、超了之后每分钟多少钱。这些数字比"怎么拖节点"重要一个量级,因为拖节点是可以自己摸索的,账单不是。
第三,把版本号写进了正文。讲意图识别节点时,书里的操作是"选择一个较新的大模型,此处选择'豆包·1.6'"后面跟着一串日期快照号(形如 250715)。这是教材的大忌——快照号会下线,读者按图索骥时会发现列表里没有这一项,然后怀疑自己操作错了。正确写法是给判断标准(上下文长度、是否支持函数调用、单价),而不是给一个具体型号。
第四,实训没有验收线。九个项目的"项目实训"都是"做一个 XX 智能体",没有评分表、没有必答项、没有"做到了算及格"的清单。教学场景下这是硬伤:学生交上来的东西,凭什么算过?如果我是编者,每个实训后会加三行——必须支持哪三种输入、必须在哪个渠道跑通、出错时必须在 30 秒内给出可读的提示。
第五,绑死一个平台,且没有"翻译层"。全书操作都在扣子的界面语言里:工作流、节点、插件、知识库、变量。这些概念在别的平台(Dify、n8n、百炼)都有对应物,但叫法和组织方式不同。书里没有一句"这个能力在别的平台叫什么",学生换平台等于重学一遍名词。前言里那句自述其实已经承认了风险:
尽管我们在编写过程中力求准确、完善,但AI技术、智能体技术发展迅速,相关领域的知识和实践也在不断更新,书中难免存在疏漏和不足之处。
这句话是所有技术教材的通用免责声明,但放在这本书里格外准确:落款是 2026 年 3 月,而书里引用的模型快照是 2025 年 7 月的。也就是说,这本书从签字付印那天起,正文里至少有一处已经开始折旧了。
第六,目录的体例是残的。45 条目录里,带【项目导读】知识目标、素养目标、【项目实训】、【拓展延伸】、课后思考这一整套教学模块的,只有项目一。项目二到项目九,目录里只剩"任务一、任务二、任务三"三行。两种可能:一种是目录收录时深浅不一(那就是索引失效,拿目录当检索表的人会漏掉八章实训);一种是后八个项目真的没配实训与思考(那就是体例不齐,学生练不了)。无论哪一种,都不像一份校对过的目录。我只过了一遍目录,无法确认正文里这些模块是否真缺,所以这条按"存疑的硬伤"记——但它确实是我翻目录时第一个注意到的异常。
八、一句话
如果你只带走一句:搭一个智能体是体力活,判断它什么时候会错才是手艺。这本书把体力活教到了满分,手艺那部分只留了一句话。
所以读它的正确姿势是:跟着做,但每做完一个项目,自己补三个动作——
一,把这个智能体故意问倒一次,记下它错在哪一类问题上(是不知道、是知道但说错、还是答非所问)。这三类的修法完全不同。
二,把它的输入按书里给的限制往上顶:文本顶到 500 字、文件顶到 10MB,看它在边界上怎么崩。
三,去发布页把每个渠道都点一遍,看哪一行灰字跳出来。那一行灰字,比整章"多平台分发"都值钱。
阅读记录:《AI智能体搭建与应用(基于Coze)(慕课版)》,乔海晔、杨志明 主编,蔡嘉婧、刘伟奇 副主编,前言落款 2026 年 3 月,微信读书网页版逐页翻阅 2272 屏 / 9 个项目 45 条目录,2026-11-05。
抽样页:p0006(前言与编写组织)、p0120(输入需求与量化标准)、p0330(图 5-11 意图识别节点与模型选择)、p0450(图 7-19/7-20 头像生成节点配置)、p0820(代码节点超时与重试上限)、p1300(图 7-48 发布渠道与授权状态)、p1600(图 4-33 试运行结果与出错处置)、p1980(输出需求与准确率指标)、p2180(智能体与扣子应用之别)、p2240(前端数据绑定 userInfo 变量)。
备注:本书为"项目式"教材,九个项目均有配套慕课视频与 PPT 教案(前言载明可登录人邮教育社区 www.ryjiaoyu.com 获取),我未核验配套资源。
发表评论: