
Midjourney AI绘画商业案例:提示词抄得走,试错过程一页没留
微信读书《Midjourney AI绘画商业案例创意与实操》· 7 章 · 200 条目录 · 544 屏
逐页翻阅 544 屏 · 7 章 · 200 条目录 · 抓取章节序列与目录一致,无跳章 · 2026-11-05
说明:我从第 1 屏翻到第 544 屏。抽看了前言、1.1 星空歌剧院的版权之争、1.2 GAN 的比喻、1.3 与 1.4 法规、《办法》第四条原文、2.4 Discord 频道、2.8 设置命令、2.9 参数、2.10 局部重绘、3.4 ControlNet、LoRA 与数据集要求、3.5 Dreambooth、4.3 三工具评测、6.2 老板电器、6.3 特斯拉、6.8 农业主题、6.10 AI 女性艺术展、7.3 展望。判断只以抽到的这些页为准,外部产品的现状我不替它补。
先说结论:这本书最值钱的不是那十个案例,是第 1 章讲法规和版权的那二十来屏。而它最像"商业案例集"的第 6 章,恰恰是全书最不像案例的一章——十个案例里没有一个给出成本、周期和转化,给的是点赞数。
544 屏、7 章、200 条目录。这个体量在 AI 绘画类图书里算厚的,排法也清楚:第 1 章通识(原理、版权、法规),第 2 章 Midjourney,第 3 章 Stable Diffusion,第 4 章 DALL·E 3 与三工具横评,第 5 章商业逻辑,第 6 章十个案例,第 7 章展望。三个工具各占一章、再横评一次,这个结构是对的——它承认了一件事:AI 绘画没有"最好的工具",只有"这件事该用哪个工具"。
但厚不等于实。它的强项和弱项分得极其清楚:凡是"讲道理、讲规则、讲概念"的地方,它比同类书认真;凡是"讲效果、讲案例、讲商业回报"的地方,它退回到"给你看几张好看的图"。下面按章节顺序说。
一、第 1 章最不像 AI 绘画书,也最值得读
大部分 AI 绘画书的第 1 章是"什么是 AI 绘画",讲三段就进软件。这本书的第 1 章占了相当大的篇幅讲三件事:作品版权归谁、训练数据合不合法、生成内容受什么管。
1.1 节从一个真实争议切入——"星空歌剧院,创意及荣誉归属之争":一幅用 AI 生成的图拿了奖,画师、提示词作者、工具方各自的主张是什么。这个开场选得好,因为它把"版权"从抽象法条变成了一个具体的人在争一个具体的奖。
1.4 节引了《生成式人工智能服务管理暂行办法》的原文:
"提供生成式人工智能产品或服务应当遵守法律法规的要求,尊重社会公德、公序良俗,符合以下要求……(二)在算法设计、训练数据选择、模型生成和优化、提供服务等过程中,采取措施防止出现种族、民族、信仰、国别、地域、性别、年龄、职业等歧视……"
引完条款之后,它做了一件多数同类书不会做的事:把"算法、模型、规则"三个词各给一条定义(算法是"一组解决问题或执行任务的明确、有序的步骤和指令",模型是"通过算法从数据中学习得到的用于预测或分类的数学表达式或结构",规则是"明确的指导原则或条件"),然后说明为什么监管范围要从"算法"扩到"模型与规则"。
这一步很关键。读者真正会踩的坑,往往不在"我能不能用 AI 画图",而在"我这张图属于算法生成还是模型生成,出了事谁担"。把三个词分清楚,等于把责任链条分清楚。
我的判断是:这一章是全书唯一不会过期的部分。参数会变、界面会改、版本号会跳,但"训练数据从哪来、生成物归谁、商用要不要授权"这三个问题,五年之内都不会有定论,只会越来越具体。一本讲工具的书,最该被反复翻的往往是它讲规则的那一章——这一章恰好是全书最不像"AI 绘画教程"的一章,也是它最有独立价值的一章。
1.2 节讲原理,用的是比喻,而且用得很好。它把生成对抗网络写成一场"艺术大师"与"艺术鉴赏家"的对决:
(1) 艺术的对决。艺术大师(生成器)试图用他的技巧和创意去迷惑艺术鉴赏家。每创作一幅画作,艺术鉴赏家(判别器)都会进行评价,指出画作中不真实的地方。
(2) 不断进步。通过判别器的反馈,生成器不断地完善自己的技巧,使得自己的画作越来越真实;与此同时,判别器也在不断地学习和提升,变得越来越敏锐。
(3) 达到高峰。经过一系列的对决后,生成器的画技已趋近于完美,即使是经验丰富的鉴赏家也无法轻易分辨画作的真伪。
(4) 在 AI 绘画中的意义。生成对抗网络就像是这场艺术大师(生成器)和艺术鉴赏家(判别器)的对决。
这段写得漂亮,好在三点:一是把两个抽象模块换成了两个有动机的角色(一个想骗,一个想抓);二是四步对应训练的真实进程(互相进步、判别器变强、生成器逼近、收敛);三是每段都用括号把术语补回去,读者不会只记住故事、忘了名词。这是科普写作里最难的一种平衡:通俗,但不失真名。
如果要挑一处,我会说第三步的措辞容易让人误解。原文写"即使是经验丰富的鉴赏家也无法轻易分辨画作的真伪",技术上对应的是"判别器无法区分"——那不是"画得完美",而是"两者的分布已经近到判别器分不出来"。用"达到高峰"形容,会让人以为 GAN 的目标是"画出完美的画",实际上它的目标是"让判别器猜不准"。这个差别在读者动手训 LoRA 时会显出来:他以为要追求"更好看",其实要追求"更像目标分布"。
二、Midjourney 那一半:一本写得不错的参数说明书
第 2 章从 2.1 到 2.11,占了全书近三分之一。骨架很传统:Discord 是什么、怎么注册、界面分区、订阅方案、版本差异、设置命令、参数、局部重绘、作品管理。
写得最实的是 2.10 节"局部重绘"。它没有停在"点这个按钮",而是把界面上的动作逐一说清:
图 2-135 选中并放大图像
(3) 选择不同区域。单击"Vary(Region)"按钮,打开编辑界面,如图 2-136 所示。
(4) 选择要再次生成(即局部绘制)的区域。选择编辑器左下角的矩形选择工具,也可以选择编辑器左下角的手绘选择工具。
这段的价值在于它给的是路径,不是结果:哪个按钮、在界面哪个角、点了之后出现什么。同类书常见写法是"使用局部重绘功能修改画面细节",一句话带过,读者对着界面找不到入口。这本书把"左下角"这种位置信息写出来了,这是真正动过手的人才写得出的细节。
2.8 的设置命令也做得细:把 /settings 里的九项拆开讲;2.9 的参数表把纵横比、质量、图像权重、风格、风格化、混乱、排除、重复、种子九类各给一条。加速那一节写着:
Turbo mode、Fast mode 和 Relax mode 分别在 Turbo、Fast 和 Relax 模式之间切换……对应 /turbo、/fast、/relax 命令以及 --turbo、--fast、--relax 参数。
信息是对的,但标题译法有问题:它写作"7 加速 快速和放松模式",把 Relax 译成"放松"。而界面上的按钮就叫 Relax,不叫"放松"。读者按书里的中文去界面上找,找不到;找到了也不敢确定是不是同一个东西。这类"译名与界面不一致"是操作类图书最常见的暗坑——不影响理解,但让每一步多一次犹豫。同类问题还有 2.7 的"模型版本 + --style raw(原始风格)","--style raw" 是要照抄进提示词的,括号里的中文却给了"原始风格",读者很容易把中文也打进提示词。
这段内容在成书时是有用的,但它属于全书最容易过期的一类。频道结构是平台运营方随时会改的东西,改一次,这几十屏就全废。更要紧的是:Midjourney 后来把出图入口搬到了网页端,不少读者根本不需要经过 Discord 就能生成。一本书把五分之一的篇幅押在一个中间层上,等于把自己的保质期交给别人管。
三、截图里的提示词有一处拼写错误,正文一句没提
还是那张图 2-135,放大后能看到一条真实跑过的提示词:
Christmas bow, in snow pine tree, beautiful sunlight, dof, dsil --ar 16:9 - Image #3 @有饭
注意中间那个 dsil。按上下文它应该是 dslr(单反相机那类景深质感的关键词)。一个字母错位,而正文对此没有任何说明。
为什么这一处值得单独说?因为提示词是这本书的核心交付物,读者会逐字照抄。照抄的结果是:出图效果和书上的样例不一样,而读者不知道自己错在哪——他以为是版本不同、是运气不好、是"我审美不行",实际上是那个不存在的词被模型整段忽略了。一个字母的代价,是一整轮自我怀疑。
同类问题还有空格和标点:--ar 16:9 前面必须有空格,逗号不能把参数粘住,中英文逗号混用会让后面的词被当成普通描述。这些规则书里散落着提过,但没有集中成一节。我给一条可执行的检查法,做完不到一分钟:
第一步,拼写。把提示词复制到记事本,逐个看那几个反复用的关键词有没有错位(dslr、bokeh、cinematic、volumetric 这类最容易打错)。第二步,分隔。确认每个 -- 前面是空格,不是逗号,也不是中文逗号。第三步,顺序。把参数统一挪到句末——模型对靠后的参数更敏感,混在句子中间容易被当成描述词吞掉。
我还想补一句更根本的:这本书教了"提示词可以多长、该有哪些成分",没教"提示词错了怎么发现"。而后者才是实操里最耗时的部分。判别方法很简单——同一段提示词跑两遍,只改一个词,看变化是否符合预期;如果两遍几乎一样,说明那个词根本没被读进去。这个动作叫单变量对照,一页纸能讲完,全书没有。
四、Stable Diffusion 那一半:比喻很准,自相矛盾也很明显
第 3 章是全书信息密度最高的一章。3.3 讲正向与负向提示词,3.4 讲 ControlNet 的八类预处理器(OpenPose 姿势、Depth 空间深度、Segmentation 品类、风格控制、Inpaint 重绘、IP2p 特效、Tile 补细节),3.5 讲 LoRA 训练,3.6 讲 Dreambooth。八类预处理器各配一句用途说明,这是很实用的排法——它把"ControlNet 有一堆模型,我不知道该用哪个"变成了"我要控制姿势还是控制深度"的选择题。
LoRA 那一节的比喻是全书写作水平第二高的地方:
Stable Diffusion 中的 Checkpoint 大模型可以理解为一本大字典,读者翻阅许久却找不到想要的内容,如果想要更新这本字典的内容,就要动用大量人力物力。而 LoRA 就像写着字的一页页书签,一方面准确地指明了与读者想要内容相关的页数,另一方面写在上面内容正是读者想要内容的补充……注意,这个书签也需要搭配字典的内容使用,所以 LoRA 需要与之匹配的大模型一起使用。
这个比喻把 LoRA 的两个技术特征都说对了:一是"小"(一本书对几页书签),二是"必须挂靠"(书签离开字典没有意义)。很多人第一次用 LoRA 出图失败,就是底模版本不匹配,而"书签必须配这本字典"一句话就讲清了。
但紧接着,同一节出现了这本书里最刺眼的一处自相矛盾。前面写:
训练的技术要求很高,过程很复杂且漫长……是否可以训练更简单、更快速?并且能让 AI 生成的图片满足特定的效果呢?LoRA 至此横空出世。
LoRA 可以帮创作者微调画面,达到预期效果。甚至个人 PC 就可以进行训练,极大降低了模型训练门槛(虽然 Stable Diffusion 工具硬件配置门槛不低,但相比专业服务器而言已大大降低)……
而在 LoRA 训练那一节的开头,又写:
对于这些觉得"大模型"是一个高不可攀的概念的人来说,这里有一个小秘密:训练大模型并不像想象中那么复杂,它就像是做一道家常菜……只要熟悉并掌握其中几个关键"调料"——模型选择、数据准备、参数调整等,跟随教程一步一步来,就会发现训练大模型就像炒个鸡蛋一样简单。
两句话摆在一起:一句说"复杂且漫长",一句说"像炒鸡蛋一样简单"。中间隔了不到三十屏。这不是修辞问题,是判断问题。训练 LoRA 到底难不难,取决于你要什么:跑通一次流程,一下午就够;训出一个能稳定复现某张脸的模型,要反复调数据集和参数,几天起步。作者显然两种都经历过,但书里只留下了两个极端的说法,中间那段"到底难在哪"被略过了。
这一节唯一给出的硬指标是数据集要求,而且给得不错:不少于 15 张高质量图像,一般可以准备 20 到 50 张;主体特征明显、不残缺不遮挡、构图简单;角色照以脸部特写为主,多角度多表情;不同姿势与服装各备半身与全身;减少高度相似的图。
"15 张下限、20 到 50 张常规"这个数字,是全书少见的可执行指标,值得表扬。但几条要求之间有个没说出口的冲突:"构图简单、避免杂乱"和"多角度、多表情、不同服装"是往两个方向拉的。前者要背景干净,后者要变化足够。真实操作里这两条要靠"同一场景、不同姿态"来同时满足,书里没点破这一层,读者按字面理解,很容易收一堆背景各异的自拍,训出来的模型把背景也学了进去。
3.4 节的姿势复刻案例(图 3-20 到 3-22)讲手指:
除了识别人物整体姿势以外,还可以识别图中人物的手指骨骼,可以在一定程度上避免生成多手指或者缺少手指的"恐怖"照片。
"在一定程度上"这五个字用得老实,值得肯定——它没夸大成"解决了"。但读者最想看的恰恰是那个"一定程度"到底有多大:同一个种子、同一段提示词,开与不开 OpenPose,各出四张,摆在一起。这种对照图一张顶三页文字,全书没有。这是我认为它作为"实操书"最大的缺口:它给条件,不给对照结果。
唯一接近这个标准的是图 3-88 与 3-89——同一栋别墅、同一视角,一张写成冬天、一张写成着火。同一底图、只换描述词,这才是对照。可惜全书我只找到这一组,而且没说明它们是不是同一个种子、只改了哪几个词。
五、三工具评测:给了星级,没给口径
4.3 节是"本书三大绘画工具详尽分析",核心是一张带星级的对比表(图 4-12)。行目我抄下来:风格控制、画面内容控制、文字控制画面、功能丰富程度、可使用模型数量、是否开源、能否自行开发迭代、内容限制、版权。列目是三款工具。
先说好的:这张表把"是否开源""能否自行开发迭代""版权归属"三行放进去了。这三行是决定"能不能商用"的关键,而绝大多数工具横评只比画质。表里"版权"那一行的写法也很具体——"付费用户拥有版权""使用模型前须阅读作者许可证和使用条款""用户拥有版权(含敏感内容检测限制)"——括号里那句限制,比一个"有"字有用得多。
问题出在星级本身。五档星、九行,没有一处说明评分口径:谁打的分、用什么提示词测的、测了几张、什么时候测的。没有这四项,星级就只是观感。举个具体的:表里"文字控制画面"这一行,把 DALL·E 3 排在明显靠后的位置,而这一项恰恰是它被公认较强的地方——我不敢断言是判断错误还是排版错位,只能说读者拿这张表去选工具,选的其实是一个没有出处的印象分。
同页正文的结论也偏软:
截至本书成稿,DALL·E 3 虽然部分作品已表达出较高的创作水准,但与另外两款软件仍有一定差距。现阶段 DALL·E 3 用来做 AIGC 启蒙或单纯作为提示词练习,是很不错的选择。
"截至本书成稿"这六个字是全书最有价值的一处限定,我给很高的评价——它等于告诉读者"这条结论有保质期"。但这句话只出现了这一次。如果每一章开头都有一句"本节基于某年某月的某个版本",这本书的可用寿命会长一倍。现在的情况是:读者知道 4.3 那页会过期,却不知道 2.7 的版本表、2.9 的参数、2.11 的下载入口,哪些还在、哪些已经不对。成本一行字,收益是读者知道该信哪一页——这本书把它写在了 4.3,没写在第 2 章,而第 2 章才是最容易被改版冲掉的地方。
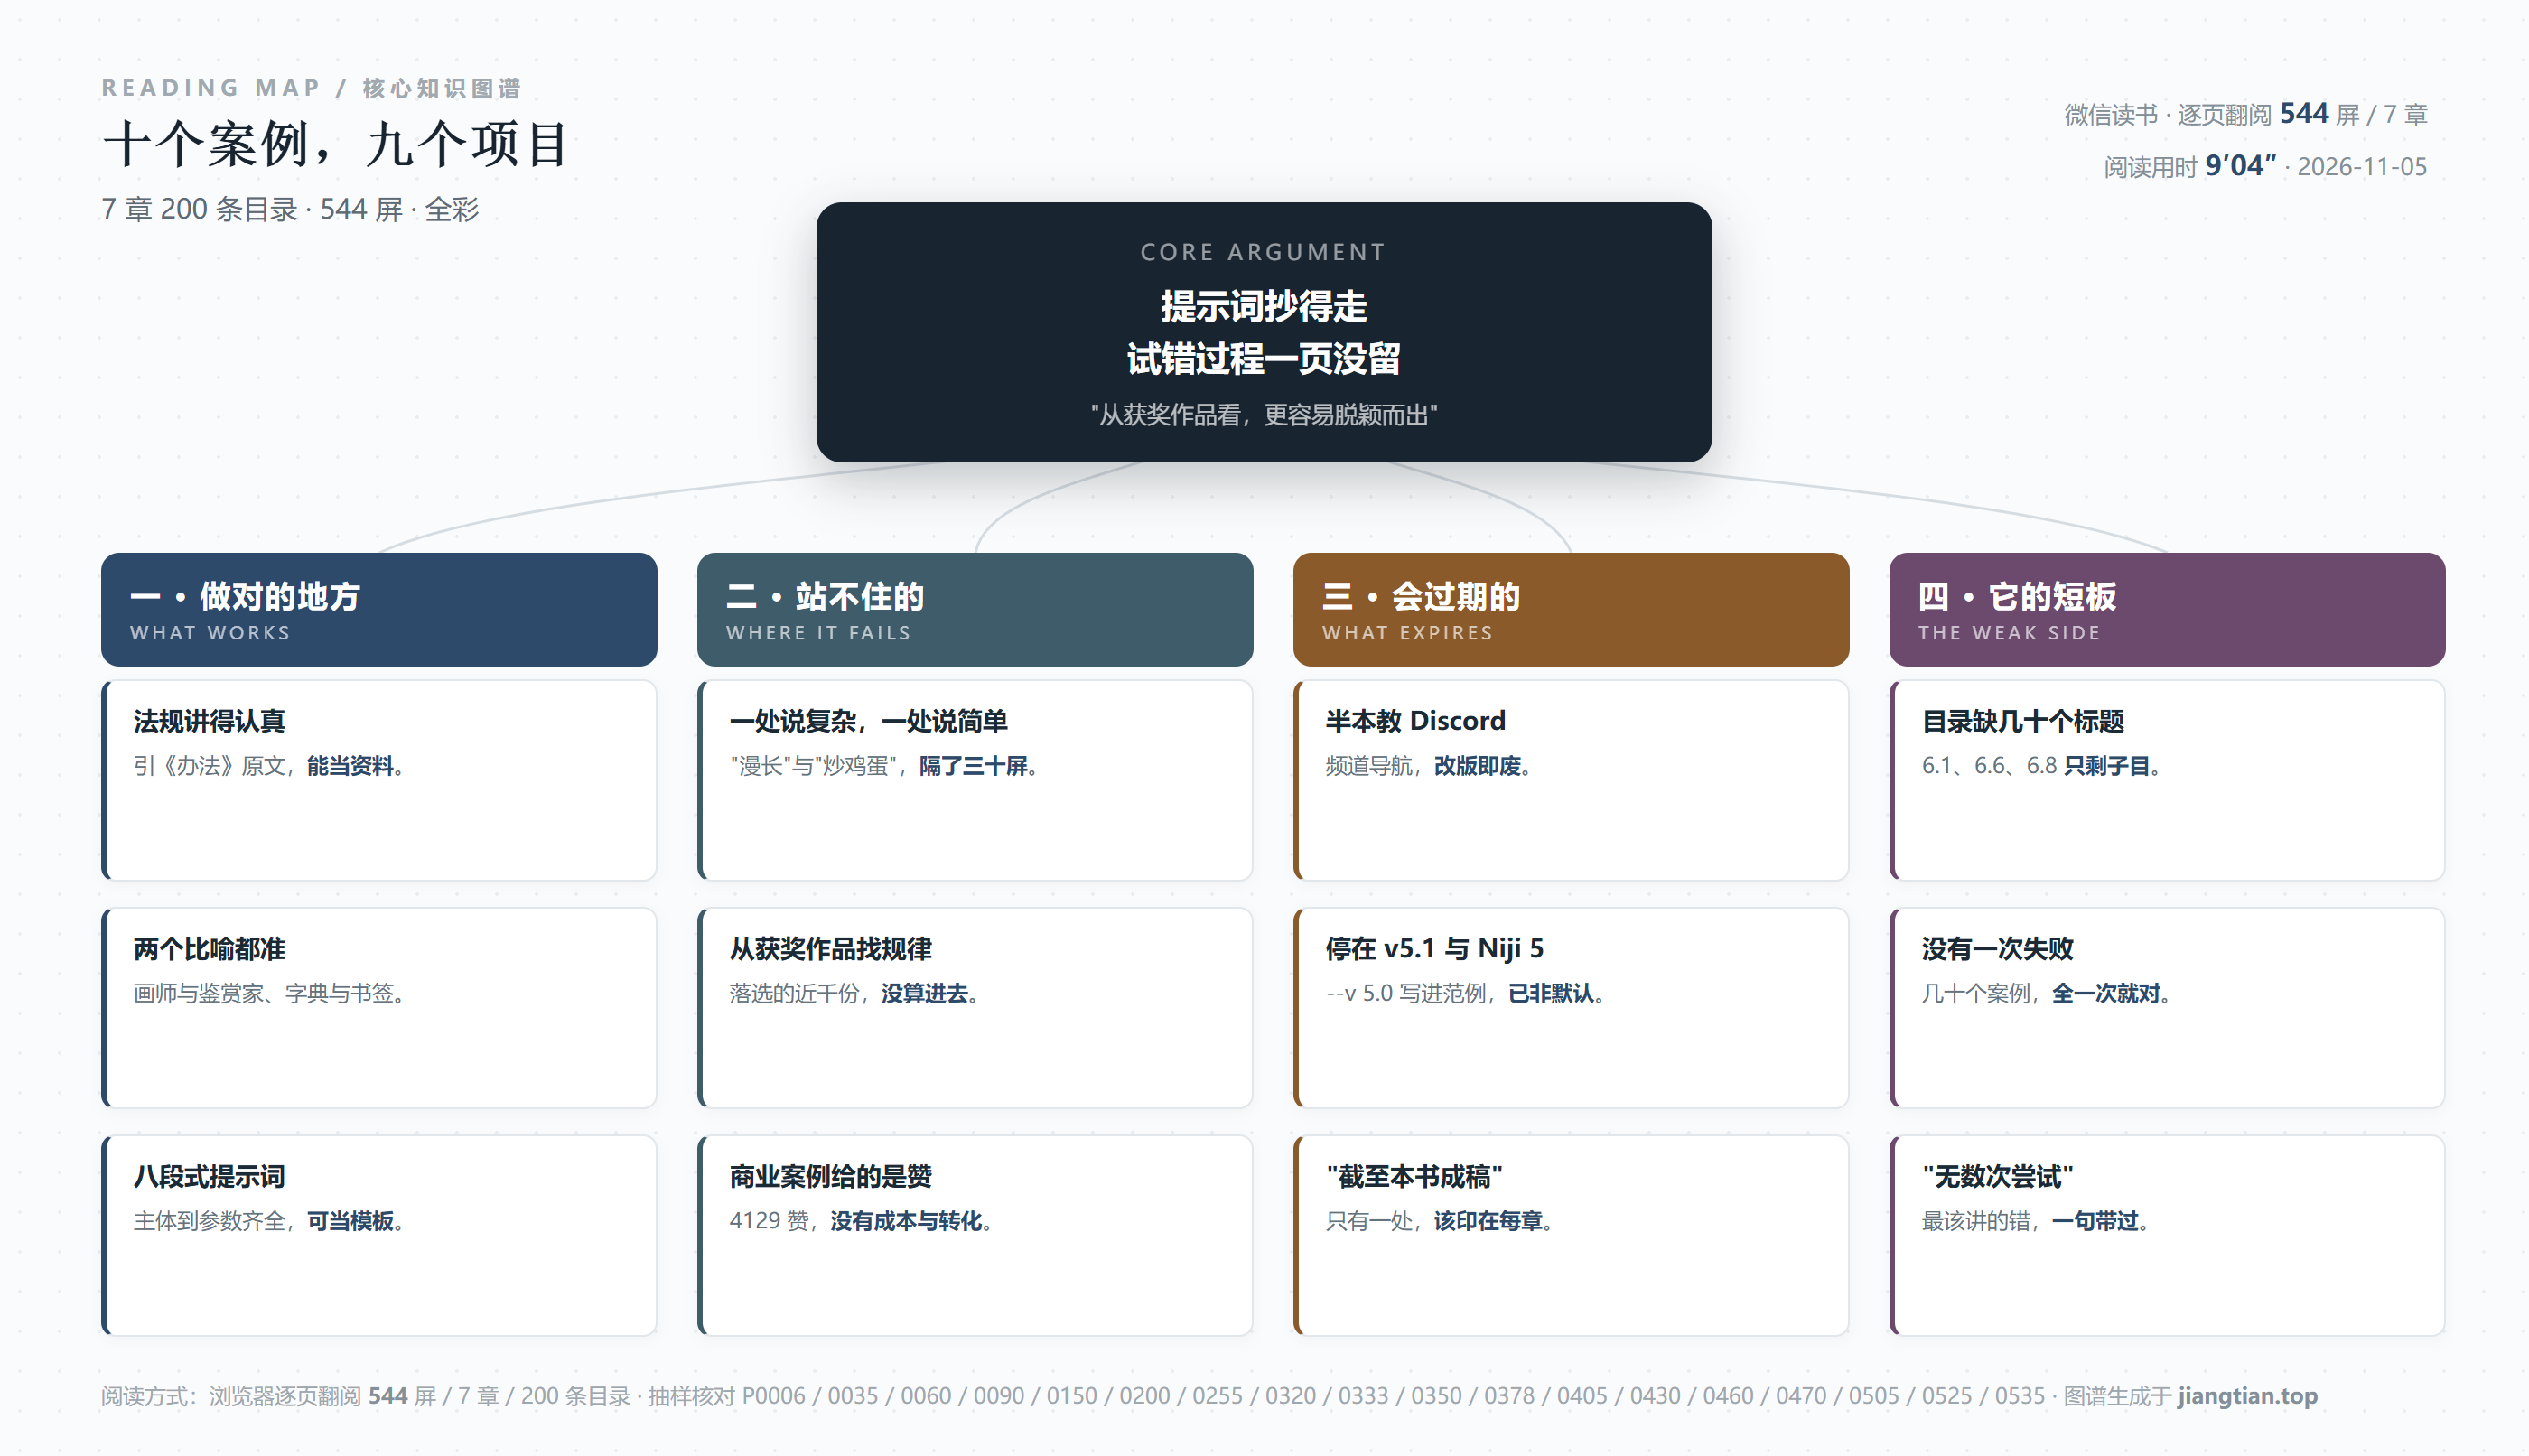
下面这张图是我把全书读完后的结构梳理,四列分别是它做对的、站不住的、会过期的、以及它的短板。
六、十个案例,更像作品集
第 6 章标题叫"AIGC'十全十美'案例集",十节,每节四段:项目背景、灵感思路、执行过程、最终交付。这个四段体选得好,它恰好是一个项目的真实生命周期。里面涉及品牌也硬:老板电器、特斯拉、腾讯、阿瑞纳 50 周年、麦当劳、AI 女性艺术展。
但读完十节,我发现一个始终没说清的问题:这些项目,谁做的?
6.3 特斯拉那一节,"最终交付"写的是:
本书特别推荐有饭同学的视觉银奖作品——《逃离》,如图 6-8 所示。她使用 Midjourney 完成了这幅耐人寻味的画作。她说,创作时她对现实充满焦虑,对未来却抱有无限憧憬。
6.8 农业主题那一节,"执行过程"写的是:
在项目执行过程中,社群累计投稿超过千份,技法涵盖摄影、油画、水彩等多种风格。但从获奖作品看,借鉴中国传统艺术元素的创作在这个主题中更容易脱颖而出,如图 6-37 所示。
两段放在一起,事情就清楚了:这些不是作者承接的商业项目,而是品牌方发起的征集活动,书里展示的是获奖作品。这不是问题——收录优秀作品本来就是案例集的常见做法。问题在于它套用了"项目背景、灵感思路、执行过程、最终交付"这个第一人称的复盘格式,却始终不交代主体:读者会默认"执行过程"是作者写的、"最终交付"是作者交的,实际上那是投稿者做的。署名和角色一旦模糊,读者学到的就不是"如何接一个品牌项目",而是"如何参加一次比赛"——这是两种完全不同的能力。
第二处问题更硬:从获奖作品里总结规律,是最容易犯的错。上面那句"从获奖作品看,借鉴中国传统艺术元素的创作在这个主题中更容易脱颖而出",逻辑上少了一半样本。落选的那近千份里,有多少也用了传统元素?没有这个数,"更容易脱颖而出"就不成立——如果落选作品里也大量是国画风,那获奖的原因就不是风格,而是构图、完成度,或者评审偏好。这类推断在书里不止一处,它是"幸存者偏差"的教科书式标本:只看活下来的,然后从活下来的身上找共同点。
第三处问题,是"商业案例"这四个字本身。6.2 老板电器那一节,唯一的数据是:
图 6-3 广告片放出后,在社交媒体上获得热烈响应
(飞书公众号:4129 赞、4096 转发、2498 收藏、187 评论)
这是传播数据,不是商业结果。一个商业案例集的合格线,是回答三个数:花了多少(人力、算力、时间)、多久交付、换回了什么(曝光成本、线索、转化)。这本书给的是点赞和转发,缺的恰恰是最贵的那三个。我能理解为什么缺——品牌方不公开预算,参赛者也不知道转化——但既然书名里写了"商业",这三样至少要交代一次"为什么不给"。不交代,读者就只能把"看起来很成功"当成"商业上成立"。
第四处,是那句全书出现频率最高、信息量最低的话。6.10 写 AI 女性艺术展的创作过程:
经过无数次的尝试和修正,我们终于创作出了几幅作品,完美地展现了叶蓉老师的诗意描述。
"无数次"这三个字,是这类书最典型的逃逸词。读者最想知道的恰恰是那"无数次"里的前三次错在哪:是主体跑偏、还是光影不对、还是提示词里"诗意"这个词压根没被理解?把前三次的废图和修改理由贴出来,这一节的价值会翻三倍。现在它只留下成功的那几张,过程和结果之间断了一整段。
也有写得好的地方,我得说清楚。6.8 那一节给了一条完整的提示词,是我在全书中找到的最可复用的结构:
…驾驶机器人,Des glaneuses(《拾穗者》),sci-fi(科幻),juxtaposition of tradition and future(传统与未来),golden crops(金色庄稼),dusk lighting(黄昏光影),detailed(细节)--v 5.0 --ar 16:9
这条提示词的成分是齐的:主体(驾驶机器人)、参照(《拾穗者》)、风格(sci-fi)、关系(传统与未来的并置)、内容(金色庄稼)、光(黄昏)、细节(detailed)、参数(版本、画幅)。八段齐备,而且"传统与未来"这种抽象关系是用"并置"这个词落实的,不是靠堆形容词。这段可以直接当模板改,是第 6 章里最实用的一页。
顺带说一句 5.4:它把写法分成"收敛型"与"释放型"——前者先想清楚要什么再往目标收,后者先让模型给一堆再看中哪个。这是全书唯一一处方法论层面的东西,比十个案例都值钱,却两页就讲完了。我补一条判据:能一句话说出验收标准的,用收敛型(海报、包装、电商主图);只能在看到东西之后才知道好不好的,用释放型(概念探索、情绪板、分镜)。
七、它的短板
这本书的"讲理"部分我给高分,"讲做"部分给及格,"编辑质量"给不及格。下面几条必须写清楚。
第一,目录缺标题缺到影响检索。200 条目录里,6.1、6.6、6.8 三节直接以子目开头("6.1.1 项目背景"),章节标题整条不见;1.2.2、1.4、2.4、2.6、2.10、3.3、3.4、3.5、3.6、4.2、5.2、5.3.1、5.4 这些编号的位置只剩内容条目,序号本身没有。我点得出名字的断点有十几处,实际只多不少。更要紧的是,1.2 下面有一行印成了"GAN 对 AIIG 的作用和意义"——AIIG 应为 AIGC。目录是这类书的检索入口,读者靠它跳转;标题缺了,跳不过去,只能一页页翻。
第二,"十全十美"是十节,不是十个项目。6.9 与 6.10 是同一个展览的上下篇,实际项目是九个。这个数字不重要,重要的是它暴露了一种凑数习惯:把一个项目拆成两节,好让章节标题对上一个成语。凡是为对齐标题而拆分的结构,读者都会在阅读时感到重复——6.10 里"叶蓉老师的诗意"那段,在上下两节里说了两遍。
第三,半本书押在一个中间层上。2.1 到 2.5、再加 2.11,五六个小节、几十屏,讲的全是 Discord 的频道、身份组、隐藏频道、社区活动。这些内容在平台改版后价值立刻归零,而它占的篇幅,足够讲完"如何用提示词控制构图"这件真正决定出图质量的事。
第四,版本全线停在过去。2.7 的版本表写到 5.1、5.0、4.0 与 Niji 5,2.8 的风格化参数、2.9 的参数表,全部基于这一代;6.8 的提示词里还写着 --v 5.0。这不是错,是"到岸价"——买书的人拿到手时,书里教的那一代已经不是默认版本了。同类书最该做的一件事,是在前言里明确写"本书基于某版,新版差异见官方文档",这本书的前言只说了"技术迭代快",没给时间锚点。
第五,没有一次失败。544 屏、几十个案例,我没看到一处"这张图废了,原因是……"。所有人一次就对,所有项目最终都"完美展现"。对一本教人动手的书来说,这等于把最难的那部分删掉了。读者照着做出不来效果,只会怀疑自己,而不是怀疑流程里缺了纠错环节。
第六,第 7 章的预言过猛。7.3 写"那些常驻手机的 APP 可能会逐渐失去它们的地位""与其打开各种应用,不如直接与 GPT、Midjourney 这样的 AI 助手对话",还断言"广告商才是其真正的'金主',但在 AIGC 时代,这类商业模式可能会被彻底颠覆"。这些判断没有时间表,也没有判据——什么条件下成立、什么条件下不成立,一句没有。预言最该配的是"如果……就……",而不是"可能会"。这类段落读着有气势,实际上不可验证,也就不承担任何风险。
最后说几句公道话。第一,第 1 章的版权与法规梳理是同类书里少见的认真,引条款、给定义、分监管范围,能当资料用;第二,GAN 的"画师与鉴赏家"、LoRA 的"字典与书签"这两个比喻是全书写作水平的顶点,讲清机制又不失真名;第三,ControlNet 八类预处理器的用途对照,是全书信息密度最高的一节;第四,6.8 那条八段式提示词可以直接当模板;第五,"截至本书成稿"这六个字,说明作者知道自己在写一份有时效的东西。这五处撑住了它的价值。
八、一句话
如果你只带走一句:这本书把"能出图"讲清楚了,把"为什么这张图能卖钱"留在了原地;提示词抄得走,试错过程一页没留。
它该怎么用?我的建议是拆成三块:第 1 章当法规资料读,反复查;第 2、3、4 章当参数手册,需要时翻到对应小节照做,但每翻一次都要意识到"这是上一代版本";第 6 章当作品集看,看构图、看配色、看提示词的成分搭配,别把它当项目复盘的范本。把它当手册,它称手;把它当案例课,你学到的是一群人的运气。
最后交代边界:我的判断建立在 200 条目录全部过目、十八页正文逐页核对之上。目录层面(缺号、缺标题、十节九项目)是完整的,因为我数的是条目本身;正文层面我只对抽到的那些页负责。"没有一处失败案例""没有给出成本与周期"这两条结论,是我在这十八页里没找到,不是通读后的断言——544 屏里我读了不到三十分之一,这个差别我不敢含糊。
阅读记录:《Midjourney AI绘画商业案例创意与实操》,微信读书网页版逐页翻阅 544 屏 / 7 章 / 200 条目录,2026-11-05。抓取章节序列与目录一致,无跳章。
抽样页:p0006(前言,本书共 7 章与三工具定位)、p0035(1.2 GAN 四步比喻)、p0060(1.4《办法》第四条与算法、模型、规则三条定义)、p0090(2.4 Discord 频道与问题反馈)、p0150(图2-86 低变化模式与 Turbo、Fast、Relax)、p0200(图2-135 局部重绘按钮组与 dsil 提示词)、p0255(图3-20 姿势复刻与手指骨骼)、p0320(图3-75 加情绪描述)、p0333(图3-88 同一建筑换季节)、p0350(LoRA 字典与书签、门槛自相矛盾句)、p0378("像炒鸡蛋一样简单"与 15 张、20 至 50 张数据集要求)、p0405(图4-12 三工具星级表与"截至本书成稿")、p0430(6.7 麦麦博物馆四图)、p0460(图6-3 飞书公众号 4129 赞与 6.2 老板电器)、p0470(6.3 特斯拉《逃离》by 有饭)、p0505(6.8 执行过程与《拾穗者》提示词)、p0525(6.10.3 叶蓉老师的诗意与"无数次尝试")、p0535(7.3 APP 与广告模式的判断)。
发表评论: