
《AI绘画:Stable Diffusion ComfyUI的艺术》:它把每一格参数都填了,只是没告诉你代价
微信读书《AI绘画:Stable Diffusion ComfyUI的艺术》· 许建锋 · 9 章 · 71 条目录 · 509 屏
逐页翻阅 509 屏 · 9 章 · 71 条目录 · 抓取章节序列与目录一致,无跳章 · 2026-11-06
说明:509 是微信读书的屏幕数,不折纸页。我抽看了作者简介、2.1 为什么学 ComfyUI、3.1 采样器清单、4.2 SD 放大、6.3 Kolors 使用技巧、8.3 AnimateDiff 合并为视频、9.1 Flux 案例,共七处逐字核对。目录 71 条全过。判断只以这七处为准,没翻到的地方我不替它补。
先说结论:这是一本把"能不能跑通"写到极致、把"值不值"留白的书。509 屏里,几乎每一格参数都填了具体数字——放大系数 3、采样步数、帧率 6、NF4 量化——但凡是需要说"这么填会付出什么"的地方,它基本没写。所以它最好的用法是当工作流手册:你卡在哪一步,翻到那一节,照做,能过。它最不适合的用法是当教材:你学完九章,会连节点,不会判断哪张图该留。
作者许建锋,浙江传媒学院动画与数字艺术学院讲师,浙江省一流课程"电脑三维设计"主持人,教育背景是四川大学广告学学士、武汉大学软件工程硕士,做过浙江省广播电视广告中心策划部主任。这份履历解释了两件事:一是这本书的实操细节为什么这么实——他在课堂和项目里都跑过;二是它的判断标准为什么偏"技术正确"——广告与影视的交付习惯是"按规格交片",不是"这一版更好"。这个偏好贯穿全书,也正好是它的短板所在。
一、先说它做对的一件事:优劣势并列着写
2.1"为什么要学习 ComfyUI"这一节,全书第一个让我停下来的地方。大部分工具书讲"为什么选它",只讲优势。这本书讲完四条优势,接着讲劣势,而且讲得很实:
· 更新快,功能完善。ComfyUI和Stable Diffusion的工作原理一致,两者能很好地兼容,因此更新速度非常快。新的模型或扩展通常在一两天内就能获得支持。
· 资源占用低。与WebUI相比,ComfyUI的资源占用更低,可以用较少的显存运行较大的模型。
· 定制化和灵活性。……
· 广泛支持各类模型。ComfyUI不仅支持Stable Diffusion,还能第一时间支持最新的开源模型,如非SD模型Playground、Kolors、Flux等。它已经成为AI绘画的共享运行平台。
紧跟着是劣势:
· 对初学者不够友好。初学者可能需要学习一段时间后才能掌握节点式操作,并且需要一定的技术背景来充分利用ComfyUI的功能和理解节点的工作原理……
· 节点种类繁多,功能参差不齐。ComfyUI是完全开源的,节点种类层出不穷且杂乱无章,功能也参差不齐,因此初学者可能会感到困惑。另外,系统环境配置错误率高……
"系统环境配置错误率高"这七个字,是全书最诚实的一句话。装过 ComfyUI 的人都知道,真正让人放弃的从来不是节点逻辑,是那天下午卡在 Python 版本、CUDA 驱动、Torch 编译、依赖冲突上的四个小时。一本教 ComfyUI 的书愿意把这句话写进"为什么学"的第一节,而不是藏到附录,说明作者确实带过人装环境。
但这段也有它的问题,而且这个问题会在后面每一节重复出现:"资源占用更低"没有数字。低多少?同一个模型、同一个出图尺寸、同一个采样步数下,显存差多少、单张耗时差多少?这四个字可以写成一张两行的对照表,成本不到半屏,读者能拿它决定自己那张 8G 卡到底该不该折腾。全书 509 屏,这张表我一次没见到。它给结论,不给判据——这是这本书的通用毛病,2.1 只是第一次显形。
另外,"ComfyUI 已经成为 AI 绘画的共享运行平台"这个判断,我认同一半。它在开源模型这一侧确实成了事实标准:新模型发布时,作者往往先给 ComfyUI 工作流,再给 WebUI 插件。但"共享运行平台"这个说法容易被读成"通用平台"——闭源商业工具(Midjourney 那一类)并不在这个共享里,它们的出图能力和 ComfyUI 不是同一件事。把"开源生态里的默认选项"说成"AI 绘画的共享平台",会让初学者以为学会它就覆盖了全部。
二、九种采样器九句形容词:这一节把"选型"写成了"偏好"
3.1 文生图是全书的分水岭。前面两章铺垫,从这里开始动手。这一节里有半页在讲采样器,我把它整段抄下来了,因为它是这本书最典型的一页:
· 采样器:选择适合需求的采样器类型。比较常用的采样器有:
Euler:默认采样器,适用于大多数场景。
Euler a(Euler Ancestral):与Euler类似,但具有更高的随机性,能在较少的采样步数中产生较大的变化。
Heun:是Euler的改进版,提供更高的准确性,但生成速度较慢。
DDIM:快速的采样方法,可能需要更多的采样步数来达到良好效果,适合迭代绘制时使用。
LMS:基于多步采样的方法,通过平均过去的几个步骤来提高准确性。
DPM2:改进的DPM,通过每一步进行两次降噪来减少所需的采样步数,以获得高质量的图像。
UniPC:快速且效果良好的采样器,特别适合平面和卡通风格的图像生成。
DPM++ 2M:一种强大的采样器,适合需要平衡速度和质量的场景。
DPM++ SDE:基于随机微分方程的采样方法,使用了祖先采样,适用于追求高质量图像的场景。
每种采样器都有其特定的应用场景和效果,用户可以根据需求和偏好选择最合适的采样器。
九个采样器,九句描述,最后一句是"根据需求和偏好选择最合适的"。这一节的信息量是:有九种。它没有告诉你的信息是:该选哪一种。
我不认为这是作者不懂——他懂,前面每一条都抓到了一个真实的机制差异:Euler a 的"祖先采样"会引入随机扰动,所以少步数也能"变";Heun 是二阶方法,所以更准但更慢;DPM2 每步两次降噪,所以同等质量下步数更少。这些都是对的。问题在于,这些机制差异被翻译成形容词之后,就失去了挑选的功能。"更高准确性"和"高质量"和"平衡速度质量"三者谁也压不住谁,读者读完仍然只能"凭偏好"。
真正的判据长什么样?我给一个最小版本:同提示词、同种子、同分辨率、同步数(比如 20),把九种采样器各跑一张,四列并排——图、单张耗时、显存峰值、你自己的取舍结论。这一张表能顶掉那九段话,而且它会把一个书里没说的真相摆出来:在 20 步、512 见方的条件下,多数常用采样器的差距远小于"换一个提示词"带来的差距。读者最需要的判断,恰恰是"这件事值不值得挑"。这本书有 509 屏,这一张表占一屏,它没做。
顺带说一句描述层面的好处:这一段把每个采样器的"为什么快/为什么慢"用一句话点了出来(LMS 的"平均过去几个步骤"、DPM2 的"每一步两次降噪"),这是对的写法——先给机制,再给体感。可惜机制讲完就断了,没有落到"所以你该选它"。一本工具书里,机制讲到一半比完全不讲更让人难受:它让你知道有原因,却不告诉你怎么用这个原因。
三、SD 放大那一节:3 倍和 4x 同时出现,像素账没人算
4.2 讲 SD 放大,操作步骤写得很清楚,清楚到我能原样复现:
02 创建"SD放大"节点,把"放大系数"参数改为3,即放大3倍,如图4-6所示。
03 加载"放大模型加载器"节点,选择"4x_NMKD-Siax_200k.pth"模型,这是一个优秀的放大模型,如图4-7所示。
步骤 02 说 3 倍,步骤 03 选的是 4x 模型。两个倍数在同一节里并排出现,正文没有一句交代它们怎么叠加。读者照着做,在点"运行"之前,对自己的图会变成多大、会吃掉多少显存,一无所知。
这不是抠字眼。放大是 ComfyUI 里最容易让人半夜重启电脑的操作:一张 1024 宽的图,按 3 倍变 3072,如果分块重绘的块尺寸没调,显存当场打满;而 4x 模型的"4 倍"与节点"放大系数"的 3 倍是什么关系,取决于节点实现——有的以系数为最终倍数、模型只提供先验,有的是先 4x 再回缩。同样的两个数字,不同的节点实现会给出不同结果,这恰恰是该用一整段说清的地方,书里用了零句。
第二个问题是"这是一个优秀的放大模型"。"优秀"没有比较对象。和谁比?和它同门的 4x-UltraSharp 比,还是和 ESRGAN 系列比?在什么图上优秀——人脸、建筑、还是线稿?放大模型的选择高度依赖素材类型,写"优秀"等于把一个需要分场景的判断压成了一个褒义词。这是我在这本书里反复遇到的同一种病:凡是需要给区间和代价的地方,它给了一个形容词。
值得肯定的是这一节的节点说明方式。图 4-6 那张节点图把输入输出全标出来了:输入是"图像、模型、正面条件、负面条件、VAE",输出是"图像"。这种"看着接口图讲节点"的写法是对的——ComfyUI 的节点本质上就是函数签名,读者看懂接口,就知道该往哪个口接什么,比读十行文字说明快。全书大部分节点图都保持了这种做法,这是它作为工具书最称手的地方。
四、帧率填 6:一个能跑起来的数字,被当成了推荐值
第 8 章讲 ComfyUI 做视频,8.3 是 AnimateDiff。这一节的收尾要经过两个节点:先把潜空间解码成帧序列,再用"合并为视频"合成文件。书里给了这张节点图的参数:
"合并为视频"节点是"Video Helper Suite(视频助手)"扩展提供的节点,AI视频工作流通常都会使用这个节点。该节点主要用于设置视频的帧率、文件名和格式等,如图8-38所示。
帧率 6 / 循环次数 0 / 文件名前缀 AnimateDiff
上一屏的"SVD_图像到视频_条件"节点,帧率也是 6,增强 0.00。
6 帧每秒。这是个什么概念:电影 24 帧,国内电视 25 帧,手绘动画最低也常按 12 帧做"二拍三"。6 帧的成片,任何有运动的地方都会跳。书里把这个值印在参数面板上,没有一句解释它为什么是 6、成片多长、以及怎么补到能用的帧率。
我猜得出这个 6 是怎么来的:显存。AnimateDiff 一次生成 16 帧左右,SVD 一次 14 或 25 帧,把生成的帧按实际时长铺开,帧率自然低;而生成更多帧就意味着更长的时序、更大的显存占用和更长的等待。这不是错误,是一个在约束下妥协出来的数字——但妥协必须写出来,否则它就变成了"标准做法"。读者做完一条 6 帧的视频,会以为自己学会了,拿去交付才发现问题;而真正该学的东西——"先按低帧率试构图,选中的镜头再用插帧补到 12 或 24",一句没有。
这一章还有一处结构上的失衡,我留到短板里说。这里只记一条可复用的判据:凡书里给出的参数是一个"刚好能跑"的极端值(帧率 6、步数 4、放大 3 倍),它就必须同时给出"正常区间"和"为什么这里取极端"。缺了这两样,读者学到的不是方法,是一个魔数。
五、9.1 那 56 屏:十八种风格,十八条提示词,零张废稿
第 9 章叫"综合练习",74 屏。其中 9.1"Flux 文生图案例"占了 56 屏,9.2 那个真正的综合案例"锦绣江南刺绣艺术"只有 16 屏。一个叫"综合练习"的章,四分之三的篇幅是同一个案例的风格枚举。
9.1 的体例是这样的:给一张图,给一条英文提示词,再给一段"对应的含义"。比如图 9-17:
提示词:Create a retro-style postage stamp depicting a majestic sailing vessel with billowing sails, gliding through the deep blue seas under a golden sunset, evoking a bygone era of maritime exploration.
对应的含义:制作一枚复古风格的邮票,描绘一艘扬帆起航的雄伟帆船,在金色的夕阳下,船在深蓝色的海面上滑行,让人联想起逝去的海上探索时代。
这个"英文原文 + 中文释义"的双语格式,是全书最实用的一处设计,值得单独表扬。它同时解决了两件事:不会写英文的人能看懂,会写英文的人能直接抄。而且释义不是逐词翻译,是"这句话在要什么画面"——"bygone era of maritime exploration"译成"逝去的海上探索时代",比"过去的海上探索时代"准确。
但体例一旦固定,问题也固定了:每条只有"提示词 → 成功图",没有一条"提示词 → 失败图 → 改了哪个词 → 变好"。从编号能看到这一节至少列到(18)——十八种风格,十八张成功的图,零张废稿。我抽到的两页里,图 9-18 是"超现实绘画:创造出超越现实的奇特景象",配一张人头长满树叶的背影,同样一句"如图 9-18 所示",没有一句讲这张图是怎么调出来的。
读者从这一节能学到的,是"英文可以这么写";学不到的,是"为什么我这么写出来的不对"。而后者占据了实际使用的九成时间。我拿其中一条做个示范:如果这段要教人,我会在英文提示词下面加三行——第一行指出哪个词负责"邮票"这个形制(postage stamp 决定了画幅比例与齿孔边),哪个词负责"复古"(retro-style 是风格标签,换 vintage 会偏暖、换 old-fashioned 会偏褪色);第二行给一版删掉 retro-style 的对照图;第三行写"如果出来的是照片而不是插画,把 depicting 后面改成 illustration of"。
这三行加起来不到一屏,却是"教方法"和"给样例"的分界线。这本书 509 屏里有大量"给样例"的内容,而"教方法"的内容,集中在第 2 章到第 5 章那 200 来屏里。第 9 章本该是把方法用一遍的地方,结果它变成了一个更大的样例库。
六、中文模型那一章,是全书最聪明的结构安排
第 6 章"中文模型"单独成章,讲 Kolors 和混元。这个安排我认为是全书结构上最聪明的一步。
理由不是"支持国产",是它把一件容易被混在一起的事分开了:模型的语言能力,和工作流的搭建方式,是两个维度。前面第 3 章讲文生图、图生图、LoRA、ControlNet、IPAdapter,用的是 SD 系模型和英文提示词;到了第 6 章,作者没有把 Kolors 塞进第 3 章当"另一种模型",而是单开一章,先讲模型概述(6.1),再讲工作流怎么搭(6.2),最后讲使用技巧(6.3)。这个顺序等于在说:换模型不是换个 checkpoint,是要重建一套连接。这个判断是对的,而且是有经验的判断。
6.3 的提示词示例也值得看。图 6-18 是一张室内效果图,下面是:
提示词:明亮的室内房间,有床,有窗户,外面的阳光透过窗户照在地板上,男生房间,沙发,电脑桌,桌上有台灯,广角。
这是全书最"中文"的一条提示词,也是最好懂的一条——它按空间顺序写:先定基调(明亮的室内),再定结构(床、窗),再定光(阳光照在地板上),再定属性(男生房间),再定陈设(沙发、电脑桌、台灯),最后一个词定镜头(广角)。这个顺序可以直接当模板:基调 → 主体 → 光 → 属性 → 细节 → 镜头。英文提示词里常见的"主体在前、风格在后",在中文模型上未必最优,这一段算是给了一个本地化的写法。
同一节讲"人物形象设计"的那段也实:
进行人物形象设计时,要精准描述人物特征,涵盖面部特征(如眼睛形状、鼻子大小)、发型、服装风格和配饰等,例如"瓜子脸,丹凤眼,齐肩卷发,穿着复古风格的……
"瓜子脸,丹凤眼"这六个字,比"一个漂亮的亚洲女性"有效十倍。这是中文模型真正的优势所在——它训练语料里的容貌词汇密度高,你写得越像中文小说里的白描,它越接得住。可惜这一节只有不到 3 屏,后面就转去讲混元了。全书 509 屏,讲"中文该怎么写提示词"的只有这 3 屏,而讲英文提示词的至少有 56 屏(9.1 那个案例)。这个比例,跟这本书面向的读者(中文读者、初学者)不太匹配。
顺带记一处排版上的小遗憾:图 6-18 的图注只有"室内效果图"四个字。它没有说这张图是不是由下面那段提示词生成的。在一本教"提示词与结果对应关系"的书里,图注承担的是举证责任——写"图 6-18 由上文提示词生成,Kolors,采样 30 步",成本十个字,读者才知道该不该信这个例子。现在这十个字省掉了,图与提示词之间只剩一个"相邻"关系。
七、它的短板
第一,篇幅分配跟着热点走,不跟着任务走。按屏幕数算:第 8 章 73 屏,其中 8.1"AI 视频的发展"占 37 屏,五节实操(SVD、AnimateDiff、MimicMotion、LivePortrait、ToonCrafter)合计只有 34 屏。一章讲视频,一半在讲历史。更显眼的是第 1 章:整整 70 屏,其中 1.3"线上体验 AI 绘画"22 屏——讲的是在别人的网站上点按钮。一本教 ComfyUI 的书,用 22 屏教你用不需要 ComfyUI 的东西;再加上 8.1 的 37 屏历史,一共 59 屏、占全书 11.6%,是"看别人做"和"听过去的事"。
第二,第 9 章名不副实。74 屏里 56 屏是 9.1 的风格枚举(至少 18 条),真正称得上"综合"的 9.2 只有 16 屏。而 9.1 那种"一条提示词一张图"的排列,是样例库的体例,不是练习的体例。读者做练习需要的是"给你一个问题,你自己想办法",现在给的是"给你一个答案,你看着像"。这两件事差得很远。
第三,练习几乎不存在。全书九章的"思考与练习",每一节各占 1 屏:p0079、p0141、p0207、p0248、p0278、p0319、p0359、p0432、p0506。九屏,占全书 1.8%。一本有"思考与练习"体例的书,把练习压到每章一屏,等于承认这部分不是重点。而它恰恰是最该厚的地方——练习是唯一能让读者从"照着做"走到"自己做"的环节。
第四,没有失败记录,也没有取舍记录。我抽的七处里,没有一处写"这样接会报错""这个模型在这类图上不行""试了三档参数,第二档最好"。唯一接近失败的是 2.9"常见错误的解决"(133–135,3 屏)——3 屏讲排错,对比全书 509 屏,比例是 0.6%。装环境这一步作者自己都承认"错误率高",却只给了 3 屏。
第五,凡需比较处,一律用形容词。"这是一个优秀的放大模型""一种强大的采样器""适合需要平衡速度和质量的场景""快速且效果良好"。这些词在书里出现的位置,全都是读者正要做决定的位置。一本 509 屏的工具书,最后的落差就落在这里:它把"怎么做"写到了可复现的程度,把"怎么选"留在了形容词的程度。
也说几句公道话。第一,优劣势并列的写法在该类书里少见,尤其"系统环境配置错误率高"这一条,是带过人的作者才会写的。第二,节点接口图讲节点的方法很称手,输入输出标清楚,读者自己就能接。第三,中文模型单列一章的结构判断是对的——换模型是重建连接,不是换文件。第四,9.1 的双语提示词格式是全书最实用的设计,英文可抄、中文可读。第五,6.3 那条中文提示词的书写顺序(基调、主体、光、属性、细节、镜头)可以直接当模板用,这是我读完最想带走的一页。
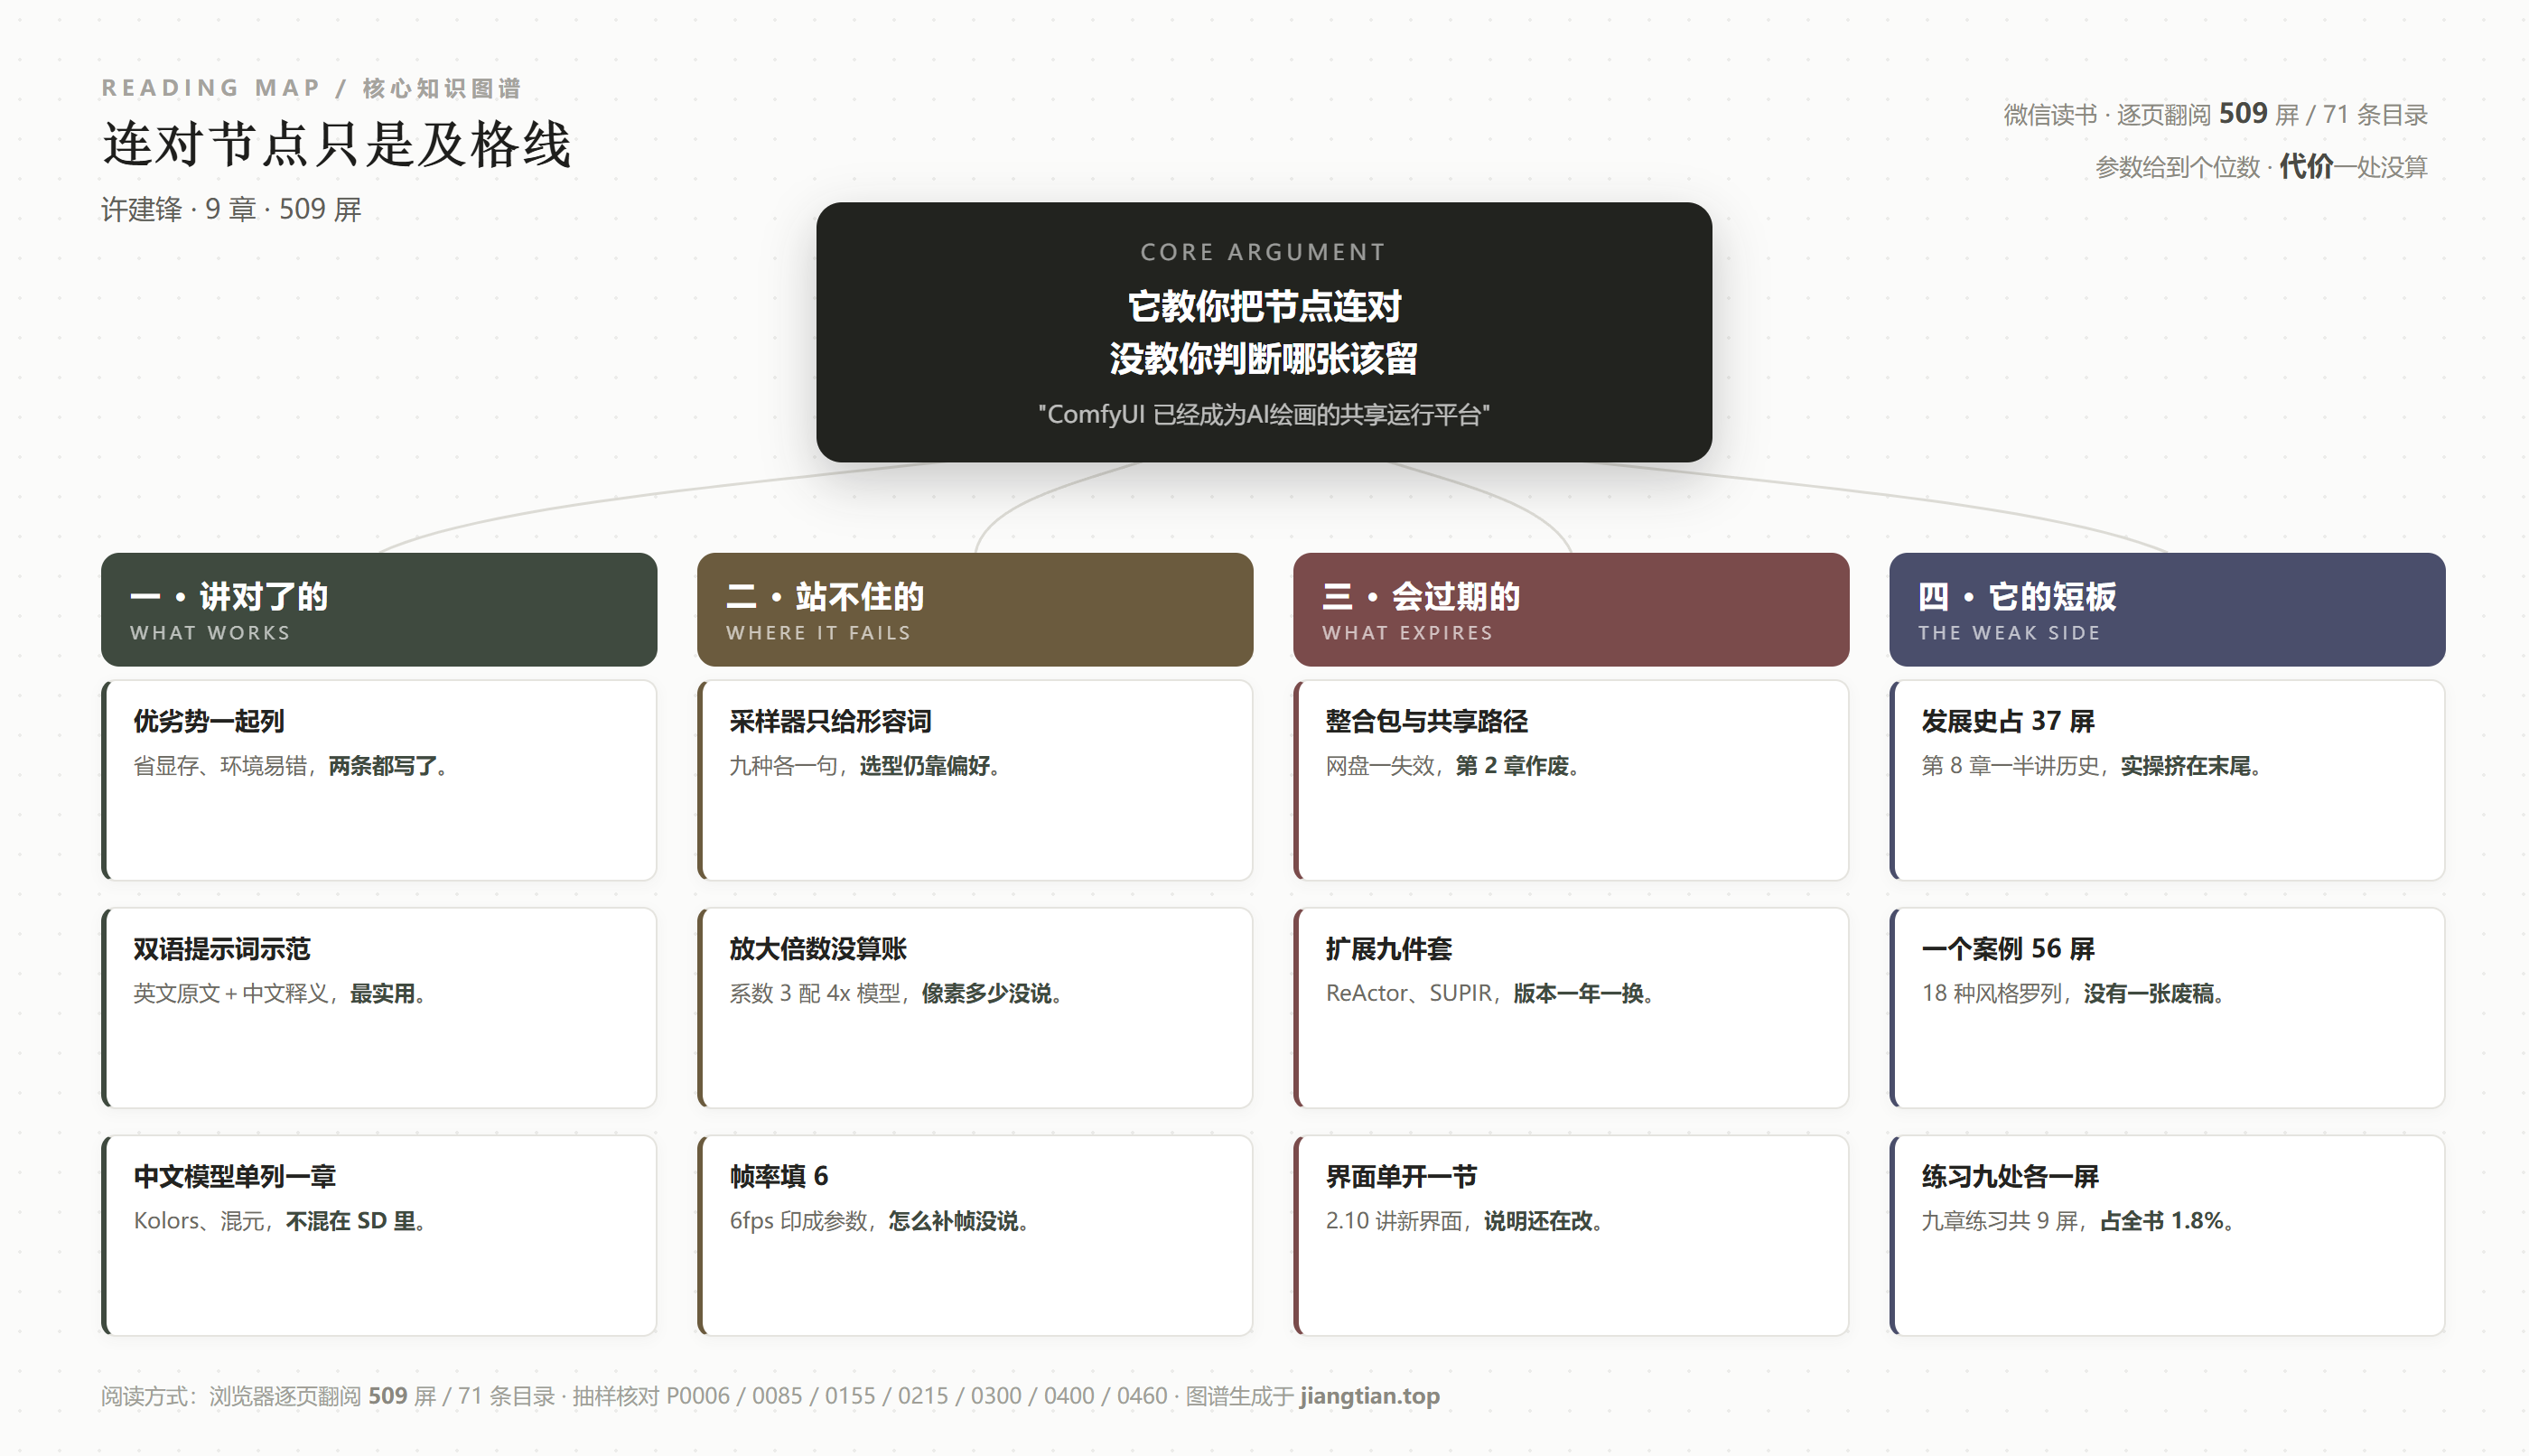
下面这张图是我把七处抽样读完后的结构梳理,四列分别是它讲对的、站不住的、会过期的、以及它的短板。
图文对照:从"能跑通"到"能判断",中间缺的那一层
八、一句话
如果你只带走一句:这本书把节点连对了,把参数填满了,把"哪张该留"留给你自己;它是这个领域里少有的、能照着跑通的手册,也是少有的、通篇不给判据的教材。
它该怎么用?我的建议是三段式:装环境那一段(第 2 章,62 屏)当操作手册,卡住就翻,翻完就合上,不必通读;第 3 到第 7 章(工作流、扩展、节点集、中文模型、Flux)当字典,做一个具体效果时按需查,每查一次顺手记下"本节给的参数值是多少"——因为那些值就是它最该被质疑的地方;第 8、9 章当素材库,看图、抄提示词,但每抄一条,自己补一句"这句话里哪个词决定了这个效果",否则抄一百条也只是复制。
最后交代边界:我的判断建立在 71 条目录全过、七处正文逐字核对之上。篇幅账(各章屏数、8.1 的 37 屏、9.1 的 56 屏、九处练习各 1 屏)是准的,因为我数的是屏幕序列本身;正文层面我只对抽到的七处负责。"没有失败记录""凡比较处用形容词"这两条,是我在这七处里的观察,不是通读 509 屏后的断言。另外声明一处我不下判断的地方:图 6-18 与它下面那段提示词是否对应,书里没有标注,我也无法用截图确证,所以我只批评"图注没写",不批评"图文不符"。
阅读记录:《AI绘画:Stable Diffusion ComfyUI的艺术》,许建锋著,微信读书网页版逐页翻阅 509 屏 / 9 章 / 71 条目录,2026-11-06。抓取章节序列与目录一致,无跳章。
抽样页:p0006(作者简介:浙江传媒学院讲师、一流课程主持人、教育与工作经历)、p0085(2.1 ComfyUI 四条优势与两条劣势)、p0155(3.1 九种采样器逐条与"根据需求和偏好选择")、p0215(4.2 图4-5 文生图工作流与 SD 放大步骤 02/03)、p0300(图6-18 室内效果图与中文提示词、人物形象设计)、p0400(图8-37 SVD 条件节点帧率 6、合并为视频节点帧率 6)、p0460(9.1 图9-17 邮票英文提示词与中文释义、第 18 项超现实绘画)。
发表评论: