
《解密AI绘画与修图》:184 屏“提示”里,没有一句“什么时候别用”
微信读书《解密AI绘画与修图:Stable Diffusion+Photoshop》· 7 章 · 55 条目录 · 544 屏
逐页翻阅 544 屏 · 7 章 · 55 条目录 · 抓取章节序列与目录一致,无跳章 · 2026-11-06
说明:544 是微信读书的屏幕数,不折纸页。我抽看了第 1 章首页、2.1 硬件与基准测试、2.2 提示词原理、2.6 高分辨率修复、4.1 图生图风格转换、4.7 测试参数(X/Y/Z 图表)、5.3 视频换脸、6.1 PS 插件设置、6.4 语义分割、6.6 金属字提示词、6.7 老照片修复、7.1 案例、7.3 图层样式,共十三处逐字核对。目录 55 条全过。判断只以这十三处为准。
先说结论:这是一本罕见地肯给对照图、肯给具体参数值、肯讲原理的工具书,544 屏里几乎每一格参数都有数字。但它也是我读过的结构最奇怪的一本——全书的 33.8%(184 屏)活在名为"提示 Point out"的侧栏里,而真正讲基础参数的 2.4 节只有 3 屏。它的强项在"怎么跑通",它的空白在"什么时候不该这么跑"。
我先把一个数据摆在这里,因为它决定了后面所有讨论:这本书的 55 条目录,没有一条叫"提示 Point out";但全文有 184 屏的章节标记就是"提示 Point out"。也就是说,三分之一的正文内容,读者按目录翻不到。这不是印刷问题,是结构问题——它把大量本该进正文的解释,装进了一个目录之外的抽屉。
一、它先讲清了原理,这一步很多同类书都跳过
2.2 节讲提示词之前,先用一屏把 Stable Diffusion 的三大件讲了。原文是:"Stable Diffusion主要由3个组件构成:CLIP text encoder(前贴文本编码器)、auto encoder(自编码器)以及由UNet和Scheduler组成的扩散模型。CLIP text encoder组件的作用是从网络上收集大量图片和语义标签文本,以建立文字和图片之间的对应关系。接下来,auto encoder组件中的编码器会在每幅图片上添加噪点,并将其压缩到原像素维度的1/48的潜空间中。"
"1/48"这个数字是判断这本书有没有真读文档的一把尺子。大部分工具书写到"压缩到潜空间"就停了,读者不知道压多少、为什么是 512×512 出图而不是 1024。给出比值,读者立刻能推出一件事:出图尺寸最好取 8 的倍数(因为 VAE 的下采样是 8 倍),1024 的图在潜空间里是 128×128。这是那种"多写一个数字,读者少踩一个坑"的地方。图 2-5 也画得清楚:猫的图进来,CLIP 抽出 cat / tree / grass / flower / sky / cloud 六个词,encoder 逐级缩到小方块,UNet 与 Scheduler 在中间工作。这张图比我见过的多数"扩散模型示意"都准确,因为它把"文字被编码成向量"和"图片被编码成潜变量"画成了两条并行的路,而不是含混地画成一个框。
同样值得记一笔的是 2.1 节那句关于显存的话:"如果显存容量比较小,可单击启动器左侧的'高级选项',根据显存容量选择优化方案。对于拥有大显存容量的用户,则可以选择关闭'使用共享显存'选项,以避免性能降级。"
这句话是内行话。共享显存走的是 PCIe,速度差一个量级,开着它出图会莫名变慢,而大部分教程只会教你"把显存调大"。一本愿意告诉你"大显存反而要关掉共享显存"的书,作者是真在自己机器上折腾过的。这类细节在全书里不少,是它最可信的部分。
二、它确实是"给值"的书:0.2 与 0.32 那一段值得单独学
6.7 节讲老照片修复上色,有一段我读了两遍,因为它是全书方法论的样板:
输入画质和描述照片内容的提示词,然后单击"图生图"和"精确"单选按钮,把"降噪强度"参数设置为0.2,然后重绘图片,如图6-97所示。把"降噪强度"参数设置为0.32,随后再生成一次图片,这一次头发和衣服的效果更好一些,但是面部的变化比较明显。
这一段同时给了三个东西:两组值(0.2 / 0.32)、两次生成的结果对比、以及代价(面部变化明显)。这是"参数书"和"实验记录"的分界线——大多数参数书只给第一样。读者看完能自己判断:如果我要保脸,就用 0.2;如果我要救头发和衣服的细节,接受脸变一点,就用 0.32。这才是可迁移的知识,因为它教的是取舍,不是魔数。
2.6 节的高分辨率修复也是同一个路子。图 2-59 用四张同构图并排给出 Denoising 0.7、0.8、0.9、1.0 的效果,人脸从"还是本人"一路走到"换了个人"。后面接一句操作:"在高分辨率修复可折叠面板中选择一个常用的放大算法,然后把'重绘幅度'参数设置为0.4,接下来取消'高分辨率修复'复选框的勾选。"
这里还有一处我很欣赏的细节:"注意:accordion控件在本书翻译为'可折叠面板',通常也翻译为'手风琴菜单'或'手风琴面板'。"为一个界面控件的译名专门写一句说明,说明作者知道读者会在别处看到另一个说法然后懵掉。这是译者意识,不是作者意识,两者都有更好——这本书有。
5.3 节讲视频换脸,还给出了可验算的算术:"如果要得到4秒的视频,则要将帧率设置为15帧/秒,总帧数就应设置为60帧(即15×4)。"15×4=60 是对的,读者拿计算器一按就能验证。一本工具书里出现可以当场验算的算式,比出现十个"效果惊艳"的形容词有用得多。
6.1 节的插件设置界面同样是"给值"的路子。图里能看到 SD Url 填 http://127.0.0.1:7860、ComfyUI Url 填 http://127.0.0.1:8188、语言选 zh_CN、采样插值选 bilinear,右边还标着插件版本 v1.4.1。这四个值恰好是新手最容易填错的地方——端口号一个 7860 一个 8188,插值算法默认是 bicubic 还是 bilinear,语言包不选中文就全是英文菜单。它把这些具体到端口的数据印出来,读者照填就能通。
但这里也漏了一件事:书里把 Automatic1111 和 ComfyUI 做成了两个单选项,却没一句说"什么情况下该选哪个"。两个都装过的读者知道,A1111 的界面是表单式的、参数一屏排开,ComfyUI 是节点式的、工作流可见;前者适合一张一张调,后者适合批量与复用。这段判断只要三句话,而它决定了读者后面三个月的时间花在哪。这本书给了接口地址,没给选择理由——又一次"给值不给判"。
三、可它给的值,大多没有"为什么"
问题出在比例上。这本书共 544 屏,第 4 章"进阶玩法"92 屏(16.9%),第 6 章"集成到 Photoshop"110 屏(20.2%),第 7 章"实战案例"89 屏(16.4%);而 2.4 节"文生图参数详解"只有 3 屏。
3 屏。一本以"解密"为名、副标题直接挂 Stable Diffusion 的书,讲最核心的那组参数——采样方法、采样步数、CFG、种子、尺寸——只有 3 屏,加上紧随其后的提示栏 8 屏,一共 11 屏,占全书 2%。而"进阶玩法"里光是"任意转换图片风格"一节就有 16 屏。
这个失衡带来一个具体后果:读者会做花活,但不知道花活为什么成立。比如第 4 章的 X/Y/Z 图表,图 4-101 用四张同构图展示四种表情变化,操作只有一句"取消'包含图例注释'复选框的勾选"。可是 X/Y/Z 图表的真正价值是做参数扫描——固定种子,一次跑 3×3 组 CFG 与步数,看出哪一组开始糊、哪一组开始僵。书里用了这个工具,但没把它当实验工具讲,只当排版工具讲。
如果让我替它补 2.4 这一节,我不加篇幅,只加三行判据,每行标出"低了会怎样、高了会怎样":CFG 低于 4,画面会散、跟提示词脱钩;高于 15,颜色开始过饱和、边缘发硬,人物皮肤像塑料。采样步数低于 20,细节还没收敛;超过 40,多半是把时间花在看不见的地方,收益趋零。尺寸不是 8 的倍数,VAE 解码会出现接缝和色块。这三行加起来不到一屏,但它把"参数"从"要填的格子"变成了"有方向的旋钮"。书里三屏给的是格子,缺的是方向。
更典型的是一处内部不一致。6.6 节(p0412)的负向提示词写的是 {ugly1},6.7 节(p0450)的负向提示词写的是 (ugly:1)。同一个功能,两页之间换了两种语法,中间零句解释。在 WebUI 系里,圆括号与花括号都是加权符号,写法不同、权重不同;读者照着抄,很可能以为自己只写了个"ugly",实际却给它加了一层或减了一层权重。一本 544 屏的书,连"括号是权重、不是装饰"这一句都没写,是一个不该有的空白。这不是吹毛求疵——提示词里最常见的翻车,就是把括号当标点用。
4.1 节的开口倒是难得的坦白。它先说文字这条路的天花板:"文字承载的信息量有限,即使编写了大段提示词并且调整了各种语法权重,也很难让AI准确理解。AI就算理解了,也未必能生成令人满意的图片,因此会导致大量时间都花费在反复尝试的过程中,俗称'抽卡'。"随后给出图生图的三条出路:风格迁移、高清重绘、修复和放大。
承认"抽卡"是这本书最诚实的一步,因为它在告诉读者:这里有一部分是不可控的。顺着这个坦白往下推,本来可以写出一页极有用的判据——什么样的参考图适合做输入?我的经验是三条:主体轮廓清楚、背景不抢戏、光影方向单一。满足这三条的图,图生图的成功率会高很多;不满足的,提示词写得再细也会被参考图带偏。书里把"用什么功能"讲清了,把"喂什么图进去"留空了。而后者才是图生图真正的门槛。
四、三分之一的书活在"提示"栏里
这是我读这本书最大的意外。抓取下来的 85 个章节段里,有 184 屏的章节标记是"提示 Point out"——占 544 屏的 33.8%。我专门去核了这一栏到底装什么。2.1 节末尾开始的第一个提示栏,接着讲的是硬件与性能:怎么用启动器的"系统信息"看基准测试、怎么看硬件平台的性能得分、显存不足时点哪里。
内容是有用的,问题在装它的位置。"提示"栏在版式上的含义是"补充说明,可跳过"。可这 184 屏里装的东西,包括参数解释、注意事项、界面说明,很多是主线内容——读者跳过它,后面就看不懂。这就形成了一个悖论:标注为"可跳过"的部分,恰恰是不能跳过的部分。
它的代价在检索上。55 条目录全是节标题,没有一条标"提示";也就是说,三分之一的正文在目录里是不存在的。读者想回头查"共享显存那一句在哪",翻目录找不到,只能一屏屏划。纸书时代这还能靠翻页蒙过去,电子书里就是纯粹的检索失效。
这 184 屏的分布更能说明问题:第 2 章 31 屏、第 3 章 22 屏、第 4 章 54 屏、第 5 章 39 屏、第 6 章 38 屏,第 1 章与第 7 章一屏没有。最扎眼的是第 4 章——92 屏的"进阶玩法"里,有 54 屏是提示栏,占了 58.7%。也就是说,这一章真正的主线只有 38 屏,"进阶"有六成装在了"补充说明"的框里。而第 1 章(工具简介)与第 7 章(实战案例)全是正片、零提示栏。合起来看,规律很清楚:越是需要解释"为什么"的地方,越被塞进了提示框;越是需要展示成果的地方,越是纯图。这个规律本身就是一种编辑取向——解释性内容被当成次要信息处理了。
我不认为这是作者的排版偏好,更像出版社的丛书体例——"提示"框在计算机教材里是个固定模块,编辑要求每节配几个。但当这个模块占到全书的三分之一时,它已经不是补充,而是第二个正文层。第二正文层不进目录,等于给读者的导航砍掉一条腿。
五、第 1 章 13 屏讲五个工具,等于点名
第 1 章"常用AI图像生成工具简介",13 屏,讲五个对象:Midjourney(2 屏)、DALL-E 3(2 屏)、Stable Diffusion(3 屏)、文心一格(2 屏)、在线版图片生成网站(2 屏)。
平均每个工具 2.6 屏。这个篇幅能装下的只有"它是什么、它大概长什么样"。装不下的是读者真正要做的决定:同一张图,五个工具出的东西差在哪;哪个能商用、哪个不能;哪个要科学上网、哪个不要;按张计费还是按月订阅,一张图的成本差多少倍。
我理解作者的取舍——这本书的主线是 SD + PS,其余四个工具是背景。但既然开了这一章,就该按"选型"来写,而不是按"简介"来写。选型章的合格线是一张四列表:能力、成本、可得性、合规。少一列,读者就只能凭印象选。这本书一列都没有,只有五个各两屏的介绍。
那张表其实不难做,两屏足够。能力一列写"能不能控姿势、能不能固定角色、能不能出中文文字";成本一列写"按张计费还是按月订阅,一张成片大概几块钱";可得性一列写"要不要境外网络、要不要本地显卡、最低显存多少";合规一列写"商用授权范围、生成内容是否需要标识"。四列填完,读者三分钟能做完决定;四列不填,读者得自己踩一遍坑才能做完同一个决定。这中间的差别,就是"教材"和"资料"的差别。
同一章还有一处时间戳,值得单独说。2.1 节图 2-3 是一张启动器的基准测试截图,表里列着环境:Python 3.10.11、Torch 2.1.0+cu118、xformers 0.0.22、CUDA 11.8、驱动 526.98、显卡 RTX 3060(6.0 GB)。
这组版本号大概停在 2023 年底。这不是缺点,是必然——书总要定稿。真正的缺点是:全书没有一页讲"你装出来的环境跟截图不一样,会怎样"。2026 年的读者去装启动器,大概率拿到的是 Torch 2.5 以上、CUDA 12.x,插件版本也对不上。那时他会遇到什么?xformers 没编好、显存反而涨、模型加载报错——这些才是真实用户的第一道墙。一本教人装环境的书,把"版本对不上"这一整类问题留给了读者自己去搜索。
六、第 7 章五个案例,最后一步是手工投影
第 7 章"AI绘图实战案例及模型推荐"89 屏,五个案例:影楼级 AI 照片 21 屏、个人虚拟形象 18 屏、小说推文封面 16 屏、写真与杂志封面 11 屏、电商产品展示图 20 屏。
7.1 的过程我是顺着看的:先用 SD 出图,再把处理完的图上传到图生图,关掉 ADetailer,开启 ControlNet,控制类型选"Tile/Blur(分块/模糊)"。图 7-15 的控制类型面板列全了十五项:Canny、Depth、NormalMap、OpenPose、MLSD、Lineart、SoftEdge、Scribble/Sketch、Segmentation、Shuffle、Tile/Blur、局部重绘、InstructP2P、Reference。这一屏信息密度很高,是那种值得拍照存下来的界面图。
但翻到案例后端,画风变了。图 7-76 是 Photoshop 的"图层样式"对话框:投影,混合模式正片叠底,不透明度 60%,角度 120 度,勾选使用全局光,距离 80 像素,扩展 0%,大小 100 像素。
一本叫"AI 绘图实战"的书,实战的最后一步是手工调投影参数。我不认为这是败笔——真实的商业交付本来就是 AI 出图加人工收尾,那层投影确实得有人调。问题在于,书里没有一句话把这层关系讲明白:哪些环节 AI 能交、哪些必须人收、收的时候按什么标准。读者跟着做完,会以为自己学会了"AI 绘图",实际上他学会的是"AI 出图 + 一套 PS 手法",而后者占了成片效果的一大半。
我在这一章里还数了一件事:五个案例、89 屏、图号排到 7-76,没有一个案例出现"这一版不行,我们换个思路"的记录。全是正片,没有废片。商业案例这样写最省事,也最没用——读者真正需要的是"出废片的时候怎么判断是提示词的问题、模型的问题、还是 ControlNet 的问题"。成功可以照抄,失败才能迁移。
这一段如果让我来写,我只加一张巴掌大的判读表,四行,把"症状"和"病灶"对上:人物五官变形,先怀疑重绘幅度过高,其次怀疑模型与 LoRA 不匹配;画面整体发灰发平,先看 CFG 是不是偏低,再看采样步数是不是不足 20;构图对但风格不对,问题在底模而不是提示词;局部糊成一团,是 ControlNet 权重压过了提示词。这张表不需要案例,只需要一次真实的翻车。它的价值在于:读者照着它查,能把"再抽一次卡"变成"改一个参数"。
七、它的短板
第一,结构上把三分之一的内容藏进了目录之外。184 屏"提示 Point out"(33.8%)不进目录,55 条目录里一条都没有。读者按目录查参数,查不到;按页码翻,翻不完。这不是排版选择,这是把检索成本转嫁给了读者。
第二,基础参数被压缩,进阶技巧被放大。2.4"文生图参数详解"3 屏,加提示栏 8 屏共 11 屏(2%);而第 4 章"进阶玩法"92 屏、第 6 章"集成 PS"110 屏。CFG、步数、采样器怎么配,是每个新手第一天就要用的东西;局部重绘、涂鸦、瞬息全宇宙是第三个月才碰的东西。这本书的篇幅分配,跟学习曲线是反的。
第三,权重语法零解释,两页之间自相矛盾。6.6 用 {ugly1},6.7 用 (ugly:1),全书没有一句讲括号与花括号在权重上的区别。提示词里最容易翻车的一处,恰好是书里最沉默的一处。
第四,没有成本账。2.1 讲硬件给了基准测试截图,却没给读者最想要的那个数:这张 3060 6G,出 512×512、20 步,一张要几秒;跑 SDXL 要几秒;放大到 4K 又要几分钟。参数书的合格线是给值,工程书的合格线是给预算。这本书给足了值,一次没给预算。
第五,失败案例零记录。五个案例、89 屏、图号到 7-76,没有一张废稿、没有一次返工、没有一句"这里试了三次才对"。读者学到的是结果,不是过程;而 AI 绘图的全部难点都在过程里。
第六,工具章的选型信息缺失。第 1 章 13 屏讲五个工具,平均 2.6 屏一个,没有能力/成本/可得性/合规的四列对比。读者读完知道有这五个东西,仍然不知道该用哪个。
第七,同一功能的两套语法并存,读者无所适从。这一条我在第三节提过,但值得在短板里再点一次,因为它不是笔误,是全书性的:提示词里既有圆括号的 (ugly:1),也有花括号的 {ugly1},还出现过纯逗号分隔的长串关键词。三种写法各自成立,混在一起就是三种规则。一本书如果不能在语法上统一,至少该有一页把三种写法摆在一起说清楚"它们等价在哪里、不等价在哪里"。这一页,全书没有。
也说几句公道话。第一,2.2 那屏把 1/48 潜空间写出来的原理讲解,是同类书里少见的准确。第二,2.6 的四张 Denoising 对照图、6.7 的 0.2 与 0.32 两组值加代价说明,是"实验书"该有的样子,我读的时候在旁边记了笔记。第三,为 accordion 这个控件专门交代译名,说明这本书在意读者会不会在别处懵掉。第四,5.3 的 15×4=60 帧,是能当场验算的算式。第五,4.1 里那句"俗称'抽卡'",是全书最诚实的一个词——它承认了这件事的不确定性,没有把它包装成"精准可控"。
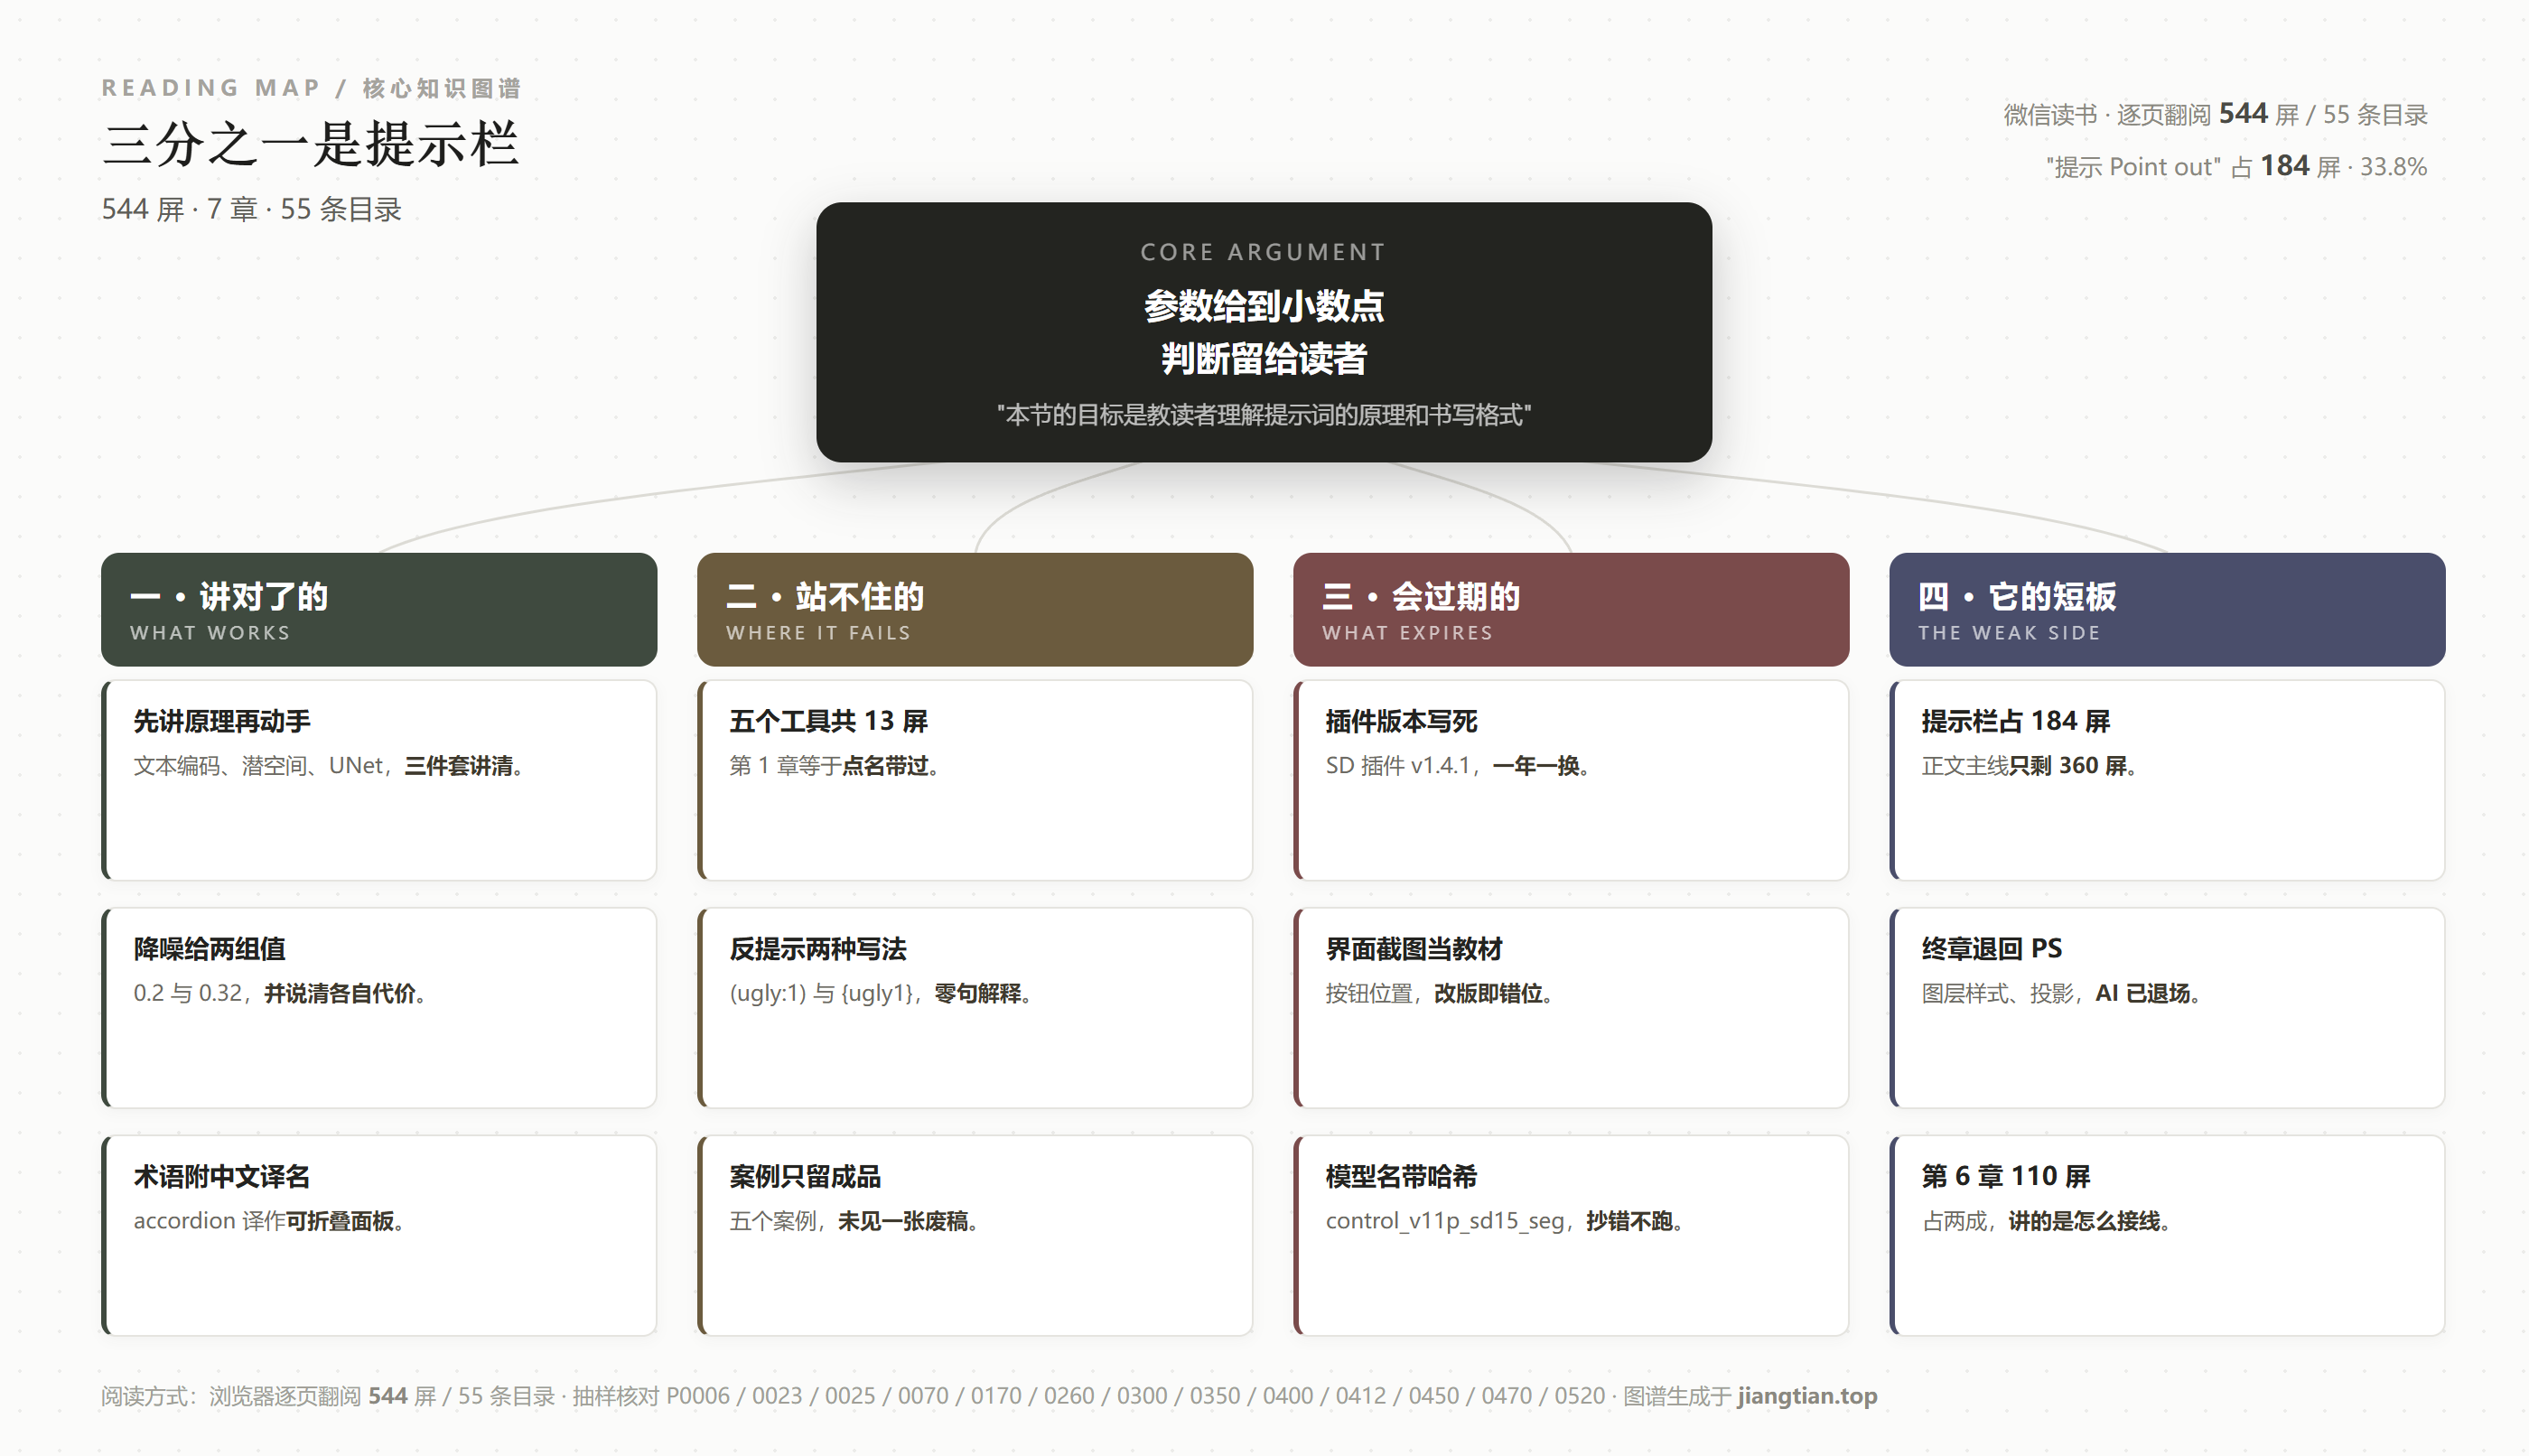
下面这张图是我把十三处抽样读完后的结构梳理,四列分别是它讲对的、站不住的、会过期的、以及它的短板。
图文对照:一本"给值"的书,缺的那道判断线
八、一句话
如果你只带走一句:这本书把"怎么做"写到了可以照抄的程度,把"什么时候别这么做"留在了读者自己的机器上;它是这个领域里少有的肯给对照图和具体值的书,也是少有的把三分之一正文藏在目录之外的书。
它该怎么用?我的建议是三步。第一步,把 2.2 和 2.6 当原理课读(约 30 屏),只读这两节,把"潜空间 1/48""Denoising 决定改多少"这两件事吃透,后面所有参数你都能自己推。第二步,把第 3 到第 6 章当字典,做一个具体效果时按需查,每查一处顺手记下"这一节给了几组值、有没有说代价"——给了代价的(6.7)照抄,没给代价的(多数)自己补一次对照。第三步,第 7 章当素材库,看图、抄提示词,但每抄一条,补一句"这句话里哪个词决定了这个效果",否则抄一百条也只是复制。至于那 184 屏"提示"栏,别跳过——它是这本书的第二个正文,只是目录没告诉你。
最后交代边界:我的判断建立在 55 条目录全过、十三处正文逐字核对之上。篇幅账(各章屏数、2.4 的 3 屏、第 6 章 110 屏、提示栏 184 屏)是准的,因为我数的是屏幕序列本身;正文层面我只对抽到的十三处负责。"五个案例零废稿""权重语法零解释"这两条,是我在这十三处里的观察,不是通读 544 屏后的断言。另外声明两处我不下判断的地方:一是图 2-3 那组版本号我只能读到版本本身,无法确证它对应的具体出版月份,所以我说"大概停在 2023 年底";二是 6.6 与 6.7 的两种负向提示词写法,我只指出写法不一致、书里没解释,不判定其中哪一个是错的。
阅读记录:《解密AI绘画与修图:Stable Diffusion+Photoshop》,微信读书网页版逐页翻阅 544 屏 / 7 章 / 55 条目录,2026-11-06。抓取章节序列与目录一致,无跳章。
抽样页:p0006(第1章 常用AI图像生成工具简介)、p0023(2.1 硬件与基准测试:图2-3 环境版本、共享显存一段)、p0025(2.2 提示词原理:CLIP/VAE/UNet 三组件与 1/48 潜空间、图2-5)、p0070(2.6 高分辨率修复:图2-59 四档 Denoising、图2-60 参数、accordion 译名说明)、p0170(4.1 图生图三个作用与"抽卡")、p0260(4.7 图4-100/4-101 X/Y/Z 图表与四种表情)、p0300(5.3 视频换脸:图5-45 前后对比、15×4=60 帧)、p0350(6.1 SD 插件 v1.4.1 设置界面)、p0400(6.4 图6-51 ControlNet Seg 与 control_v11p_sd15_seg)、p0412(6.6 金属字提示词与 {ugly1})、p0450(6.7 老照片修复:0.2 与 0.32 两组值与代价、图6-97)、p0470(7.1 图7-14/7-15 ControlNet 控制类型十五项)、p0520(7.3 图7-75/7-76 Photoshop 图层样式投影参数)。
发表评论: