
《AIGC:智能创作时代》:241 屏写"时代",只给风险一屏
微信读书《AIGC:智能创作时代》· 6 章 21 节 · 3 个附录 · 241 屏
逐页翻阅 241 屏 · 6 章 21 节 · 读至末页「全书完」· 2026-11-06
说明:241 是微信读书的屏幕数,不折纸页。整本从 p0001「版权信息」翻到 p241「全书完」,中途没跳页。为了写这篇,逐字核对了九处:p0006 图 0-2 与图 0-3、p0009 参数规模与图 0-6、p0030 媒体 AI 写作、p0052 四模态与视频生成、p0095 表 2-4、p0135 虚拟主播、p0160 数据服务、p0218 与 p0219 风险与监管、p0241 全书末页。引用全部出自这几处,没看过的地方不写。
先说结论:这是一本写给 2023 年初的书,而它自己没意识到这一点。241 屏里,"GPT-4 也预计在不久的将来发布"这句话出现了不止一次(p0095),所有关于"未来"的判断都挂在这句话上。三年后回看,这本书的每一页都变成了史料——这不算错,但它自己不知道,这就有点尴尬。
我不打算用"时效性"来打这本书。任何一本写"时代"的书都会过期,这是体裁决定的。真正值得说的是它的结构性失衡:一本 241 屏、讲"智能创作时代"的书,给"风险与监管"的篇幅是一屏。
一屏。而"参与主体"(讲谁在投钱、谁在做局)给了 18 屏,"产业下游应用拓展"给了 23 屏,"专家推荐"给了 11 屏。推荐语比监管多十倍。
这个配比不是偶然。它暴露了这本书真正的血统:它不是一本思想书,是一份包装成书的行业研报。研报的结构就这样——先讲变革,再讲技术,再讲应用,再讲产业地图,最后用一页"风险提示"收尾,因为研报的风险提示从来都是免责条款,不是分析结论。
一、骨架:技术 60 屏,应用 85 屏,产业 46 屏,未来 26 屏
241 屏的分配,我按章节算了一遍:
代序 15 屏 + 前言 4 屏 → 开篇 19 屏(7.9%)
第一章 AIGC:内容生产力的大变革 39 屏(16.2%)
第二章 AIGC 的技术思想 41 屏(17.0%)
第三章 AIGC 的职能应用 19 屏(7.9%)
第四章 AIGC 的行业应用 27 屏(11.2%)
第五章 AIGC 的产业地图 46 屏(19.1%)
第六章 AIGC 的未来 26 屏(10.8%)
附录三件套 + 后记 + 专家推荐 22 屏(9.1%)
版权信息 2 屏
按性质归一下:技术讲清楚的部分(代序、前言、第二章)60 屏,占 24.9%;讲应用的部分(第一章、第三章、第四章)85 屏,占 35.3%;讲产业的部分(第五章)46 屏,占 19.1%;讲未来的部分 26 屏,占 10.8%。
这个结构本身没问题,问题在内部的颗粒度差得太远。
第五章"产业地图"46 屏,其中"产业上游:数据服务"14 屏,"产业中游:算法模型"3 屏,"产业下游:应用拓展"23 屏。中游只有 3 屏。而中游恰恰是这本书最该讲的地方——算法模型层是整个 AIGC 产业的技术命门,OpenAI、Anthropic、Stability、Midjourney 全在这一层。3 屏,连把这几家点名都勉强。
第四章"行业应用"27 屏,摊给六个行业:资讯 3 屏、影视 7 屏、电商 4 屏、教育 2 屏、金融 2 屏、医疗 3 屏。平均每个行业 3.5 屏。3.5 屏能讲什么?能把"AI 在这个行业能干什么"列个清单,讲不了"这个行业为什么这么干、卡在哪"。这一章的名字叫"行业应用",实际功能是目录:告诉读者还有哪些地方没讲。
而第六章"未来"26 屏里,"参与主体"占 18 屏——讲的是资本、大厂、创业公司在怎么布局。这个内容放在"产业地图"里更合适,放在"未来"里,等于用"谁在进场"代替了"会变成什么样"。
二、最扎实的二十屏:媒体 AI 小编那二十年
如果这本书只留一节,我会留第一章第一节。这一节讲"从 PGC、UGC 到 AIGC",7 屏,信息密度是全书最高的。
p0030 是我在这本书里唯一划线的一页。它给了几个具体到秒的数字:
2016 年 5 月,四川绵阳发生 4.3 级地震时,中国地震台网开发的地震信息播报机器人在 6 秒内写出了 560 字的快速报道;2017 年 8 月,当四川省阿坝州九寨沟县发生 7.0 级地震时,该机器人不仅翔实地撰写了有关地震发生地及周边的人口聚集情况、地形地貌特征、当地地震发生历史及发生时的天气情况等基本信息,还配有 5 张图片,全过程不超过 25 秒;在后续的余震报道中,该机器人的最快发布速度仅为 5 秒。
这三个数字比全书任何一张趋势图都有说服力。6 秒、560 字、25 秒、5 张图、余震 5 秒——你不需要相信任何"时代"叙事,也能判断这件事已经发生了。而且它给的是能查的细节:年份、月份、地名、震级、字数、秒数、图片张数。这是记者的写法,不是研报的写法。
同一页还列了国内媒体那一批 AI 小编的名字:新华社"快笔小新"、第一财经"DT 稿王"、《南方都市报》"小南"、封面新闻"小封"、腾讯财经"Dreamwriter"、今日头条"Xiaomingbot"。六个名字,六个真实产品,一个不多一个不少。这一段的价值在于它把"AI 写作"从抽象概念落到了具体产品上——读者可以自己去搜这六个名字,验证它们今天还在不在。能被验证的叙述,才叫事实。
紧接着它做了一次分类,也是全书最细的一次分类:AI 文本生成分两类,非交互式与交互式。非交互式再分三支:结构化写作(标题生成、新闻播报)、非结构化写作(剧情续写、营销文本)、辅助性写作(内容推荐、润色)。交互式则用于虚拟男友/女友、心理咨询、文本交互游戏。
这个五分法我认可,因为它有判据:看输出要不要人来接、看有没有对话轮次、看语料是模板还是自由文本。顺着这个分法,读者能自己判断一个新出现的产品属于哪一类,而不是等着被归类。
它还顺手给了一句我认为是全书最好的判断:"AI 不具备个人色彩,行文相对严谨、客观,因此在地震信息播报、体育快讯报道、公司年报数据、股市讯息等领域具有较大优势。"这句话说的是 AI 写作的真实边界,而且说对了——它擅长的不是"写得好",是"写得不出错"。
一句话,把边界画出来了。可惜这样的句子,全书只有几处。
三、两张图暴露的方法论:图 0-3 与图 0-6
这本书有两张图,我盯了很久。它们不是插画,是论证工具,而两张都出了问题。
第一张是 p0006 的图 0-3,"人类生成内容向 AIGC 转换趋势"。画面很简单:横轴时间,纵轴数量,一条向下的人类生成内容曲线,一条向上的 AIGC 曲线,两条线交叉。图上没有刻度、没有单位、没有数据点、没有来源。
而正文怎么说这张图?"2022 年是重要的历史拐点(图 0-3)。"
用一张没有刻度的示意图,去支撑"历史拐点"这个判断,这是循环论证:曲线的交叉点落在哪一年,完全取决于画图的人想让它落在哪一年。把横轴拉长一点,交叉点可以挪到 2030;把它压紧,交叉点可以挪到 2019。这张图不提供信息,它只提供态度。
我理解示意图的作用是"让人一眼看懂趋势"。但趋势图的前提是趋势本身有据。没有数据的趋势图,本质是一句画出来的修辞。它出现在一本自称讲"时代"的书的第 6 屏,等于给全书定了个调:这本书的论证方式是"断言 + 示意图",不是"数据 + 推演"。
第二张更成问题,是 p0009 的图 0-6。正文写得很谨慎:
GPT-2 大约有 15 亿个参数,而 GPT-3 最大的模型有 1 750 亿个参数,上升了两个数量级。而且,它不仅参数规模更大,训练所需的数据也更多。根据媒体猜测但还未被证实的消息,GPT-4 的参数可能将达到 100 万亿规模(图 0-6)。
文字部分我挑不出错——它老老实实写了"媒体猜测""还未被证实"。这是这本书的良心。问题在它后面那张图。
图 0-6 画的是两个几何体:左边一个小方块标"GPT-3",右边一个大圆标"GPT-4"。我按屏幕上的比例量了一下,方块边长约 45 像素,圆的直径约 170 像素。
算一下:正方形按面积算,45² = 2 025;圆按面积算,π×85² ≈ 22 700。比值约 11 倍。
而它想表达的数字比值是多少?100 万亿 ÷ 1 750 亿 ≈ 571 倍。
如果真要用面积表示 571 倍,圆的直径应该是方块的 √571 ≈ 24 倍——方块 45 像素的话,圆的直径得画到 1 080 像素,比整个屏幕还宽。画不下,于是画了个 3.8 倍直径的圆,凑合着看。
我不是在抠一张插图的准确性。我想说的是:当一本书用"面积"表示"数量级",而面积与数量级差着 50 倍的时候,它实际上是在用视觉冲击替代数量关系。读者看图得到的印象是"大了不少",而文字说的是"大了 571 倍"。这两个印象之间的落差,恰好是这本书最典型的问题——它知道该谨慎(所以说"未被证实"),但它更想要那个震撼的画面。
顺带说一句:这句"100 万亿参数"的猜测,今天看是错的。GPT-4 的参数至今未公开,业内普遍推测是混合专家架构下的万亿级,远不到 100 万亿。书里加了免责声明,所以它不算造谣;但它把一条明显不可信的猜测画成了图,这就不是谨慎,是既要又要。
四、四类文本与那个"小学生"的类比
第五章第三节"产业下游:应用拓展"给了 23 屏,是全书单节最长的。它把文本类应用分成四类:结构化写作、非结构化写作、辅助性写作、知识型文本处理。前三类是"输出",第四类是"输入"。
p0175 对这个区分做了一次解释,用的比喻我很喜欢:
上述三类文本处理应用从定位上更接近于"输出"的过程,即"使用的目的"是为了有可以外发的、展示的、传播的产出,就好比一个小学生可能会用小猿搜题找到作业的答案,然后把作业展示给老师。而知识型文本处理应用则更注重信息的"输入",帮助用户更好地进行信息的归纳、接收和整理,就好比一个小学生在写作业之前,要用思维导图等工具把上课学到的知识点整理好,内化为之后写作业、考试可以用到的技能。
这个类比的准确度很高。"小猿搜题"与"思维导图"两个意象,一下子把"生成给人看"和"生成给自己用"分开了。而且它隐含了一个更硬的判断:前者是替代,后者是增强。抄答案替代了思考,做导图增强了思考——同样叫 AIGC,价值方向相反。
可惜书里没把这个判断推下去。它举了彩云小梦(续写小说,内置标准、言情、玄幻、都市多种模型,每段可中途修改或换掉,目前免费)和 Mem 作为例子,然后就转去讲别的了。
如果是我写,我会在这里停下来问一个问题:为什么"替代型"的应用先跑通,而"增强型"的应用至今没有爆款?我的答案是:替代型有明确的验收标准(答案对不对、稿子能不能发),增强型没有(导图做得好不好?)。而这本书整本的短板,恰好也是这一条——它一直在讲"能生成什么",从没讲"怎么判断生成得好不好"。
这不是巧合。一个不讨论验收标准的行业观察,必然也只能写出"替代型先赢"这种表面结论,因为它看不见另一条赛道的价值所在。
五、那本成本账,只算了一半
p0135 是电商行业应用的一页,讲虚拟主播。它给了一个很具体的案例和一本账:
虚拟主播"小美"就出现在兰蔻、欧莱雅、OLAY、科颜氏等超过 20 个美妆大牌直播间,开启直播首秀……这类结合人工智能技术的虚拟主播不仅在用户体验方面与真人无异,而且还可以节约 30%~50% 以上的成本。根据网上的调研数据,在一线城市雇用一名优秀主播的月薪大约是 1 万元左右,加上直播场地费,每年差不多需要 15 万元左右的成本,如果再加上硬件设备成本,成本可能达 20 万元,这对商家来说无疑是一大笔开支。
20 个美妆大牌、30%–50%、月薪 1 万、每年 15 万、加硬件 20 万——这些数字给得很诚恳。它连"硬件设备"都想到了,说明作者是真的去算过。
但这本账只算了一边。它算的是"被替代的人"多少钱,没算"替代它的东西"多少钱。数字人的成本结构是:形象定制(一次性,几万到几十万)、驱动与渲染(按并发或时长计费)、运营(脚本、选品、场控,一个数字人直播间照样要三到五个人)、带宽与算力。这些加起来,"节约 30%–50%"能不能成立,取决于你按几年摊销、按几路并发。
而"30%–50%"这个数字,在书里没有分母。相对谁的 30%?是相对那个 20 万/年的人力成本,还是相对整个直播间的运营成本?这两个基数差三到五倍。读者拿这个数字去做决策,会亏得很惨。
同页还有一句话我读了两遍:"在直播过程中,虚拟主播的每帧画面都由人工智能生成。"
这句话在技术上是不准确的。数字人直播的主流方案是 3D/2D 形象加动作驱动加实时渲染,不是"每帧由 AI 生成"——如果真是逐帧生成,一路 1080p、30 帧的直播,一秒要出 30 张图,成本会高出好几个数量级。把"渲染""驱动""合成"统统叫成"生成",是这本书一个贯穿全书的语言问题。
这个问题不小。因为"生成"这个词在这本书里同时指四件技术含量完全不同的事:扩散模型从噪声里长出图像(真生成)、模板加数据填空(结构化写作)、检索后重组(知识型处理)、渲染加驱动(数字人)。四件事的难度差两个数量级,成本差三个数量级,但在这本书里共用同一个词。读者读完,会觉得它们是一回事。
六、产业地图:它其实是份研报,而且写得不错
第五章 46 屏,是全书第二厚的章。它按上中下游切开:上游数据服务 14 屏、中游算法模型 3 屏、下游应用拓展 23 屏。
p0160 讲上游,是我认为全书第二扎实的一段。它讲 Scale AI 的两条护城河:
客户黏性:数据标注服务本身很难建立起高度的客户黏性,而 Scale 之所以可以留住客户,得益于它在 2020 年 4 月推出的 Scale Document。Scale Document 不仅为数据贴标签,还与客户合作建立定制模型。这使得客户切换服务商的成本变高,因为需要重新训练模型。
资源垄断:这里所说的资源垄断指的不是垄断数据而是垄断人才,数据的所有权是客户的,即使通过 Scale 来完成打标签过程,也不能把这些数据误认为是 Scale 的资产。但随着数据流过 Scale 平台,这些数据同样训练了 Scale 平台标注算法的模型能力,也沉淀了这个领域的众多人才,人才是这个领域的宝贵资源。
"垄断的不是数据而是人才"这句话,是全书少有的、有洞察力的判断。它戳破了一个常见的误解:以为数据服务商的价值在于囤数据。实际上数据的所有权在客户手里,服务商能留下的是"处理数据的能力"和"干过这件事的人"。这个判断放到今天依然成立,甚至更成立——因为模型能力在贬值,而"知道怎么把脏数据处理干净"的经验没有。
同页还有 Labelbox 与 Burberry 的案例:"根据 Labelbox 官网的信息,在和 Burberry 合作的过程中成功为 Burberry 节省了 10 个人力,仅花费 2 个小时就可以处理完成上千张图片。"
这个案例给得比虚拟主播那本账诚实——它说了"节省 10 个人力"和"2 小时处理上千张",两个数都可核对,而且没急着换算成钱。该给的细节给到位,不该下的结论不乱下,这一段的分寸感是全书的标杆。
但整章的天平还是歪的:上游 14 屏、下游 23 屏、中游 3 屏。上游讲得细,因为上游是"服务业",好懂、好举例、好算账;下游讲得长,因为下游是"应用",可以一直举例子;中游 3 屏,因为中游是硬技术,讲清楚要交代架构、算力、训练成本、开源与闭源的路线之争——这些都不好写。
于是这本讲"智能创作时代"的书,把最难写的那一层跳过去了。而那一层恰恰决定了这个时代能走多远。
七、它的短板
按"能不能被验证"排,从硬到软。
第一,风险与监管只有一屏,而且是别人的清单。p0218 到 p0219 这两屏里,我看不到一个中国字:从"建立公众对人工智能的信任"到"鼓励机构间协调",八条全是美国或国际组织的 AI 治理原则的中文转述,最后一句是"根据上述原则框架,以及 AIGC 领域后续发展中的监管实践,在不远的未来,在美国将会有更多具体的监管条例落地"。
然后这一节就结束了,翻过去是"下一章"。
我要说清楚边界:这本书的写作时点在 2023 年初,中国的《生成式人工智能服务管理暂行办法》是 2023 年 8 月才施行的,书里不可能引用。所以我不批它"没写中国法规"。我批的是结构:241 屏讲一个"时代",讲它可能带来的风险只给一屏,讲谁在投钱给 18 屏。这个配比说明作者下意识地把"风险"当成免责声明,而不是分析对象。
而风险恰恰是这类书最该写的部分,因为它是唯一不会被三年时间冲掉的部分。技术会迭代,产品会死,公司会倒,但"生成内容的版权归谁""深度伪造怎么举证""训练数据的授权边界在哪"——这些问题只会越来越硬。书里一个都没碰。
第二,六个行业共 21 屏,等于没写。资讯 3 屏、影视 7 屏、电商 4 屏、教育 2 屏、金融 2 屏、医疗 3 屏。教育和金融这两个行业,恰恰是 AIGC 落地最难、争议最大的两个,各给 2 屏。2 屏能写什么?写一个产品名、一句价值主张、一个"未来可期"。
我更愿意相信作者知道这两个行业难写:教育涉及未成年人内容安全,金融涉及合规与可解释性,两个都是"讲不清就别讲"的领域。但把它们放进目录,就等于承诺了要讲。目录里六个行业并列,读者会以为它们分量相当;实际是有的 7 屏、有的 2 屏,而 2 屏那两节,本质上是一句话的展开。
第三,论证方式是"断言 + 示意图"。前面拆过两张图:图 0-3 用无刻度的交叉曲线支撑"2022 年是历史拐点",图 0-6 用面积差约 11 倍的几何体表示数量差 571 倍的参数规模。两张图都不是数据图,是插图;但它们被放在论证位置上,承担了论据的功能。这是这类"时代"书最常见的毛病:它想让人相信一个方向,而不是让人自己算出这个方向。
第四,"生成"一词被用得太宽。扩散出图、模板填空、检索重组、实时渲染,四件事共用"生成"两个字。结果是读者无法从书里判断一件事的技术含量。看到"AI 生成直播画面",以为是视频生成模型;看到"AI 生成新闻",以为是语言模型写作——实际上前者是渲染,后者是模板加数据。这个混淆不会让读者读不懂,只会让读者高估。
第五,时效已经过期,而书里没有提醒。"GPT-4 也预计在不久的将来发布"(p0095);"在不远的未来,在美国将会有更多具体的监管条例落地"(p0219);"伴随着 AIGC 技术的发展,AI 虚拟数字人将收获更强的交互能力……这时的虚拟数字人也许就可以在很多场域下代替真人进行工作"(p0135)。三句预测,三种命运:第一句已经发生(GPT-4 在 2023 年 3 月发布),第二句部分发生,第三句至今没有发生。
预测有对有错很正常。不正常的是,一本预测型的书,没有在任何一个地方标注"这是截至 2023 年 2 月的判断"。读者在 2026 年翻开它,看到的是一堆没有时间戳的断言。
最后照例声明:前四条是我逐字核对过的(页码都在文中),第五条关于写作时点的推断,依据是 p0095 那句"GPT-4 预计在不久的将来发布"——这句话把成书时间锁在了 2023 年 3 月之前。除此之外我没有别的依据,所以只说"推断",不说"确定"。
八、它该给谁读,以及怎么读才不亏
这本书今天还值得读,但不是按它自己希望的方式读。
它值得读的部分,是"史料"。前两章那 80 屏,记录的是 2023 年初一个行业对自身的想象:四模态、Transformer、GPT 三代参数表、Stability 与 Jasper 的融资额与估值、虚拟主播"小美"进了 20 个美妆直播间。这些是时间胶囊。你现在打开任何一篇 2026 年的行业分析,都找不到"2022 年 10 月 17 日 Stability 融资 1.01 亿美元、估值 10 亿"这种颗粒度,因为大家都往前看了。想理解这一轮是怎么起来的,这本书的第一、二、五章仍然是好材料。
它不值得读的部分,是所有"未来"。第六章 26 屏,技术趋势 6 屏、参与主体 18 屏、风险监管 1 屏。趋势那 6 屏今天看基本作废,参与主体那 18 屏讲的公司有一半换了赛道,风险那 1 屏本来就没写。这一章的性价比最低。
我自己的读法是:先读 p0030 那一页,再读 p0160 那一页,然后读附录三"大事记"那 4 屏。三处加起来不到 10 屏,能拿到这本书八成的东西:一个真实的落地案例(地震播报 6 秒 560 字)、一个有洞察的产业判断(垄断人才不是数据)、一条可核对的时间线(大事记)。剩下的 230 屏,是这三处的外围展开。
谁不该读?想学"怎么做"的人。这本书没有一个操作步骤,没有一个提示词,没有一个工具界面。它讲"AI 能生成视频",不讲"用什么生成、参数怎么设"。它是地图,不是手册;而地图的问题是,它画的是三年前的地形。
最后说一句公道话。这本书的推荐值是 72.2%,1513 人点评(p0241)——这个分数不低,我理解为什么:它写得清楚、结构完整、案例具体,作为一本"了解 AIGC 是什么"的入门书,它合格。它的问题不在写得差,在于它把自己写成了"时代",而"时代"这个词要求作者对代价有话说。它对代价只有一屏,还是别人的清单。
写"时代"最难的不是描述它跑得多快,而是说清它撞坏了什么。前者只需要观察,后者需要立场。
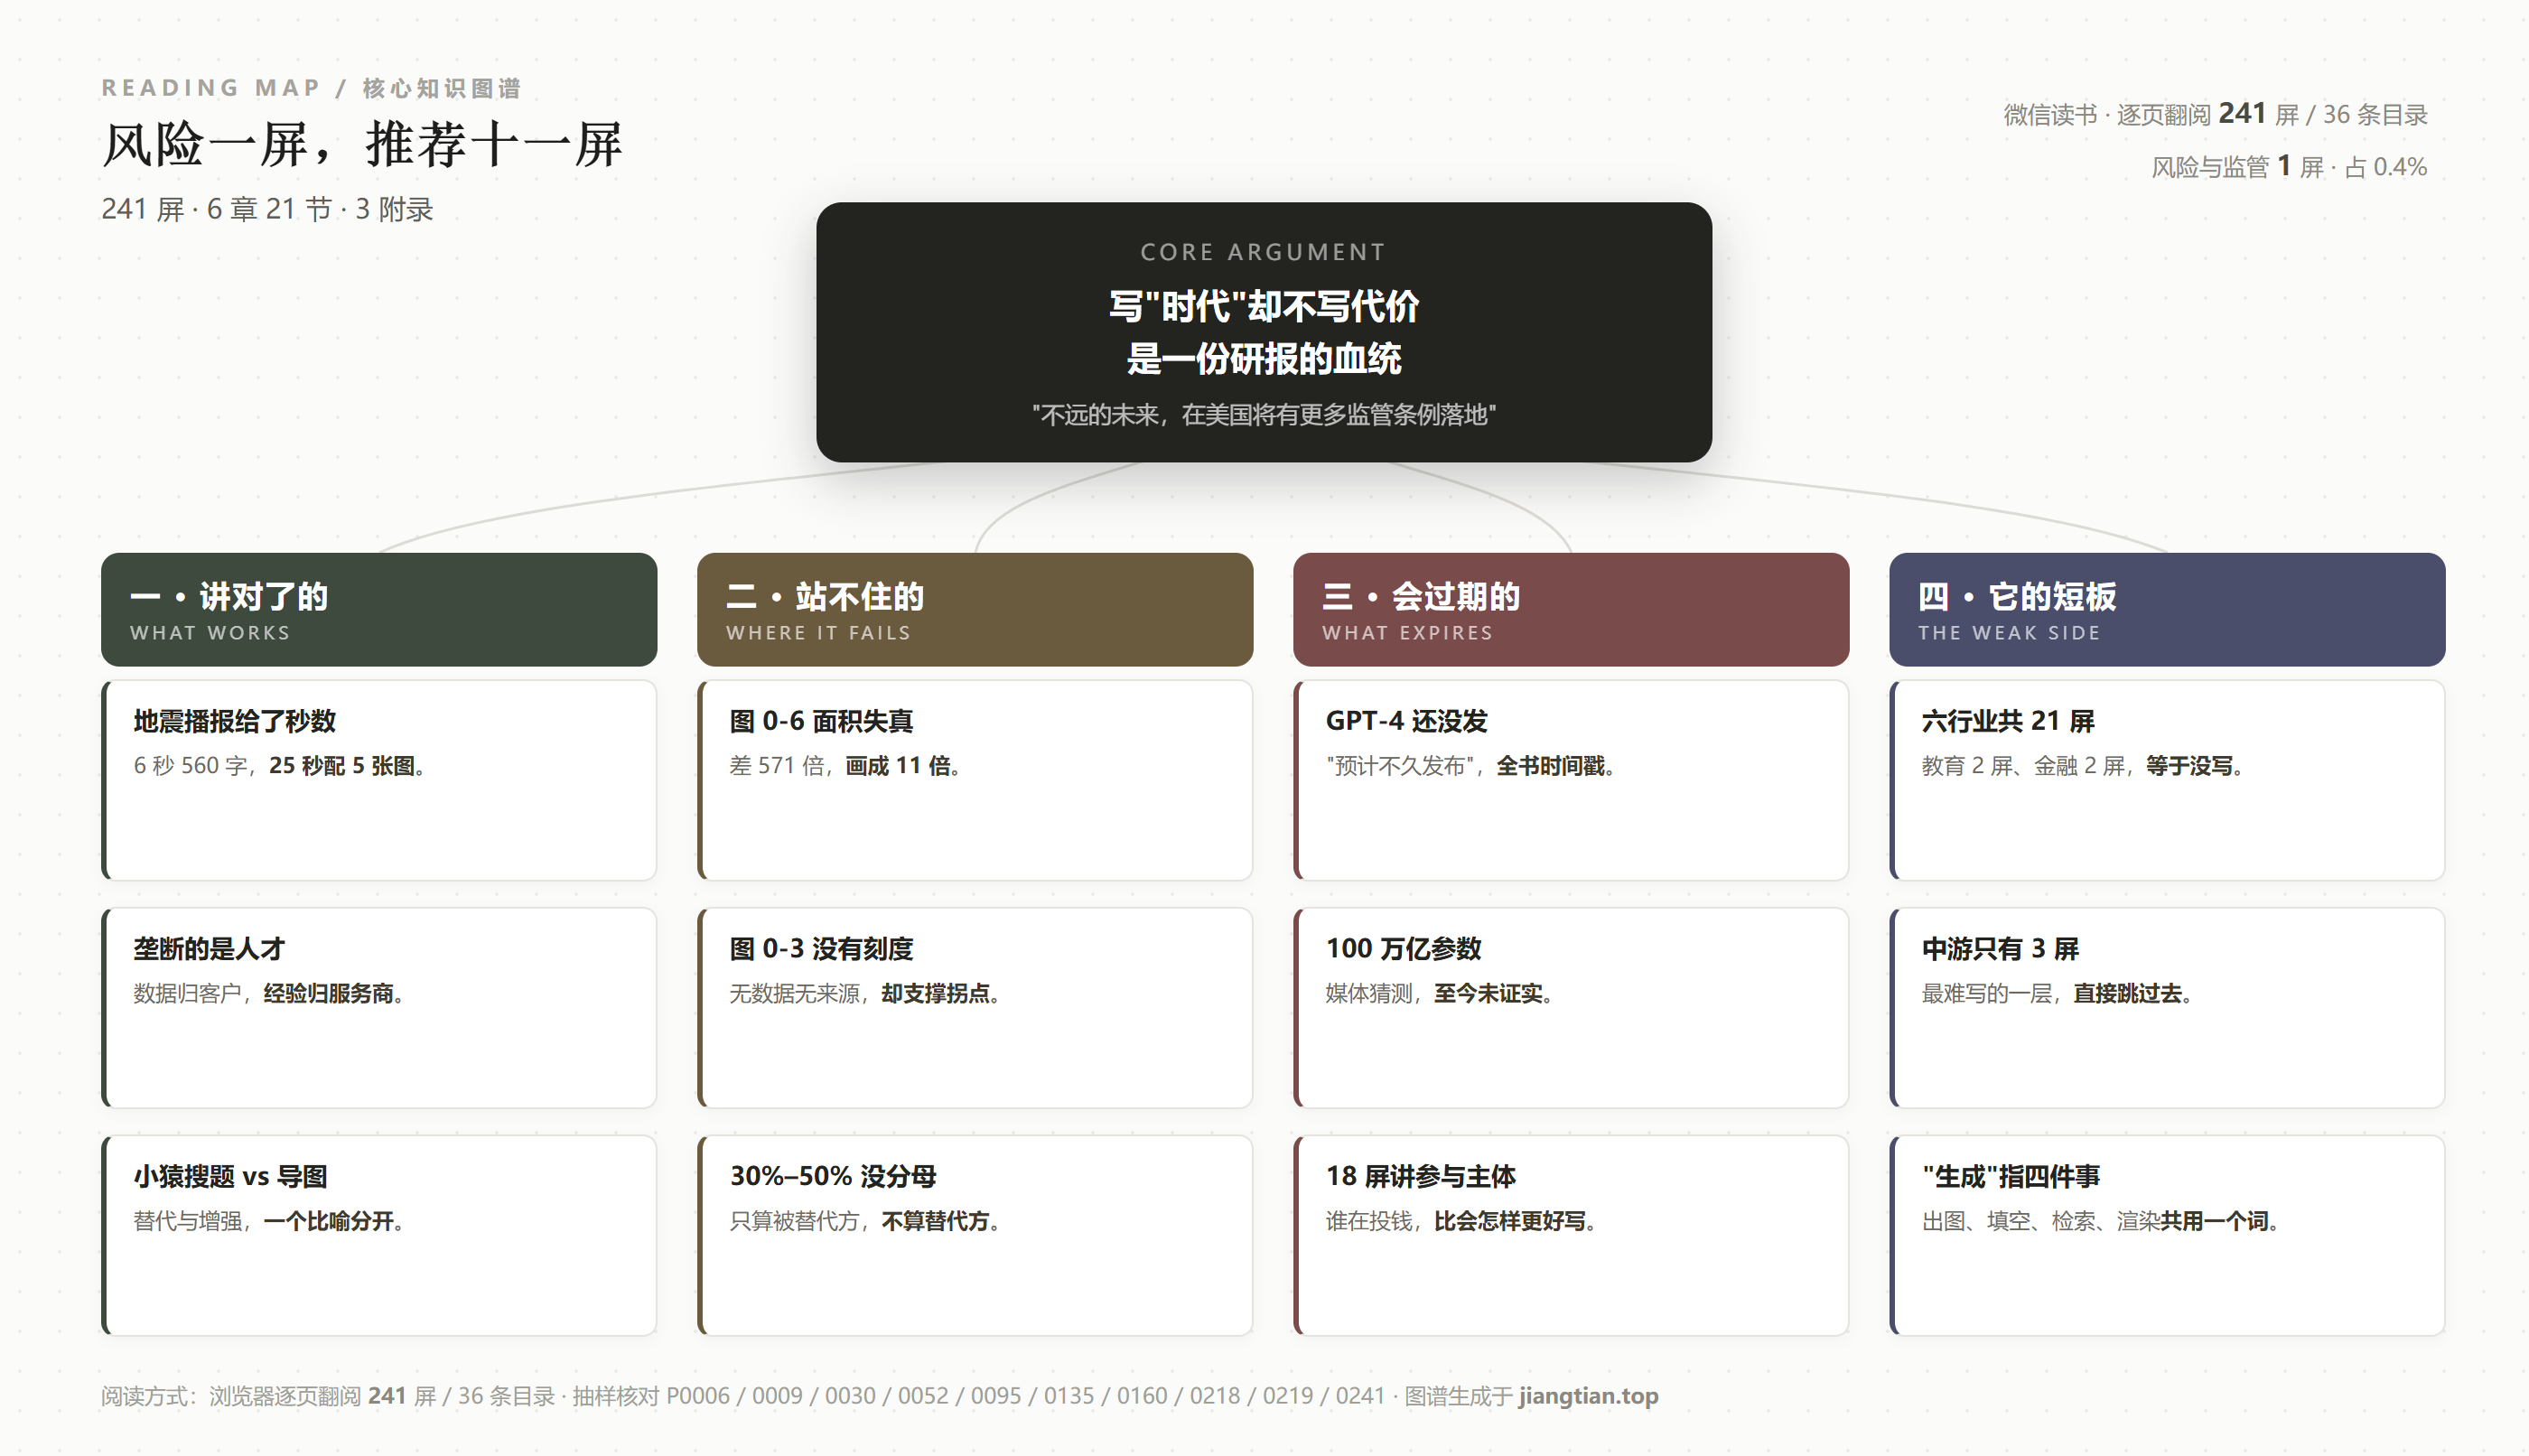
补一个细节,它比正文更能说明这本书的性格:全书最后 11 屏是"专家推荐",前面是后记 2 屏。也就是说,这本书用 11 屏告诉读者"它有多重要",用 1 屏告诉读者"它有什么风险"。推荐语里有前迪士尼研究中心研究员、人工智能博士魏新宇的评价,措辞克制,说的是"非常适合用来了解我们的未来"——注意,是"了解未来",不是"判断未来"。这句推荐语比书本身更准确。
阅读记录:微信读书《AIGC:智能创作时代》· 241 屏 / 6 章 21 节 / 3 个附录 · 逐页翻阅至 p241「全书完」· 抽样核对 p0006、p0009、p0030、p0052、p0095、p0135、p0160、p0218、p0219、p0241 · 2026-11-06
发表评论: