
多模态AI Agent开发实践:259 个标题,89 个只占一屏
微信读书《多模态AI Agent开发实践》· 13 章 · 259 条目录 · 885 屏
逐页翻阅 885 屏 · 读至末页「13.5 本章小结」· 2026-11-06
说明:885 是微信读书的屏幕数,不折纸页。从 p0001「版权信息」翻到 p0885「13.5 本章小结」,中途没跳页。为了写这篇,我逐字核对了九处:p0006 前言、p0050 跨模态对齐、p0128 依赖冲突排查、p0227 ReAct 案例的环境配置、p0331 能力边界、p0445 功能测试、p0663 数据质量管控代码、p0775 知识点溯源、p0883 本章小结。引文都出自这九处,没翻到的地方不写。
先说结论:这本书的前言许诺"帮助读者跨越'能跑通 Demo'与'可稳定商用'之间的鸿沟",而它自己连"能跑通"这一关都没过——第 4 章的安装命令钉了三个互相冲突的版本号。
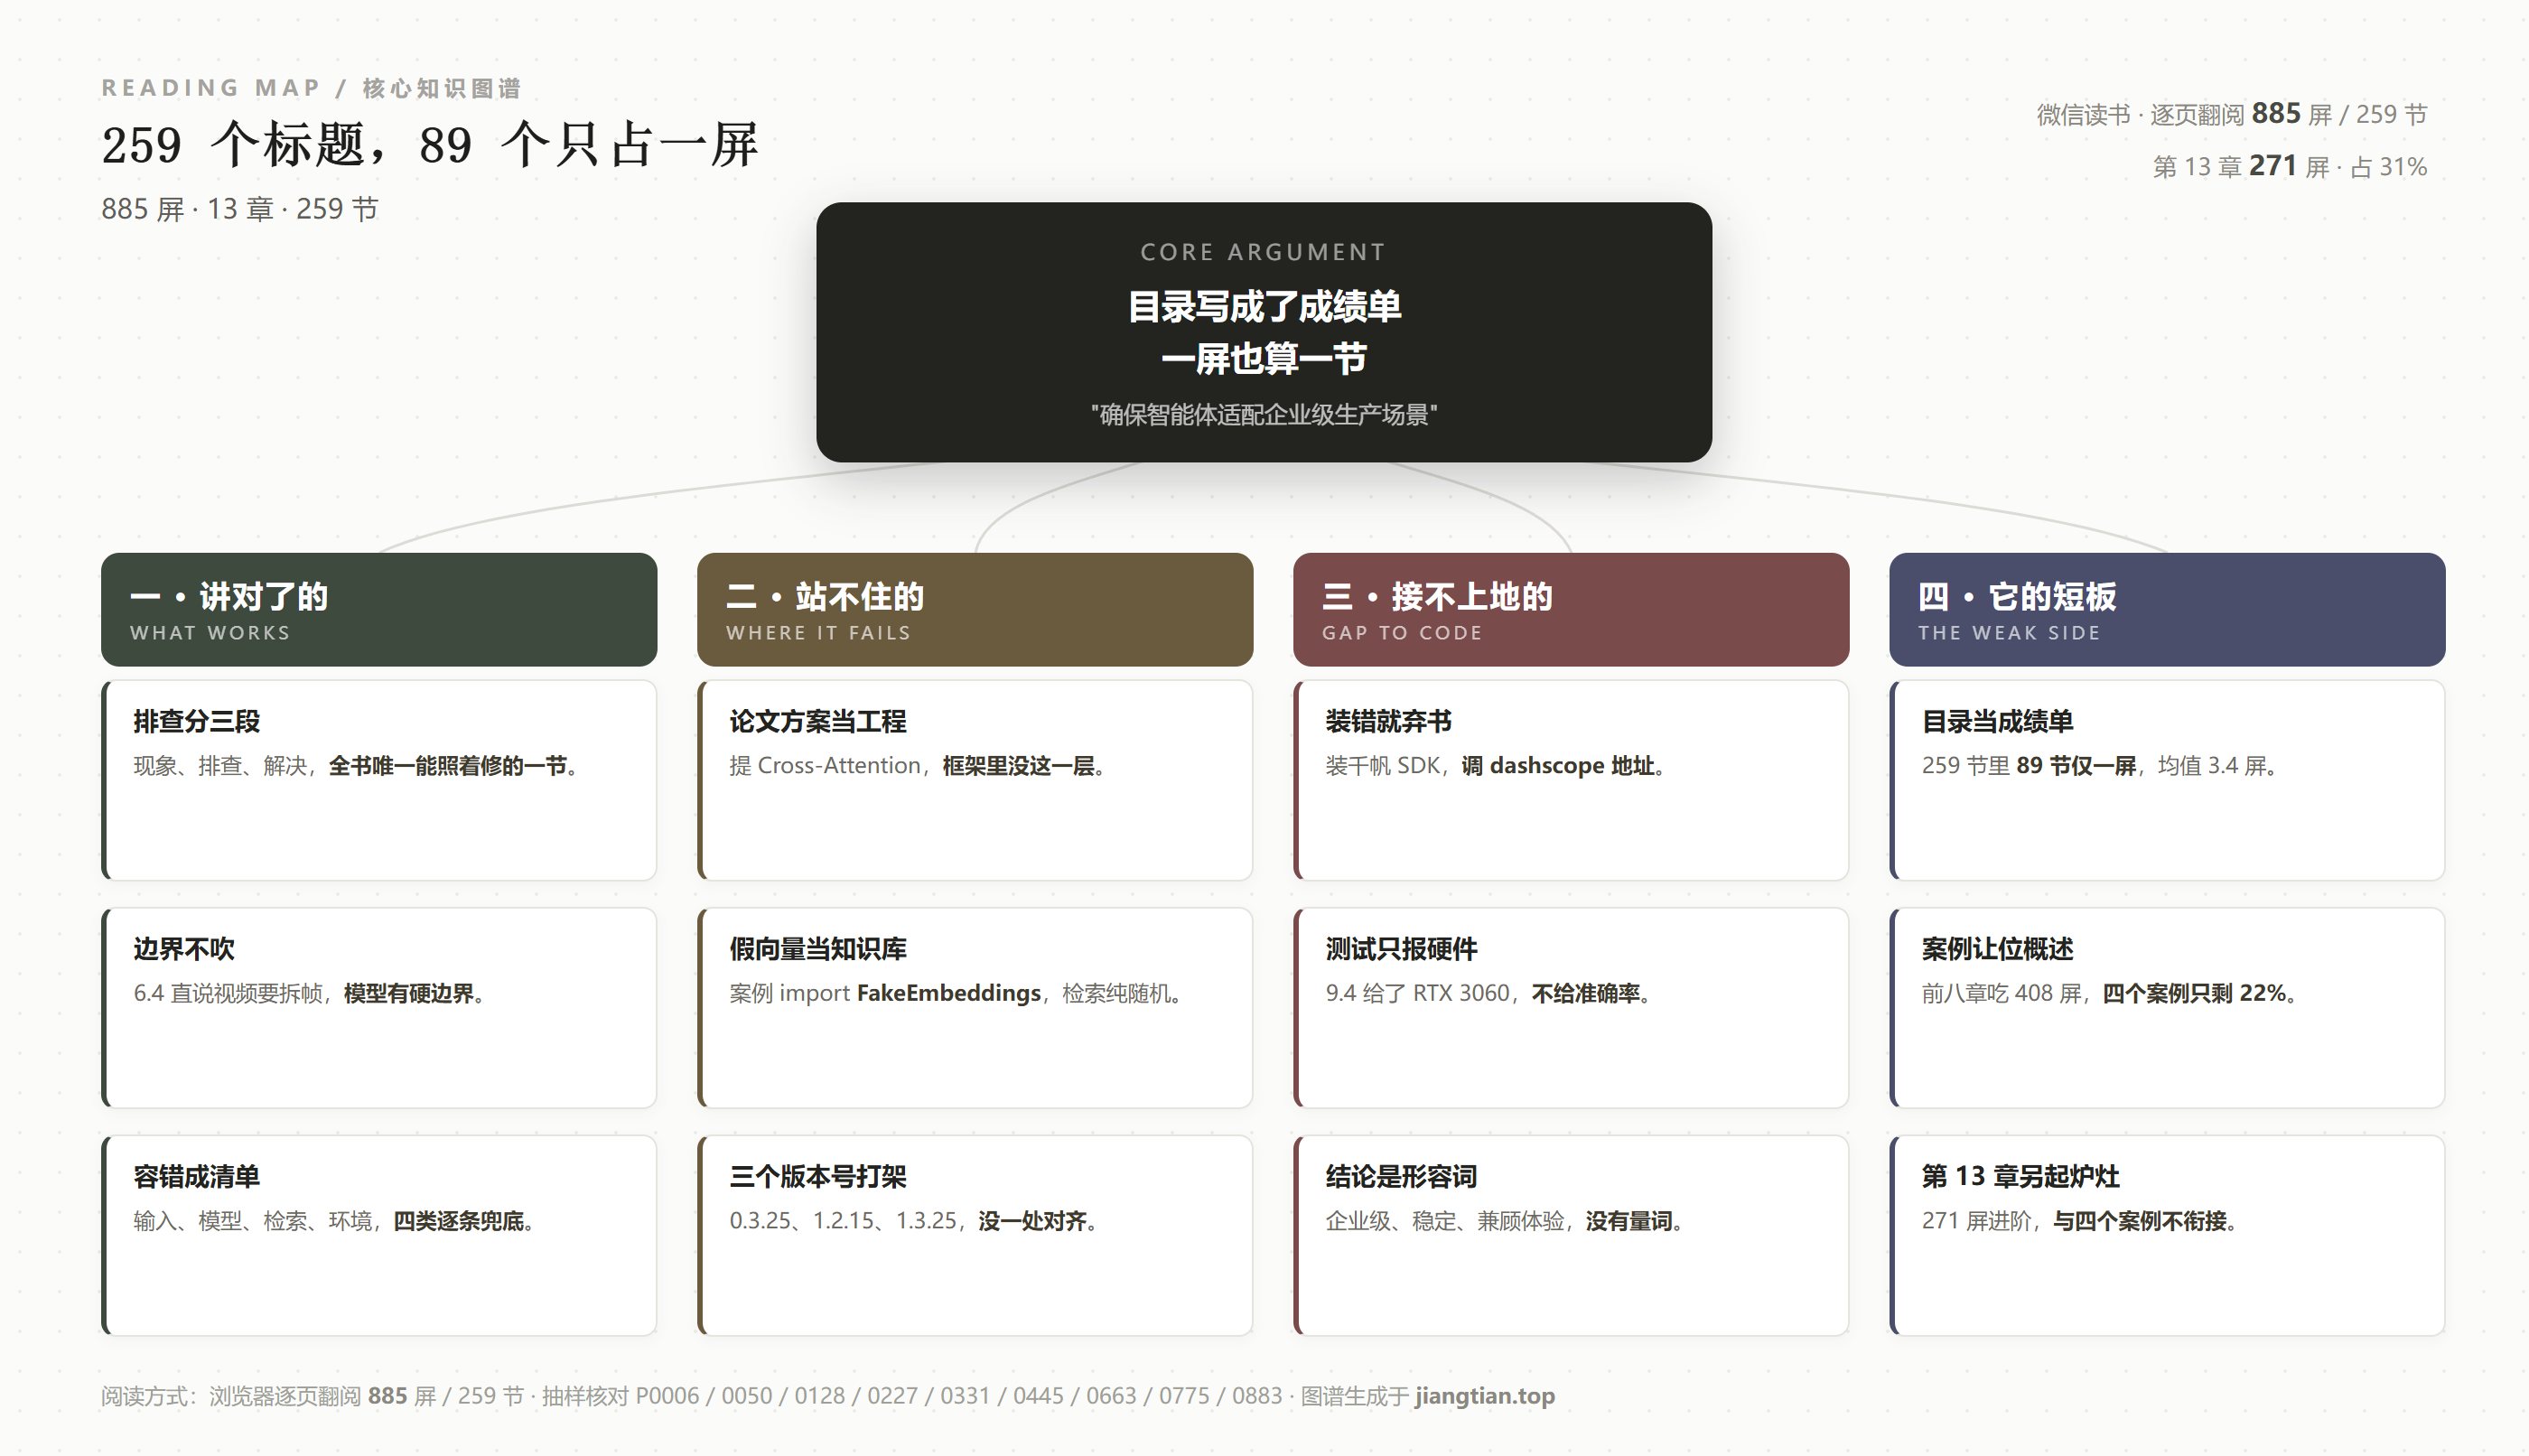
885 屏,13 章,259 条目录。这个数字组合本身就值得停下来看一眼:259 条目录,意味着平均每条目录 3.4 屏。我一开始以为是分节太细,翻完之后发现不是分节细,是节被切碎了——259 条目录里有 89 条只占一屏,占 34%;只占两屏以内的有 151 条,占 58%。
一、把 885 屏摊开:一本"概述书"套了四个案例
按章分开是这样的:第 1 章多模态智能体概述 59 屏(6.7%),第 2 章开发环境 74 屏(8.4%),第 3 章 LangChain 核心组件 67 屏(7.6%),第 4 章 Agent 核心技术 60 屏(6.8%),第 5 章数据处理与存储 47 屏(5.3%),第 6 章多模态大模型基础 21 屏(2.4%),第 7 章 LangChain 集成多模态模型 54 屏(6.1%),第 8 章开发方法论 26 屏(2.9%),第 9 到 12 章四个案例合计 195 屏(22.0%),第 13 章进阶优化 271 屏(30.6%)。
这两个数字放在一起,能看出这本书真实的重心:它不是一本案例书,它是一本"环境 + 组件 + 方法论"的前置教材,外加一个特别长的尾巴。前八章 408 屏讲的是"怎么装、怎么调、怎么想",四个案例只有 195 屏——平均一个案例不到 49 屏。而第 13 章一章 271 屏,比四个案例加起来还多 76 屏。
第 13 章讲什么?数据增强、容错、可解释性、多轮对话融合。这四件事当然重要,但它们的位置不对。它们是"案例跑起来之后"的问题,却被放在四个案例之后当独立一章,而且体量是案例的 1.4 倍。读者读完第 12 章已经有一个客服智能体了,翻到第 13 章却要从"文字数据增强与清洗"重新起头——这不是递进,是换了一本书接着写。
四个案例的内部分配也差不多是同一个模子:场景需求、技术方案、代码实现、功能测试、部署优化、本章小结,六段。第 9 章 37 屏,代码 13 屏;第 10 章 44 屏,代码 18 屏;第 11 章 47 屏,代码 14 屏;第 12 章 67 屏,代码 23 屏。四章合计 195 屏,代码 68 屏,占 35%——这个比例本身没问题,问题是六段里的"场景需求"每章只有三到七屏,"部署优化"每章只有一到四屏。一本书要跨"能跑通"和"能商用"两道坎,结果给"商用"的那一段(部署、并发、成本、监控)每章不到四屏。
前言里有一句话,我读的时候划了线:
书中四大实战案例覆盖文档解析、视觉问答、内容创作与智能客服,均源自真实业务场景,直面数据质量、容错与鲁棒性、可解释性、多轮对话融合等工程约束。
"均源自真实业务场景"是个可以检验的承诺。检验的方式很简单:真实业务场景里的东西,一定有数字。单量、响应时长、准确率、人工介入率、每天处理多少份文档——至少有一个。四个案例我一个个翻过去,一个都没有。这一点留到第七节说。
二、一屏一节:目录是怎么被做成绩单的
第 5 章是最能说明问题的样本。它的目录长这样:5.1 多模态数据加载、5.1.1 依赖确认与环境准备、5.1.2 四大类多模态数据加载实操、5.1.2.1 图片数据加载(JPG/PNG/GIF)、5.1.2.2 音频数据加载(MP3/WAV)、5.1.2.3 视频数据加载(MP4/AVI)、5.1.2.4 文本数据加载(TXT/PDF/Markdown)、5.1.3 多模态数据加载注意事项。
从 5.1 到 5.1.4,整整八条目录,对应 p0275 到 p0283,九屏。其中 5.1 一屏、5.1.1 一屏、5.1.2 一屏、5.1.2.1 一屏、5.1.2.2 一屏、5.1.2.3 一屏、5.1.2.4 一屏。八条目录,七条各一屏。
再看 5.3 向量数据库集成:5.3.2 Chroma 本地向量数据库集成(开发测试首选)一屏,5.3.3 Pinecone 云端向量数据库集成(生产环境适配)一屏,5.3.4 Milvus 分布式向量数据库集成(大规模数据适配)一屏。三种向量数据库,一种一屏。而 5.3.1"向量数据库集成基础准备"给了六屏。
一屏能装什么?八百字左右,或者一段话加二十行代码。它能装一个"什么是 Chroma",装不下"Chroma 在什么数据量下该换成 Milvus"。而括号里那句"生产环境适配""大规模数据适配"恰恰是需要证据的判断——多大的规模算大?到多少条向量时 Chroma 开始明显变慢?这三个词后面本该跟着三个数量级,实际跟的是回车。
我不是在说分节细是错的。学术书的分节比这细得多。问题在于"节"在这里不是结构单位,是排版单位。结构单位要有独立的论点,排版单位只需要换行。259 条目录里 89 条只有一屏,意味着三分之一的"节"没有独立论点——它们只是把上一屏的最后一句话换了个标题继续。读者翻目录时会以为有 259 个知识点,读的时候发现只有 170 个左右,剩下的是目录学。
这件事有一个很实际的代价:你没法用目录来定位。想查"Milvus 怎么配",目录告诉你 5.3.4,翻过去一屏,看完还得回 5.3.1 补前置。目录本该省时间,这里反而多花了一次跳转。
还有一个数字比 89 更值得说:第 6 章"多模态大模型基础"只有 21 屏,占 2.4%,是全书最短的一章。这一章讲什么?6.2 主流多模态模型(GPT-4V/CLIP/BLIP/Qwen-VL)三屏,6.3 输入输出格式三屏,6.4 能力边界三屏,6.5 qwen-vl-plus 基础实操四屏。一本书名里写着"多模态"的书,讲"多模态模型到底怎么回事"的部分,占 2.4%;讲"怎么装环境"的部分,占 8.4%。
这个比例决定了这本书的性格:它假设你已经知道多模态是什么,只想快点把代码跑起来。如果前言是这个意思,那没问题。但前言说的是"兼顾学术深度与产业落地"——"学术深度"那半边,在这 21 屏里只够放四个模型的名字、每个名字一句介绍。
三、全书最值得学的一节,是讲报错的那一节
说完结构,我要说这本书真正的长处,而且这个长处很具体:它会写排查。
第 2 章的 2.6.2"常见问题排查"是第 2 章最长的一节,十四屏——比"API 密钥配置"三节加起来还长。它的每一个问题都按同一个三段式写。p0128 是"依赖冲突问题(最常见)":
(1)问题现象:安装依赖时提示"version conflict",或运行代码时出现"ImportError""AttributeError"。
(2)排查方法:执行 pip list 查看所有依赖包版本,对比 LangChain 官方文档的推荐依赖版本,找出冲突的依赖包。
(3)解决方法:卸载冲突的依赖包,安装推荐版本……若冲突较多,则可重新创建虚拟环境,按本章步骤重新安装依赖。
这个三段式是全书最值钱的东西,比任何一个案例都值钱。因为它教的不是"遇到 X 就做 Y",而是"怎么把一个问题变成可执行的步骤":先看现象(报什么错),再定位(用哪个命令查),最后动手(先卸载还是先重建环境)。第三段末尾那句"若冲突较多,则可重新创建虚拟环境"尤其老练——这是有真实踩坑经验的人才会写的判断,因为它承认了"有时候修不如重装"。
我数了一下,14 屏里这种三段式至少出现了五个问题:依赖冲突、OpenCV 安装失败、模型调用超时、多模态文件读取报错、环境变量不生效。五个问题,五套"现象—排查—解决",这是这本书唯一能让人合上书直接操作的部分。
第二个问题写得更实。它不是笼统地说"OpenCV 装不上",而是先给出具体的报错文本——安装 opencv-python 时提示"编译失败""missing header",然后才进排查。这一点很关键:报错文本是可以直接复制去搜的,而"安装失败"四个字搜不出任何东西。一个作者愿不愿意把报错原文抄进书里,基本能判断他自己有没有真的装过。
也正因为这一节写得好,后面的落差才明显。同一本书里,能写"复制这行报错去搜"的人,会在安装命令里写三个互相冲突的版本号;能写"若冲突较多就重建虚拟环境"的人,会让读者在第一次跑代码时就撞上一次依赖冲突。这不是能力问题,是流程问题——这一节大概是他真踩过坑之后写的,其他章节不是。
然后就出现了一个很难看的对照。这本书最会写"依赖冲突怎么排查",而它自己给出的安装命令,本身就是一次依赖冲突。
四、同一条占位命令,书里给了三个版本号
p0227 是第 4 章 ReAct Agent 实操案例的环境配置。它先给 .env:
# 通义千问 API 配置(需在阿里云百炼平台申请)
QWEN_API_KEY=你的 qwen-vl-plus API Key
QWEN_SECRET_KEY=你的 qwen-vl-plus Secret Key
注释说得清楚:阿里云百炼。代码里的调用地址也对:https://dashscope.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation——这是阿里云 DashScope 的多模态接口。然后下一屏的依赖列表是这样的:
pip install langchain==0.3.25 langgraph==1.0.5 langchain-core==1.2.7 langchain-community==0.4.1 python-dotenv==1.0.1 aliyun-python-sdk-core==2.15.0 aliyun-python-sdk-qianfan==0.1.9 TTS==0.13.3 requests==2.31.0
这一行有三个问题,而且都不需要装完就能看出来。
第一,版本互相打架。langchain 0.3 系列要求 langchain-core 在 1.0 以下;langchain-community 0.4 系列要求 langchain-core 在 1.0 以上。这里把 langchain==0.3.25、langchain-community==0.4.1、langchain-core==1.2.7 三个钉在同一行,pip 会在解析阶段直接报依赖冲突,一行代码都装不上。而以"依赖冲突"为第一个排查项的作者,恰恰在这里制造了一个依赖冲突。
第二,装错了平台的 SDK。注释说阿里云百炼,地址是 dashscope,但依赖里装的是 aliyun-python-sdk-qianfan——这是百度千帆的 SDK。它对这个案例毫无用处。读者照着装完,会发现多了一个永远用不上的包,而且不知道该删不该删。正确的做法是根本不装 SDK——dashscope 走的是 HTTP 接口,同一个案例的代码里用的就是 requests。
第三,也是最有意思的:版本号在书里出现了三次,三次都不一样。p0227 的 pip 行写 langchain==0.3.25;p0663 的代码注释写"兼容 langchain==1.2.15 导入路径";p0445 的测试环境写"指定依赖版本(如 langchain-1.3.25、langgraph-1.1.5 等)"。0.3.25、1.2.15、1.3.25——同一个依赖,三个版本,分别出现在第 4 章、第 13 章、第 9 章。
这不是笔误的级别。笔误是一处写错,改一个字符就好。三个版本号意味着这三章是在不同时间、用不同环境写的,而且合并的时候没人对过样本。读者按第 2 章装好环境,跑第 4 章报错,去第 9 章对版本,得到第三个答案——这种时候他不会怀疑书,他会怀疑自己。
五、假向量:第 13 章的知识库,检索结果是随机的
如果说版本号打架是"编辑事故",那么下面这一处是"设计事故",而且更严重。
p0663 是 13.1.5"案例实战:多模态客服智能体数据优化与实现",27 屏,是 13.1 节最长的一段。它的开篇写得很正经:全流程数据质量管控,原始数据目录、增强数据目录、知识库目录、日志文件,四个目录,一份 .env,然后"3. 核心代码实现"。
代码的 import 段是这样的(我放大核对过):
from langchain_community.vectorstores import Chroma
from langchain_community.embeddings.fake import FakeEmbeddings
from langchain_core.documents import Document
FakeEmbeddings。假向量。
如果你不熟这个类:它是 LangChain 提供的一个测试替身,embed 出来的是一串随机数。它存在的唯一目的是让单元测试不需要下载真实模型、不需要联网、跑得快。用 FakeEmbeddings 建出来的向量库,相似度检索返回的是随机结果——不是"不太准",是"跟内容无关"。
也就是说,这一段被命名为"知识库构建"、出现在"数据质量管控"标题下的代码,它的检索部分是空的。你按它跑通,界面上会显示"已检索到 3 条相关知识",那 3 条是随机的。
我能理解作者为什么这么写。用真模型要下载几百兆的 embedding 模型,要联网,读者第一次跑就一定失败;用 FakeEmbeddings 可以保证"代码能跑通、界面能出结果"。这是教学上的合理妥协,但它必须被说出来。
一句注释就够:# 示例用 FakeEmbeddings 保证离线可跑,生产环境请换成 DashScopeEmbeddings 或 bge-m3,否则检索结果无意义。这句话十二秒能打完,它决定读者是"知道自己在用测试替身",还是"以为自己有了一个知识库"。书里连一句都没有。而在同一页的代码里,作者明明有写注释的习惯——上面那行"兼容 langchain==1.2.15 导入路径"就是注释。
更值得说的一句是:这不是一个代码错误,是一个教学伦理问题。代码错误会让程序崩,崩了你知道;替身不留说明会让程序"正常"地给出错误答案,而你以为它对了。学习者最怕的不是报错,是静默的错。如果非要给这本书提一条最低限度的修改建议,就是所有示例代码顶上统一加一行注释:本段使用测试替身,生产请替换。这一行不占版面,但它把"我知道"和"你以为"分开了。
同类的痕迹在第 13 章不止一处。p0775 的可解释性案例,代码开头连续四行环境变量:TF_CPP_MIN_LOG_LEVEL=3、CURL_CA_BUNDLE=""、HF_HUB_OFFLINE=1、TRANSFORMERS_OFFLINE=1——强制离线、关闭 SSL 校验。这两个设置放在一起,说明代码是在"模型已经下好、不能联网"的机器上跑通的,而读者第一次运行必然需要联网下载模型。书里没写"请先联网跑一次把模型缓存下来,再打开离线开关"。
六、把论文的解法搬进工程章节
第 1 章第 1.3 节讲"核心挑战与解决方案",四个挑战,每个四到五屏。第一个是"跨模态语义对齐精度不足",p0050 给的方案是:
通过专业的模态特征提取工具(如 CLIP 用于图像特征提取、Wav2Vec 2.0 用于语音特征提取),提取不同模态的细粒度特征(如图像中的像素级特征、语音中的音素级特征);再通过跨模态注意力机制(如 Cross-Attention),强化细粒度特征与文本语义的关联,实现细粒度对齐。
这段话在论文里是对的,在这本书里是错位的。因为这本书的技术栈是 LangChain——一个编排框架。它封装的是"调模型、拼提示词、连工具、存向量"。它没有、也不打算给你一层可以改注意力的接口。你没法在 LangChain 里"通过 Cross-Attention 强化细粒度特征与文本语义的关联",因为那需要在模型内部改结构,而 LangChain 始终在模型外部。
更要紧的是后面那句举例:在工业巡检场景中,用提示词"重点识别图像中设备的微小裂纹,结合文本中的故障描述,精准对应裂纹位置与故障类型",引导大模型实现细粒度对齐。
前半段说要改注意力,后半段说写句提示词就行。这两件事不在一个层面。读者读到这里会以为"细粒度对齐"是一个能通过提示词调出来的效果,而它实际是模型架构、训练数据、分辨率共同决定的能力上限。把架构问题写成提示词问题,是这类书最常见的一种偷懒——不是作者不懂,是这一节没有可写的工程内容,只能用论文填空。
对照一下第 6 章 p0331 的写法,你就知道这本书其实会写边界:
(1)支持的模态范围:可稳定处理文本、图片、音频输入,视频输入需拆分为帧图像(如前 5 章视频加载方法),无法直接处理完整视频流。
这是全书我最愿意引用的一段。"无法直接处理完整视频流"——一句否定句,一个明确的边界,还顺手指回了第 5 章的做法。这句话的可信度,比第 1 章那一整页 CLIP + Wav2Vec2 + Cross-Attention 加起来都高。因为它说的是"做不到什么",而做不到的事是可以验证的。
七、证据链:只有硬件,没有准确率
9.4"功能测试与效果验证"四屏。开头写"验证功能完整性、解析准确性与性能达标情况,采用'测试用例 + 实际文档测试'的方式"——三个待验证项,一个测试方法。然后它给了测试环境:
(1)硬件环境:CPU i7-12700H,内存 16GB,GPU RTX 3060(6GB)。
(2)软件环境:Python 3.11,指定依赖版本(如 langchain-1.3.25、langgraph-1.1.5 等),Windows 11 系统。
(3)测试文档:3 份测试文档,包括 PDF 文档(20 页,含文字、3 幅图片、2 个表格)、Word 文档(15 页,含文字、2 幅图片、1 个……
硬件给得比结果细。CPU 型号、内存容量、显卡型号和显存,一个不落;测试文档连"20 页、3 幅图、2 个表格"都数清楚了。这是很扎实的准备工作——然后它没有交出这三个数:解析准确率是多少?响应时间多少秒?四个案例里最该被量化的"准确"两个字,全文没有出现过一次具体数值。
这不是吹毛求疵。"验证解析准确性"是你的承诺,那么准确性的定义(三份文档共多少个字段?判定标准是什么?)和结果(对了几个?)就是必须交的作业。把测试环境写这么细,反而让缺失更刺眼——你连显存都记得写 6GB,为什么不写解析对了 47 个字段里的 43 个?
第 13 章的收尾把这种写法推到了顶。p0883,13.5 本章小结:
结合 LangChain+LangGraph 架构,提供了完整的技术方案、代码实现与落地案例,确保智能体适配企业级生产场景,兼顾性能、稳定性与用户体验。
"确保""企业级""兼顾"——三个词,零个量词。"确保"是一种承诺,"企业级"是一个标签,"兼顾"是一种态度。这三个词放在一起,读起来很顺,查起来什么都没有。一本 885 屏的书,最后一段总结里没有一个数字。
前言说"帮助读者跨越'能跑通 Demo'与'可稳定商用'之间的鸿沟"。这句话本身写得很好,它把这本书的定位说清了:不是教你怎么写出第一个 Agent,是教你怎么让它别在半夜挂掉。但"稳定商用"是个可以用数字描述的境界——可用率、平均恢复时间、单次调用成本、误答率——而这本书一次都没用数字描述它。它用形容词描述了一个需要数字的承诺。
八、它的短板
按规矩,这一节只写短处,不掺好话。
第一,目录被做成了成绩单。259 条目录,89 条一屏(34%),151 条两屏以内(58%),平均 3.4 屏一节。第 5 章 5.1 到 5.1.4 八条目录九屏、5.3.2/5.3.3/5.3.4 三种向量库各一屏,是最典型的样本。后果不是"内容少",是"目录失去了检索功能"——翻到那里还得往回跳。
第二,四案不如一章。四个案例 195 屏(22%),第 13 章 271 屏(31%)。案例是这本书唯一能证明"这些零件能装成机器"的部分,它拿到的篇幅比"零件装好之后怎么保养"还少 76 屏。而且第 13 章是从"文字数据增强"重新起头的,与第 12 章的客服智能体没有接口。
第三,示例代码的可信度被三处硬伤拖垮。依赖版本三处不一致(0.3.25/1.2.15/1.3.25);装百度千帆 SDK 调阿里云 dashscope;知识库用 FakeEmbeddings 建假向量且不作说明。这三处只要中一处,读者就会在第 4 章或第 13 章卡住;中三处,等于这本书的代码只能当伪代码读。
第四,该给数字的地方给形容词。9.4 测试只报硬件不报准确率;13.5 小结用"确保/企业级/兼顾"收尾。一本讲"工程实践"的书,工程性最硬的证据就是数字,而它把数字留在了读者的想象里。
第五,第 1 章用论文填空。CLIP + Wav2Vec2 + Cross-Attention 三段式在 LangChain 里一步都落不了地,紧接着又用一句提示词"实现细粒度对齐",把架构问题降级成了措辞问题。
那么它适合谁?适合已经把环境装好、正在被报错折磨的人。第 2 章 2.6.2 那十四屏,是我在这个品类里见过最像"运维手册"的一节,五个问题五套"现象—排查—解决",可以直接照着修。也适合想看一眼"多模态 Agent 的完整骨架长什么样"的人:13 章目录摊开,从环境到模型到案例到容错到可解释性,骨架是全的。
它不适合谁?不适合照抄代码的人(三处硬伤,第 2 章能过第 4 章过不去),也不适合想找可复现效果的人(四个案例没有一个数字)。
我自己的读法是:先读 2.6.2 排查那一节,把它当工具书放在手边;再读第 6 章 6.4 能力边界三屏,知道自己手里的模型不能干什么;第 3、4 章当 LangChain 速查;第 9 到 12 章只看技术方案设计和流程拆解,代码跳读并默认它有坑;第 13 章留到真的要做容错和可解释性时再翻。第 1 章可以直接跳过——那一章的信息密度全书最低。
最后说一句公道话。这本书的结构是诚实的:13 章的目录确实覆盖了一个多模态 Agent 项目从装环境到上线的全部环节,没有漏项。它的问题不是不知道要写什么,是每一节都只写了个开头。259 个标题像 259 个抽屉,拉开一半是空的。一本 885 屏的书,最后让人记住的是一句"视频输入需拆分为帧图像"——因为那是全书少数几句能被验证的话。
能把"依赖冲突怎么排查"写成三段式的人,不会不知道自己那行 pip 装不上。他大概只是没在同一个环境里,从头到尾跑过一遍。
阅读记录:微信读书《多模态AI Agent开发实践》· 885 屏 / 13 章 / 259 条目录 · 逐页翻阅至 p0885「13.5 本章小结」· 抽样核对 p0006、p0050、p0128、p0227、p0331、p0445、p0663、p0775、p0883 · 2026-11-06
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: