
一条视频号视频是怎么做出来的?我把它拆成了 93 个镜头
我用一个开源工具把这条 3 分半的视频号视频拆成了 93 个镜头,看清了它每一秒是怎么拼出来的。
这不是一条炫技的片子。没有绿幕,没有特效堆叠,灯光就是展馆顶上的射灯,机器就是一台手机加一根自拍杆。但它能在 226 秒里塞进一场行业大会、10 个创业者的采访、一个 AI 产品的实操演示,最后还落回自己的团队——这种「信息密度」,才是它真正的技术含量。
下面是逐镜拆完的结论。数据来自 rea-video 这个开源 skill 的自动取证,加上我人工看片的复核。
一句话结论
整片 226 秒、93 个镜头、平均 2.43 秒一刀;字幕是后期压上去的硬字幕(白字黑描边、底部居中);声音是真人同期声配 124.5 BPM 的曲库 BGM;一共埋了 35 处音效点。
换句话说:这条片子 七成是「走出去拍」,剩下三成全是后期——公众号截图做的卡片、手机 App 录屏、UI 动效、一张地图动画,还有一段 12 秒的 3D 卡通。所谓「AI 含量」,其实只有一个镜头段落。
这条片子讲了什么
作者是视频号「徐老师AI+」,11 月 5 日发布。主线很清楚:
他在世界互联网大会现场,先替观众问了一个问题——「OPC(一人公司)到底能不能做?」,然后花了近两分钟在 OPC 创业集市里挨个采访创业者,问他们做什么、缺什么。中间插一段 3D 卡通,用两个小人打比方:做产品的人和做内容的人怎么搭在一起。后半段他自己上手,用「千问Go」搭了一个帮 OPC 找搭子的平台,把匹配结果给受访者看。最后回到公司,团队一起把想法做成能跑的应用。
结构是标准的四段式:提问 → 走访 → 自己动手 → 落到团队。这个结构决定了它的素材配比:走访需要大量实拍,自己动手需要大量屏幕证据,所以「实拍 + 录屏 + 卡片」是必然的组合,不是审美选择。
93 个镜头,只有 5 种来源
| 画面来源 | 时长 | 占比 | 用在哪 |
|---|---|---|---|
| 实拍 | 162.1s | 72% | 展馆游走、一对一采访、办公室收尾,共 62 个镜头 |
| 代码/模板渲染 | 约 27s | 12% | 开场 21 秒的公众号截图卡片流、地图动画、白底 UI 卡片动效 |
| AI 生成视频 | 约 18s | 8% | 100.7–112.4s 那段 3D 卡通(是否纯生成待确认,见文末) |
| 静态图 + 推拉 | 15.9s | 7% | 首帧、以及后半段把 App 截图放大推进的几处 |
| 3D 渲染 | 2.3s | 1% | 零星过渡 |
这个配比是「人工复核后」的数字。工具第一遍只靠像素统计给出的初判是「实拍 53% + AI 18% + 3D 15%」——把展馆里一堆虚化背景的镜头误判成了 AI。这类误判是必然会发生的:微信转码把传感器噪声抹掉了,机器少了一条最可靠的证据,只能靠人眼看。
开场 21 秒:一条纯后期的「卡片流」
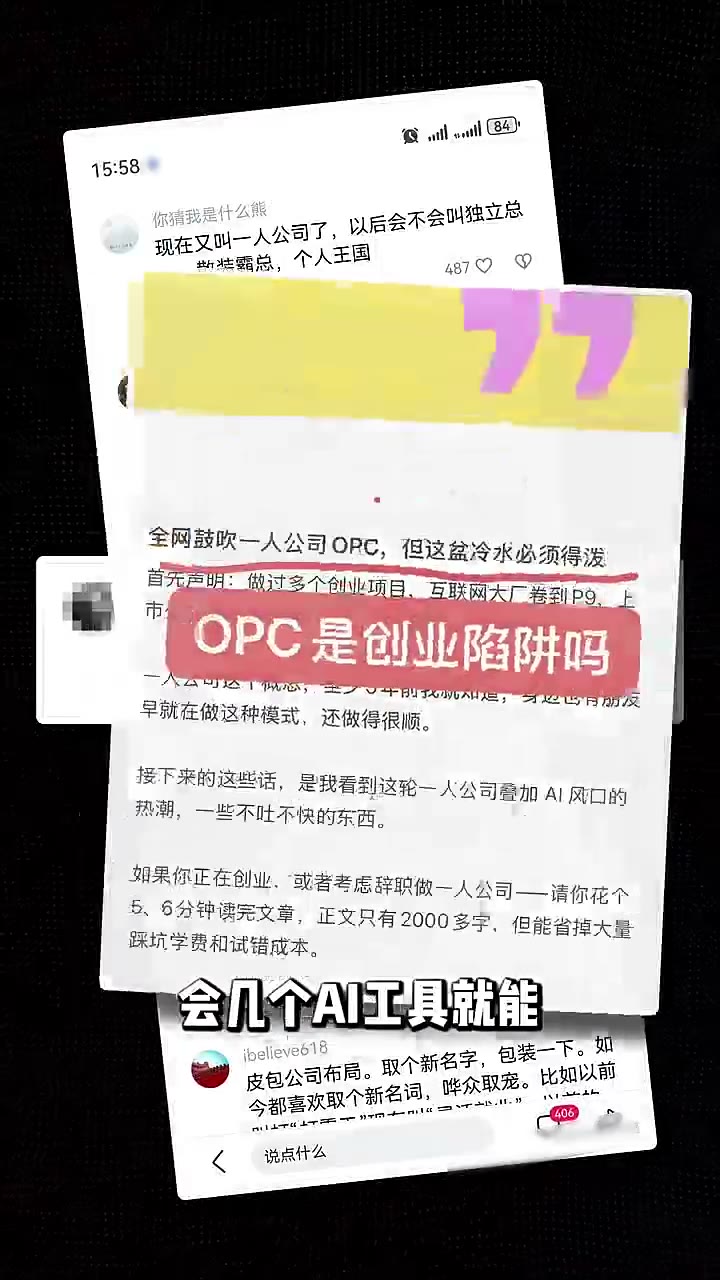
很多人以为开头那 20 秒是「快剪花絮」,其实它一帧实拍都没有。做法很土但很有效:
- 纯黑底当画布,把公众号里讨论 OPC 的文章截图一张张丢进去;
- 每张截图做 3%–5% 的缓慢缩放和轻微位移(推拉),视觉上就有了「呼吸」;
- 关键句用黄色荧光笔色块压在上面,再用红色大字打出「OPC 是创业陷阱吗」——整片最大的情绪钩子放在第 8 秒;
- 中间穿插几个竖屏素材小窗(女生口播、男生办公、会场演讲),带彩色描边,做出「我在看很多人的说法」的错觉。
这一段一共 12 个镜头、平均 1.7 秒一个,全部是后期合成。它的作用是先把「争议」立起来,好让后面那句「我专门来了一趟」有落点。成本几乎为零,但比任何精修空镜都有效——这类「卡片流开场」,是可以直接抄的模板。
中间 100 秒:一台手机,两根机位
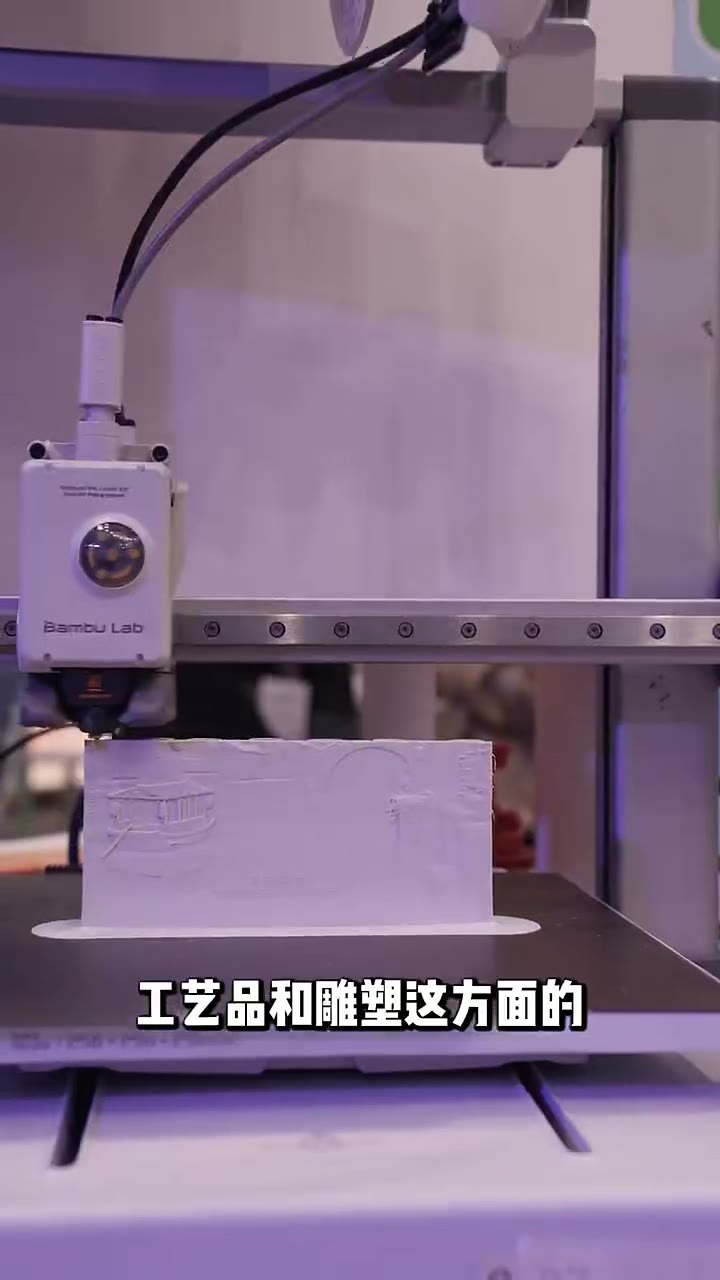
这是全片的主体。测量出来的参数很朴素:
| 维度 | 实测 |
|---|---|
| 机位 | 只有两类:① 主持人手持自拍杆自拍(边走边讲);② 双人对谈机位,手机架在受访者侧前方约 1 米 |
| 景别 | 中景 73%、近景 27%;移动机位 87%(摇、移为主) |
| 打光 | 基本没布光。主光是展馆顶部射灯,正面偏上、漫射,光比只有 1.2:1,人脸几乎没有阴影 |
| 色温/调色 | 偏冷(约 5000K),原色直出、轻微降饱和,没有明显 LUT |
| 景深 | 背景明显虚化,人像模式或长焦副摄 |
还有两个细节值得记下来。
第一,机器回来是能对齐的。62 个实拍镜头里,同一个人在展馆不同位置的外观是连续的——同一件黑 T 恤、同一条白裤、同一个白包带。这说明他不是「逛到哪拍到哪」,而是有意识地把「我」这个人当成片子的锚点,让观众始终认得是谁在带路。
第二,采访被压成了「一句话一个人」。10 来个受访者,每个人都只留一句最有信息量的话,平均 2.6 秒。声音是同期声直接用的(人声占全片 64% 的时长,基频 162Hz,人类录音特征明显),没有重新配音——现场的环境底噪、展馆回音全留着,这反而是「真实感」的来源。BGM 只在下面垫了一层(124.5 BPM、F 大调,曲库风格),混音时压得很低,不抢人声。
100–112 秒:全片唯一一段「生成」的画面
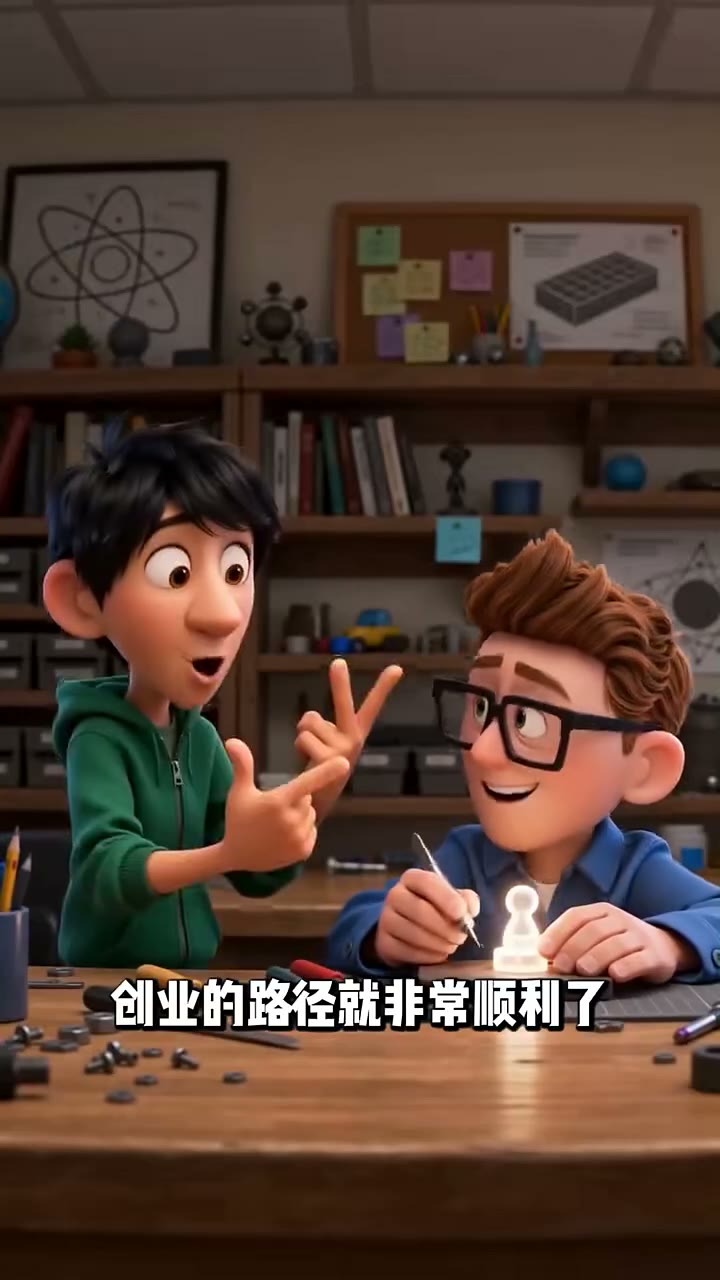
这段 12 秒是全片唯一「不是拍出来」的画面:暖光书房、木桌、两个皮克斯风格的卡通男孩,一个用镊子夹起白色小零件,一个在旁比划讲解;后半段场景直接切到深蓝虚空,两人中间升起一棵由发光粒子组成的网络光树。
判它是 AI 生成(而不是 3D 工程渲染)的理由有三条:手指关节细看有轻微软化、粒子光效均匀得不像模拟、同一段里两个场景的质感不统一。但这条判断我标了「待确认」——桌面级 3D 也能做出同样效果,没有 AIGC 元数据标识就只能是倾向。
它承担的叙事功能很清楚:把「一个人做产品、一个人做内容」这种抽象关系,变成一句能看懂的比喻。口播讲抽象概念时观众会走神,插 10 秒动画就能把人拉回来——这是口播视频里性价比最高的「注意力补丁」。
后半段:用录屏和 UI 动效「举证」
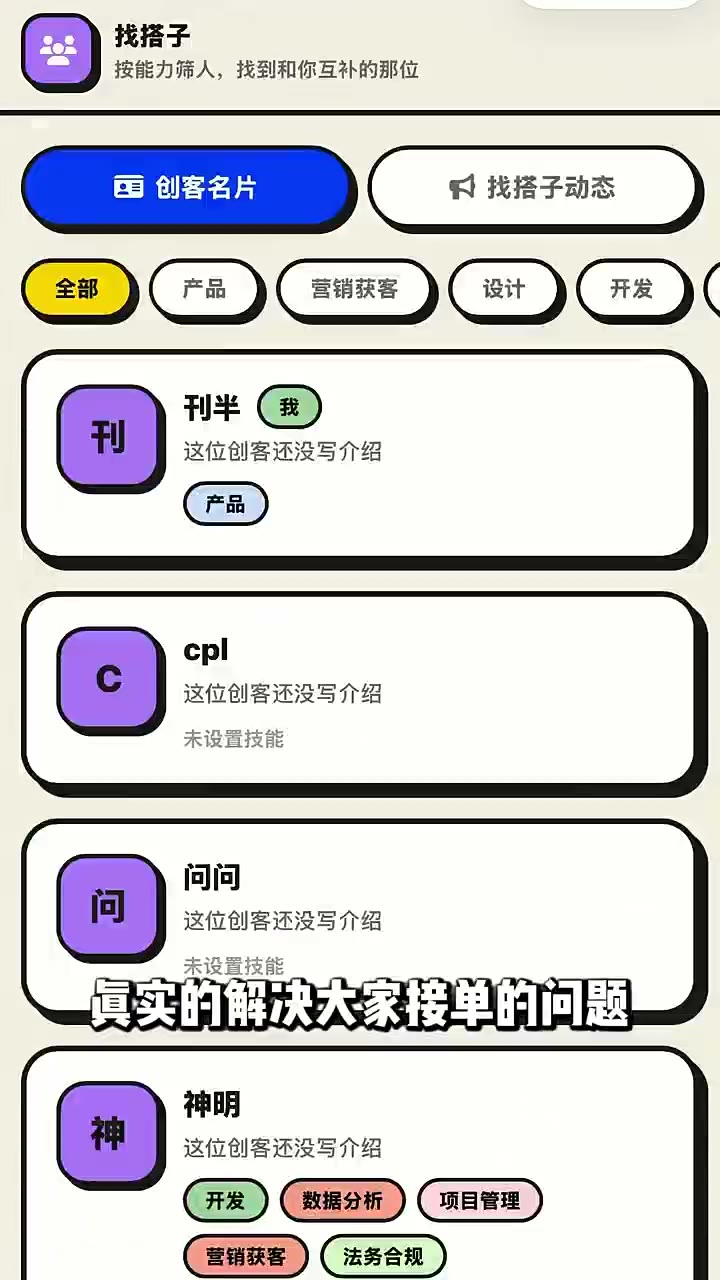
从 112 秒开始,画面在「实拍」和「屏幕」之间来回切:一张地图动画定位到上海(188.8–191.3s)、千问Go 的对话界面录屏(139.4–143.6s、163.4–171.5s)、最后是白底匹配卡片逐张弹出的 UI 动效(209.6–216.9s)。
这类镜头的价值不在好看,在可信:口播说「我搭了个平台」,观众未必信;把手机屏幕怼到镜头前,让卡片一张张弹出来,观众就信了。整片「插入画面」(截图/录屏/卡片)占了 28% 的时长——接近三分之一的时间在给口播提供证据。
值得注意的还有节奏:每分钟 24.4 刀,实拍镜头平均 2.6 秒,91 次硬切只配了 1 次叠化。切点有 33% 落在说话停顿处——是典型的「剪气口」剪法,不追音乐节拍(只有 10% 的切点踩在拍子上,跟随机差不多)。这也是访谈类视频的标准做法:让节奏跟着说话走,而不是跟着 BGM 走。
要复刻,得准备什么
工具给了一份很具体的复刻方案,我把它压成三条:
① 一天能拍完的三个场次。展馆(或任何行业活动现场)拍游走 + 街采;办公室拍团队协作收尾;3D 段落单独处理。器材清单短到不像话:手机 + 1.2–1.5 米自拍杆或稳定器 + 一个领夹麦。不用补光,靠现场顶光和展台灯箱,光比控制在 1.2:1 左右,色温 5000K 上下,开人像模式做背景虚化。
② 5 段 AI 生成。3D 卡通那部分可以拆成 5 个生成单元,一次出多镜头,用 Seedance 2.5 级别的模型 5 次调用就能覆盖;关键是给两个卡通角色各固定一张参考图,否则跨镜头会长得不像同一个人。走 Blender / Three.js 手搓也行,一致性更好,成本更高。
③ 4 段代码合成。开场卡片流、地图动画、UI 卡片动效,本质是「版式 + 元素入场时间轴」,用剪映的模板或者 Remotion 都能重建。工具已经把每段里每个元素的出现时间、方向、快慢、色值拆成了时间轴,照着写就行。
我不确定的三件事
- 那段 3D 卡通到底是生成的还是渲染的。倾向 AI(约 70%),但没有 AIGC 元数据,双方证据都不硬。
- 字幕的完整时间轴没导出。字幕是烧进画面的硬字幕,需要 OCR 才能转成文本;我这台机器的 Python 版本装不上 OCR 依赖(下面会讲),所以只确认了样式——白字、黑描边、底部居中,一句一行,跟着说话走。
- 音效清单只有四成可信。35 处音效点是信号层检出的候选,其中「卡在字幕弹出/贴纸出现」的 7 处比较确定,其余可能是环境声被误判。
整份拆解的置信度是 0.798。这个数字不是客套——它意味着大约两成结论还站不稳,需要人再看一遍。
尾巴:这套拆解是怎么做出来的
上面所有数据,来自一个叫 rea-video 的开源 skill(GitHub 上的 JuneYaooo/rea-video,2.5k stars,Apache-2.0)。它的定位一句话说清:
逆向一切视频:实拍口播、桌拍、AI 视频、3D、代码动效、混剪,逐镜拆出画面、花字、剪辑和声音是怎么做的,并给出复刻方案。
它拆十类画面来源——实拍、AI 视频、数字人、3D 渲染、2D 动画、定格动画、代码模板渲染、录屏截图、静态图推拉、静帧;再叠上字幕逐句时间轴、花字、贴纸/画中画、切点位置、BGM 的 BPM 和调性、音效卡在哪个画面事件上。最后输出一份 report.html,逐镜带关键帧截图、证据和复刻路线。
装它只要两行:
pip install "rea-video[ocr] @ git+https://github.com/JuneYaooo/rea-video"
rea-video --help
前置只有两个:ffmpeg,和 Python 3.10 以上。用起来是四步:
| 命令 | 干什么 |
|---|---|
rea-video decompose 片子.mp4 -o out/ref --lang zh | 切镜、分离人声/配乐、逐镜取证,产出 breakdown.json 和 report.html |
rea-video summary out/ref/breakdown.json | 打一份紧凑摘要,低置信镜头会被标出来 |
rea-video review out/ref | 生成逐镜看图任务——让能看图的 agent 亲自核对 |
rea-video apply-review out/ref --by 你的名字 | 把人工判断并进结论,重写报告 |
我这次的实际体验,好坏都说:
- 226 秒的片子,切镜 + 取证 + 出声报告,跑了 6 分半(CPU,无显卡)。这个速度可以接受。
- 不配多模态模型也能跑,但第一遍结论一定要人复核。它初判「实拍 53%、AI 18%、3D 15%」,把展会里虚化背景的镜头大批量误判成 AI;我逐镜看完再并进去,实拍回到 72%,置信度从 0.475 升到 0.798。
- 它在判断「这条片子有几台机器、怎么打的光、什么色温、光比多少」这类事上很硬——这些是从像素里量出来的,不是猜的。
- 一个真踩到的坑:它的字幕 OCR 依赖(rapidocr)只支持 Python 3.12 以下,我这台机器是 3.13,装不上,所以字幕时间轴没导出来。装个 3.11 的虚拟环境就能解决,我懒得折腾了。
- 另外 pypi 官方源在我这儿会卡死,换清华镜像才装完——国内环境大概率都要这一步。
它最适合的场景,是「我想学这条片子怎么做的」而不是「我想直接生成一条差不多的」。前者的答案是拆解 + 复刻方案,后者的答案是换个工具。这个区别挺重要:它不替你生产画面,只负责告诉你画面是怎么来的。
想看原片?
这条视频我不放链接。原因很实在:视频号的分享链接(weixin.qq.com/sph/…)在电脑浏览器里打开,只会跳到一个带二维码的预览页——页面里没有播放器,也不能把微信客户端直接叫起来。手机浏览器偶尔能唤起微信,但得满足「已登录 + 版本匹配」,做成博客里的按钮基本是坏的。
所以:在微信里搜视频号「徐老师AI+」,11 月 5 日那条就是。搜得到的,比点了打不开的链接有用。
拆解工具:rea-video(JuneYaooo/rea-video)· 拆解对象:视频号「徐老师AI+」2026-11-05 作品 · 逐镜复核 93/93 · 全片置信度 0.798
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: