
《AIGC与新媒体数据分析》:AI 站在旁注里,Excel 站在正文里
微信读书《AIGC与新媒体数据分析(慕课版)》(吴小坤 主编,刘春媛、韩明睿、赵旭 副主编)· 979 屏
逐页翻阅 979 屏 · 从 p0001 读到第 10 章课后习题(p0775),再往后抓取回环、跳回第 2 章(p0800 是图2-8)· 2026-11-07
说明三点。第一,这本的抓取目录名是错的——目录叫「AIGC新媒体营销与运营(慕课版)」,p0006 顶部书名条写的却是「AIGC与新媒体数据分析(慕课版)」,p0011 落款「编者 2026年3月」,主编吴小坤。我核对的是书名条,不是目录名。第二,这本书没有抓到目录页,章节位置是我按页码抽样定位的:p0014 是第 1 章引导案例,p0150 在 2.3.2,p0170 已进第 3 章(图3-4),p0350 在第 4 章,p0450 在第 5 章,p0530 是第 6 章末的课堂练习,p0550 到第 7 章,p0640 在第 8 章,p0700 在第 9 章,p0750 是 10.1.3,p0775 是第 10 章课后习题。第三,979 屏不等于读了 979 屏新内容:从第 10 章习题之后,抓取又回到第 2 章重读了一遍,所以有效部分大约到 p0780;第 10 章习题之后有没有附录、参考文献,我没读到,本文不对那部分作任何评价。
先说结论:这是一本写得挺认真的教材,认真到把每章学时都排好了;但它是一本关于 Excel 的教材,AIGC 只是加在书名上的前缀。
我把这个判断的凭据一条条摆出来,包括它做得比我预期好的地方。因为一本教材最怕的不是被骂,是被当成通稿夸。
顺带把一个操作层面的发现放前面:这本书在抓取队列里的目录名是「AIGC新媒体营销与运营(慕课版)」,与实际书名不符。这已经是这个项目里第十来个错标目录了。判据很简单——p0006 顶部那条书名栏,比任何目录名都可靠。
一、账:979 屏,十章,三十二学时
先看它自己给的账。p0009 到 p0010 有一张「表1 各章的学时安排」,我把它整张抄下来了:
1 新媒体数据分析基础 2 学时
2 新媒体数据的获取 4 学时
3 新媒体数据的处理与分析 4 学时
4 新媒体数据的可视化 4 学时
5 新媒体数据分析报告 4 学时
6 抖音账号数据分析 2 学时
7 微信公众号数据分析 2 学时
8 微博数据分析 2 学时
9 其他新媒体数据分析 4 学时
10 新媒体数据分析进阶专题 4 学时
学时总计 32
这张表是我在这本书里看到的最诚实的一页。绝大多数教材谈结构只谈「十章四大模块」,不谈学时;它把每章该占多少课时写死了,等于把「详略」提前公示。
三十二学时是什么概念?一学期十六周、每周两节课,正好用完。也就是说,这本书是按「一学期上完」设计的,不是按「读完一本」设计的。
而它有一千屏左右。我按页码抽样估了一下各段的厚度:第 1 到第 5 章(基础五章)从 p0014 一路铺到 p0490 附近,占了全书三分之二;第 6 到第 10 章(三个平台章、一个其他类目章、一个进阶专题)挤在剩下的三分之一里。其中第 6、7、8 三章各只有 2 学时,对应的正文量我抽样看是几十屏的量级——p0490 是抖音的成品截图,p0530 已经是第 6 章末尾的「课堂练习」,p0550 就到第 7 章的图7-1 了。
一张表把结构写得很清楚,正文的篇幅分配却和执行表打架。第 6 章从开章到课堂练习,我抽样只跨了四十来屏;而第 4 章讲「设置数据系列边框」「填充颜色」这类操作,从 p0310 附近一路到 p0400 之后。一本书的价值观不看它说什么,看它把页码给谁。
另一处账也对得上:p0011 的教学资源表里,「PPT课件」是 10 份,「课后习题答案」是 10 份。十章,十个课件包,十份答案。这张表与表1互相印证,说明十章确实是定稿结构,不是中途改的。
二、前言立了四条规矩,我逐条去核
p0008 是「本书特色」,四条,我原样抄下来:
(1)理论服务于实践。本书围绕新媒体数据分析的实际工作流程展开……
(2)AI贯穿全程。本书没有把AI的相关知识局限在某一章,而是让AI贯穿包含数据获取、数据处理与分析、数据可视化等的新媒体数据分析全流程……
(3)分平台讲解。抖音、微信公众号、微博等平台的后台数据结构、指标口径、运营逻辑各有不同,本书分别使用独立章节……
(4)案例真实、练习闭环。本书每章设置「引导案例」「课堂练习」「章节实训」「思考与练习」等模块……
四条里,第(3)条和第(4)条我核得住:平台确实分了独立章节(第 6、7、8 章),练习模块也确实在(p0530 是第 6 章的「课堂练习」:「在飞瓜数据抖音版中选择一个热销商品,查看其直播数据,并进行分析」;p0775 是第 10 章的「三 判断题」「四 简答题」)。
第(1)条要看怎么定义「实践」。如果「实践」指的是「照着点鼠标」,这本书做到了;如果指的是「遇到一份真数据,知道先做什么、后做什么」,它做到了一半——流程是有的,判断是缺的。
第(2)条是四条里最需要核的,也正是这本书最站不住的一条。下一节专门说。
三、AI 站在旁注里,Excel 站在正文里
「AI贯穿全程」这句话,如果成立,应该有一个可检验的样子:每章的核心工序里,AI 是必经的一步,而不是可选的补充。
我抽样看了几章的核心工序,看到的不是这样。
第 3 章「新媒体数据的处理与分析」,p0170 那一屏的正文是:
03 在弹出的【删除】对话框中选中【整行】单选按钮,单击【确定】按钮,如图3-4所示,即可将选中的所有空值单元格所在行删除。删除后的效果如图3-5所示。
这是一段标准的 Excel 操作说明:定位空值、删整行。整屏没有 AI。
再往后,p0210 那一屏讲的是用 VLOOKUP 给粉丝做年龄段分组,屏幕上那行公式清清楚楚:
=VLOOKUP(C2,G:H,2)
03 选中单元格D2,将鼠标指针移动到单元格的右下角,当鼠标指针变成黑色十字形状时双击,即可完成所有粉丝的年龄分组,如图3-37所示。
第 4 章「新媒体数据的可视化」,p0350 那一屏是「设置数据系列格式」面板,讲把数据系列边框设为「无线条」,配三张 Excel 对话框截图。
第 5 章「新媒体数据分析报告」我本来期待最高——写报告是 AI 最能帮上忙的环节。p0450 那一屏给的是对话框截图(图5-19),输入区下面写着「通过 shift+回车换行;支持复制粘贴/拖曳上传图片或文件」,上面一行小字是「当前支持上传1张图片 最大10MB」;紧接着图5-20 是一个「打开」文件对话框,正在选一张叫「6-18抖音直播投放数据分析.jpg」的图。
这个细节值得停一下。一份新媒体分析报告,通常要处理的是几十上百条笔记、几十场直播的记录、一整个月的后台导出的表格。而这本书教的做法,是把一张截图丢进对话框。限一张、限 10MB,这两个数字是界面给的,书里没提,但它决定了这套做法只能处理「一屏之内的证据」。
第 2 章本来是最有希望的一章——数据获取,正是 AI 最该出场的地方。p0150 是 2.3.2「AI辅助采集新媒体平台数据」,原文起手一句:「本实战以扣子平台为例,借助其AI自动创建功能,用户只需输入需……」
「以扣子平台为例」这五个字,是这本教材的一个缩影。它选的路径是:不写爬虫、不讲接口、不碰 cookie 与反爬,直接用一个可视化的智能体平台把采集包起来。这条路对课堂极其友好——学生不用配环境、不用处理登录态、不会因为一个 403 卡两节课。
代价也在这里:采集这件事的核心难点全被平台吃掉了,读者学到的是「在这个平台上填三个框」。平台一改版,这一节就作废;换一个站点,这套流程不一定迁得过去。而真正能迁移的那部分知识——页面结构长什么样、翻页怎么触发、字段怎么对齐、限速怎么设——一个字没讲。
所以「AI贯穿全程」落到实处,是这样的形状:AI 出现在「你可以让 AI 帮你……」这样的句子里,Excel 出现在「选中单元格 D2」这样的句子里。前者是建议,后者是工序。读者照着做,手上留下的还是 Excel 技能。
我不认为这是欺骗。教材作者面对的是课堂:四十五分钟要讲完一节,Excel 操作能演示、能验收、能出作业,AI 生成的答案不能。选 Excel 是理性的。但书名把 AIGC 放在最前面,就得承担一个后果——读者是冲着 AIGC 来的,学完发现自己会的是数据透视表和 VLOOKUP。
一句话:AI 是这本书的前言和旁注,Excel 是它的正文。
四、开篇第一个案例,数字一个都没出处
p0014 是第 1 章的「引导案例」,全书第一个案例。原文我抄在这里:
2024年,我国电影市场总票房超400亿元,而微短剧市场的规模持续扩大,首次超越电影市场总票房。通过对用户数据的深入分析发现,微短剧的核心受众特征为:女性、中青年、本科学历,居住在新一线和二线城市,多为公司一般职员,也包括自由职业者及大学生。相关数据显示,都市情感题材微短剧最受欢迎,用户偏好占比约为35%。
这段话里有五个可检验的事实:票房 400 亿、微短剧规模超过电影票房、受众是女性中青年本科、居住在新一线和二三线、都市情感题材偏好约 35%。
五个,零个来源。
没有一句「据某机构某年报告」,没有口径(微短剧市场规模按充值流水算还是按上线量算),没有时间窗(2024 全年还是上半年),也没有样本说明(35% 是问卷还是播放量占比)。
一本教人做数据分析的书,第一页就给了五个没有来源的数字,这件事的严重性不在于数字对不对,而在于它示范了什么。学生学到的第一课是:结论可以直接写,来源可以省。
更麻烦的是「首次超越电影市场总票房」这句。这类「首次」是新闻里最容易被误传的一类表述——统计口径一变(比如把微短剧的充值流水与电影的票房并列),结论就可能翻。书里一个字没提口径差异。
我给这一节留一个可执行的改法,因为批评不给出路等于没批评:这段如果要保留,只需在句末加半句——「(数据来源:某机构《2024 微短剧市场报告》,口径为平台充值流水;电影票房为国家电影局全年票房)」。加这半句,案例立刻从「据说」变成「可核」。成本是一行字。
后面第 8 章的微博粉丝分析倒是给了我一点补偿。p0640 那屏讲粉丝地区分布,原文的逻辑链是完整的:
图8-14所示为某微博账号的粉丝地区分布情况,山东的粉丝数量占比最高,因此,运营人员在创作微博内容时,可以增加一些与山东相关的元素,这样更容易引起粉丝共鸣。此外,运营人员在选择线下活动的举办地点时,可以优先考虑山东,便于大部分粉丝参与活动。
这段从「数据看到什么」推到「内容怎么做」「活动在哪办」,是全书里少见的完整推理。它只缺最后一步:山东占比到底多少?百分之三十和百分之八,对应的策略完全不同——前者值得为一个省改选题,后者只是顺手。
五、它做对的地方:一张表,三条判断题
批评写到这里,得说它好在哪,否则不公平。
第一处好,是前面那张学时表。明码标价的教材不多,愿意把「这一章只值两节课」写出来的更少。
第二处好,是 p0775 那一屏的三条判断题。我原样抄:
1.AI辅助预测建模得出的结果可以直接作为最终决策依据,无须新媒体运营人员结合实际业务经验进行合理性判断。( )
2.AI工具给出的营销策略建议具有普遍适用性,新媒体运营人员可以直接套用而无须调整。( )
3.在使用AI工具分析用户评论数据时,应尽可能对用户数据进行匿名化处理,以保护用户隐私。( )
三条题的答案依次是错、错、对。前两条打的是同一个靶子:把 AI 的输出当成结论。第三条打的是另一件事:数据合规。
这三条题的分量,比前面几十屏「AI 很强大」的段落加起来都重。原因很简单——它给了判据。一个学生做完这三道题,会记住「AI 给的结论要过人工」这条底线;而这句话如果写成正文里的一段议论,他大概率划过去。
这也是我对这本书整体评价的一个分水岭:凡是它写成「判断题」「课堂练习」的地方,质量都稳;凡是它写成「功能介绍」的地方,就开始注水。
第三处好,是 p0550 对公众号后台数据菜单的拆解。它把菜单里六项(内容分析、用户分析、菜单分析、消息分析、接口分析、网页分析)列全,然后给了一句判断:「运营人员通常只需要进行内容分析、用户分析、菜单分析、消息分析」。六项里划掉两项,这是有经验的写法——先给全景,再给取舍。
可惜这种「先全景再取舍」的写法,全书我抽到的十九屏里只见到两三次。
六、图号:正文喊 4-41,图注印 4-39
这是一个小到容易被忽略、但很能说明编辑工序的问题。
p0350 那一屏的正文写:「单击【确定】按钮,如图4-41所示。」然后下一段:「数据系列边框的设置与填充颜色的设置基本一致,此处,将数据系列边框设置为无线条,即在【边框】组中选中【无线条】单选按钮,如图4-42所示。设置过数据系列的柱形图的效果如图4-43所示。」
而这一屏下方印着的那张图,图注是「图4-39」。
正文连提三个图号(4-41、4-42、4-43),屏幕上只有一张图,图注是 4-39。三种可能:图没排进来、图号被改过、或者这一屏是跨页截断(图在上页、图注在下页)。我没法确定是哪一种,但能确定一件事:这本书的图号与正文没有做过一遍终校。
为什么这件事比错别字严重?因为这类教材的检索方式就是靠图号。「详见第 4 章图4-41」是一句有效索引,「详见第 4 章」则不是。图号一乱,索引就废了;索引一废,一本九百多屏的书就只剩通读一条路——而三十二学时的课,没有通读的时间。
同一个问题在彩图上还有另一个版本。p0530 和图9-5(p0700)这两处,图注都带着「(彩图)」两个字:图6-65(彩图)、图9-5(彩图)。这说明正文里印的是黑白图,彩色版本另外放。对读者意味着什么?图9-5 是一张雷达图,靠颜色区分「同领域笔记数据」和「本笔记数据」两条线;黑白印刷后两条线只能靠线型或灰度区分,如果图里没做这个区分,读者就分不清哪条是哪条。彩图另附,本质上是把「看懂这张图」的成本转给了读者。
我没有纸质书,无法确认纸书上是否真的分不清。所以这一条只落在「标注了彩图、说明正文是黑白」这个事实上,不往前多推一步。
七、VLOOKUP 少一个参数,读者换张表就全错
这条是本篇里我最想让学生看到的一条,因为它示范了「操作正确、原理缺失」是怎么发生的。
p0210 的公式是 =VLOOKUP(C2,G:H,2)。三个参数:找谁(C2 的年龄)、在哪找(G 到 H 两列的阈值表)、返回第几列(第 2 列,组别名称)。
第四个参数(是否近似匹配)没写。VLOOKUP 省略第四个参数时,默认是近似匹配(TRUE),也就是「找不到完全相等的,就返回不大于查找值的最大值」。这正是分段统计想要的行为——年龄 23 落在 18 到 25 之间,返回「18岁到25岁」。
问题在于,近似匹配有两个隐含前提:阈值表必须升序排列,且分段边界不能有重叠。书里那张阈值表恰好是 0、18、26、36、46、61,升序,规整,所以一按双击填充就出结果,看起来一切正常。
但读者拿自己的表来试,只要阈值乱序(比如先写 60 以上再写 18 岁以下),VLOOKUP 不会报错,它会安静地返回一个错误的分组。而这本书通篇没提这个前提。
这不是挑刺。这是教材最该防的一类事故:示例跑通了,原理没讲,读者以为学会了,其实学会的是「照抄这一张表」。
补丁只有一句:「第四个参数省略时为近似匹配,要求第二参数首列升序;分段统计建议写 1 并确认升序,或用 XLOOKUP 的分段写法。」一句,一行,就能把「照抄」变成「会用」。
顺着这一条,我整理了一份可以贴在屏幕边的自检清单,六条,每条都能在一分钟内做完:
第一,公式里有没有省略的默认参数。VLOOKUP 的第四参、SUMIF 的求和区域、INDEX 的行列序,凡省略都在赌数据结构不变。第二,阈值表是不是升序、边界有没有重叠。18 到 25 与 26 到 35 之间空了 25 岁,这是分段统计最常见的漏。第三,返回的是文本还是数值。「18岁到25岁」是文本,不能排序也不能求均值,需要另留一列起点值。第四,分组后有没有回头验一条。随机抽三行,手算一遍,对不上就是公式错了。第五,原始列有没有留。分组列是派生列,删原始年龄列,以后想换分档就得重做。第六,这一步要不要写进报告的方法说明。凡做过分组、清洗、剔除,报告里就得有一句,否则读者无法复算。
这六条,这本书一条都没在正文里列过。它把操作写得很顺,顺到让人忘了每一步都在做选择。
八、它的短板
按规矩,这一节老老实实写。
短板一:全书没有一处「AI 给了错答案,怎么发现」的完整案例。前言(p0006)把这件事说得很明白:「AI工具给出的分析结果并非绝对可靠……同一个AI工具在不同时间面对同一个问题给出的答案都可能存在差异,以及AI工具生成的代码未必经过真正验证等。」话说得很到位。但说完之后,正文里我抽样看到的 AI 段落,全是「让 AI 做某事,得到了结果」。它承认了风险,却没有给一个演示风险的案例。承认风险是成本最低的动作,演示风险才要花篇幅。
短板二:平台指标口径只列名字,不给定义。「分平台讲解」这一条承诺里,最有价值的部分应该是「同一个指标在不同平台算法不同」——比如「播放量」在抖音和视频号的口径差异,「阅读量」在公众号与头条的差异。我抽到的平台章(p0490 抖音、p0550 公众号、p0640 微博)里,指标是以菜单项的形式出现的(内容分析、用户分析……),而不是以定义的形式出现的。菜单会改版,定义不会。教菜单,等于把书的保质期交给平台的产品经理。
短板三:三十二学时压十章,练习题只能做到「检查」,做不到「训练」。p0530 的课堂练习是「在飞瓜数据抖音版中选择一个热销商品,查看其直播数据,并进行分析」。这句话里,「选择」「查看」是动作,「进行分析」是结果,中间那步没给。学生交上来的会是一段描述,不是一份分析。真正可验收的题长这样:给出该商品近七天的直播场次与GMV,要求写出「哪一场的转化率异常、可能原因两条、下一条建议一条」。
短板四:练习与正文的比例,我没法给准数。这本书没有目录页被抓到,我无法统计「思考与练习」占多少屏。我只知道抽到的第 6 章末、第 10 章末各有练习模块,第 1 到第 5 章我抽的页里没撞见。所以这一条我标为「未核实」,不作为批评依据。
短板五:最该被反复用的那张表,只出现一次。表1(学时安排)是全书的骨架说明书,它出现在前言。但正文各章开头没有一处回引「本章对应 4 学时,重点在两节」。骨架只在前言出现一次,等于把地图贴在门口,进屋就撕了。
写完这五条,我补一句公平话:这五条都不是「作者不会」,而是「教材这个体裁 + 三十二学时的预算」共同挤出来的结果。一本书要覆盖十章、五个平台、四类数据、还要给十份课件和十份答案,剩下的页码只够写操作步骤。
所以这本书适合谁?适合要开一门课的老师和要交作业的学生——它结构规整、有学时表、有练习、有配套资源,拿来当课程骨架是够用的。
它不适合谁?不适合想学「怎么判断 AI 给的这份分析能不能用」的人。那套判断,它在前言里提了,在判断题里提了,然后就没有然后了。
工具书的合格线,是给操作步骤。数据分析教材的合格线,是给口径和判据。这本在第一条上过了线,在第二条上,停在了前言。
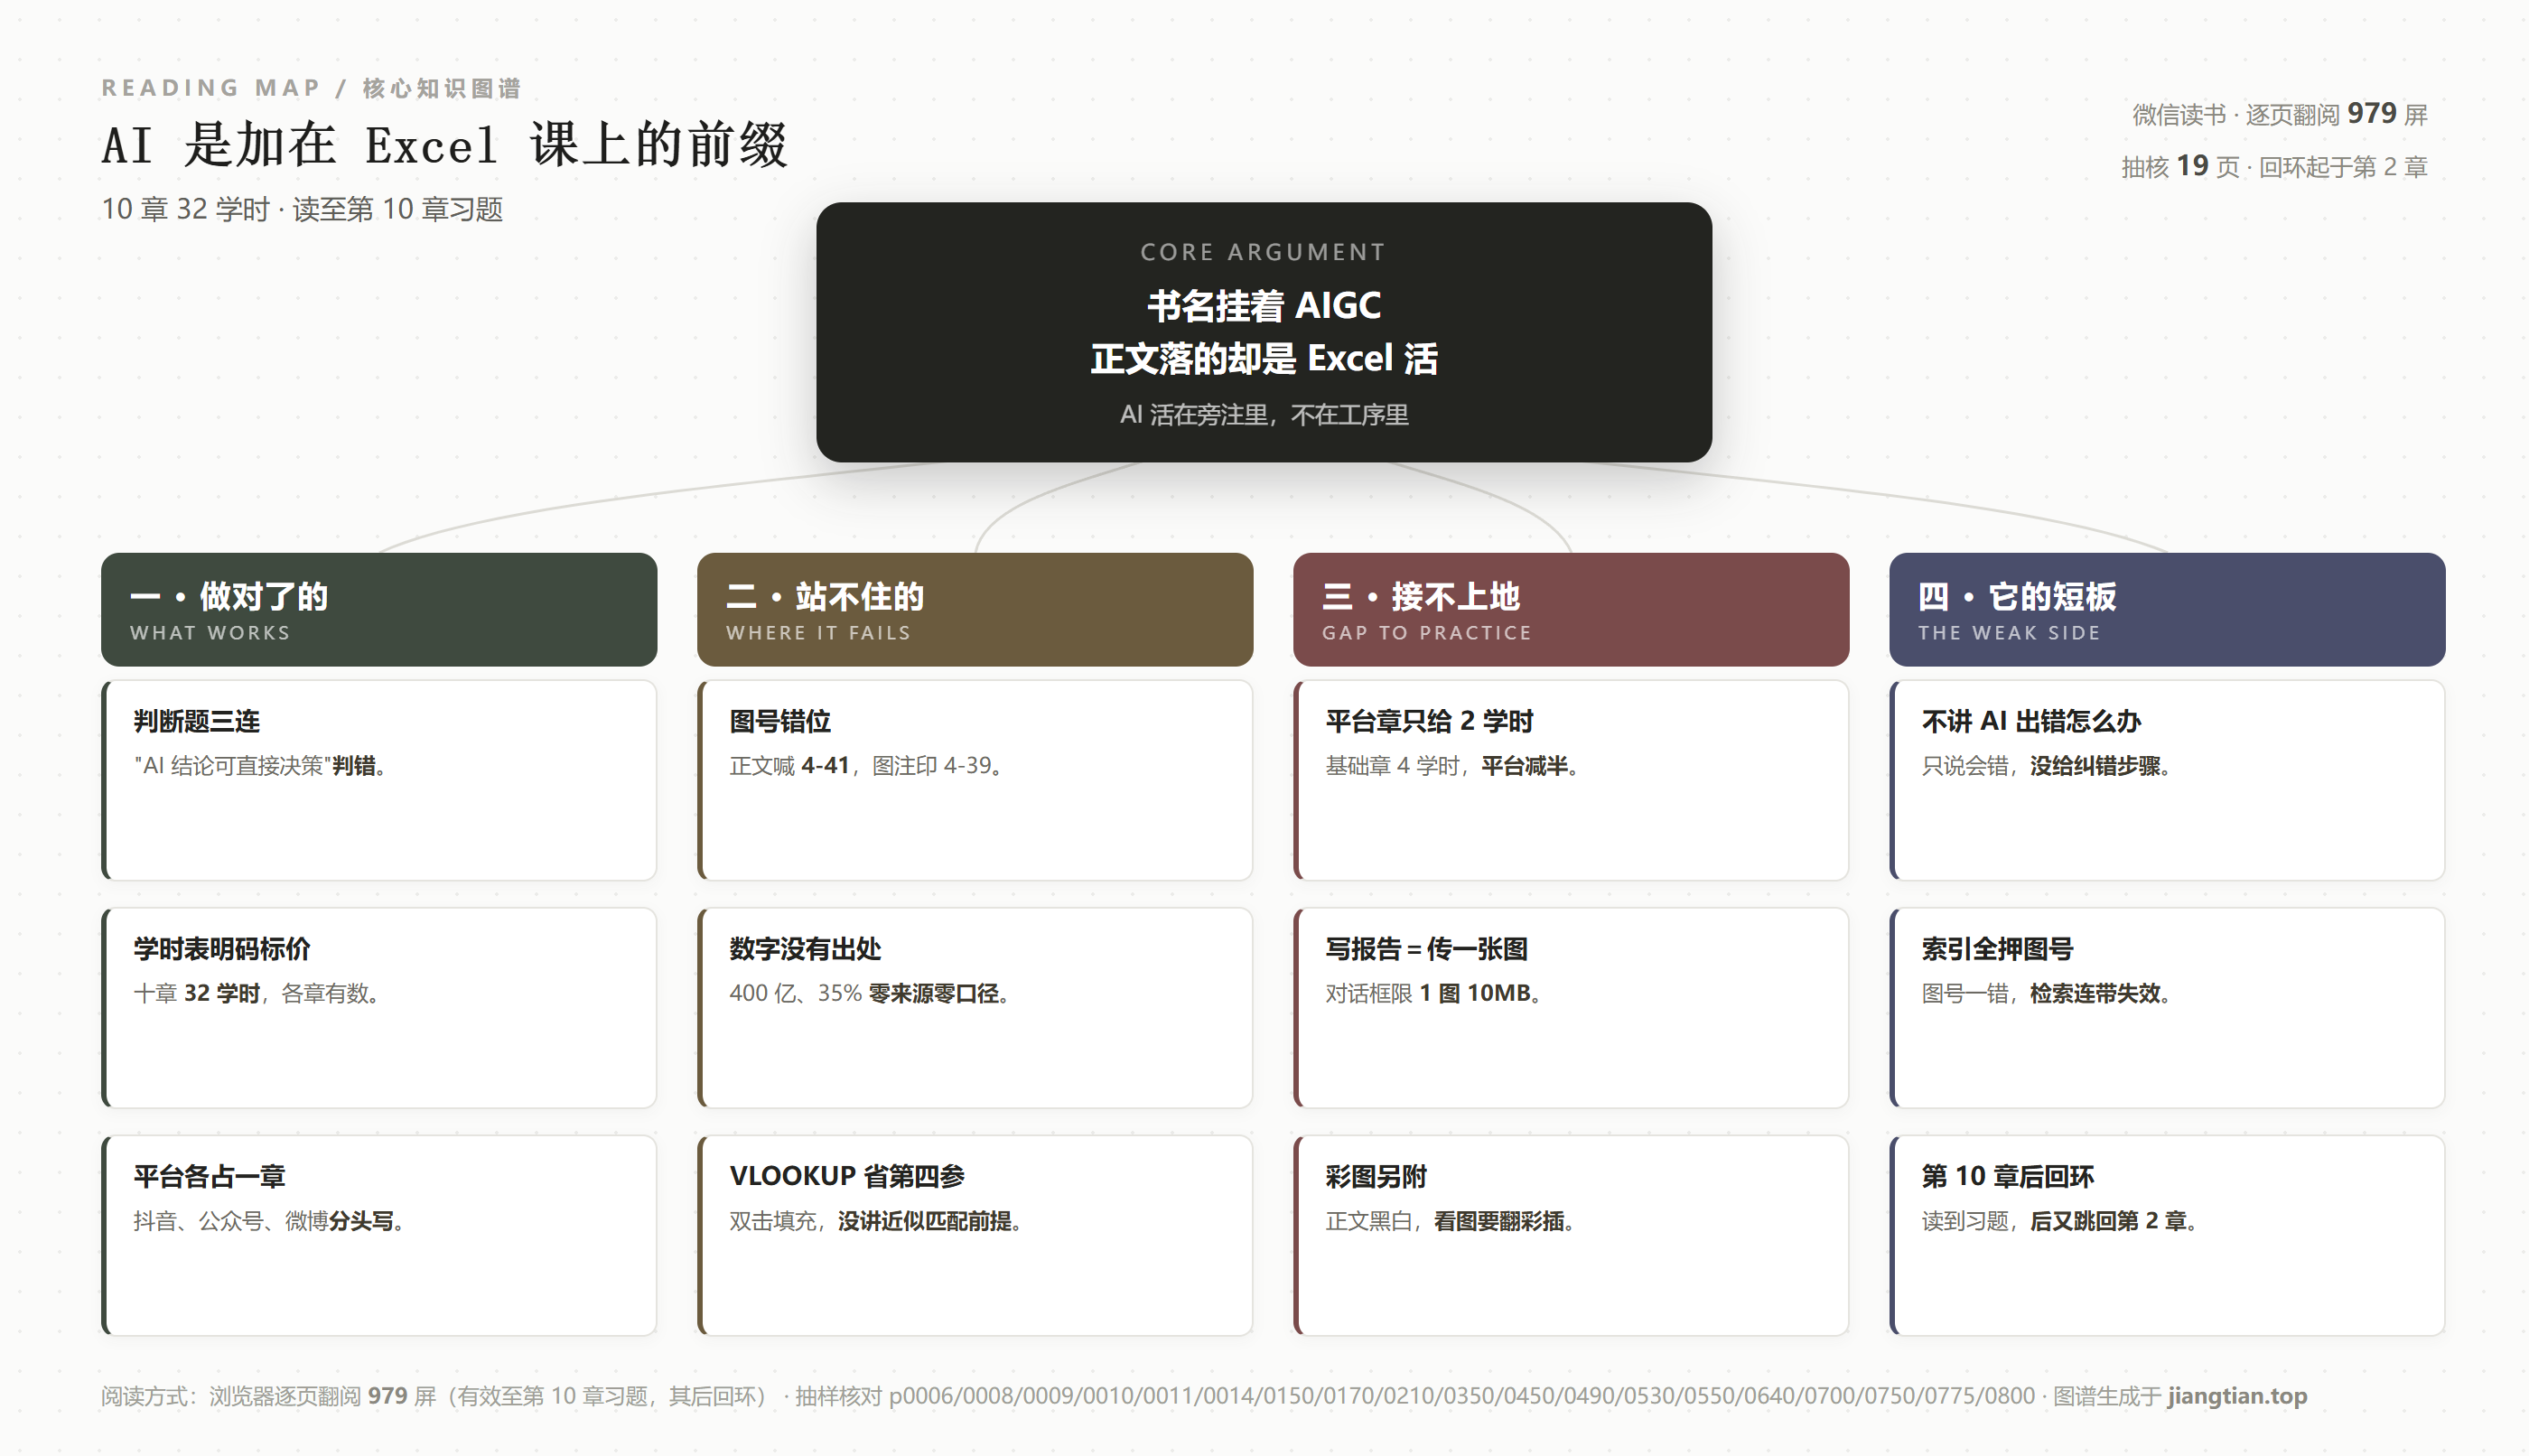
最后一句话:这本书把「AI + 数据分析」写成了一门 Excel 课的升级版,而升级的那部分,恰好写在读者最容易跳过的地方——前言的第一段,和每章最后的三道判断题。
抽样核对:p0006 前言 / p0008 本书特色四条 / p0009–p0010 表1 学时安排与表2 教学资源 / p0011 编者团队与落款 2026年3月 / p0014 第1章引导案例 / p0150 2.3.2 AI辅助采集 / p0170 图3-4 删空值行 / p0210 图3-36 VLOOKUP 分组 / p0350 第4章图表格式与图号 / p0450 图5-19 上传限 1 图 10MB / p0490 抖音截图 / p0530 图6-65 与课堂练习 / p0550 图7-1 公众号数据菜单 / p0640 图8-13 微博粉丝地区 / p0700 图9-5 笔记诊断(彩图)/ p0750 10.1.3 音频分析 / p0775 课后习题 / p0800 图2-8 回环证据
核对方式:每屏截图 + 顶部书名条比对(p0006 为「AIGC与新媒体数据分析(慕课版)」,与抓取目录名「AIGC新媒体营销与运营(慕课版)」不符,已按书名条为准)· 笔记与图谱生成于 2026-11-07
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: