
怎么让 AI 先读你十几篇旧文,学会你的语气再动笔?
怎么让 AI 先读你十几篇旧文,学会你的语气再动笔?
答案是先喂旧文、再总结语气、你确认对了、最后才叫它动笔,顺序一换,产出就换了个作者。我今天用 demo02 真跑了一遍:AI 读完我最近 10 篇旧文章,交回来一张语气卡,句长和口头禅全是从语料里数出来的。下面把这套做法拆开讲。
直接叫它「模仿我」,会得到什么
你大概试过在提示词里写一句「模仿我的语气」。AI 会满口答应,交回来的是「字里行间流露着真诚」这类通用腔,看着像你,读着不像。它压根没见过你的文章,只能按「公众号作者」的平均印象来猜。
猜出来的东西有个统一的名字,叫四不像。句子比你的长,口头禅一个没用上,连你惯用的收尾设问都没有。读者其实分得出来,老读者一眼就看出这篇不对味,留言都会问你是不是换人了。
病根还是信息不够。语气这种东西,你自己都说不清是哪几句撑起来的,AI 更猜不着。猜不着还硬写,就只能拿套路糊弄你。
通用腔还有一个害处,是它磨掉你文章里的记性。你的口头禅、你的收尾设问、你的短句节奏,这些是读者记住你的锚点;AI 用平均印象来写,锚点全被磨平。文章挑不出错处,也没有记性,读完就忘。
原理:语气可以量成三个数
换个思路,别让 AI 猜,让它数。语气听起来玄,拆开其实是三样可量化的东西:句子平均多长、哪些词反复出现、惯用什么句式。这三样都能从你的旧文章里统计出来,数字摆在那,不需要任何天赋。
我用 demo02 实测过一遍。脚本连接博客数据库,拉出最近 10 篇旧文章,一共 3080 字语料,数出平均句长 46 字,还数出 5 个高频口头禅:张雪、不是、自己、家传、什么。这些数字不是我拍脑袋定的,是一个一个从真实语料里数出来的。
数字数出来只是半成品,还要让 AI 拼成一张「语气卡」。有这张卡垫底,AI 再动笔就不是猜了,是照着你的数字写。先读再写、先总结再确认,顺序对了,产出的东西才像你。
为什么统计这条路走得通?因为语气的外壳就是可数的特征:句长能数,口头禅能数,句式也能数。你读一个作者读多了会说「有那味了」,那味拆开来就是这几样特征的组合:特征能数,AI 就能学;特征说不清,AI 才只能猜。
换句话说,让 AI 学语气,学的是特征不是灵魂。你不用跟它讲什么文风气质,那些它听不懂;你只给它句长、口头禅、句式三个硬指标,它就能拼出七八分像。剩下两三分,靠你核对语气卡的时候补。
数字还有个好处,是它让「像不像」变成可以讨论的事。以前你觉得 AI 写得不像你,只能凭感觉说不像;现在你指着语气卡说,句长超了,口头禅没用上,它改起来有据可依。凭感觉吵架,改成照数字办事,效率高一个量级。
要紧的一点记牢:语气卡是统计出来的,不是 AI 编出来的。口头禅那五个词——张雪、不是、自己、家传、什么——全是从 3080 字语料里数出来的高频词,一个都不是猜的。统计打底,语气卡才有公信力。
实操:三步喂出一张语气卡
第一步,挑文章。把你写得最好的十几篇旧文章挑出来,注意是「写得最好」,不是「最新」。语料的质量决定语气卡的质量,凑数凑进来的差文章会把统计带偏。
挑文章还有个参考标准:优先挑你写起来最顺、发出去读者反应最好的那批。语料在精不在多,十几篇写得最好的,胜过几十篇平庸的。篇数太少统计不稳,篇数太杂统计走样,十几篇正好卡在中间。
第二步,把文章喂给 AI,让它先别动笔,只做统计。我在 demo02 里就是这么跑的:脚本连接博客数据库,拉出最近 10 篇旧文章,合计 3080 字语料。然后让 AI 数三样东西:句长、口头禅、惯用句式。
第二步给 AI 的指令要写死三个动作:只统计,不写作;逐项报数,不写感想;数完等确认,不往下走。AI 敢提前动笔,语气卡就白做了,它必须停在统计这一步等你验收。我在 demo02 里就是按这三个动作分开跑的。
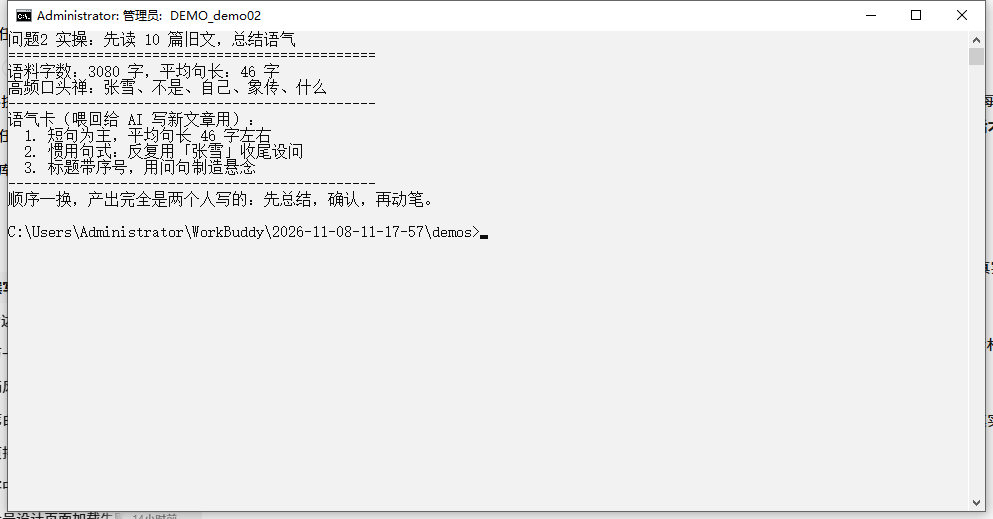
统计结果交回来长这样:语料 3080 字,平均句长 46 字,5 个高频口头禅——张雪、不是、自己、家传、什么。平均句长 46 字这个数字一出来我就服了,我平时确实爱写短句,自己没意识到,机器一数就现形。口头禅更准,「张雪」这种名字反复出现,连我自己都没数过。
第三步,让 AI 把统计拼成语气卡。demo02 交回来的语气卡一共三条:第一条,短句为主,平均句长 46 字左右;第二条,惯用句式是反复用「张雪」收尾设问;第三条,标题带序号,用问句制造悬念。三条对着 3080 字语料,一条都有出处。
语气卡到手还没完,最要紧的一步是你亲自核对。平均句长 46 字对不对味,5 个口头禅是不是你常挂嘴边的,惯用句式像不像你收尾的习惯,逐条过一遍。哪条不对就打回去重数,核对到全对为止。
核对的时候顺便做一件事:把这 5 个口头禅亲手用进新文章里。机器数出来的特征,你主动用起来,它才真正长在你手上,下次不用 AI 数,你自己落笔就有这个意识。养成这个习惯,语料会越写越像你自己。
核对完了才叫它写新文章。写的时候把语气卡一起贴进提示词,AI 就照着你的句长、你的口头禅、你的句式动笔。这一趟跑下来,产出立刻像两个人:没喂语料前是四不像,喂完是你本人。
核对语气卡的时候,建议你拿新文章试产一段。用语气卡写一小段出来,跟你的旧文章并排读,像不像自己立刻有判断。试产通过,再放它写整篇;试产不像,回到统计那一步重数。
试产这一步别省,它是整条流程里你唯一能提前看到成品的机会。语气卡看着都对,拼出来却不对味的情况真实存在,试产一段就能当场暴露。暴露得早,改的就只是一张卡,不是一整篇文章。
语气卡做一次能用很久,风格没大变就不用重做。我的习惯是每写满十几篇新文章,重喂一次语料,刷新一次数字,让语气卡跟着你一起长。风格是会变的,卡片也要跟着换版本。
两个坑,别踩
坑一:随手抓十几篇喂进去,不挑质量。语料里混进凑数的差文章,统计出来的句长和口头禅就掺了假,AI 照着掺假的语气卡写,写出来自然不像你。挑的时候狠一点,只留你自己读着最顺的那十几篇。
坑二:不看语气卡,直接放行。AI 总结完你不核对,它统计错了你也发现不了,错的方向一路写到底。核对只花两分钟,5 个口头禅逐个看,比事后重写省力得多。
这两个坑一个是进料不挑,一个是出料不验,正好卡在这条流程的头尾。头尾守住,中间的统计活交给 AI,它数数字比人可靠。这套做完,你的语气就成了可以随身带的说明文件。
这两个坑背后是同一个道理:语气卡的价值全在真实两个字上。进料真实,统计才真;出料核对,使用才真。哪一头掺假,这张卡就只剩一个好看的壳子。
收尾
让 AI 学你的语气,靠的不是它有灵性,是你先喂语料、它再统计、你确认语气卡、最后才动笔。顺序对,它就抄得像;顺序错,它就猜得虚。10 篇旧文章、3080 字语料、一张三条的语气卡,就是我今天真跑出来的成本。
语气像了还有一处露馅的地方:满篇形容词没有动作。下一篇解它:《AI 写出来全是形容词没有动作,怎么让它自己改?》
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: