
AI绘画师:文案、图片与视频制作从入门到精通:操作会过期,方法只剩一页
微信读书《AI绘画师:文案、图片与视频制作从入门到精通》(AIGC 文画学院编著,前言自署 2023 年 6 月)· 抓取 580 屏 / 12 章
逐字核对 14 屏 · p0006 书名条核对为本书 · 抽样率 2.4% · 2026-11-09
两点说明。第一,这本书有明确的写作时间戳,先说清楚:前言末尾署「编者 2023 年 6 月」,p0130 的 ChatGPT 截图右下角印着「ChatGPT May 12 Version」,p0290 的 Midjourney 截图里挂着 --v 5.1。它是一本 2023 年中的书,不是新书,我按「一本三年前的操作手册在 2026 年还剩多少用」来评。第二,14 屏对 580 屏,抽样率 2.4%,凡是我说「全书没有」的地方,请按这个比例打折看——我能保证的是「我抽到的这 14 屏里没有」,不能保证作者一定没写在别处。
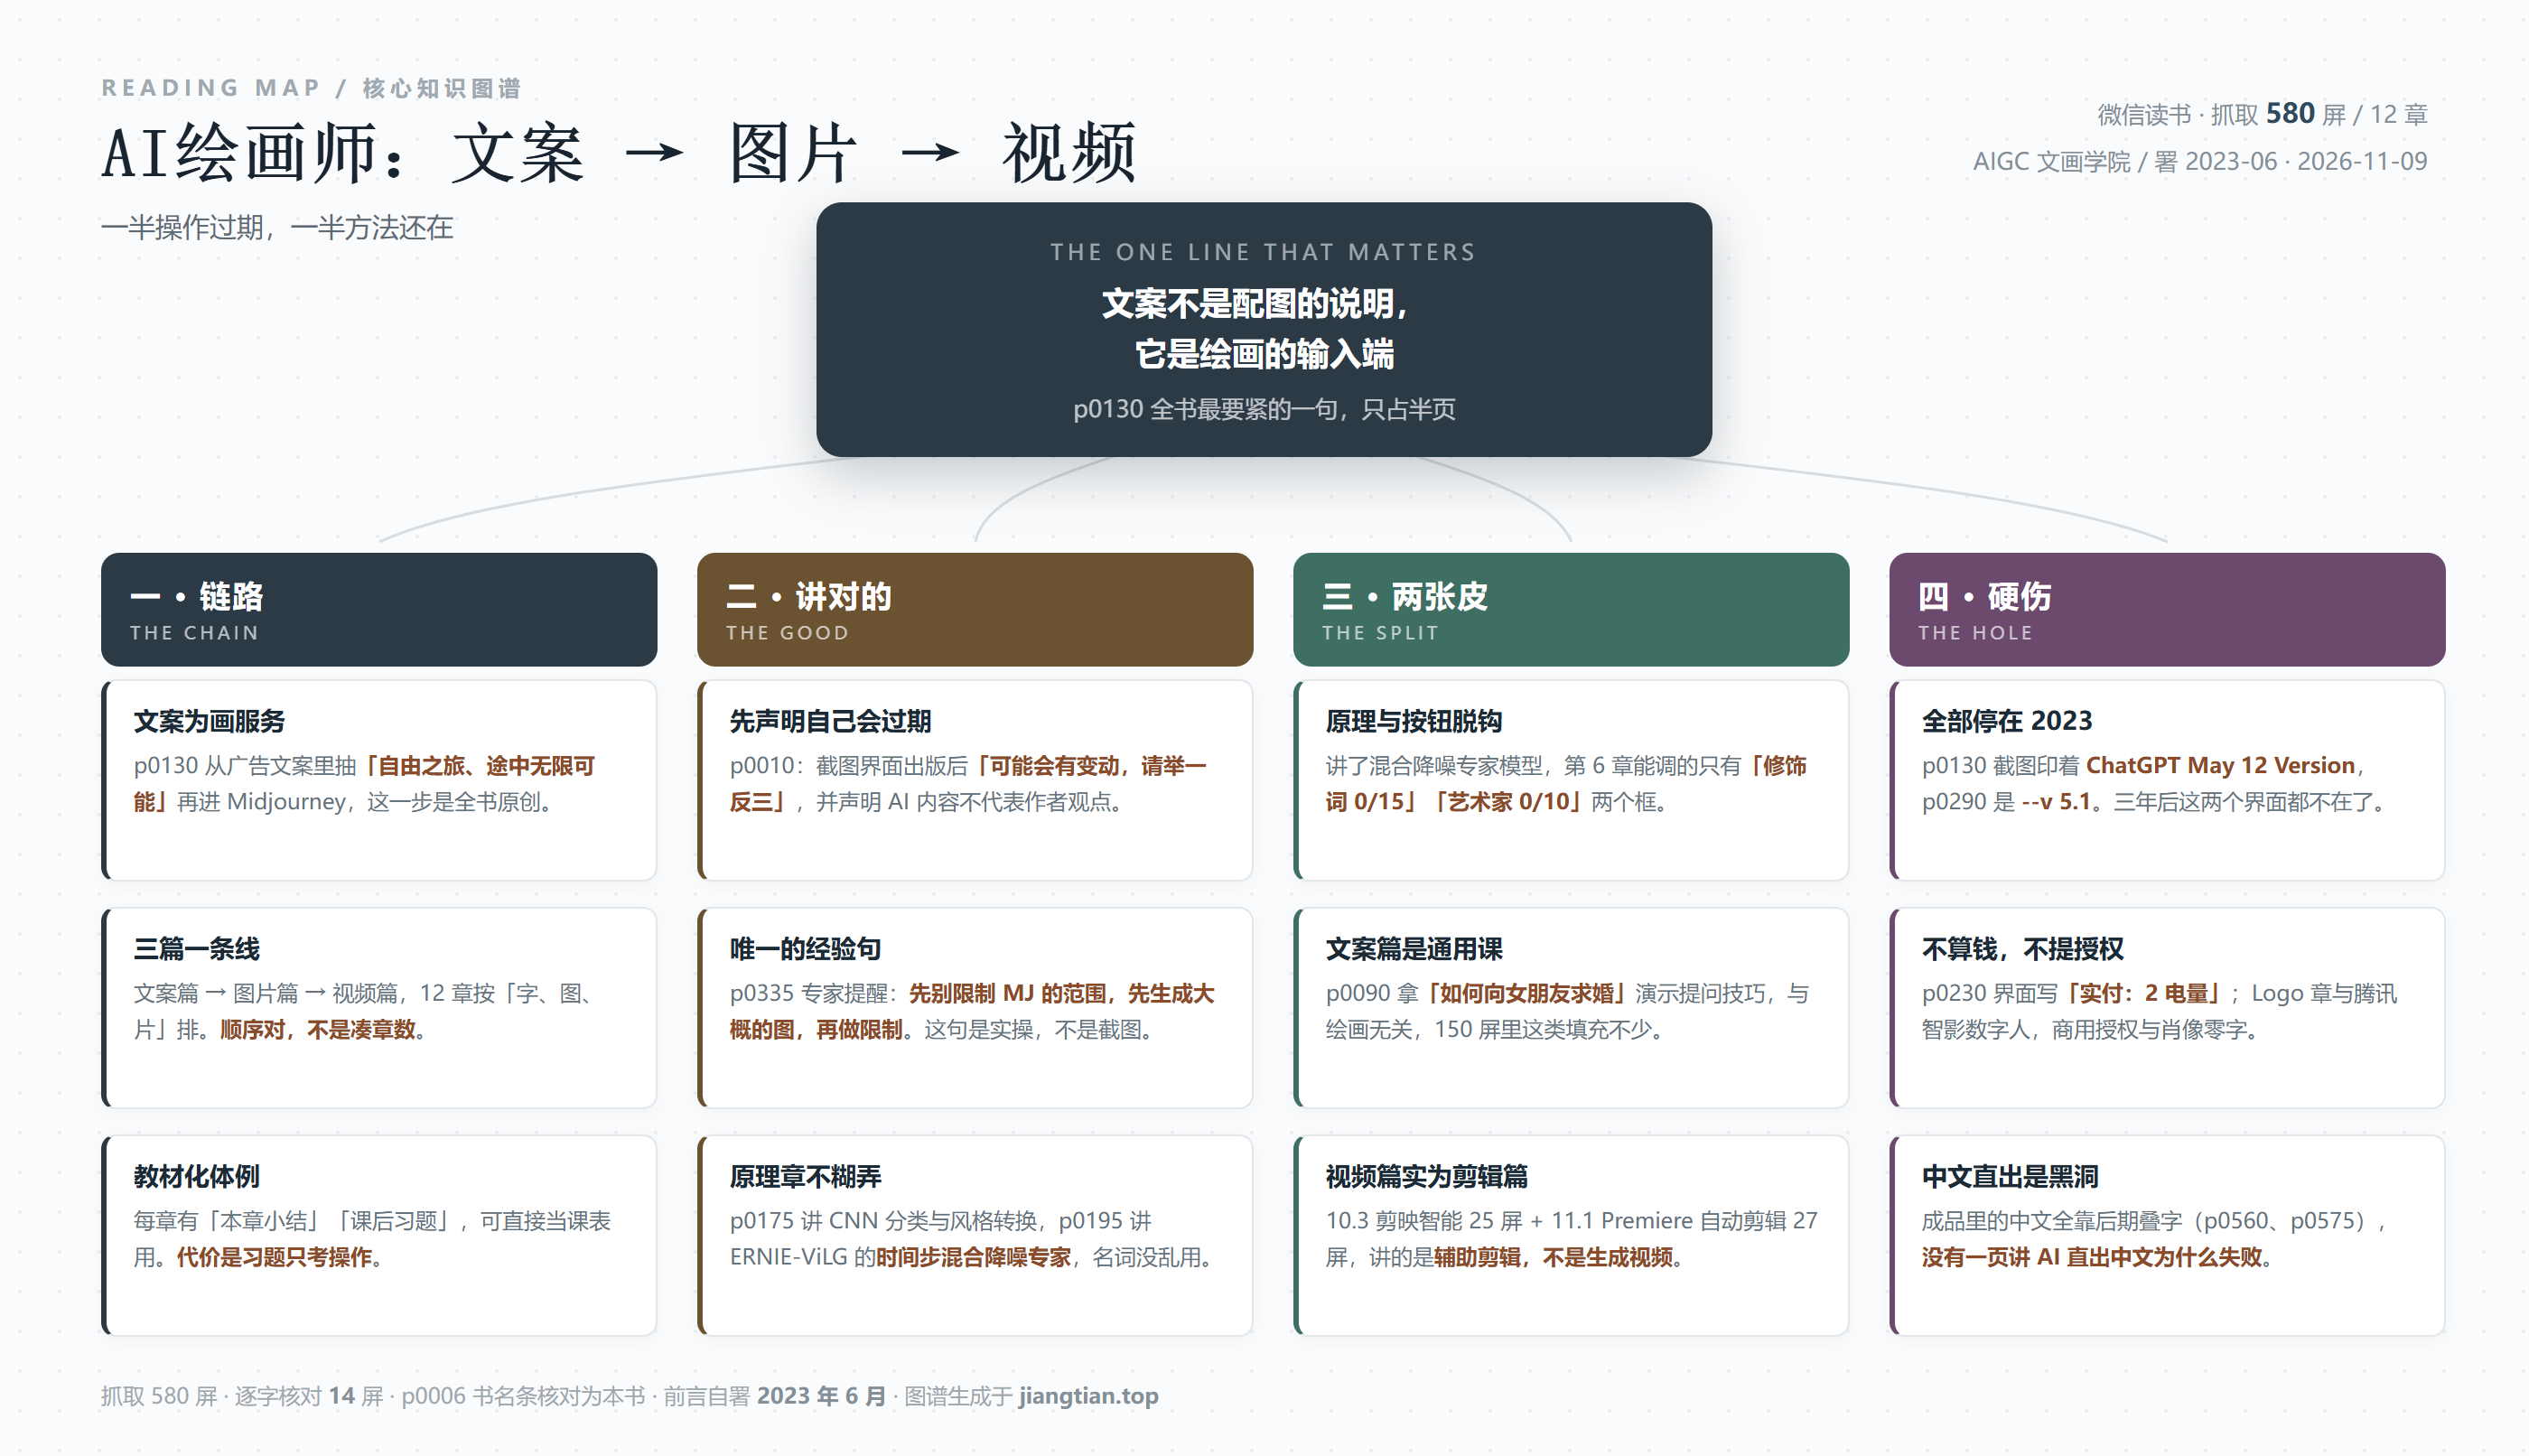
我先给结论:这本书的骨架比它的内容值钱。它想清楚了一件当年很少有人想清楚的事——文案、图片、视频不是三门手艺,是一条流水线;但它的血肉是软件说明书,而说明书的保质期只有一年。
这个结论分两半,都是认真的。前半句是夸奖:2023 年市面上讲 AI 绘画的书,绝大多数是「Midjourney 关键词大全」,把绘画当成一个孤立的出图动作。这本书不这么看,它把「写文案」放在最前面,把「生成视频」放在最后面,中间才是图。这个顺序是对的,而且它自己知道为什么要这么排,p0130 里有一句原话:「这本书的主题,文案是为绘画而服务的。」
后半句是批评,而且是那种三年后才看得清的批评:它的教学颗粒度落在「点击哪个按钮」上,按钮一改版,教程就归零。这不是作者不努力,是这类书的宿命——但作者其实预见到了,却没有为此改变写法,这才是我想说的重点。
一、它真正原创的地方:把「文案」接在了「画」的前面
先看它怎么把一个广告需求变成一张图。第 4 章「案例:广告、短视频与直播文案创作」里,汽车广告这一段是全书方法最完整的地方。p0130 的原话:
这本书的主题,文案是为绘画而服务的,接下来以本节制作的汽车广告文案为例,在文案中提取需要的关键词,如「自由之旅、途中无限可能、汽车广告、银白色外观」等,在 Midjourney 中生成相……
这句被排版截断了,但意思完整:它不是让你直接对着 MJ 憋关键词,而是让 ChatGPT 先把话说圆,再从成稿里抽词。这一步的价值,做过商业图的人都懂——甲方给你的从来不是关键词,是一段「我要高级但不冷淡、要自由感但别太野」的玄学描述。你能做的是先把它写成文案,再从文案里挑出可以画的部分。这个「先成句、再抽词」的动作,2023 年很多教程没讲,2026 年很多教程还是没讲,它们直接给你 200 个「赛博朋克 8K 高清」。
这条链子还往下接了两段。第 8 章用 Logo、插画、漫画三个案例,把「文案给方向、MJ 出图、人做取舍」走了一遍;第 12 章用自媒体、虚拟主播、口播三个案例,把图、配音、字幕、成片串起来。三篇一脉:字 → 图 → 片,12 章按这个顺序排,没有为了凑章数把「AI 音频」硬塞进来。这个结构我认为是对的,甚至比它自己的内容更对。
还有一处值得记下来。p0010 的「特别提示」写得很清醒,我从截图里逐字抄:
本书在编写时是基于当前各种 AI 工具和软件的界面截取的实际操作图片,但本书从编辑到出版需要一段时间,这些工具的功能和界面可能会有变动,请在阅读时根据书中的思路,举一反三,进行学习。此外,AI 工具和软件通过关键词生成内容仅作为教学演示,其内容不代表作者的观点。还需要注意的是,即使是相同的关键词,AI 每次生成的文案、图片或视频内容也会有所差别。
三句话,三件事:界面会变、内容只是演示、结果不可复现。这三句是给「操作类图书」划边界的标准动作,很多同题书一句都不写,装作自己的截图能管三年。它写了,说明作者知道自己的书有保质期。
但也正因为写了,后面那个问题才更刺眼:既然知道会过期,为什么整本书还是写成了「点这里、再点这里」?
二、它是一本 2023 年 6 月的产品说明书,而且没有留下「可迁移的那一半」
我把它当成一份 2023 年 6 月的快照来读,会发现里面到处是当时的界面遗迹。p0130 的 ChatGPT 输入框底下,灰色小字写着「Free Research Preview. ChatGPT may produce inaccurate information about people, places, or facts. ChatGPT May 12 Version」;p0290 的 Discord 截图里,机器人回复尾部挂着「--v 5.1-」,用户名后面还跟着「(fast)」——那是 MJ 的快速模式标记,现在的计费和模式早就换过几轮。p0230 是文心一格的下单界面,字段名写着「修饰词 0/15」「艺术家 0/10」,右下角一行「实付:2 电量」。
这些遗迹本身不是错。错在书没有把「遗迹」和「机制」分开写。举一个具体的例子:p0230 教的是「单击立即生成」,p0225 到 p0254 这 30 屏(6.2 文心一格的进阶玩法)教的是怎么填参考图、怎么选艺术家。但文心一格真正的门槛从来不是「点哪个按钮」,是「修饰词只能填 15 个字以内,而这 15 个字里到底该放风格还是放光线」。书里给了字段上限(0/15、0/10 这两个数字就印在截图上),却没有一节讲「15 个字怎么分配」。这是把「输入框有几格」当成了「怎么写」。三年过去,输入框可能从 15 字变成 50 字,也可能被参考图彻底替代,那这种教法留下的东西就是零。
反过来看 p0335,那是我在全书里找到的唯一一句「能穿越版本」的话,藏在第 8 章 Logo 案例的「专家提醒」小框里:
在开始设计 Logo 时,尽量不要限制 Midjourney 的范围,让 Midjourney 先生成一个大概的图像,然后根据这个图像再做一个范围的限制,优化图像,最后得到想要的效果。
这句话放到 2026 年任何模型上都成立,因为它是关于收敛顺序的判断:先发散、再收窄,而不是一次把话说死。糟糕的是它只出现在一个「专家提醒」的小方框里,占三分之一个页面;而「修饰词只能填 15 个字」这种一次性的界面事实,占了整整 30 屏。这本书的篇幅分配,是按「能不能截到图」来的,不是按「三年后还有没有用」来的。
三、颗粒度问题:它教你点按钮,不教你看图
书名里有「绘画师」三个字。我按这三个字的标准去读,读到的是一个软件操作员培训班。
整本 580 屏,我按章节页数算了一笔账:文案篇(第 1—4 章)约 151 屏,图片篇(第 5—8 章)约 216 屏,视频篇(第 9—12 章)约 197 屏。三大篇的算法是均衡的,这说明结构上没偷懒。但把镜头推近,你会看到不均衡长在别处:教「软件在哪里」的篇幅,远大于教「图好不好」的篇幅。第 2 章(ChatGPT 入门 + 技巧 + 行业应用)38 屏,第 6 章(文心一格)50 屏,第 7 章(Midjourney)66 屏,第 10—11 章(剪映 + Premiere)77 屏。这些章节的主体是「步骤 01、步骤 02、步骤 03」,每一步配一张带红框箭头的截图。
那「怎么看一张图好不好」写在哪?我抽了 14 屏,没有找到。所有的评价标准都是同一个句式:「效果如图 X-XX 所示」。p0450 是剪映识别字幕,图 10-39 四格并排,让读者「预览剪映识别的语音文字效果」——但它没有告诉你识别错了怎么办、错在哪一类字(同音、方言、专有名词),只是让你「预览」。p0560 是数字人模板,图 12-38 让你点「使用此模板创作」,模板画面是「The smallest bird in the world / 世界上最小的鸟 蜂鸟」,中英对照——这个模板的中文是设计好的版式字,不是模型生成的;书里没有一句说明这件事,而读者极容易以为是「AI 把中文字写对了」。这是全书最危险的一处误导,因为它不撒谎,它只是不说。
更具体的一点:这本书里所有带中文的成品图,中文都是后期叠上去的或版式自带的。第 12 章口播视频那一段(p0575),数字人嘴里念的是「我们为什么要使用背屏模拟曝光功能呢……」,屏幕上的中文字幕是剪映语音识别出来的文本层。也就是说,在 2023 年最痛的那个问题——「AI 直接生成中文字」——全书一个字没提。它绕过去了,用后期排版绕过去了,然后当作这个问题不存在。做电商图、做海报的人翻开这本书,会发现最想解决的那件事,目录里没有入口。
四、原理章与操作章是两张皮,而且撕得很干净
第 5 章 5.1 节(23 屏)讲「AI 绘画的基础知识」,是我抽样里最意外的一段,因为它是真的在讲原理。p0175 把 CNN 在绘画里的用法分成三条:图像分类和识别(卷积、池化、特征提取)、图像风格转换、图像生成和重构。第二条给了例子:图 5-5 应用了美国艺术家詹姆斯·古尼(James Gurney)的哑光绘画风格,关键词是「史诗哑光绘画,微距离拍摄,在花丛中,金叶,红花,晴天,春天,高清图片,哑光绘画」。
p0195 更进一步,讲到了文心一格底层的 ERNIE-ViLG:
ERNIE-ViLG 通过视觉、语言等多源知识指引扩散模型学习,强化文图生成扩散模型对于语义的精确理解,以提升生成图像的可控性和语义一致性。
同时,ERNIE-ViLG 引入基于时间步的混合降噪专家模型来提升模型建模能力,让模型在不同的生成阶段选择不同的降噪专家网络,从而实现更加细致的降噪任务建模,提升生成图像的质量。
这段话水平不低。「让模型在不同的生成阶段选择不同的降噪专家网络」,是把 MoE 和时间步两个概念咬在一起说清楚了,比很多论文摘要还干脆。问题是——然后呢?
第 6 章教你用文心一格,界面上的可调项是「修饰词 0/15」「艺术家 0/10」,外加一张参考图和「实付 2 电量」。「混合降噪专家模型」这个机制,在这 50 屏操作里没有任何一个参数和它对应。读者读完原理,得到的知识是「哦,它内部是这么算的」,然后合上书去点按钮,两者之间没有一条可走的路。这就是我说的两张皮:原理章负责证明作者懂,操作章负责证明软件能用,中间缺的那一段——「这个机制决定了你该怎么写提示词」——一句没有。
再举一个更扎心的例子。p0175 那条关键词是把六类东西混在一串的:「史诗哑光绘画」(画风)、「微距离拍摄」(景别,还是个摄影词)、「在花丛中」「金叶」「红花」(题材与元素)、「晴天」(光线)、「春天」(季节)、「高清图片」(画质)。六类混排,读者根本不知道哪个词该放前面、哪个词是噪音。第 3 章 3.2 节叫「生成 AI 绘画关键词的技巧」,20 屏,正是该给这张六类表的地方。书里没给。它给的是「多试几次」「关键词越具体越好」这类无法执行的话。一本自称「从入门到精通」的书,最该有一张自己总结的表,结果它把最难的活儿留给了读者的手感。
五、「AI 视频篇」其实是「AI 辅助剪辑篇」
这是我认为书名与实际内容落差最大的一处。
第 9 章讲 AI 视频的概况与工具(9.1 八屏、9.2 八屏,总共 16 屏,是三篇里最薄的入门章)。第 10 章剪映,第 11 章 Premiere。这两章加起来 127 屏,占了视频篇的六成半。而这两章实际教的是什么?p0450 是「在播放器面板中单击播放按钮,预览剪映识别的语音文字效果」,接着 10.3.4 讲「运用『视频防抖』稳定画面」。第 11 章 11.1 是「使用 Premiere 自动剪辑视频片段」,11.2 是「使用 Premiere 的智能化功能」。
自动字幕、场景检测、视频防抖、自动踩点——这些确实是 AI,但它们是剪辑软件的智能功能,和「生成一段不存在的视频」是两回事。2023 年 6 月,Runway、Pika 已经能用,Sora 还没来,可灵要到下半年;作者选了剪映和 Premiere,是当时最务实的选择(门槛低、能交付)。我理解这个选择,但不能接受它不做区分。全书没有一节告诉读者:「本篇讲的是 AI 辅助你剪已有的素材,不是 AI 帮你生成素材;后者要另找工具,且当时还不成熟。」这一句不写,读者买回去会以为学完能做「输入一句话出一段片」。
第 12 章三个案例里,真正沾「生成」的只有一个:12.2 虚拟主播,用的是腾讯智影的数字人模板(p0560 的「使用此模板创作」,12.3.2 是「更改主播形象气质」)。而这一段恰恰暴露了另一个问题:数字人是别人做好的形象,你只是换脸、换词、换背景。p0575 的截图里有一条产品自带的提示条,写着「轨道中的数字人·仅支持预览静态形象,合成后可查看动态效果」——作者看到了这条提示,把它截进了书里,却没有在正文里解释「静态预览」和「合成后」差在哪、为什么预览不能信。这属于「素材里有答案,正文里没答案」。
还有一处细节,我认为很能说明这本书的写作姿态。p0575 数字人口播的台词是:
我们为什么要使用背屏模拟曝光功能呢?因为这样可以使我们拍照更加方便、更利于观察照片的效果。如果你想深入学习背屏模拟曝光的技术,可以学习《幻境:风光摄影与后期从小白到大师》这本书。
这是「风光摄影」案例的口播稿,说了二十秒,最后半句是给自家另一本书做的广告。作为案例,它当然能用;但作为教学,它把最应该展开的东西(口播稿怎么写才像人说话、停顿怎么标、数字人的口型和音频怎么对齐)压缩成了「把文案粘进去」。案例是营销素材改的,这一点书里没打算藏,但也没打算讲。
六、案例章失踪的那一段:失败的样子
第 4、8、12 三章是案例章,加起来 162 屏,占全书 28%。三个案例的打法完全一致:给一个成品(汽车广告图、水果店 Logo、山水国风插画、卡通少女漫画、旅行风光视频、旅游博主、风光摄影口播),然后倒推步骤。
这种写法能教会人「跑通」,教不会人「改对」。因为它把迭代过程剪掉了。真实的出图流程是:第一版手是六根指头,改词,第二版风格飘了,加参考图,第三版构图对了但字糊了,只好后期叠字。这本书里没有任何一页展示「第一版不行、第二版更差、第三版才对」。所有图都是「效果如图 X-XX 所示」,一次成功。
我不认为这是作者不会,我认为这是取舍:一页放四张失败图,编辑大概会说「排版乱」。但一本讲「从入门到精通」的书,最值钱的恰恰是失败样本——因为入门的人不缺「成功长什么样」,缺的是「我这张为什么不对」的判读能力。p0335 那句「先生成大概的图再做限制」,其实就是一句失败经验的浓缩,但它被写成了一句口诀,没有配任何一张「限制过早导致什么样的图」的对照。
这一节我不算进「短板」,因为它属于写法层面的遗憾;下一节才是硬伤。
七、它的短板
按老规矩,短板的每一条我都给页码,也标注它的边界。
第一,全书停在 2023 年 6 月,且没有留「迁移层」。p0010 前言自署 2023 年 6 月;p0130 截图印着 ChatGPT May 12 Version;p0290 是 Midjourney --v 5.1。三年后,这两个界面、这两个模型号都不在了。作者在特别提示里承认「界面可能会有变动,请举一反三」,但整本书的结构没有为这句话付出代价——它没有在每一章末尾加一小节「这一章里哪些是会变的、哪些是不变的」。承认会过期,和为此重新安排篇幅,是两件事,这本书只做了前一件。
第二,不谈成本。p0230 的界面上明明白白写着「实付:2 电量」,这是全书唯一一次露出价格,而它是以截图形式露出的,正文没有解释「一张图 2 电量是多少钱、一个案例下来要花多少、失败重生成要不要再扣」。Midjourney 那边更明显:p0290 的截图里挂着「(fast)」,这是快速模式,额度消耗更快,正文同样没提。一本教人干活的工具书不算成本,等于教人开车不看油表。这一条我态度很硬,因为成本是这类工具的第一约束,比参数重要。
第三,没有版权与授权这一节。第 8 章用 Midjourney 做「水果店标志」,第 12 章用腾讯智影做虚拟主播,p0290 的图片混合还用了别人的图(截图里 @BettyNelson 的 bot 在跑混合)。三个场景,三种授权问题:AI 生成图的商用权归谁、平台条款怎么规定、拿别人的图做 blend 算不算改编、数字人用真人形象模板要不要肖像授权。全书零字。2023 年这些还是灰色地带,可以理解;但一本要卖到 2025 年以后的书,至少该有一页「这里有个坑,你自己去查条款」。它连提醒都没有。
第四,没有验收标准。如前所述,所有评价都是「效果如图」。没有一次「这张不合格,因为手指结构错了 / 画风偏了 / 中文字糊了」。这意味着读者学完无法自评,只能靠感觉;而感觉,正是这门手艺里最难教的部分。
第五,中文直出被整体跳过。书里所有中文成品字都是后期叠的或模板自带的(p0560 的中英对照版式、p0575 的剪映字幕)。这是 2023 年国内做图最大的痛点,也是这本书最该有一节的地方,目录里没有。
第六,课后习题只是操作的复述。p0580 两道题:「使用剪映的『剪同款』功能快速生成一段宝宝成长的视频」「使用腾讯智影快速创作出一个有关职业培训的虚拟主播视频」。两题都是「把第 12 章再做一遍」,没有一题要求判断(比如「同一段文案出三版图,说明你选哪版、为什么」)。习题的水平,暴露了这本书对「学会」的定义:能复现,就算会。
第七,也是最根本的一条:它没有回答书名里的那个词——「绘画师」。580 屏里,没有一页讲构图、色彩、风格的判断依据;没有一页讲「什么样的图能商用、什么样的图只是好看」;没有一页讲客户说「不够高级」时你该改哪里。它教的是「怎么让软件出图」,不是「怎么做一个画画的人」。这两件事在 2023 年差别还小,在 2026 年差别巨大——因为「让软件出图」这件事,现在一句话就能做到,而「知道要什么图」依然要人。
八、适合谁,以及一句不算安慰的话
适合一类人:要给团队或学生做「AI 内容生产入门」的培训者。这本书的体例是现成的课表——12 章、每章有小结、有习题、有案例,三篇的顺序(字→图→片)可以直接搬去当大纲。你不需要照它的步骤讲,你需要它的骨架。这是我唯一会推荐它的场景。
不适合两类人。第一类是 2026 年想学出图的新手:你会被 2023 年的界面带偏,学到的操作有一半已经不存在,而且书里没有告诉你哪些已经不存在。第二类是想解决「我的图为什么不对」的人:这本书没有失败样本,也没有判读标准,它帮不了你。
那它还剩什么?我认为剩两样,都不在正文的显眼处。
一样是 p0130 那句「文案是为绘画而服务的」。这句话在 2026 年比在 2023 年更值钱:模型越强,「说什么」就越比「怎么点」重要。今天你让任何模型出图,卡住你的从来不是参数,是你自己没想清楚要什么。这本书三年前就把「先写清楚、再画出来」排在了第一章,这个顺序判断是对的。
另一样是 p0335 那句「先生成大概的图,再做限制」。它其实是同一个道理的另一种说法:先发散,再收敛。出图如此,写提示词如此,做产品也如此。
所以最后一句,不算安慰,是实话:这本书的操作部分已经过期了,方法部分还剩一页——而那一页,恰好是三年后唯一还在用的那一页。它的问题是,那一页被印在了一个「专家提醒」的小方框里,而三十屏的按钮教学占据了正文。
抽样核对 14 屏:p0010 前言末页(「编者 2023 年 6 月」、特别提示三条、参与编写者胡杨、苏高等) · p0025 通义千问介绍与图 1-8(「我想写一篇文章,关于《语言模型的诞生和发展史》…」) · p0045 图 2-3 ChatGPT 文本翻译功能与「类似于神经网络的模型」表述 · p0090 图 3-5 求婚方案与「What are some alternative perspectives?」 · p0130 图 4-7 附文生成、ChatGPT May 12 Version、「文案是为绘画而服务的」 · p0175 图 5-5 CNN 风格转换与 James Gurney 哑光绘画九词关键词 · p0195 ERNIE-ViLG 与时间步混合降噪专家模型、图 5-20 · p0230 图 6-17 文心一格「修饰词 0/15」「艺术家 0/10」「实付 2 电量」 · p0290 图 7-25/7-26 图片混合、U4 放大、--v 5.1、(fast) · p0335 图 8-6 与「专家提醒」原文 · p0450 图 10-39 剪映语音识别字幕与 10.3.4 视频防抖 · p0560 图 12-38「使用此模板创作」、12.3.2 更改主播形象气质 · p0575 图 12-50 数字人口播词(荐书《幻境:风光摄影与后期从小白到大师》)与「仅支持预览静态形象」提示条 · p0579 图 12-54 口播四格、本章小结(剪映 + 腾讯智影) · p0580 课后习题两道
说明:抓取止于末页课后习题(页底为「下一章」按钮),未捕获微信读书的阅读统计浮层,故本篇不列推荐值与点评人数 · 章节页数按 pages.jsonl 的章节字段统计 · 笔记与图谱生成于 2026-11-09
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: