
大模型应用开发 RAG实战课:三问提得好,第三问只给了五屏
微信读书《大模型应用开发 RAG实战课》(黄佳,人民邮电出版社,2025 年 5 月,ISBN 9787115671851)· 抓取 449 屏
逐字核对 12 屏 · 空屏 33 屏 · p0001 版权页核对书名与作者 · 2026-11-09
先把素材的边界说清楚,因为这直接决定我能说什么。第一,抓取是截断的:449 屏停在「6.1 从小到大:节点-句子滑动窗口和父子文本块」,末页正文还在往下走,没有「下一章」按钮;而 p0185 里作者提过「第 7 章会讲解压缩提示词的方法」,说明书还有第 7 章及以后。所以凡涉及「生成、评估、上线」的部分,我没有素材,不立论。第二,449 屏里有 33 屏是纯色空屏,全部集中在 p0409—p0433,正好压在第 5 章「检索前处理」的主体上(5.1 查询构建 21 屏、5.2 查询翻译 11 屏)。这是抓取失败,不是书的错,但结果是第 5 章我只能按标题和零星几页说,不能细评。第三,12 屏对 449 屏,抽样率 2.7%,我说「书里没有」的时候,请按这个比例打折看。
我先给结论:这是我读过的同题书里,最肯把参数摊开来讲的一本;但它的篇幅分配暴露了一个老毛病——最贵的那一问写得最薄,最该判断的那两节给得最少。
黄佳这本书有一件别人不容易做到的事:它不满足于告诉你「要分块、要嵌入、要向量库」,它把每一层的可调参数列出来,还标了取值范围和默认值。这在 RAG 类图书里是稀缺品。同一批书里,多数停在「你可以根据业务调整」,而这本书至少把旋钮的刻度画出来了。
但它也有一个很典型的结构病:开篇用「RAG 三问」搭了一个漂亮的梯子——何谓 RAG、如何快速搭建、从何处入手优化——然后第三问只用了五屏就过去了。五屏是什么概念?它比「楔子 闹市中的古刹」那篇散文还短一屏。而那恰恰是读者买这本书的原因。
一、先看结构:三问是个好装置,但第三问只有五屏
我把 pages.jsonl 的章节字段统计了一遍,这本 449 屏的书是这么分量的:
序「未来奔涌而来:从 RAG、AI Agent 到 MCP 和 A2A」14 屏,题记 3 屏,楔子「闹市中的古刹」6 屏,开篇「RAG 三问」2 屏。然后:一问 13 屏(p0032—p0044)、二问 32 屏(p0045—p0076)、三问 5 屏(p0077—p0081)。正式章节:第 1 章数据导入 96 屏,第 2 章文本分块 44 屏,第 3 章信息嵌入 62 屏,第 4 章向量存储 113 屏,第 5 章检索前处理 40 屏,第 6 章索引优化抓到 1 屏就断了。
这个分布本身就在说话。「二问:如何快速搭建 RAG 系统」用了 32 屏,讲得很够——它带你把一条最小链路跑通(p0055 用的是 InMemoryVectorStore,注释写明「本例采用内存向量存储机制,不使用外部向量数据库」,很务实)。而「三问:从何处入手优化 RAG 系统」,5 屏。
5 屏能写什么?能写一句「先看检索、再看生成」,能列三五个优化方向,然后就没了。可这本书后面那 350 多屏讲的,全是第三问的展开——分块、嵌入、向量索引、查询改写,每一项都是「优化」的一个分支。也就是说,作者手里其实有答案,他只是没有在第三问里把这张地图先摊开。读者读完三问,得到的是一句「优化要看检索」,然后翻进第 1 章从头学数据导入,走了三百多页才回到「优化」这个词上。
这是讲 RAG 最典型的失手方式:先给结论,再拆零件,但从结论到零件之间那根线断了。相比之下,第 4 章 4.4 节那段话反而是全书最像「地图」的地方——它把选型按四个维度摊开,然后直接给场景映射(这个我下面单独说)。可惜那段在第 326 页。
二、它把「数据侧」讲到参数级,这是我最愿意给它记的一功
第 4 章「向量存储」113 屏,是全书最厚的一章,比第 1 章数据导入还多。这个配比在同类书里少见——多数书会把「向量数据库怎么选」压缩成一张对比表,然后赶紧去讲 Agent。这本书没有,它把向量库当成一个需要调的东西来讲。
举一个我逐字核过的例子。p0310 讲 IVF_FLAT 为什么叫「倒排」:
咖哥:在文本检索场景中,「倒排索引」是指为给定的词(或关键词)维护一份「文档列表」,列出所有包含该词的文档。这样,在搜索某个词时,只需要从这个「倒排列表」中查找相关文档,不需要遍历整个文档集合。
IVF 借鉴了这一理念,将所有向量聚类成多个「簇」,每个簇记录自己的向量列表,就像文本检索中的倒排列表一样。当执行查询时,根据查询向量与各「簇中心」的相似度,仅选择最相似的几个簇进行检索,而非遍历整个数据集。
这段的解释是对的,而且它做了一件很多书偷懒不做的事:从熟悉的东西(倒排索引)推到陌生的东西(IVF 簇),中间用「簇记录自己的向量列表,就像倒排列表一样」这一句接上。p0310 的图 4-12 也配合着画了:查询向量是红色,选定的簇是粉色区域,其余簇是淡紫——一张图就说清了「只比一部分」是什么意思。
再看 p0185,这是我在这本书里最想给高分的一页,因为它给的是判据,不是操作:
尽管随着大模型的发展,这个问题变得不那么突出,许多现代大模型提供了极大的上下文窗口,例如 GPT-4o 可以接受 128000 个 token 的上下文。然而,即使文本块的容量不再是问题,使用非常大的块时仍需要注意,过度冗余的信息可能会对对话结果的相关性产生负面影响。
……虽然嵌入模型规定了每个块的最大 token 数,但这并不意味着你的分块需要达到这个最大长度。实际上,为了提高检索精度,我们常常倾向于将文本分成更小的块。
「块的最大长度不等于推荐长度」——这句话看着简单,但它是分块这件事的第一判据,而且它主动否掉了「上下文够大就不用分块」这个流行误解(用 GPT-4o 的 128000 token 做靶子,很具体)。同一页还往下「剧透」了分块与嵌入的关系:大多数嵌入模型是基于仅编码器的 Transformer 架构,通过池化层把输入文本映射成一个固定维度的向量(如 768 维),配图 2-6 画了短文本与长文本各自的 token 序列怎么被池化成一个 768 维向量。这一步是「为什么块越大信息越糊」的机制解释,它把前面那句判据坐实了。
这类「先给判据,再给机制,最后给操作」的顺序,是我认为技术书该有的顺序。这本书有若干页做到了,所以它值得被认真评,而不是被一句「又一本攒出来的书」打掉。
三、BM25 那一段:敢上公式,还讲清了「稀疏」稀在哪
p0265 是 3.4 节「稀疏嵌入、密集嵌入和 BM25」。这一页是我抽样里信息密度最高的:先给例子——游戏「灭神纪·狮鹫」的战斗日志,战斗术语集合里有「神兵」「妖怪」「烈焰拳」「金刚体」,词表大小 10000,「狮鹫」在词表里的索引是 103,所以它对应的稀疏向量的第 103 维是 1,其余全 0;然后给公式:
score(w)=IDF(w)·TF(w)(k₁+1)/(TF(w)+k₁(1−b+b·文档长度/平均文档长度))
再解释每一项:TF 是词频,例子是「烈焰拳」出现 3 次;IDF 是逆文档频率,例子是「金刚体」可能在大部日志里出现所以权重低,而「毁灭咆哮」出现得少所以权重高;最后点明k₁ 和 b 是超参数,分别控制词频对权重的影响、以及文档长度归一化的程度。
这一段的价值在哪?它把「稀疏」这个词从比喻变成了可数的东西:1 万个词的词表 → 1 万个维度 → 只有出现的词那一维非 0。读者看完能自己算:如果词表是 5 万,那向量就是 5 万维,命中的维度可能只有三五个。这就解释了为什么 BM25 便宜(稀疏、可倒排)而语义弱(不含上下文),也解释了为什么混合检索要把 BM25 和向量检索拼起来——p0340 所在的第 4 章后头有「4.6 利用 Milvus 实现混合检索」14 屏,逻辑是接得上的。
我要挑的一点是:它给了公式,但没给「k₁ 和 b 一般取多少」。BM25 的经典默认值(k₁ 约 1.2—2.0,b 约 0.75)是行业常识,说出来一句话的事,书里只说「是超参数」。这跟后面表 4-4 只给默认值不给建议值,是同一个毛病——它敢摊开参数,但不愿意替你拍一个数。
四、向量库那一章:选型给了四维度,索引给了范围,却把「该填多少」留空
先说好的那半。p0326 讲选型,是我认为全书最接近「工程师该怎么想」的一页。它给了四个维度:功能支持(要复杂混合检索就 Weaviate、Qdrant、Milvus;要动态更新数据和索引就 Milvus、Qdrant)、成本与预算(开源 PGVector、Chroma 降低初始投入;商业方案如 Pinecone 成本较高,但更适合追求稳定性与服务支持的企业)、技术栈兼容性(已有 Elasticsearch 就扩它的向量检索;PostgreSQL 团队考虑 PGVector)、特殊需求(云原生看 Vald、Milvus 的 Kubernetes 支持;GPU 加速看 Faiss)。然后直接落到场景:
根据这些维度,可以快速匹配最合适的向量数据库。例如,开发实时推荐系统时可选择 Milvus 或 Qdrant;进行概念验证或开发小型项目时可选择 Chroma 或 Weaviate;开发企业级搜索时可选择 Pinecone 或 Elasticsearch;如需要与关系型数据库整合,PGVector 是一个不错的选择。
这段话是这本书的成色所在。它没有停在「各有优劣」,而是给了「什么场景配什么」。同题书里最常写的是「Milvus 性能强、Chroma 轻量」,读者读完还是不知道选哪个;这里给了四条可直接对照的场景,专业度立刻不同。
然后是我不满意的那半。p0340 讲 IVF_FLAT 的构建参数,正文解释得清楚:nlist 是把向量划成多少个簇,nprobe 是查询时探几个簇,「nprobe 的值越大,准确率越高,但查询速度越慢;反之……」,还老实说了 IVF_FLAT 不压缩向量、索引文件与原始数据基本一致、数据量大时加载会吃内存。这些都对。但表 4-4 长这样:
表4-4 IVF_FLAT 的索引构建参数
参数:nlist | 说明:聚类数量 | 取值范围:[1, 65536] | 默认值:128
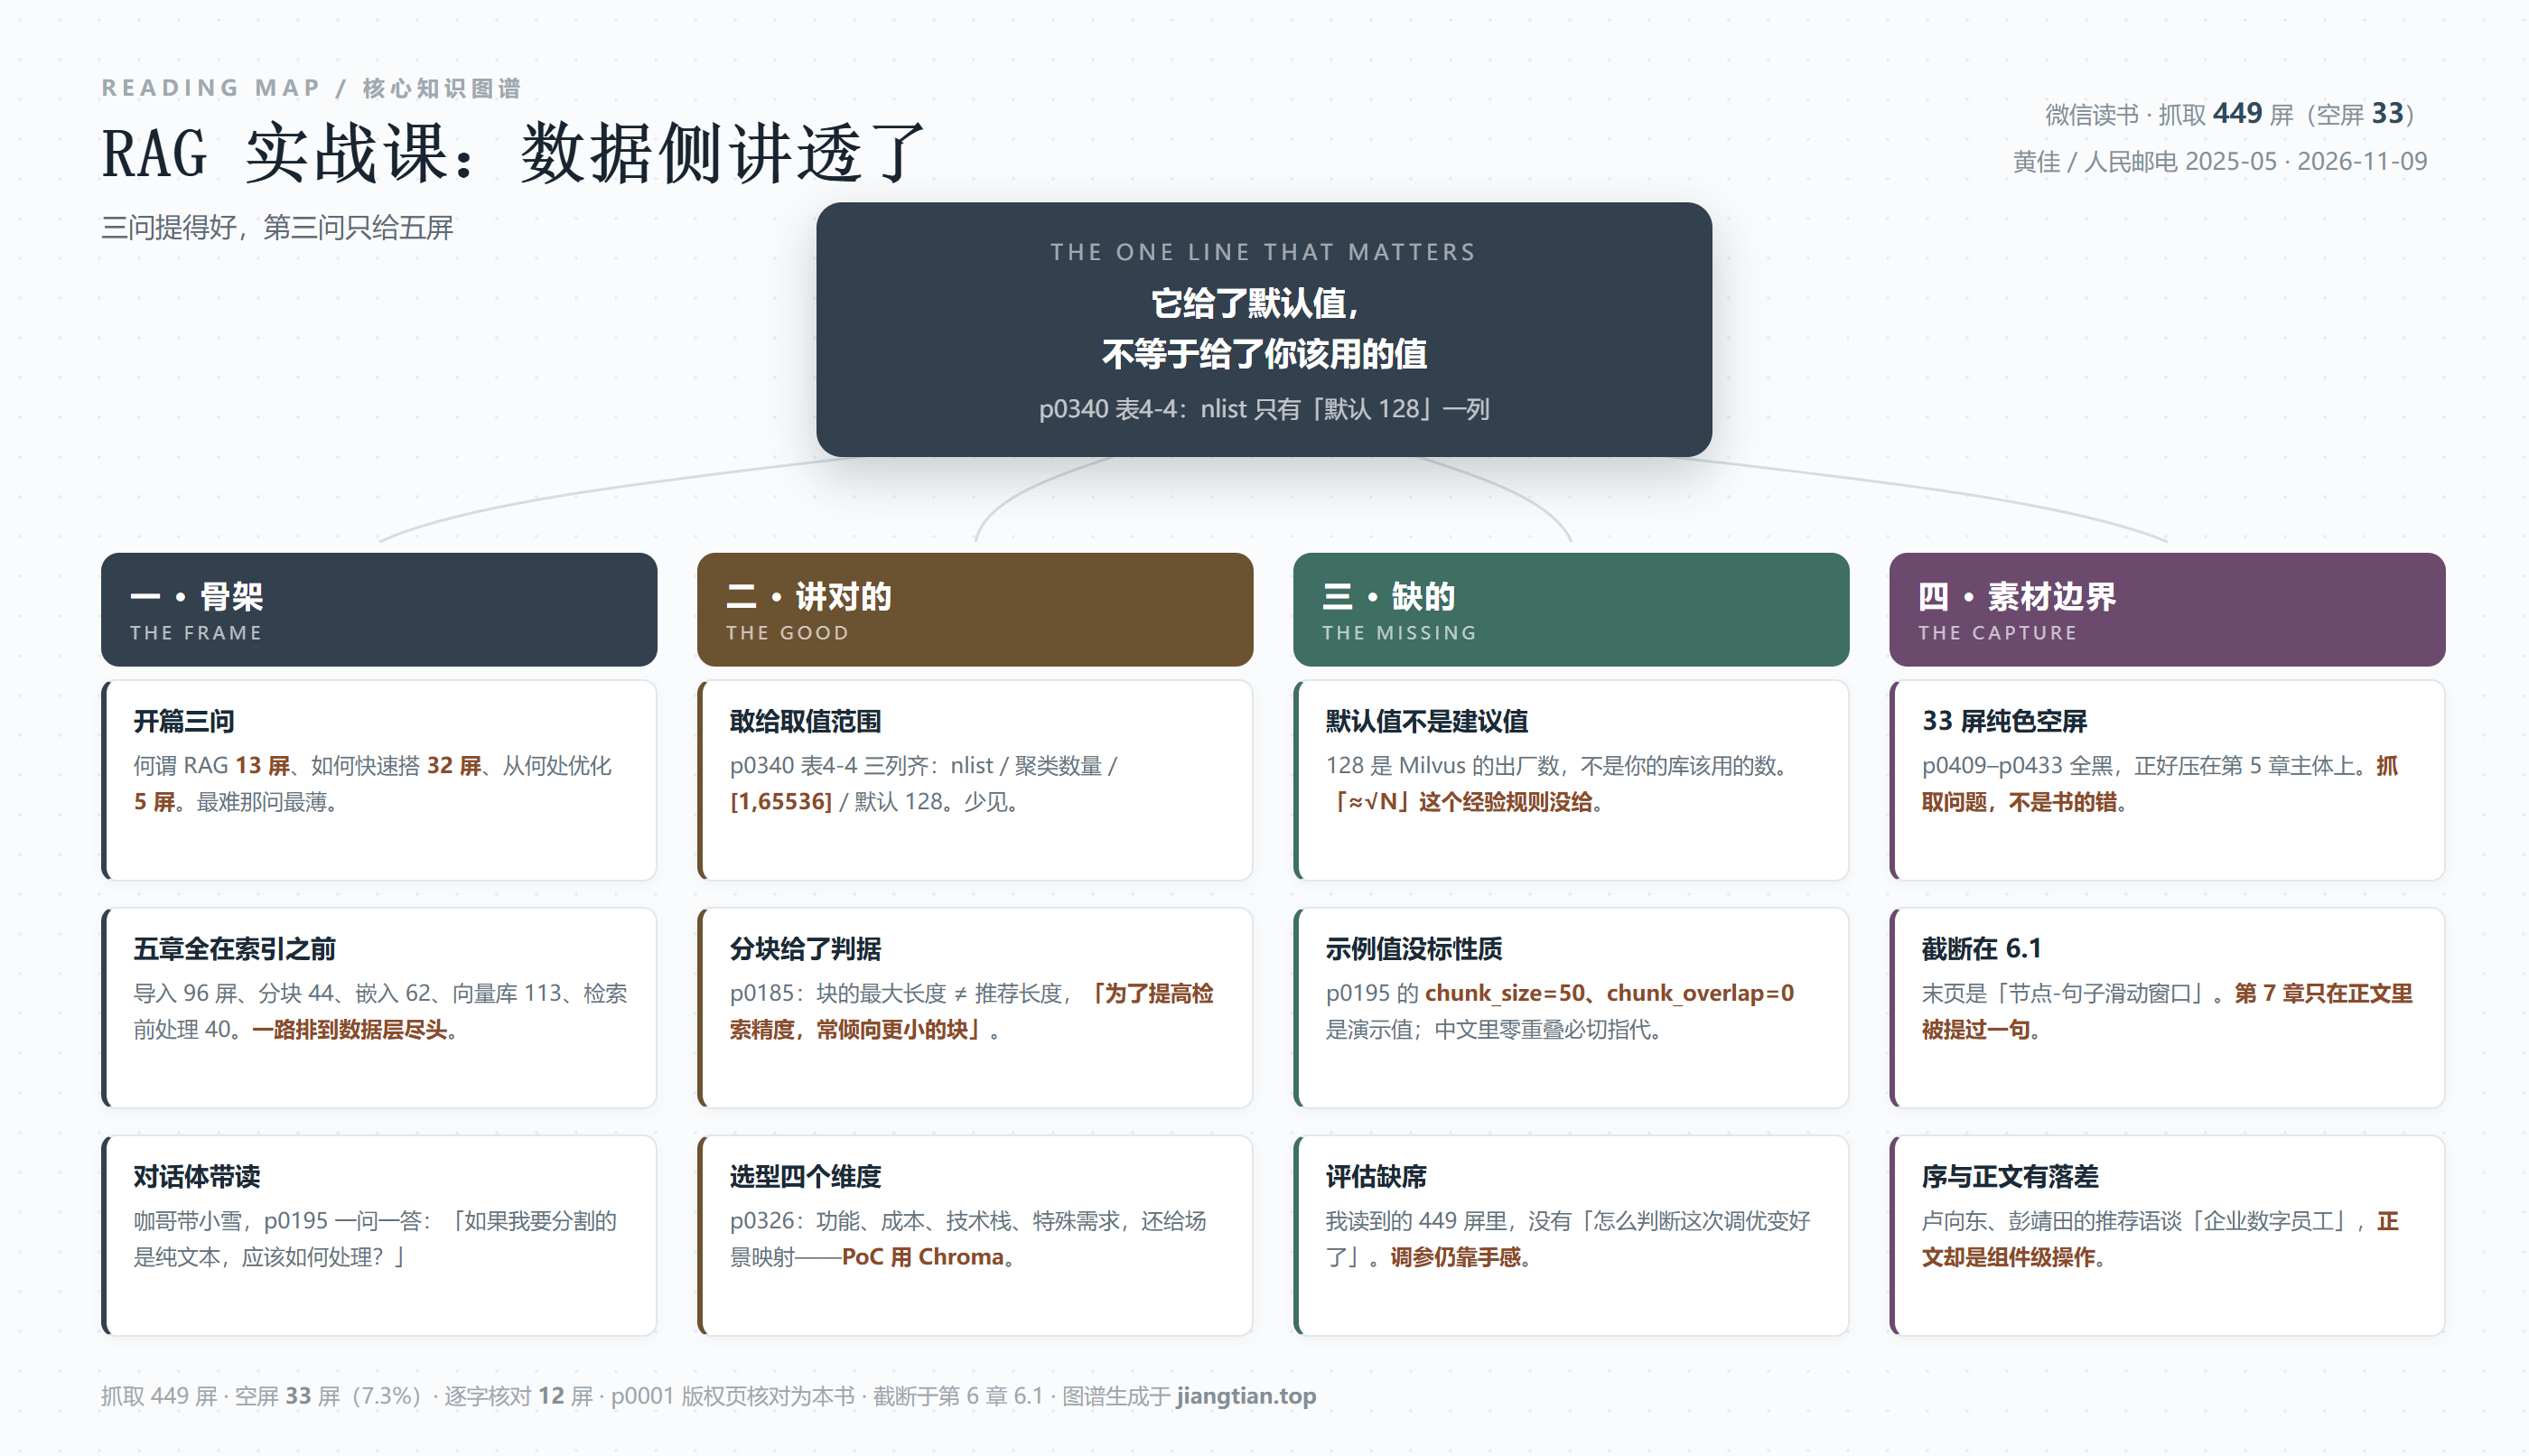
我特意把这张表裁下来放大看了三遍,确认第四列的表头是「默认值」,不是「建议值」。这就是我要说的那个毛病:128 是 Milvus 的出厂设置,不是你的数据该用的数。nlist 有一个流传很广的经验规则——大致取向量总数的平方根量级,10 万条向量大概几百到一千。书里给了「[1, 65536]」这个宽得没边的范围,给了「128」这个跟你的数据无关的默认,唯独没给「我该填多少」。读者照着默认值跑,索引能建起来,召回率好不好,没人告诉他。
而且这个毛病在第 2 章也复现了一次。p0195 演示「按固定字符数分块」,代码是:
text_splitter = CharacterTextSplitter(
chunk_size=50,
chunk_overlap=0,
separator="\n"
)
# 使用create_documents方法分割文本
示例文本是云冈石窟的介绍(「云冈石窟位于中国北部山西省大同市西郊 17 公里处的武周山南麓……2007 年 5 月 8 日被国家旅游局评为首批国家 5A 级旅游景区」)。chunk_size=50 是什么概念?中文 50 个字,大约两三句话;chunk_overlap=0 意味着块与块之间没有任何重叠。这两个值合起来,几乎必然切断跨句的指代关系——「它始建于北魏」这种句子被切到下一块,那块就说不清「它」是谁。作为演示代码,它能跑通、能打印出干净的 Document 列表(我看 Out 里 metadata 是 {'source': 'data/山西文旅/云冈石窟.txt'},page_content 是整齐的两段),但它没有标注「这是演示值,不是推荐值」。而 p0185 刚刚才说过「常常倾向于将文本分成更小的块」——两页放在一起读,读者很容易把 50 当成「更小的块」的推荐值。
这里我要说清一件事:这本书不是不给判据,它给判据的地方比同类书多;问题是它给的顺序反了——判据写在原理节(2.1.2),示例值写在操作节(2.2),中间没有一句话把两者连起来。读者按顺序读,先被概念说服,再被代码覆盖。
五、对话体是双刃刀:小雪永远问在点上
这本书沿用黄佳前作的写法,用「咖哥」和「小雪」两个角色对话推进。p0195 那段很典型:
小雪:split_documents 方法读取的是 LangChain 中的 Document 对象,如果我要分割的是纯文本,应该如何处理?
咖哥:可以用 create_documents 方法接受一个文本列表(非 LangChain 的 Document 对象),将其分割成新的 Document 对象。
这个装置的好处很实在:技术的转折点有了人声。很多书写到 API 差异时是一句「注意:split_documents 需要 Document 对象」,读者眼睛就滑过去了;换成小雪提问,读者会停一下,因为那是他心里的问题。
坏处也在这。小雪的问题问得太准了——她问的正好是「split_documents 与 create_documents 的区别」,一个边界清晰、有标准答案的知识点。真实的新手不会这么问。真实的新手会问:「我按你说的切完了,为什么搜出来的东西驴唇不对马嘴?」「为什么同一个问题,昨天搜得到今天搜不到?」「我的 PDF 切出来全是乱码,是分块的问题还是解析的问题?」这些问题的答案不在 API 文档里,在判断里;而小雪从来不问这类问题。
所以对话体在这本书里起到的作用,是把「知识点的边界」讲清楚,而不是把「判断的困难」摆出来。这也解释了为什么它读起来顺、学完却还是不会调——对话把棱角磨平了。p0310 那段「小冰:为什么叫倒排?」是同一模式:问题精准地卡在概念命名上,答案是一段干净的类比。好读,但不难。
顺带说一句,对话体是有成本的。449 屏只走到第 6 章 6.1,而这本书的目录里至少有第 7 章(p0185 提到「第 7 章会讲解压缩提示词的方法」)。一问一答的排版本身就吃掉不少篇幅——每段对话都要单独起行,插图要配合「咖哥画给你看」的语境。我不能断言这是篇幅超支的原因(毕竟我看到的是截断的抓取),但「对话体 + 图解」这套写法,确实是拿页数换亲切感。
六、我的素材边界:33 屏空屏、一个断章,和序里的落差
这一节不是评书,是交代我看到的到底是什么。
第一,33 屏空屏。我用脚本扫了 449 张图,有 33 张是纯色(灰度值恒定 38,文件大小一律 6987 字节),编号集中在 p0409—p0433,p0435 也是黑的。这个区间正好是第 5 章「检索前处理」的主体。所以关于「查询构建、查询翻译、查询路由」这三节,我只有标题和章节页数(5.1 二十一屏、5.2 十一屏、5.3 四屏),内容一个字都没有。这一章我不评,因为没有材料。
第二,一个断章。第 449 屏是 6.1 的开头,正文写着「每个节点被解析为单独的句子,并且该节点的元数据中包含了其前后一定数量的句子,形成一个所谓的『窗口』。在检索过程中,通过使用元数据替换的方式,将整个句子替换为这个窗口中的上下文」,然后介绍要用 LlamaIndex 的 SentenceWindowNodeParser 和 MetadataReplacementNodePostProcessor 实现「从小到大」策略——说到一半就没了。这一页其实是全书我第二喜欢的一页(它把「小检索、大上下文」这个技巧讲得很具体),但它是断的,我引用它时必须说它是断的。
第三,序与正文的落差。p0006 是两段推荐语。卢向东(TorchV 创始人兼 CEO)写的是:「企业不仅要借助大模型和流程编排工具,还需将这些技术与自身知识体系深度融合,具备幻觉对抗、权限控制、知识重构与解释、自动更新以及过程可溯等能力,而实现这些目标的核心技术正是 RAG。」彭靖田(谷歌 AI 开发者专家)写的是:「本书深入浅出地剖析了 RAG 的技术栈与实践要点,对致力于构建高性能、可信赖 AI 应用的工程师和架构师而言,极具参考价值。」
这两段序把期待值拉到「企业级 RAG 实施路径」的高度——幻觉对抗、权限控制、自动更新、过程可溯,四项。而我读到的 449 屏里,讲得最实的是数据怎么进来、怎么切、怎么嵌入、怎么存、怎么检索;权限控制和过程可溯,我没看到(也可能在第 7 章之后,但我只能说我看到的)。序言许诺的是「治理」,正文交付的是「管道」。这不是欺骗,是文体问题——推荐语总要拔高一点;但它确实让读者带着错误的期待翻开第 1 章。
七、它的短板
第一,第三问只有五屏,而它是全书的题眼。一问 13 屏、二问 32 屏、三问 5 屏。这个数字对比我核过两遍,因为我不太敢信。「从何处入手优化 RAG 系统」是读者最想知道的问题,也是这本书后面 350 屏的实际内容所属的大类,却在开篇被压缩成五屏。合理的写法应该是:三问里把优化的四条路径(数据质量、分块策略、嵌入与索引、查询侧改写)先摊开成地图,后面每章开头回指一次。它没有做这件事,所以读起来是一串珠子,缺一根线。
第二,给默认值,不给建议值。表 4-4 的 nlist 是「[1, 65536],默认 128」。128 是软件出厂设置,与你的数据规模无关;而 nlist 恰恰是一个跟数据量强相关的参数(业界常用量级是向量总数的平方根附近)。书里给了宽到没边的范围,给了与你无关的默认,没给「我该怎么估」。同类问题在 BM25 那节也出现:k₁ 和 b 只说「是超参数」,不给常用取值。这不是能力问题,是习惯问题——作者愿意摊开参数,但不愿意替你拍一个数。
第三,示例值不标性质。p0195 的 chunk_size=50, chunk_overlap=0,能跑通、输出干净,但中文 50 字两句话、零重叠必切指代。它没有一句「此处仅为演示」。而 p0185 又刚说过「常倾向更小的块」,两页相邻,读者极易把 50 当成推荐起点。一本讲实战的书,代码里的每个数字都该标清楚「这是演示」还是「这是建议」。
第四,评估缺席(这条打折看)。我读到的 449 屏里,没有任何一处讲「怎么判断这次调优变好了」:没有召回率、没有命中率、没有答案忠实度、没有「同一批问题跑两个配置比一比」。RAG 调优的全部功夫都在这一步——你改了 chunk_size,得知道它是变好还是变坏。但没有评测集,「变好」就只能靠手感。这一条我必须声明边界:书还有第 7 章及以后,评估很可能在后面;我只能说,它在数据侧的 350 多屏里没有出现。
第五,最需要判断力的两节,篇幅最少。第 4 章里,「4.3 主流向量数据库」6 屏、「4.4 向量数据库的选型与测评」5 屏,加起来 11 屏;而「4.5 向量数据库中索引和搜索的设置」34 屏。选型是要拍板的活儿,参数设置是照文档填的活儿——书把力气花在了后者。p0326 那四维度写得很好,但它只有一页半;表 4-2 还是引「LangChain 团队在 2024 年」的第三方比较,作者自己也加了免责「随着时间推移……可能会发生变化」。2025 年 5 月出版的书,用 2024 年的对比表给选型定调,这个滞后它自己知道,读者未必知道。
第六,散文式开头的成本。「楔子 闹市中的古刹」6 屏、「题记」3 屏、「序」14 屏,加起来 23 屏,占全书 5%。这在人文书里是加分项,在技术书里是奢侈品——尤其当第三问只有 5 屏的时候,这个对比会让人有点难受。我不反对技术书写得好看,我反对的是「好看的部分」比「要紧的部分」长。
八、适合谁,以及一个具体的用法
最适合的一类人:已经跑通过一个最小 RAG、现在开始怀疑「为什么它答不准」的人。这本书的前四章正好是你的下一步——你已经知道要分块,现在你需要知道块该多大、重叠该多少、嵌入模型怎么选、索引怎么建、nprobe 调大调小分别牺牲什么。它的强项就在这些「第二层」问题上。
不太适合的两类人。第一类是零基础:第 1 章上来就是各种 Loader(文本、JSON、UnstructuredLoader 读图、大模型整体解析图文、CSV、网页、Markdown、PDF),没有编程底子会卡在环境上。第二类是想要「一本书读完就上线」的人:上线要的是评估、监控、权限、成本,这些在我读到的部分里没有。
最后给一个具体用法,我觉得比「推荐指数」有用:把这本书当参数手册用,不要当教程顺着读。顺着读你会在第 1 章耗掉耐心(96 屏的数据导入,其中 1.8 节 PDF 解析就 35 屏);把它摆在手边,等你遇到「召回不准」「索引太慢」「换嵌入模型要不要重建」的时候,按目录去翻对应小节,效果更好。它的目录结构(导入→分块→嵌入→存储→检索前处理→索引优化)本身就是一张排查表。
最后一句:这本书把 RAG 的数据侧讲到了参数级,这份诚意在同题书里不多见;但它把最贵的那一问写成五屏、把最该拍板的选型写成十一屏,说明它仍然是一本「知道怎么调」的书,而不是一本「知道该调到哪」的书——而后者才是读者真正缺的那一半。
抽样核对 12 屏:p0001 版权信息(黄佳/人民邮电/2025-05-01/9787115671851) · p0006 推荐语(卢向东「幻觉对抗、权限控制、知识重构与解释、自动更新以及过程可溯」;彭靖田) · p0032 一问标题页(「从实际项目展示到底何谓RAG」/「何谓RAG?」) · p0055 InMemoryVectorStore 代码与图 0-13 检索加生成阶段 · p0185 2.1.2 分块大小对检索精度的影响(GPT-4o 128000 token、「常倾向更小的块」、图 2-6 池化到 768 维) · p0195 create_documents 与 CharacterTextSplitter(chunk_size=50, chunk_overlap=0)、云冈石窟示例 · p0235 3.2 从早期词嵌入到大模型嵌入(BERT 2018 → Sentence-BERT → SentenceTransformers) · p0265 3.4 BM25 公式与 TF/IDF 解释(k₁、b 为超参数) · p0310 图 4-12 与倒排索引类比 · p0326 4.4 选型四维度与场景映射、表 4-2(LangChain 团队 2024 年比较) · p0340 IVF_FLAT 与表 4-4(nlist/聚类数量/[1,65536]/默认 128) · p0449 6.1 节点-句子滑动窗口(SentenceWindowNodeParser/MetadataReplacementNodePostProcessor)
说明:p0409—p0433 共 33 屏为纯色空屏(灰度恒定 38,6987 字节),覆盖第 5 章主体,该章无法细评 · 抓取止于 6.1,第 7 章及以后无素材 · 章节页数按 pages.jsonl 的章节字段统计 · 笔记与图谱生成于 2026-11-09
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: