
AI驱动开发:1057 屏读完,企业级只剩一张 products 表
微信读书《AI驱动开发:企业级机器学习与自动化编程实战》· 抓取 1057 屏 / 22 章 / 382 条目录 · 读到书尾
逐字核对 12 屏 · p0006 书名条核对为本书 · 2026-11-10
抽样不是随机翻。这本书的结构非常规整:前 3 章讲概念和提示策略,中间 7 章建一个电商网站,后 10 章拿 ChatGPT 和 Copilot 做机器学习的教科书练习。所以我把抽样点放在三处:体例声明处(前言)、方法论骨架处(2.3 与 12.6)、以及每一段的重心落地处(8.2 的业务问题、16.4 的预处理、20.5 的代码审查、21.4 的智能体、22.4 的收尾)。抽读 12 屏约占 1.1%,但因为全书体例高度重复,抽样误差主要落在「具体数字」上而不是「结构判断」上——结构判断我是用 pages.jsonl 的逐页章节映射做的全量聚合,不是抽样。
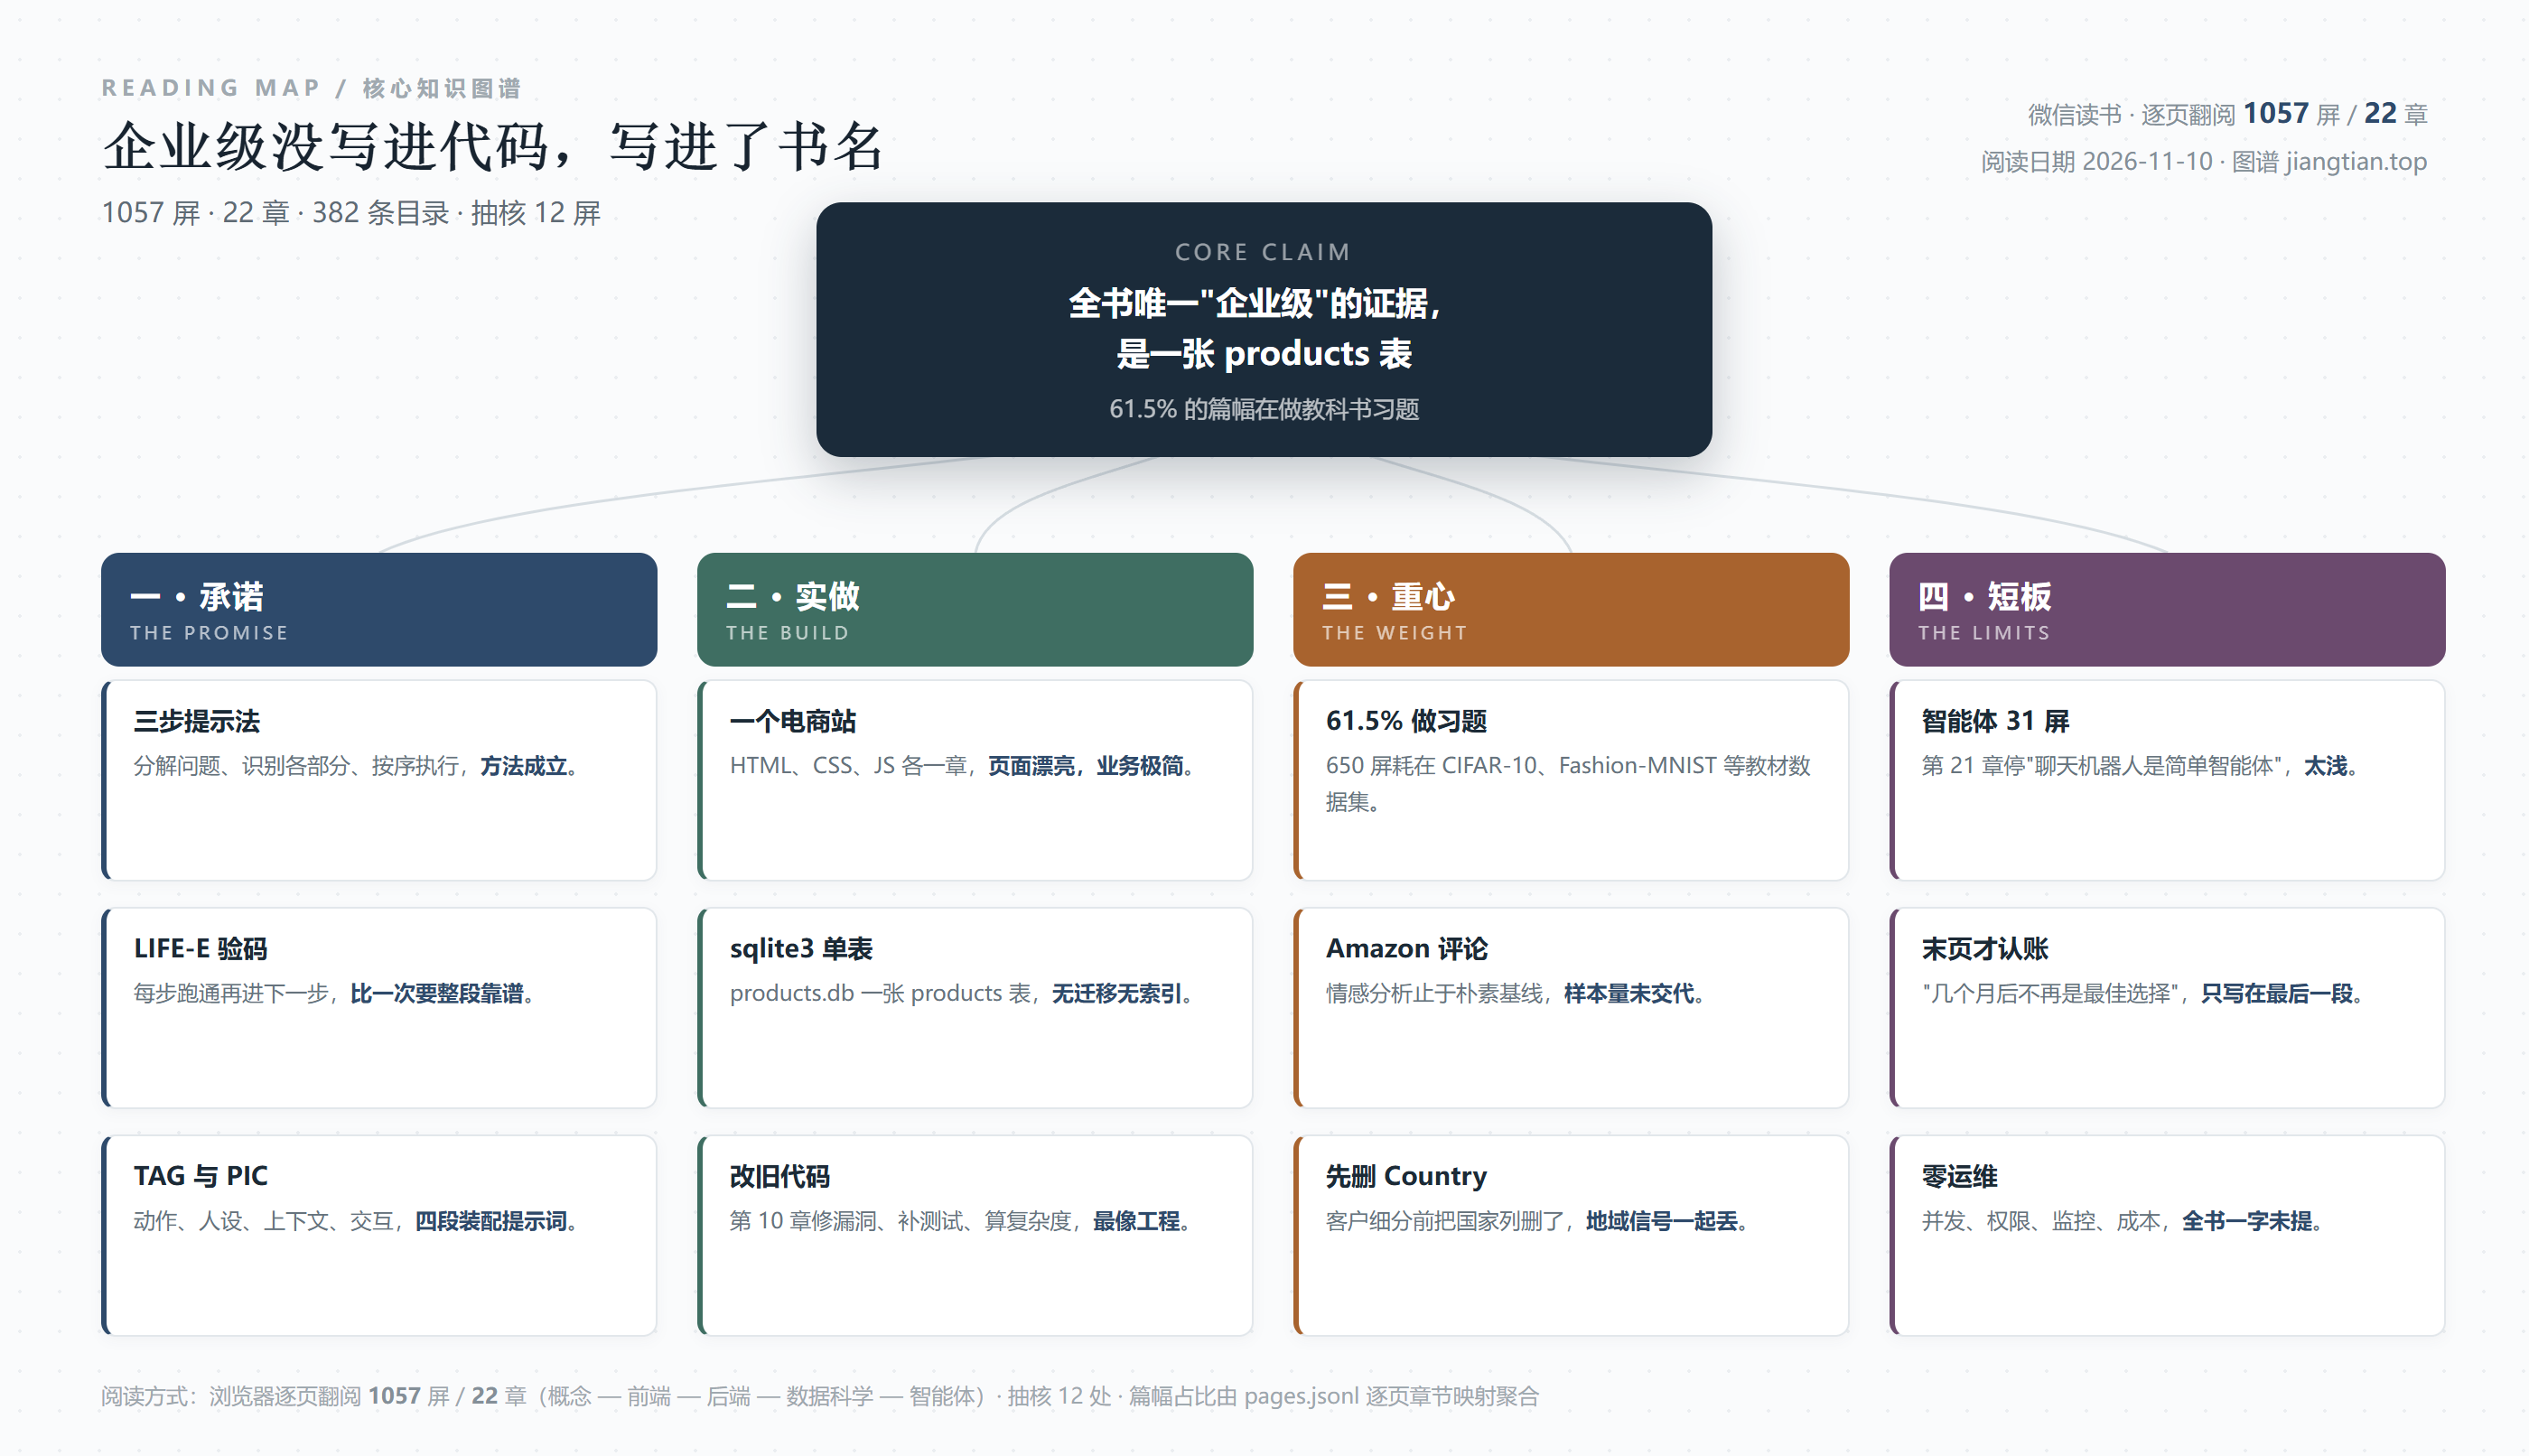
我先给结论:这是一本合格的技术书,配了一个不合格的书名。它的真身是「用 Copilot 和 ChatGPT 做全栈 Web 开发与机器学习练习」,中文版给它套了「企业级」三个字。翻完 1057 屏,我没有找到一处企业级系统必须回答的问题——权限、并发、部署、成本、监控、数据合规,一个字都没有。全书唯一能被称为「企业级」的物证,是第 20 章代码审查那一段收敛出来的一个 sqlite3 单文件数据库,里面只有一张 products 表,三个字段:id、name、price。
这不代表书没用。恰恰相反,它在「怎么把提示词写成可验收的步骤」这件事上,比我读过的绝大多数 AI 编程书都清楚。问题是,你按封面买它,会失望;按前言买它,会觉得值。
一、先说这本书原本是给谁写的
p0022 的「前言」把话说得很直白:「本书的目标读者是 Web 开发、机器学习和数据科学领域内至少有 1~3 年经验的专业人士,特别是那些希望通过使用 GitHub Copilot 和 ChatGPT 等 AI 助手来提高工作效率的人群。」
1 到 3 年经验。这是一条非常重要的界线。1~3 年经验的人,还没有资格对「企业级架构」做决策,他们的日常是写页面、改 bug、跑模型、被人 review。这本书服务的就是这个日常,而且服务得不差。
同一页还交代了全书的主线:「第 4 章重点构建电子商务应用的前端(这是贯穿全书的主题)。第 5 章继续开发电子商务应用,尤其关注 CSS,以确保应用外观更加吸引人。」也就是说,从第 4 章到第 10 章,作者带你做的是一个电商网站的前端、样式、交互、响应式布局、后端 API,最后是「维护现有代码库」。
这是电商网站,不是电商系统。区别在于:前者是一个能跑起来的 CRUD 项目,后者要处理订单幂等、库存超卖、支付对账、灰度发布。作者从没承诺过后半段,但他的书名承诺了。
还有一件事值得提。前置部分有 31 屏,占全书 2.9%,其中六篇推荐序占了大半。p0006 是推荐序一,落款是某科技公司创始人兼总裁,通篇在讲「金融行业的数字化转型不仅是技术的升级,更是业务与技术的深度融合」。后面还有航空运行安全、智能芯片、网络安全。六位推荐人来自六个完全不同的行业,唯独没有一位来自这本书正文里那个电商库存系统的真实使用者。
推荐序在为「AI 赋能行业」背书,正文在教你怎么用 Copilot 写 HTML 表格。这两件事之间隔着的,就是书名里那三个字。
二、篇幅账:61.5% 的屏在做教科书习题
判断一本技术书的重心,不要看目录,看每一章占了多少屏。我把 pages.jsonl 里逐页的章节标记做了聚合,得到这张账单:
前置(版权、六篇推荐序、译者序、前言、作者简介)31 屏,2.9%。
第 1~3 章(AI 助手新世界、提示策略、行业工具)72 屏,6.8%。
第 4~10 章(HTML、CSS、JavaScript、响应式布局、Web API 后端、AI 服务、维护现有代码库)262 屏,24.8%。
第 11~20 章(数据探索、分类、回归、MLP、CNN、无监督、Copilot 做机器学习、回归分析、效率提升)650 屏,61.5%。
第 21 章(软件开发中的智能体)31 屏,2.9%。
第 22 章(结论)11 屏,1.0%。
22 章、1057 屏,平均每章 48 屏。这个体例很整齐,整齐到有点机械。但真正的信息在比例里:超过六成的篇幅,花在 CIFAR-10、Fashion-MNIST、亚马逊评论、客户消费回归这几个数据集上。
这些数据集是什么?是机器学习课的标准作业。任何一个上过入门课程或者跑过 Kaggle 练习赛的人,都在这几个数据集上练过手。它们的问题是:标签干净、特征规整、样本量适中、评价指标明确。企业里的数据一样都不占。
我不是说教材数据集不能用来教学。教学当然要用干净数据,否则学生连模型跑不跑得起来都判断不了。我要说的是另一件事:当你把 61.5% 的篇幅放在教材数据集上,然后在书名里写「企业级」,你就制造了一个预期落差。读者带着「怎么在我公司落地」的问题进来,拿到的答案是「怎么在 Colab 里跑通 CIFAR-10」。
更能说明问题的是跨度。第 16 章「无监督学习:聚类和 PCA」94 屏,占 8.9%;第 21 章「软件开发中的智能体」31 屏,占 2.9%。一本在 2024 年之后出版、书名带「AI 驱动开发」的书,给智能体的篇幅不到聚类分析的三分之一。这个配比不是笔误,是章节结构在动笔时就定下的——它反映的是作者的知识地图,而不是读者的需求地图。
三、真正硬的那 24.8%:一个电商站和一次改旧代码
第 4 到 10 章,262 屏,四分之一本书。这是全书唯一一条「从零到一建东西」的完整链路,也是唯一能看出作者有真实工程经验的部分。
第 4 到 7 章共 123 屏(占全书 11.6%),讲 HTML 结构、CSS 样式、JavaScript 行为、响应式布局。这部分内容本身没什么稀奇,任何前端入门书都讲。它的价值在于「怎么让 AI 参与」:不是让 Copilot 一次生成整个页面,而是一条提示词加一点上下文、再看 AI 的建议、再接受或修改。p0104 的第 4 章扉页之后,作者用「简单提示词 → 添加更多上下文 → 接受提示建议」三步走完一个页面的骨架。这个节奏是对的,因为一次性生成整个页面的结果,通常是一个你看不懂、也改不动的页面。
第 8 章「构建具有 Web API 的后端」48 屏,是这段链路里最像工程的一章。p0230 的 8.2 节叫「业务问题」,作者先把电商拆成逻辑域:「逻辑域:应该将应用程序划分为不同的逻辑域。在电子商务问题的上下文中,这通常会被转化为产品、订单、发票等。」然后他逐个说每个域该由谁负责,产品可能有专门的团队,发票和付款通常有专门团队处理用户支付费用的问题。
这段写得专业。先划域,再定接口,最后才写代码——这是做后端该有的顺序,很多书直接从「我们来创建一个 Flask 应用」开始。
但接下来的一页,也是这本书最暴露短板的一页。同一节里,作者写到库存:「库存:需要在库房备有一定数量的产品。如何确定备货量?需要与业务分析师或数据专家合作,以做出精准预测。」
库存:需要在库房备有一定数量的产品。如何确定备货量?需要与业务分析师或数据专家合作,以做出精准预测。
这句话说明作者完全知道真实业务长什么样:要跨部门,要预测,要跟业务分析师对齐。他不是不懂,他是知道但没写。从 p0230 到全书结束,还有 827 屏,没有一屏去兑现这句「需要与业务分析师合作」。库存预测这个东西,在企业里可能是整个系统最难的一块,在这本书里是一句话带过的注脚。
第 10 章「维护现有代码库」56 屏,是这段链路里我最想推荐的一章。它的节标题依次是:解决一个漏洞、实施更改并添加新功能和测试、大 O 表示法计算、添加测试并降低更改风险、更新现有的电子商务网站。
这是全书唯一一章在讲「代码已经在那儿了,你怎么动它」。真实工作里,这件事占掉工程师 70% 的时间,而几乎所有 AI 编程书都在教你怎么从零开始一个新项目——因为新项目好写,旧代码难写。作者把「用大 O 估算改动的影响面」「加测试来降低改动风险」这两件事放进 AI 辅助的流程里,这是有含量的。
它的价值也到此为止。因为这一章讲的是「怎么安全地改」,不是「怎么在企业规模下改」。一个人改一个 500 行的 Flask 项目,和十个人改一个 50 万行的服务,完全不是同一种活动,后者需要的是接口契约、灰度、回滚、依赖治理。这些词在这本书里没有出现过。
四、它的方法论贡献:把提示词拆成可验收的步骤
如果这本书只能带走一样东西,我建议带走第 2 章那套提示策略。
p0050 的 2.3 节「如何有效提示」,开头就把提示词的性质说清楚了:「提示词是 AI 工具的输入项。根据你想要达到的目标,你需要针对场景调整你的提示词。因此,如何『提示』至关重要。如果提示词太模糊,你就无法得到所需的结果。」接着是一个很多人会忽略的对比:给公司写口号的提示词,和给应用程序生成代码的提示词,不能是同一个。数据科学这类学科,「应该按照特定顺序来执行任务,提示词应反映要完成的任务,以及在需要时执行任务的步骤」。
然后他给了宏观层面的方法:「(1) 分解问题以便深入理解。」下面两条是理解问题(明确问题的定义和范围,比如「构建一个机器学习模型来预测销售额」和「构建一个网页来跟踪库存」是两个完全不同的方向)和识别问题的各个部分。
这套东西听起来朴素,但它是把「提示词工程」从玄学拉回工程的第一步:先分解,再排序,再逐步验收。后面在 12.7 节,作者把它具体化成了一套标记体系。p0492 里有这样一段提示词:「我计划为亚马逊评论数据集(TAG-T)构建一个简易的情绪分析模型。在此处上传CSV格式的数据集(PIC-C)。它应该包括以下步骤(TAG-A)(我是一个初学者用户(PIC-P)),所以请每次提供一个步骤,并等待用户反馈(PIC-I)。」
TAG 管任务(TAG-T 是什么任务、TAG-A 要哪些动作),PIC 管角色与节奏(PIC-P 人设、PIC-C 上下文、PIC-I 交互方式)。这套标记比「你是一个资深数据分析师」这种咒语式提示词有用得多,因为它逼你在开口之前先把任务拆完。
验收环节叫做 LIFE-E。p0450 写:「我们现在将应用评估提示策略(LIFE-E),并通过在 Google Colab 中运行每个步骤来验证代码。」
这套拆法还有一个副作用,作者没有明说:它把读者的注意力从「AI 能不能做对」转移到了「我有没有说清楚」。这是好事,因为它把责任放回使用者身上;这也是坏事,因为当结果不对时,人会本能地怀疑自己提示词写得不够好,而不是怀疑这条路本身走不通。我在这本书里看到的每一次失败,作者都归因为「提示词需要更具体」,没有一次归因为「这个任务不该交给模型」。
这里就是这套方法论的天花板。LIFE-E 的「验收」标准是「代码跑通」,不是「结果正确」。跑通和正确之间隔着一整个太平洋——一个把标签泄漏进特征的模型,跑得比谁都顺,指标比谁都漂亮,上线比谁都惨。这本书从头到尾没有做过一次「AI 生成的模型 vs 人手写的基线模型」的对照,也没有讨论过怎么判断「这个 0.92 的准确率是真的还是噪声」。它把验证收缩成了执行,这是技术书里最常见、也最贵的一种简化。
五、它最诚实的一页,是一张三个字段的表
第 20 章「利用 Copilot 提高效率」里有 20.5 节,标题是「代码审查和优化技术」。p1000 展示了这段优化的结果:代码被拆成三个文件,app.py 负责启动应用并注册蓝图,database.py 负责数据库连接,products.py 负责产品 API。作者的原话是:「我们现在看到的是职责的分离……我们可以使用并维护这些代码。」
然后他给出了 database.py 的实现:
import sqlite3
def get_db():
with sqlite3.connect('products.db') as db:
db.row_factory = sqlite3.Row
return db
def init_db():
with sqlite3.connect('products.db') as db:
db.execute('''CREATE TABLE IF NOT EXISTS products
(id INTEGER PRIMARY KEY AUTOINCREMENT,
name TEXT,
price REAL)''')
db.commit()
我不打算苛责这段代码——它是一本入门书的教学示例,写清楚了职责分离,with 上下文管理器也用了。我要指出的是它代表的东西:1057 屏之后,这本书留给读者的「企业级系统」,是一个单文件 SQLite 数据库、一张三字段的表、没有任何迁移脚本、没有索引、没有事务边界、没有连接池。
作者在这段代码下面写了一句很动情的话:「记住,Copilot 不仅仅是一个代码生成器。」这句话我完全同意,而且我觉得这是全书最真诚的一句判断。但「不仅仅是一个代码生成器」的下一步,应该是「它还是一个需要你懂架构才能指挥的东西」——而这本书没有走这一步。它停在「Copilot 能帮你重构」,没有走到「重构到什么程度才算能上生产」。
我在这一页停留了很久,因为它准确地暴露了这类书的共同处境:它们能教你把东西做出来,但教不了你把东西扛住。而「扛住」才是企业级三个字的全部含义。
六、第 21 章:智能体被压缩成 31 屏,还停在 2021 年
第 21 章叫「软件开发中的智能体」,31 屏,占 2.9%。这是全书最让我意外的一章,因为它和前面 20 章的写作水准有明显落差。
p1022 的 21.4 节「简单智能体」是这样开头的:「如前所述,更为简化的智能体专为特定任务设计。与它们的交互通常也很有限——要么使用关键词,要么表达方式受限。聊天机器人就是一个简单智能体的例子。聊天机器人的程序可以理解有限的一组关键词和短语。」
接着给出的对话示例是这样的——用户问「请介绍一下你们的产品」,智能体答「我们提供多样化的产品,包括电子产品、服装和配饰」;用户说「我对衣服感兴趣,适合当前天气的衣服」,智能体答「我当然可以给出关于衣服的建议,不过我不知道目前的天气状况」。
这个例子在 2021 年是准的,在 2024 年之后是过时的。现在的智能体不是「理解有限关键词的聊天机器人」,而是「能调用工具、能多轮规划、能在失败后重试的执行体」。一本讲 AI 驱动开发的书,把智能体定义成关键词匹配,等于把这一章的知识水位拉回了规则引擎时代。
更值得注意的是它的位置。第 21 章在全书倒数第二章,前面是 650 屏的机器学习习题。也就是说,读者的路径是:先花六成时间学怎么训模型,最后 31 屏才被告知「AI 还能自己调工具」。这个顺序在 2023 年是合理的,在今天是反的——现在更多人是从「我怎么让 AI 帮我干活」进入,再回头补模型原理。
我不认为这是作者水平问题。这更像是一本引进书的时差:原书成稿时智能体还不是主线,中文版出版时它已经成了主线,但结构没法重排,只能加一章、缩一章。于是 31 屏成了整本书里最尴尬的 31 屏——它不是写错了,是写早了。
七、它的短板
把上面散落的判断收一收,这本书的短板有四条,按严重程度排。
第一,书名与内容错位,且错得系统性。「企业级」不是某一章的疏漏,是全书没有对应物。22 章里没有一章讲权限模型、并发控制、部署拓扑、可观测性、成本核算、数据合规。这些不是「进阶话题」,它们是「企业级」这个词的定义本身。一本 1057 屏的书,如果真要挂这三个字,至少要有一章专门拆解「一个企业内部系统的非功能需求清单」。它没有。
第二,验证标准停在「跑通」。LIFE-E 的验收方式是「在 Colab 里运行每个步骤」,全书没有一次基线对照,没有一次误差分析,没有一次「这个结果为什么可信」的追问。这在教学书里可以接受,在挂着「实战」二字的书里是硬伤——因为实战里最贵的不是写出代码,是判断代码给出的数字能不能信。
第三,预处理有教科书式的偷懒。p0755 的 16.4.2 节做客户细分的预处理,代码里连着删了四列:StockCode、InvoiceDate、Description、Country。前三个删得合理,它们是交易明细的标识和时间戳,对「客户分群」这个目标来说是噪声。但 Country 不一样——国家是客户分群最有解释力的维度之一,英国客户和海外客户在客单价、复购、退货率上的行为差异,往往比 RFM 三个指标加起来还大。删它的真实原因是「聚类算法吃不了类别变量」,而正确的做法是编码(one-hot、target encoding)或者分层建模。书里对这件事一个字没提,直接 drop。
第四,最后一页才告诉你这本书会过期。p1052 的 22.4 节「写在最后」,全文只有四句话:「AI 的世界发展迅猛。昨天的完美工具和策略,几个月后可能就不再是最佳选择。因此,我们希望你能以本书为起点,不断关注最新的研究成果和见解。衷心希望本书对你有所帮助。」
这段话诚实得让人心疼,但它出现的位置是第 1052 屏。读者要翻完 1050 屏,才知道自己前面记住的那些界面、那些按钮、那些模型名,几个月后可能全部作废。如果这句话放在前言,并且配一张「哪些知识会过期、哪些不会」的分层表——比如「提示策略的分解思路不会过期,Copilot 的侧边栏按钮位置三个月就变」——这本书的价值会高一个档次。作者知道答案,但他把答案放在了最不容易被读到的地方。
还有一个小的、但会让读者卡住的问题:p0450 里 Colab 的数据集路径是 /content/My Drive/Chapter05/amazon_product_review_data.csv。Chapter05,第五章。但这个项目在中文版里是第 12 章。路径里保留的是原书章号,中文版没有任何一处说明这件事。读者按自己的章号去 Drive 里找 Chapter12,会找不到。这是引进书的通病,但通病不等于不用修。
八、给要买这本书的人
最合适:工作 1~3 年、想搞清楚「AI 到底能替我做哪几步」的开发者和数据新人。这本书真正的产品是那套提示策略:分解、排序、逐步验收、TAG 与 PIC 标记。这套东西不依赖具体工具,学会之后换成 Claude、换成 Cursor、换成任何一个新出的助手,都能用。第 2 章 37 屏加第 12 章的示范,值回书价。
次合适:需要带新人的技术负责人。书里第 4 到 10 章那条链路(页面 → 样式 → 行为 → 响应式 → 后端 API → 维护旧代码),是一条完整的新人训练路径。你可以直接把它当课程大纲用,让新人两周内走完,比让他自己摸索快得多。第 10 章那 56 屏尤其适合当「第一次改别人代码」的教材。
不合适:正在设计企业系统的人。如果你要找的是权限体系怎么设计、多租户怎么隔离、模型服务怎么扩缩容、推理成本怎么核算——这本书一页都没有。别被书名骗了,去读架构类的书。
也不合适:想学智能体的人。第 21 章 31 屏,讲的是关键词聊天机器人,和今天说的 agent 不是同一个东西。这一块去看专门的书,别在这本书里找。
还有一个判断标准,比前面几条都实用:如果你读完前言那句话时的心情是「1~3 年经验,说的就是我」,这本书值得买;如果你读到时的心情是「我早过了这个阶段」,这本书不值得。它的价值曲线在 3 年经验处见顶,之后迅速衰减。这不是缺点,是定位。技术书最怕的不是浅,是不承认自己浅——它在 p0022 承认了,只是被封面盖住了。
最后给一个读法建议:先读 p0022 的前言和 p1052 的「写在最后」,再回头读第 2 章。前言告诉你它想服务谁,最后一段告诉你它会过期,第 2 章告诉你什么是不会过期的。三处加起来不到 40 屏,读完你就知道这本书该给你什么、不该给你什么。剩下的 1000 屏,按需查。
一句话:它教会你怎么让 AI 替你写代码,但没教会你怎么让 AI 替你扛系统——前者省时间,后者才省钱。
抽样核对 12 屏:p0006 推荐序一(金融行业 AI 赋能与数字化转型) · p0022 前言(目标读者 1~3 年经验;第 4 章电子商务应用为贯穿全书主题;第 1~3 章导读) · p0032 第 1 章扉页 · p0050 2.3 如何有效提示(提示词为输入项;模糊则无法得到结果;分解问题/理解问题/识别各部分) · p0104 第 4 章扉页(HTML 与 Copilot 构建外观) · p0230 8.2 业务问题(逻辑域划分产品/订单/发票;库存需与业务分析师合作做预测) · p0450 12.6.1(pandas read_csv;Google Colab drive.mount;路径 Chapter05/amazon_product_review_data.csv;LIFE-E 评估提示策略) · p0492 12.7(TAG-T/TAG-A/PIC-P/PIC-C/PIC-I 提示词;分词、小写、去停用词标点、TF-IDF 与词嵌入) · p0755 16.4.2(dropna CustomerID;剔除 Quantity/UnitPrice 负值;删除 StockCode/InvoiceDate/Description/Country) · p1000 20.5 代码审查和优化技术(app.py/database.py/products.py 职责分离;sqlite3 products.db 三字段;「Copilot 不仅仅是一个代码生成器」) · p1022 21.4 简单智能体(聊天机器人理解有限关键词;简单智能体不是优秀的对话者) · p1052 22.4 写在最后(「几个月后可能就不再是最佳选择」)
说明:篇幅占比由 pages.jsonl 逐页章节映射聚合而得(前置 31 屏 2.9%;第 1–3 章 72 屏 6.8%;第 4–10 章 262 屏 24.8%,其中第 4–7 章 123 屏 11.6%;第 11–20 章 650 屏 61.5%;第 21 章 31 屏 2.9%;第 22 章 11 屏 1.0%;合计 1057 屏)· 抽样率 12/1057 ≈ 1.1% · 第 5、6、7、9、11、13、14、15、17、18、19 章仅按目录与篇幅核对,未逐字展开 · 笔记与图谱生成于 2026-11-10
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: