
生成式AI应用开发:值钱的是那 55 屏请求库,其余在等截图过期
微信读书《生成式 AI 应用开发:基于 OpenAI API 实现》· 抓取 782 屏 / 9 章 / 175 条目录 · 读到书尾
逐字核对 10 屏 · p0006 书名条核对为本书 · 2026-11-10
抽样点位的选法:这本书的九章是九个独立项目,每章都能单独交付,所以我按「一章一屏」取点,再从两处加密/安全相关的段落各加一屏——因为全书只有那一处涉及真实风险。抽读 10 屏约占 1.3%。篇幅占比不是抽样得出的,是用 pages.jsonl 逐页章节映射做的全量聚合。
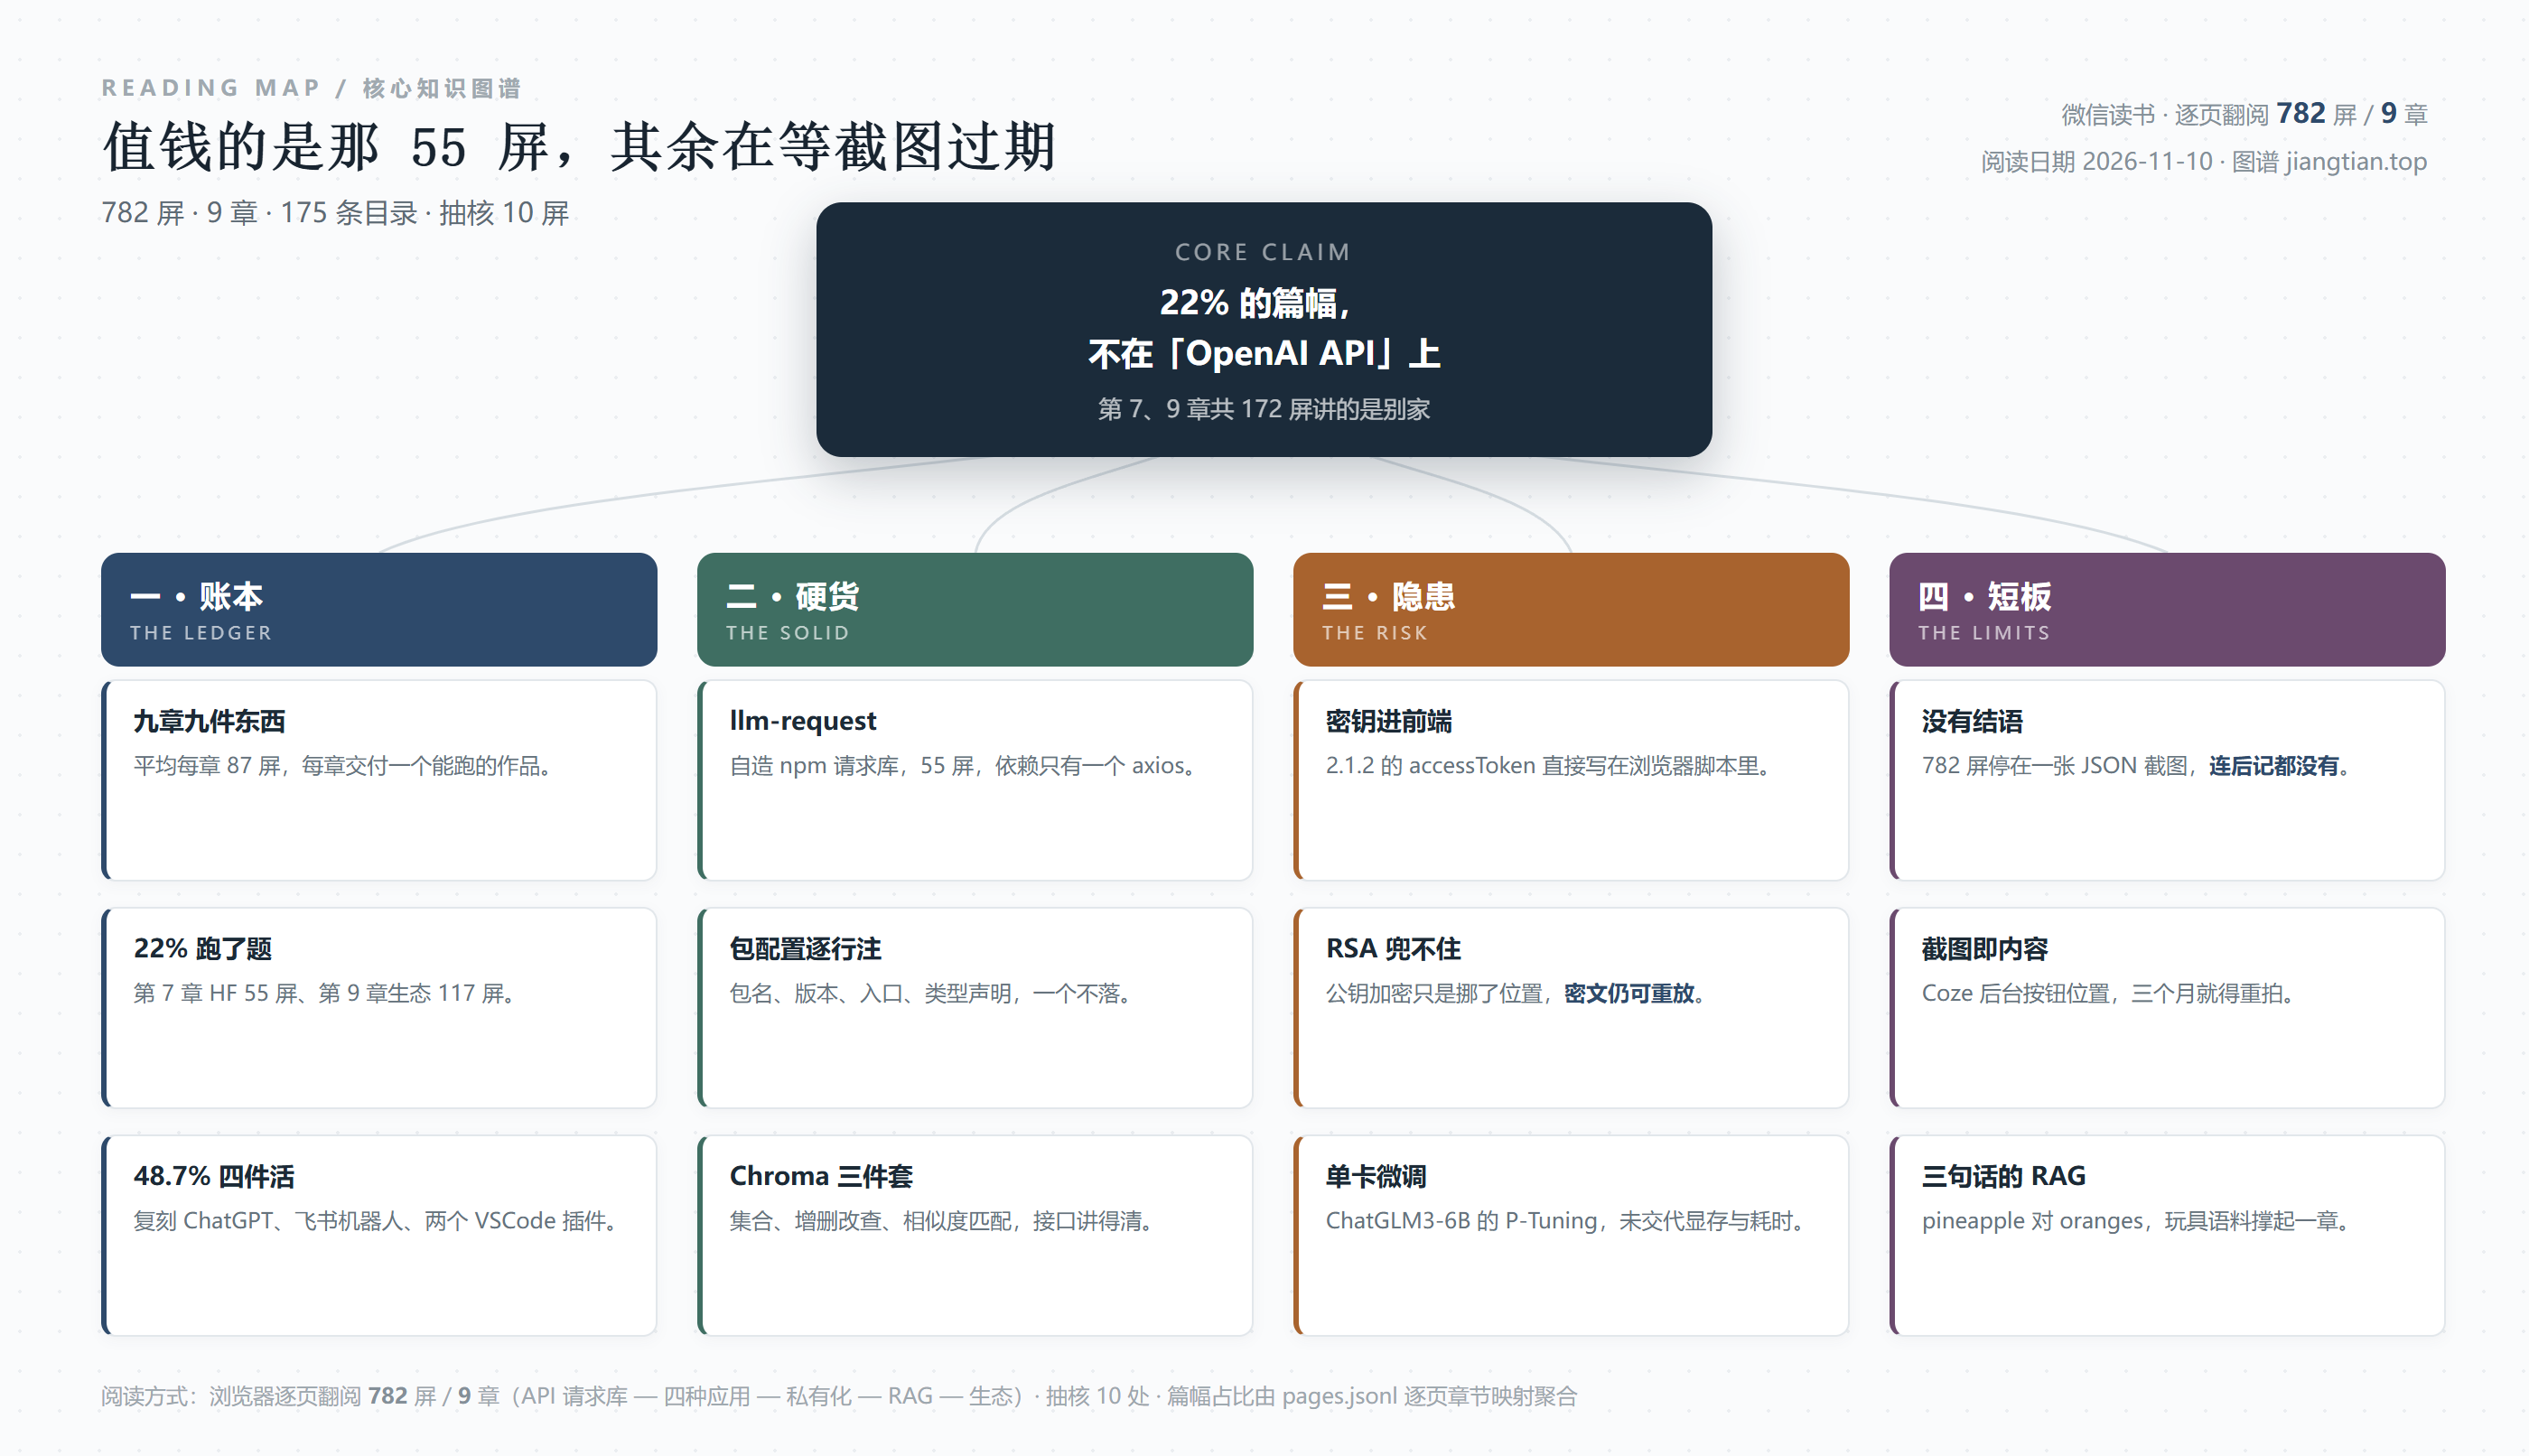
我先给结论:这是一本体例罕见的书——九章,九个能跑起来的东西,每章结束你手上都有一个可交付的产物,而不是一堆概念。这个体例值得所有技术书学。但它有一个更罕见的问题:价值分布和篇幅分布正好相反。全书最厚的第 9 章(117 屏,占 15.0%)讲的是 Coze 后台怎么点按钮,三个月后全部作废;而真正能陪你五年的第 2 章(99 屏,12.7%),恰恰是讲 API 端点参数和请求库封装的那一章,也是最不像「应用开发」的一章。
更准确地说,这本书最值钱的部分,是第 2 章里那个叫 2.3.2 的小节——「实战:封装并发布一个大语言模型 API 的请求库」,55 屏。全书 782 屏,这 55 屏是唯一一件你离开这本书之后还能继续用、还能发到 npm 上、还能在下一个项目里 import 的东西。剩下的 727 屏,一半是教学项目,一半是随时会过期的界面截图。
一、九章,九个能跑的东西
先把体例说清楚,因为这是这本书最大的优点,也是最容易被忽略的优点。
九章分别是:绪论;OpenAI API 请求库;基础应用——ChatGPT 的实现;交互应用——集成 AI 模型功能到飞书机器人;VSCode 自定义插件;编程应用——AI 编码辅助插件;Hugging Face 开源模型的私有化部署和微调;检索增强生成技术——向量化与大模型的结合;提示词工程与 LLM 社区生态。
782 屏、175 条目录、9 章,平均每章 87 屏。这个密度说明一件事:作者没有在概念上绕圈子。第 3 章讲怎么复刻一个 ChatGPT,第 4 章讲怎么把它接进飞书机器人,第 5 章讲怎么包成 VSCode 插件,第 6 章讲怎么让插件读你的代码库。四章连起来,是一条完整的「把模型接到人手上」的路径——从网页,到 IM,到 IDE。
p0006 的推荐序把这本书的野心写得很高。作序的是死月,《软件开发珠玑》的译者、字节跳动的技术专家、Node.js Collaborator,落款 2025 年 1 月于金塘。他引了作者前言里的一句话:「与其称 AI 为一个行业风口,笔者倒更想大胆地判断为第五次工业革命。」然后他补了一句自己的评价:这本书「仅介绍了如何使用生成式 AI,还深入分享了生成式 AI 应用开发的全过程,从 GPT 的发展历程到 OpenAI API 的实际应用,再到生成式 AI 应用的开发实例」。
「第五次工业革命」这个判断和「VSCode Webview 里注册一个空 HTML 模板」这个动作之间,隔着一段很长的距离。这不是说后者没价值——恰恰相反,能让人在一个下午做出一个能用的插件,比空谈革命有用一百倍。但这本书的自我定位和它的实际水位之间,确实存在一道缝。
我猜这道缝的来源是书名里的「应用开发」四个字。它其实是一本「应用集成」的书:教你把别人做好的模型,接到你自己的产品里去。这个能力非常实用,但它的天花板在第 6 章就到了——你能让 AI 读代码、能给建议,但你不能改模型本身。
还有一处体例上的小瑕疵值得记一笔。第 3 章 80 屏复刻 ChatGPT,前两节的标题是「ChatGPT 静态交互的实现」——也就是说,到第 150 屏(p0150),作者还在用写死的模拟数据渲染对话:一条「你好」,一条「你好!有什么我可以帮助你的吗?」,标题栏显示 ChatGPT 3.5,页面元素里保留着操作区域的骨架,注释写着「一些图标和充值操作的元素对主体功能不重要,这里不实现」。
这种写法本身没错,先搭壳再接电是标准做法。但它的代价是节奏:第 3 章用 80 屏讲一个「能看还不能用」的壳——HTML 结构、CSS 布局、事件绑定、富文本渲染,而真正的 API 调用在第 2 章 p0045 就已经出现过一次(那个可以直接在浏览器里跑的语音接口)。对性急的读者,这个前奏有点长;对耐心的读者,这段壳反而是最有用的——因为它能跑、能看、能改,而且改完就是你自己的产品。
二、篇幅账:22% 不在「OpenAI API」上
书名里有一个非常具体的限定词:基于 OpenAI API 实现。我把逐页章节映射聚合了一遍,看这个限定词兑现得怎么样:
前置(版权、作者简介、内容简介、推荐序、前言)10 屏,1.3%。
第 1 章 绪论 29 屏,3.7%。
第 2 章 OpenAI API 请求库 99 屏,12.7%。
第 3 章 基础应用:ChatGPT 的实现 80 屏,10.2%。
第 4 章 交互应用:飞书机器人 99 屏,12.7%。
第 5 章 VSCode 自定义插件 107 屏,13.7%。
第 6 章 编程应用:AI 编码辅助插件 95 屏,12.1%。
第 7 章 Hugging Face 私有化部署和微调 55 屏,7.0%。
第 8 章 检索增强生成 91 屏,11.6%。
第 9 章 提示词工程与 LLM 社区生态 117 屏,15.0%。
第 3 到第 6 章,381 屏,48.7%,是全书的主干——用 OpenAI API 做四件不同的事。这个部分和书名完全对得上,而且写得扎实。
但第 7 章和第 9 章加起来 172 屏,22.0%,讲的内容和 OpenAI API 没有关系。第 7 章讲的是把 ChatGLM3-6B 拉下来、单机单卡做 P-Tuning;第 9 章讲的是文心一言、Coze 这些国内平台,以及提示词工程的一般原理。
我不认为这是注水。这两章各有各的道理:第 7 章回应的是「不能上网、数据不能出门」的场景,第 9 章回应的是「国内用不了 OpenAI」的现实。对中文读者来说,这两章可能是最实用的部分。但书名承诺的是「基于 OpenAI API 实现」,而 22% 的篇幅在讲「不用 OpenAI 怎么办」。这不是错,是书名和内容打了一架,输的是书名。
真正让我在意的是另一个比例关系。全书最厚的两章是第 9 章(117 屏)和第 5 章(107 屏)。第 5 章讲 VSCode 插件,从项目初始化到 Webview 注册,代码扎实,这部分不容易过期——VSCode 的 API 相对稳定。但第 9 章 117 屏里,有大量篇幅是平台后台的界面截图:p0722 就是典型的一页,「9.3.2 基础使用」在教你点「创建 Bot」按钮,填写工作空间(个人空间)、Bot 名称(限制 20 字)、Bot 功能介绍(限制 500 字)。
这种内容的问题不在于写得不好,而在于它的保质期是三个月。Coze 的后台改一次版,这一章就得重拍。而同一本书里,第 2 章讲 chat 端点的参数、流的响应格式、请求库怎么封装——这些内容的保质期是五年以上。
一本书把 15.0% 的篇幅给了三个月的东西,把 12.7% 给了五年的东西,这不是作者的失误,是这一类书的共同困境:平台生态变化太快,写的时候是热点,印出来就成了档案。而书这种载体,没法打补丁。
三、那 55 屏:全书唯一能带走的产物
第 2 章「OpenAI API 请求库」99 屏,其中 2.3.2 节「实战:封装并发布一个大语言模型 API 的请求库」55 屏,占全书 7.0%。这是我最想单独拎出来讲的部分。
作者没有停在「用 fetch 调一下接口」,而是真的做了一个 npm 包,叫 llm-request。p0078 给出了完整的 package.json,而且每一行都有注释:
{
"name": "llm-request", // 项目的名称
"version": "1.0.0", // 项目的版本号
"description": "面向大语言模型的 Web 和 Node.js 端请求库", // 项目的描述
"main": "dist/index.js", // 项目的入口文件
"types": "dist/index.d.ts", // TypeScript 类型定义文件
"scripts": { "build": "tsc" }, // 使用 TypeScript 编译器进行编译
"dependencies": { "axios": "^1.6.0" },
"devDependencies": { "@types/axios": "^0.14.0", "typescript": "^5.4.2" }
}
这份配置的含金量在于三个字段:main 指向 dist/index.js,types 指向 dist/index.d.ts,scripts.build 用 tsc。这三个字段凑齐,意味着这个包既能被 JavaScript 项目用,也能让 TypeScript 项目拿到类型提示——这是「一个能发出去的包」和「一个自己玩玩的文件」的分界线。很多教程会教你写一个 request 函数,但很少会教你把它做成一个别人能 install 的东西。
p0078 还交代了一个细节:TypeScript 文件不能直接用 node 执行,所以要么用 ts-node,要么用 tsc 打包成 JS。作者选了后者,理由是「考虑到这是初始化阶段,可以先使用后一种方法,后续开发阶段会介绍第一种方式」。这句话很短,但它体现了一种难得的分寸感:先让它跑起来,再让它变得优雅。
我为什么说这 55 屏最值钱?因为它交付的不是知识,是资产。读完第 9 章,你得到的是「Coze 原来是这样点的」;读完 2.3.2,你得到的是一个可以 commit、可以 publish、可以在下个项目里 import 的库。前者是信息,后者是工具。信息会过期,工具会积累。
这也是这本书最该被学的地方:它没有把「调 API」当终点,而是当成了一个可以工程化的对象。把鉴权、重试、流式解析、错误码这几件事收进一个库,是所有 AI 应用团队迟早要做的事;这本书把它提前做了,还做给你看。
更值得注意的是它教了一件极少有书教的事:「把它发出去」本身是一个独立的技能。写一个能跑的 request 函数,和发布一个别人敢 install 的包,中间隔着版本号语义、类型声明、构建产物目录、README 里的最小示例。这些东西不影响功能,但决定别人愿不愿意用。作者愿意花 55 屏在一个「不影响功能」的环节上,说明他知道工程能力和演示能力的差别在哪。
我唯一的遗憾是它没有走完最后一步:没有讲怎么在 npm 上 publish、没有讲怎么设 files 字段控制发布内容、没有讲破坏性变更该怎么升大版本。55 屏停在「能 build 出一个 dist」,离「能被别人依赖」还差一屏。但就这一屏的差距,已经把这本书和 90% 的 AI 教程分开了。
四、它最危险的一页:把密钥放进浏览器
现在说这本书最需要被批评的一页,p0045,2.1.2 节「在浏览器端实现文本转音频」。
这一页给出的代码是这样的:在 HTML 里写一段 script,用 fetch 调 https://api.openai.com/v1/audio/speech,请求头里放 Authorization: Bearer ${accessToken},请求体里指定 model: "tts-1"、voice: "alloy"、input 是待转换的文本。而在脚本最上面,赫然写着一行:
const accessToken = ''; // 换成你的 API_KEY,用于身份验证
这行代码的意思是:把你的 OpenAI 密钥,写进一个会被下载到任何访客浏览器里的 JavaScript 文件。
这是 AI 应用开发里最经典、也最贵的一个错误。前端代码对用户是完全透明的,任何人按 F12 就能看到你的 key;一个爬虫扫一遍公开的页面,就能拿走它。密钥一旦泄漏,账单是你的,额度是别人的。在 OpenAI 的用量面板上,这种盗刷通常表现为凌晨三点突然出现的大量 tts 或 chat 调用。
我要为作者说一句公道话:这一节的教学目的是「让你看到浏览器也能直接调 API」,用一个空字符串占位、让读者自己填,形式上没有把 key 硬编码进书里。而且他在第 3 章 3.3.5 确实回头处理了这个问题,标题就叫「思考题:如何避免在请求中暴露 API_KEY」——说明他知道这是个问题。
但问题在于顺序和命名。「如何避免在请求中暴露 API_KEY」被写成了一个「思考题」,而不是一条「禁止事项」,而且还被放在 200 屏之后。一个照着 2.1.2 敲代码、跑通就去接下一个项目的读者,很可能根本走不到 3.3.5。技术书里,安全约束如果不能前置成一句「不要这样做」,那它就只是一段可读可不读的补充材料。
正确的写法其实只要一句话:密钥只能存在于服务端;浏览器要么调你自己的后端代理,要么用一个短期、限域、可撤销的临时凭证。这句话应该在 2.1.2 的代码块上方,用加粗写。
五、用 RSA 解一个不该存在的问题
更值得讨论的是 3.3.5 给出的答案。p0200 写道:
中间层的 BFF 进行中转,鉴权的方式由 API_KEY 替换为使用一些加密方式,就可以避免直接暴露 API_KEY。……因为公钥不具备解密功能,而是作为私钥「键-值对」(Key-Value Pair)中的键,所以即使暴露了公钥,也无法直接解密得到 API_KEY。
思路是:客户端用公钥加密 API_KEY,发到 BFF(Backend for Frontend)中间层,中间层用私钥解开,再拿明文 key 去调 OpenAI。页面给了一个时序图,链路上依次是 User、ChatGPT、BFF、数据库、OpenAI API。
这个方案的问题在于,它解决的不是真正的问题,而是把问题挪了个位置。
第一,BFF 已经存在了。既然有一个中间层能拿私钥解密、能转发请求,那它本来就可以直接持有 key 并代你调用 OpenAI——加密这一步是多余的。用 RSA 加密一个 key 再让中间层解开,等价于把信封封好交给门卫,而门卫本来就有钥匙。真正的解法是「前端不接触 key」,而 RSA 方案的前提仍然是「前端持有 key」,只是换了一种形态。
第二,加密不能防重放。攻击者拿不到明文 key,但他可以把你页面里的加密逻辑原样跑一遍,生成一个合法密文,然后无限次调用你的 BFF。从 BFF 的角度看,这是一次完全合法的请求;从你的账单看,这是被盗刷。密钥保护变成了接口滥用,问题没消失,只是换了个名字。
第三,也是最重要的:这段内容被放进了「思考题」的答案里。思考题的题干是「如何避免在请求中暴露 API_KEY」,而答案给了一个「暴露的是密文不是明文」的方案。这在教学上是危险的,因为它会让读者以为「加密过的 key」等于「安全的 key」。实际上,任何长期有效的凭证只要出现在客户端,就已经不安全了,加密只是把风险从「明文泄漏」变成「可滥用」。
我知道作者为什么这么写。RSA + BFF 是一个「看起来很有技术含量」的答案,写进书里比「别把 key 放前端」这句话体面得多。但技术写作最难的从来不是给复杂答案,是敢给简单答案。「密钥不上前端,前端只调自己的后端」这十四个字,比一整页 RSA 时序图有用。
如果一定要在浏览器端保留一点「像样的安全」,正确的方向也不是加密 key,而是缩短凭证的寿命和范围:后端签发一个只对某个接口、只对某个用户、十分钟内有效的一次性令牌,前端拿着它去换一次调用。这样即使令牌被抄走,攻击者拿到的是一个十分钟后就失效、且只能用一次的字符串,损失可控、可审计、可追溯。加密解决的是「别人能不能读」,令牌解决的是「别人能不能用」——在密钥这件事上,后者才是真问题。
六、第 7 章:ChatGLM3-6B 为什么会出现在这本书里
第 7 章「Hugging Face 开源模型的私有化部署和微调」55 屏,7.0%。p0540 展示了这一章的实操部分:拉代码、装依赖、下载训练集、跑 P-Tuning。
依赖清单写得挺具体:jieba>=0.42.1、ruamel.yaml>=0.18.6、rouge_chinese>=1.0.3、jupyter>=1.0.0、datasets>=2.18.0、peft>=0.10.0,另外还要 pip install nltk 做文本预处理。训练集是官方给的一组衣服广告数据,dev.json 和 train.json,「包含十几万样本数据的对话」,字段 content 是衣服的关键词,summary 是对应的预期广告语。目标是让模型具备「衣服关键词 → 广告文案」的映射能力。
这个案例选得聪明:垂直、可验证、有明确输入输出。它是全书唯一一个「你真的可以拿去改成自己业务」的模型微调示例。
但它有两个明显的信息缺口。
第一,没有显存数字。ChatGLM3-6B,6B 参数,P-Tuning v2 冻结主干只训 prefix,理论上单卡 24G 能跑。但「理论上」和「实际上」之间差着 batch size、序列长度、梯度累积、精度(fp16 还是 int8)。书里写「单机单卡」,却始终没说这张卡是多少 G、显存峰值是多少、一次 epoch 多久。读者读完不知道自己那张 4090 到底能不能跑——而这恰恰是决定「要不要走这条路」的唯一问题。
第二,和书名的主线脱节。这一章讲的东西和 OpenAI API 没有任何关系,甚至和「应用开发」也有些距离——它是模型训练。作者没有为这次跳转做任何铺垫:前一章还在写 VSCode 插件,这一章突然开始装 CUDA 环境。读者会在第 520 屏感到困惑:我是不是翻错书了?
我觉得合理的解释是:这一章是为了回应一个真实的读者痛点——很多公司的数据不能出内网。这个需求是真的,案例也是对的,但正确的做法是在第 1 章就交代「本书有两条路线:调 API,和私有化部署」,让读者一开始就知道第 7 章的存在。现在它像一段插叙,插入的位置还很突然。
七、它的短板
按严重程度排四条。
第一,安全约束的优先级排错了。把 key 放前端(p0045)出现在第 45 屏,而「如何避免暴露 key」的讨论出现在第 200 屏,且是「思考题」。这个顺序会让相当一部分读者带着一个危险的习惯离开这本书。安全不是进阶话题,它是第 45 屏就该说清的准入条件。而 3.3.5 给出的 RSA 方案,本质上是用复杂度掩盖了「前端不该持有长期凭证」这个根因。
第二,最厚的一章最不耐用。第 9 章 117 屏,15.0%,大量内容是平台后台截图:Coze 怎么创建 Bot、怎么填名称和功能介绍、怎么配工作流。这些截图的价值随平台改版归零。而同一本书里,讲端点参数、流式响应、请求库封装的第 2 章 99 屏,是唯一能撑五年的部分。书这个载体没法打补丁,作者本可以把第 9 章的篇幅压下来,把省下的屏数投给第 2 章和第 8 章。
第三,RAG 那一章的知识密度和它的篇幅不匹配。第 8 章 91 屏,11.6%,是全书第四厚的章。但 p0600 展示的检索示例,语料是三句话:「This is a document about pineapple」「This is a document about oranges」,查询是「This is a query document about hawaii」,返回最近的 pineapple,距离 1.04806。这个例子能说明「向量相似度检索是什么」,但说明不了「RAG 怎么做对」。真正的 RAG 难点在于分块策略(切多长、要不要重叠、按语义还是按段落)、嵌入模型选型(不同模型对中文的召回差异可能高达一倍)、召回评估(怎么知道该召回的那条被召回了)。这三件事在 91 屏里没有系统展开。玩具语料撑不起一章。
第四,它没有结语。这是我在读完整本书后最意外的一点。p0780 是全书最后一屏,内容是「图 9-84 资讯助手流式调用的部分结果」——一张终端截图,里面是 Coze API 返回的腾讯体育和新浪体育的资讯条目,时间戳、标题、概述。然后,书就结束了。
没有「写在最后」,没有「下一步该学什么」,没有「这本书哪些内容会过期」。782 屏之后,读者被留在一张 JSON 返回值的截图前面。对比同类的引进书,哪怕只有四句话的收尾(「AI 的世界发展迅猛,昨天的完美工具和策略几个月后可能就不再是最佳选择」),也比没有强——至少它提醒了你该带走什么。
这本书缺的不是内容,是告别。而告别恰恰是技术书最有价值的部分之一:它告诉读者,哪些东西你已经拿到了,哪些东西得自己去找。
八、给要买这本书的人
最合适:会写 JavaScript 或 TypeScript、想把 AI 接进自己产品的前端和全栈工程师。这本书的技术栈从头到尾是 JS/TS:浏览器 fetch、Node.js、VSCode 插件、飞书机器人。如果你本来就是写前端的,读它会非常顺——它几乎是照着你的技能树写的。第 2 章的 llm-request 和第 5 章的 VSCode 插件,两处加起来 162 屏,足够让你在自己的产品里做出一个能用的 AI 功能。
次合适:需要给团队搭一个「AI 能力接入层」的技术负责人。你可以直接拿第 2 章那 55 屏当设计参考:请求库该封哪几层、类型声明放哪、错误怎么处理、流式怎么解析。这不是一本架构书,但它给了一个足够小的、可以照着改的样板。
要当心的地方:安全那一章。如果你团队里有人照着 p0045 的写法把 key 放到前端,一定要拦住。正确的做法只有一条:前端永远不持有长期凭证,所有模型调用走你自己的服务端。书里 3.3.5 的 RSA 方案可以作为理解「公钥加密能做什么」的练习题,但不能当生产方案用。
不合适:想深入 RAG 或模型微调的人。第 8 章 91 屏、第 7 章 55 屏,都是「带你跑通一次」,不是「教你调好」。
读法建议:按第 2 章 → 第 5 章 → 第 6 章 → 第 3 章的顺序读,先拿到那个请求库,再做插件,再回头补最基础的 ChatGPT 复刻。第 9 章可以只翻目录,遇到具体平台再回来查。第 7 章和第 8 章当作「知道有这么条路」的索引,真要动手时去查官方文档,比看书快。
一句话:它把「接一个模型」讲成了一门手艺,却没告诉你这门手艺里有一处会让账单失控的坑——手艺可以学,坑得自己躲。
抽样核对 10 屏:p0006 推荐序(死月作序,《软件开发珠玑》译者、字节跳动技术专家、Node.js Collaborator,2025 年 1 月于金塘;引前言「第五次工业革命」判断) · p0045 2.1.2 浏览器端文本转音频(api.openai.com/v1/audio/speech;model tts-1;voice alloy;const accessToken 写在客户端脚本) · p0078 2.3.2 请求库(package.json:name llm-request;version 1.0.0;main dist/index.js;types dist/index.d.ts;build tsc;axios ^1.6.0;typescript ^5.4.2;tsc 打包说明) · p0150 第 3 章静态交互(模拟对话数据「你好」/「你好!有什么我可以帮助你的吗?」;聊天区标题 ChatGPT 3.5) · p0200 3.3.5 思考题答案(BFF 中间层中转;RSA 公钥加密;「即使暴露了公钥,也无法直接解密得到 API_KEY」;User→ChatGPT→BFF→数据库→OpenAI API 时序图) · p0430 第 6 章(VSCode WebviewViewProvider;resolveWebviewView;注册空 HTML 模板) · p0540 第 7 章(requirements:jieba/ruamel.yaml/rouge_chinese/jupyter/datasets/peft;pip install nltk;dev.json 与 train.json 十几万条;衣服关键词→广告语) · p0600 第 8 章(Chroma 三句话语料 pineapple/oranges;查询 hawaii;距离 1.04806;8.3.3 集合 API) · p0722 9.3.2 Coze 基础使用(创建 Bot 截图:工作空间个人空间、Bot 名称限 20 字、功能介绍限 500 字) · p0780 全书末页(图 9-84 资讯助手流式调用结果:腾讯体育/新浪体育资讯,无结语)
说明:篇幅占比由 pages.jsonl 逐页章节映射聚合而得(前置 10 屏 1.3%;第 1 章 29 屏 3.7%;第 2 章 99 屏 12.7%,其中 2.3.2 为 55 屏 7.0%;第 3 章 80 屏 10.2%;第 4 章 99 屏 12.7%;第 5 章 107 屏 13.7%;第 6 章 95 屏 12.1%;第 7 章 55 屏 7.0%;第 8 章 91 屏 11.6%;第 9 章 117 屏 15.0%;合计 782 屏。第 3–6 章合计 381 屏 48.7%;第 7 与第 9 章合计 172 屏 22.0%)· 抽样率 10/782 ≈ 1.3% · 第 1、4、5 章部分小节仅按目录与篇幅核对,未逐字展开 · 笔记与图谱生成于 2026-11-10
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: