
生成式人工智能基础:15 章每章一样厚,等于没有重点
微信读书《生成式人工智能基础》· 抓取 787 屏 / 15 章 / 278 条目录 · 读到书尾
逐字核对 9 屏 · p0006 书名条核对为本书 · 2026-11-10
抽样点位的选法:这本书十五章是「基础—AIGC—大模型—提示—文本—图像—音频—多模态—五个行业—伦理—AGI」一条线,我按「前八章取五屏、行业与伦理章取两屏、首尾各取一屏」布点,重点压在两个地方:一是前言里的教学进度表(它决定了全书的形状),二是每章末尾的作业(它暴露了内容与题目的关系)。抽读 9 屏约占 1.1%。章节篇幅占比不是抽样得出的,是用 pages.jsonl 逐页章节映射做的全量聚合。
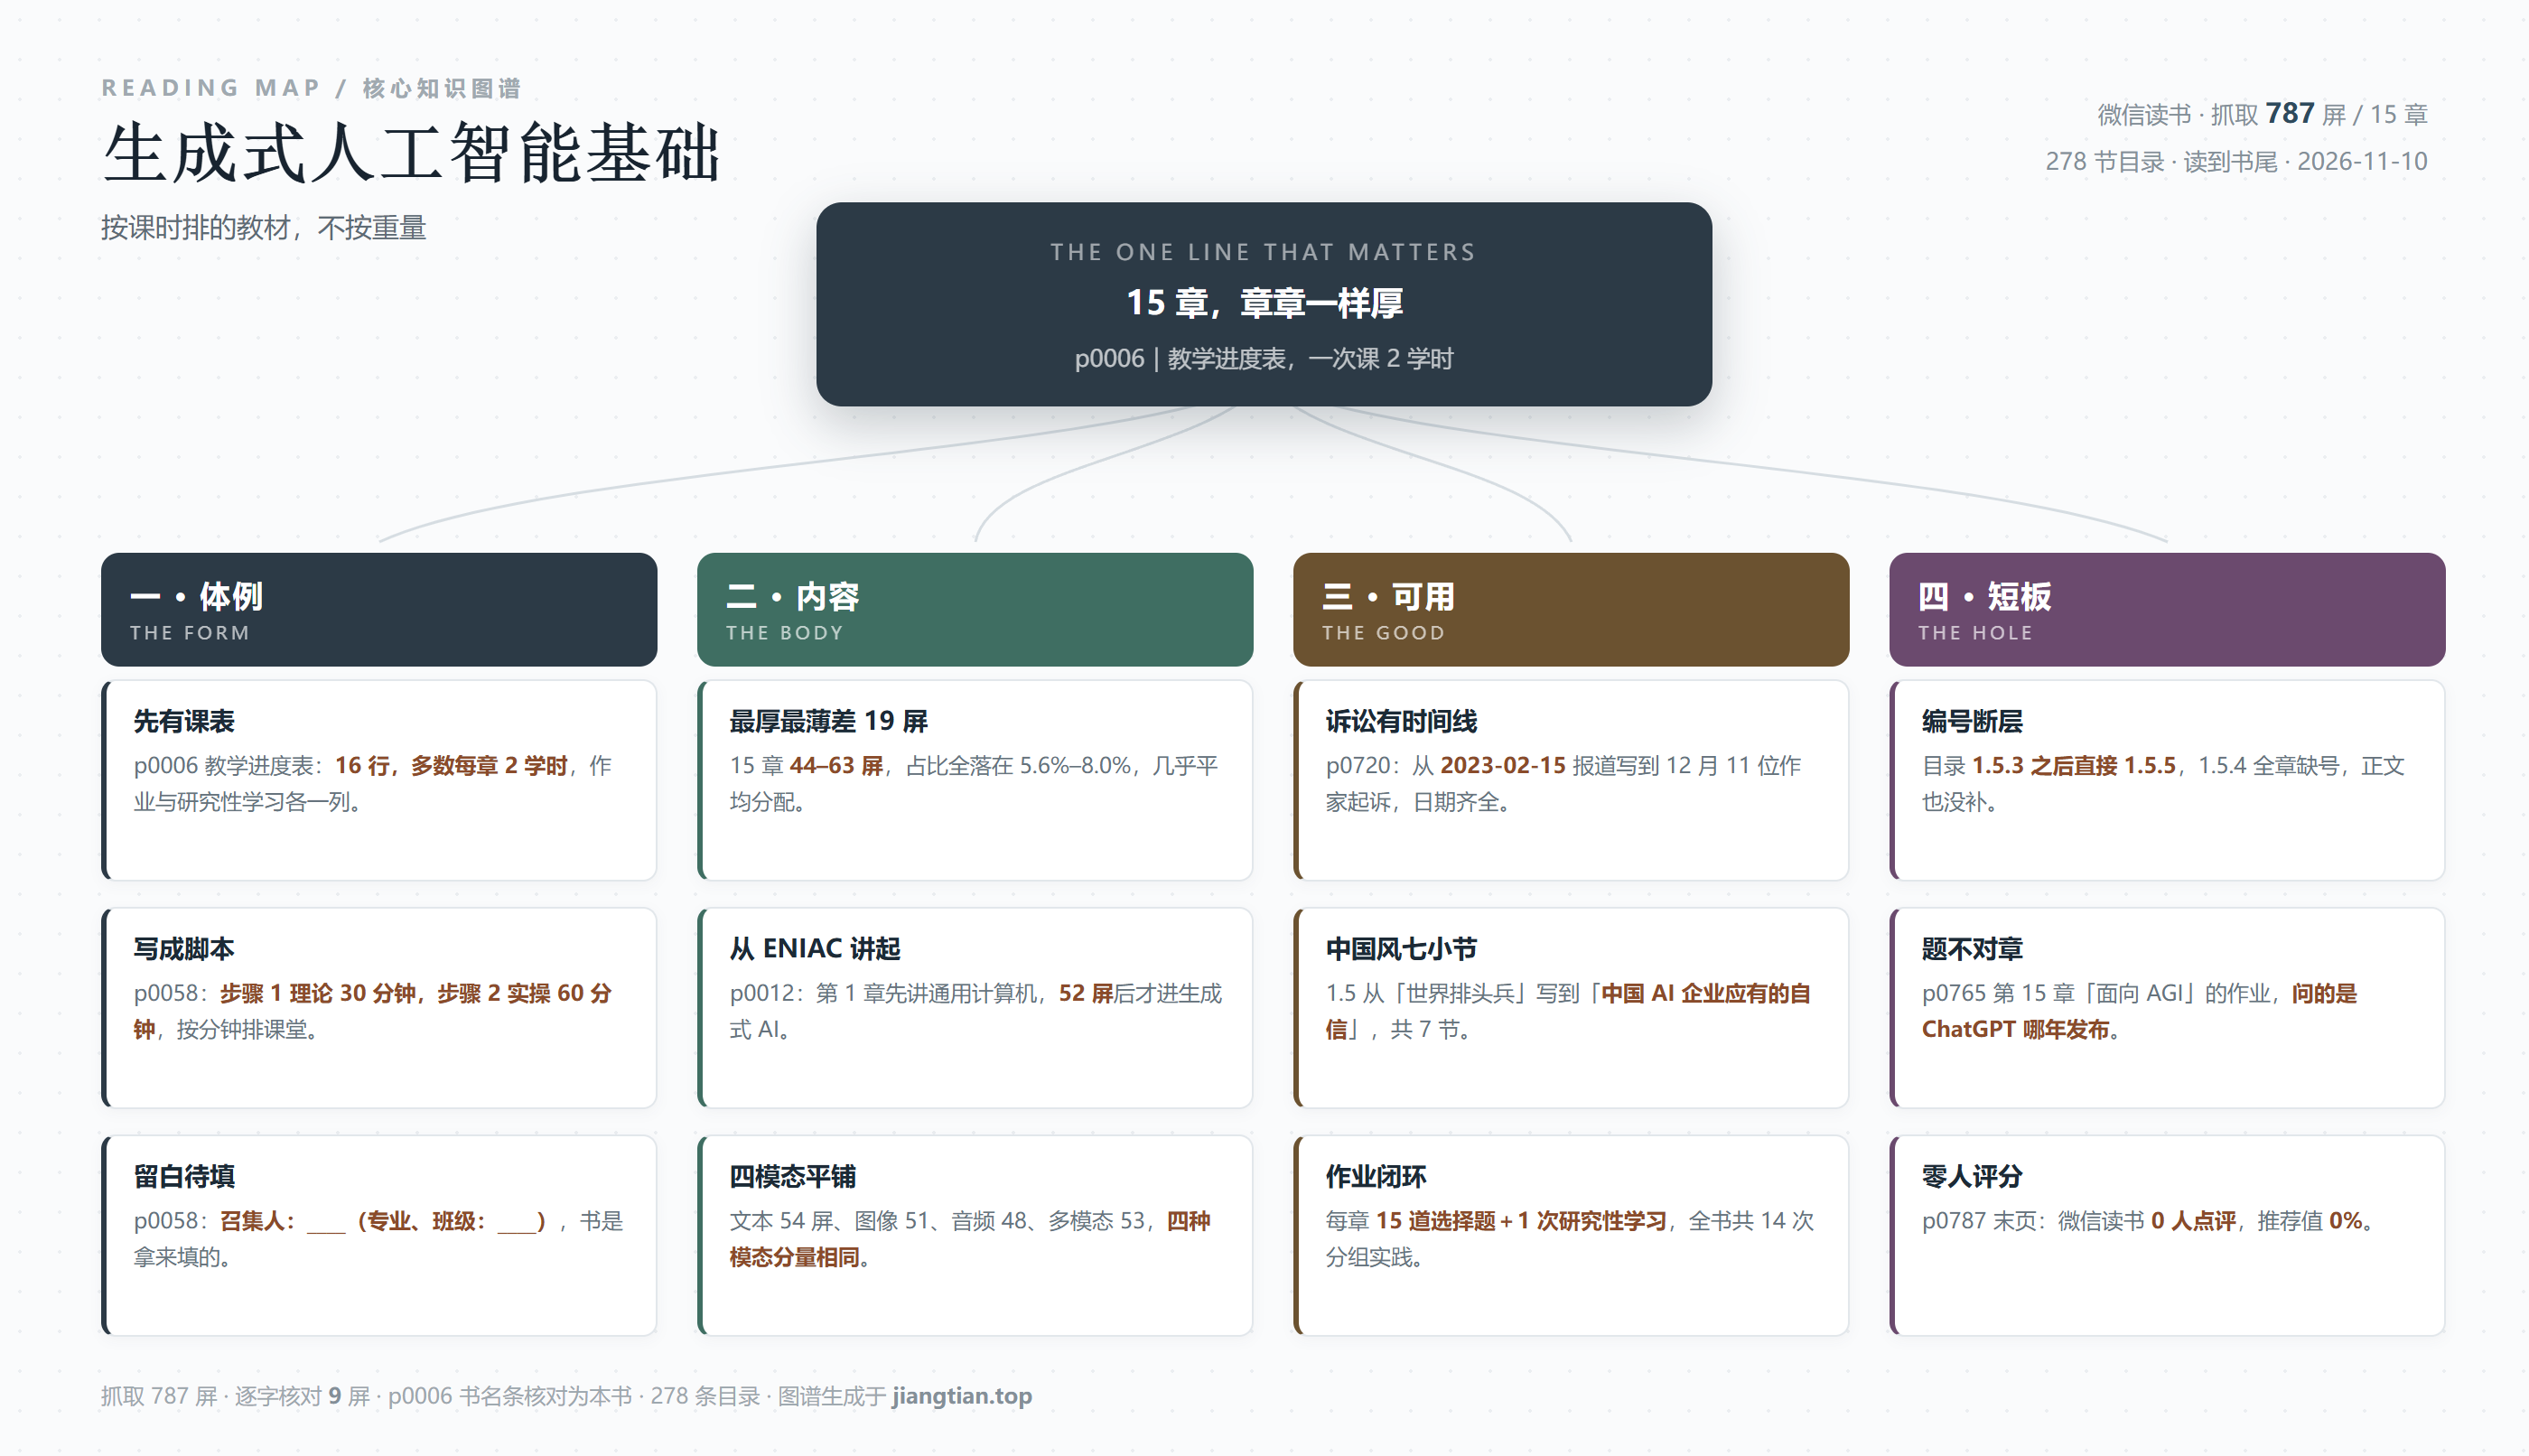
我先给结论:这不是一本让你读懂生成式 AI 的书,是一本让老师上完十六次课的书。它把 787 屏非常均匀地分给了 15 章,每章 44 到 63 屏,最多和最少只差 19 屏——均匀到「提示工程」和「伦理与法律」在这本书里几乎等重(51 屏对 44 屏)。作为课程包,这个设计是合格的;作为读物,它等于告诉读者「什么都要紧」,也就是「什么都不要紧」。
这个判断不是我读出来的,是它自己写在 p0006 上的。那一页是「教学进度表」:16 行,每行一章或一次实践,多数标着「2 学时」,右侧两列是「研究性学习」和「作业」,表格底下是「填表人(签字):__」「系(教研室)主任(签字):__」「日期:__」。再下面紧接着「本课程的教学评测可以从以下几个方面入手,即:(1)每章的课后作业(15 项);(2)每章的『研究性学习』实践(14 项);(3)第 15 章的『课程学习与实践总结』;(4)学生针对每章内容写下的阅读笔记(建议);(5)平时考勤情况。」
看到「平时考勤情况」和「阅读笔记」并列出现在一本书的开头,你就该知道它是什么了。这是一份课程大纲,装订成了一本书。它的第一读者不是买书的人,是排课的教务处。
一、先看课表:这本书是按分钟写的
p0058 是第 1 章【研究性学习】那一页,把这本书的写作方式暴露得最彻底。它把一次课堂活动拆成了分钟:
「步骤 1:理论学习(30 分钟)。」(1)回顾课堂内容:简要回顾本章所学的 AI 和机器学习/深度学习基础知识,包括 AI 定义、机器学习主要类型(监督学习、无监督学习、强化学习)以及深度学习基本概念。(2)案例分析:选择一个具体的 AI 应用案例(如智能推荐系统、信用评分系统等),详细讲解其技术实现和实际效果。
「步骤 2:实践操作(60 分钟)。」(1)分组实践:「研究性学习」活动需要通过学习小组,以集体形式开展。为此,请你邀请或接受其他同学的邀请。研究性学习小组成员以 3 到 5 人为宜。你们的小组成员是:召集人:____(专业、班级:____)。
这一段是全书的说明书。它告诉你三件事:这本书假定有老师、假定有课堂、假定有 3 到 5 人的小组,还假定你会拿笔在书上填名字。一本书如果假设你在教室里读它,它就不可能同时在你的床头读得下去——因为课堂需要节奏均匀,而阅读需要轻重缓急。
我不认为这是缺点。教材就该这么写,一门 32 学时的课,你不能给第 3 章排 8 学时、第 14 章排 1 学时,那样期末考纲都对不上。但读者得分清自己在读什么:你手上这本不是「生成式 AI 入门」,是「生成式 AI 入门课程」。两者的差别,就是「一章 60 屏」和「一章 20 屏」的差别。
二、篇幅账:最厚 63 屏,最薄 44 屏
把 pages.jsonl 的逐页章节映射聚合出来,787 屏的分配是这样的:
前置 8 屏 1.0%;第 1 章 人工智能基础 52 屏 6.6%;第 2 章 生成式 AI 与 AIGC 55 屏 7.0%;第 3 章 大语言模型技术 63 屏 8.0%;第 4 章 提示工程与技巧 51 屏 6.5%;第 5 章 文本生成技术 54 屏 6.9%;第 6 章 图像生成技术 51 屏 6.5%;第 7 章 音频生成技术 48 屏 6.1%;第 8 章 多模态生成技术 53 屏 6.7%;第 9 章 AIGC 促进文化创意 57 屏 7.2%;第 10 章 AIGC 改善医疗健康 44 屏 5.6%;第 11 章 AIGC 造就智慧城市 55 屏 7.0%;第 12 章 AIGC 提升金融服务 50 屏 6.4%;第 13 章 AIGC 提高科研水平 54 屏 6.9%;第 14 章 伦理与法律考量 44 屏 5.6%;第 15 章 面向 AGI 48 屏 6.1%。
这组数字的整齐程度,在我读过的五十多本同类书里是独一份。15 章,占比全部落在 5.6% 到 8.0% 之间,标准差小到几乎可以用一句话概括:每章五十屏上下,谁也不许多,谁也不少。
四个模态的分量几乎一样:文本 54 屏、图像 51 屏、音频 48 屏、多模态 53 屏。五个行业章也一样:文化创意 57、医疗 44、智慧城市 55、金融 50、科研 54。这种「平均」显然不是自然形成的,是排课表排出来的——每个话题 2 学时,2 学时就是 50 屏左右,于是所有话题都被压成了同一个厚度。
我得说清楚:均匀本身不是罪。教科书要覆盖考纲,就得均匀。但均匀有一个代价,而这个代价在 p0006 那张表上写得明明白白:当每一章都值 2 学时,读者就没有任何依据判断哪一章值得他多花一个周末。一本 787 页的书,读完你还是不知道「如果我只想搞懂一件事,该看哪一章」——因为书本身拒绝回答这个问题。
278 条目录,15 章,平均每章 18.5 节。这个数字比篇幅更能说明问题:目录也是按课时切的。每一节大约三屏,正好是课堂上讲七八分钟的量。所以你翻开目录看到的不是「知识的层级」,而是「进度的刻度」——小节标题之间的粗细几乎一样,没有哪一节被写成「这一节最难,请慢一点」,也没有哪一节被标成「可以跳过」。教材的目录天生如此,但读者拿它当导航时会迷路:一份没有海拔标记的地图,走起来是要摔跤的。
三、均匀的代价:提示工程和伦理,一样重
把这个逻辑推到极端,就会出现这样一组对照:
第 4 章「提示工程与技巧」51 屏。第 14 章「伦理与法律考量」44 屏。
差 7 屏。
我的判断很直接:对一个 2024 年之后要动手用生成式 AI 的人来说,这两件事的重量不可能是 51 比 44。提示工程是你每天都要用的手艺,伦理与法律是你在特定场景才需要翻的红线。把它们压成同一个厚度,等于把「怎么用」和「别怎么用」放在同一张秤上——这在课堂里成立(两章都是 2 学时),在读者手里不成立。
同样的失衡还有几处。第 1 章 52 屏,其中一大段是从 ENIAC 讲起的计算机史:p0012 的图 1-1 是「世界上第一台通用电子数字计算机 ENIAC」,正文在用烤面包机打比方解释「通用计算机」——「普通的烤面包机本来并不需要计算机,但比起采用一堆乱七八糟的组件,只用一个简单的部分就可以实现所有功能还是比较划算的」。这个比喻挺可爱,写得也清楚;但它是 1946 年的事。一本讲生成式 AI 的书,用 52 屏讲基础,其中相当一部分在讲七十年前的机器,而全书的第 3 章「大语言模型技术」只有 63 屏。
这就是均匀的代价:它不允许任何一章「薄」,于是每一章都得从盘古开天讲起;而真正需要厚度的地方(大模型、提示、多模态),也只能拿到 50 屏。
四、它最值钱的一段:那条精确到天的诉讼时间线
说完结构,得说这本书真正写对了的地方——而且它确实有一处写得比大多数同类书都硬。
p0720,第 14 章伦理与法律,标题是「ChatGPT 屡屡惹官司」。这一页不空谈原则,它给的是日期、当事人、法院、诉求:
「2023 年 2 月 15 日,《华尔街日报》记者弗朗西斯科·马可尼公开指控 OpenAI 公司未经授权大量使用路透社、《纽约时报》《卫报》、BBC 等媒体的文章来训练 ChatGPT 模型,但从未支付任何费用。」
「2023 年 6 月 28 日,第一起具有代表性的 ChatGPT 版权侵权之诉出现在公众视野。两名畅销书作家保罗·特伦布莱和莫娜·阿瓦德在美国加州北区法院,向 OpenAI 提起集体诉讼……同月 16 名匿名人士向美国加利福尼亚旧金山联邦法院提起诉讼,指控 ChatGPT 在没有充分通知用户,或获得同意的情况下,收集、存储、跟踪、共享和披露了他们的个人信息。他们称受害者可能多达数百万人,据此要求微软和 OpenAI 赔偿 30 亿美元。」
「2023 年 7 月 10 日,美国喜剧演员和作家莎拉·希尔弗曼以及另外两名作家理查德·卡德雷、克里斯托弗·戈尔登在加州北区法院起诉 OpenAI……同年 9 月 19 日,美国作家协会以及包括《权力的游戏》原著作者乔治·R·R·马丁在内的 17 位美国著名作家向美国纽约联邦法院提起诉讼,指控 OpenAI『大规模、系统性地盗窃』……同年 12 月,包括多名普利策奖得主在内的 11 位美国作家,在曼哈顿联邦法院起诉 OpenAI 和微软滥用自己作品来训练 LLM。」
这一段是我在整本书里读到的最可信的 5 屏。理由很简单:它可核查。日期、法院、人数、索赔金额,全是外部世界可以对账的东西,不是作者的观点。而且它没有停在「AI 有版权风险」这种正确而无用的话上,它把风险的形状描出来了:先是媒体报道,再是作家集体诉讼,再是个人信息,再是行业协会,再是普利策得主——一条清晰的升级路径。
同类的好料还有第 1 章 1.5 节「人工智能发展中的『中国风』」,7 个小节,从「世界 AI 发展的排头兵」写到「AI 领域的『东方神秘力量』」,再到「基于量化『幻方』的深度求索」、「游戏科学与《黑神话:悟空》」、「全球最大可交互三维能力的群核科技」,最后落到「中国 AI 企业应有的自信」。这是选材上的主动,不是凑数——把 DeepSeek 的算力出身、把游戏引擎和三维内容生成写进基础教材,比再抄一遍 Transformer 结构图有用。一本教材愿意为中国读者单独开一节讲「我们在这条链上的位置」,这是加分项。
五、它最薄的一环:全都在讲「是什么」
这本书的叙述方式高度统一,统一到你可以从任意一页认出它:给一个概念,给一组分类,给一份流程,然后用「(1)(2)(3)」列出来。
p0135 讲 GAN 的演进:③「不使用 sigmoid 和交叉熵损失:与传统 GAN 不同,WGAN 不再使用 sigmoid 激活函数和二元交叉熵损失,而是直接优化推土机距离」;④「改进版本 WGAN-GP:通过引入梯度惩罚替代简单的权重裁剪」;(3)「样式 GAN」,下面四点——分层感知控制、映射网络、自适应实例规范化(AdaIN)、渐进式增长架构;(4)「周期(Cycle)GAN:广泛应用于风格迁移、彩色化黑白照片、季节变换等图像……」
信息是对的,分类是清楚的,但它是一张「有哪些」的清单,不是一张「什么时候用哪个」的判据表。读者读完知道 WGAN-GP 比 WGAN 稳,却不知道自己的项目该选谁、训练不稳的时候该改哪里。
p0300 讲图像风格迁移的「基本原理」,也是同一个路子:「图像风格迁移通常利用卷积神经网络(CNN)提取内容图像的高级特征和风格图像的纹理特征,并在其中找到平衡以创造视觉上和谐的结果。」然后三个概念:内容图像「提供主要形状和对象布局」、风格图像「提供视觉风格(如色彩、纹理、笔触等)的参考」、目标图像「最终生成的图像保留了内容图像的主要结构,但采用风格图像的美学特征」。
这段定义写得很干净,但它讲的是 2015 年那套 Gatys 方法。而同一本书的第 1 章已经在讲 2024 年爆火的 DeepSeek。一本书里,技术叙事的年份横跨近十年,却没有任何一句提示读者「这一节的知识属于哪一年、现在还是不是主流」。这不是作者不知道,是教材体例不许他说——教材讲原理,不讲时效。
行业五章把这个毛病放大到最大。p0510 是第 10 章「AIGC 改善医疗健康」里讲健康产品的一页:一张图(图 10-3 可穿戴健康产品,标注「基于织物的自发电生物传感器(乳胶)」),然后一句「AIGC 在健康产品中的应用前景广阔,通过不断的技术创新和应用探索,AIGC 有望在以下几个方面取得突破」——接着三条:更精准的个性化服务、更智能的互动体验、更广泛的推广应用。
三个「更」,「有望」两个字,没有一个数字,没有一个已落地的产品名,没有一处监管门槛。这类段落在五章里反复出现,它的问题不是空,而是它和一个学生的期末论文摘要长得一模一样——你可以把主语换成任何技术,把这三条原封不动地搬过去。教材最不该写的就是这种「换个名词还成立」的句子,因为它不携带任何只属于这个领域的知识。
「提示不仅是用户与 AI 模型交互的桥梁,更是一种全新的『编程语言』。」
——p0185,第 4 章 4.2「提示的原理」。我不同意这个比喻:一门语言要有变量、控制流、可组合的语义和可测试的行为,提示词四样都没有。它是意图的近似表达,不是程序。
这一页还有更值得说的地方。它把「用户输入提示词后,AI 系统会通过以下步骤生成回答」拆成三步:(1)解析提示词,提取关键词和语境;(2)检索知识库,从训练数据中检索相关信息;(3)生成文本,结合上下文和检索到的信息生成连贯的回答。
这三步写得很顺,但它是把「对话模型」和「检索增强」混成了一条流水线。普通的对话模型在生成时并不会去「检索知识库」,它是在参数里做前向计算;「检索」是 RAG 才有的动作。这处混淆不算致命——对初学者来说,「先去知识里找,再组织语言」是个好用的直觉——但它会在后面埋雷:读者会以为模型「知道」的东西是查出来的,而不知道它其实是「算」出来的。这个区别,恰恰是幻觉问题的根源。
六、作业与正文的错位:第 15 章问 ChatGPT 哪年发布
每章结尾都有【作业】,形式统一:选择题,四个选项,一题占小半屏。p0049 的第 1 章作业在问「大数据的 3V 特征」「所谓『用现有的一般技术难以管理』是指什么」——和本章内容对得上,合格。
但 p0765 的第 15 章作业是这样的:
「1. OpenAI 的 AI 聊天机器人程序 ChatGPT 发布于()年 11 月 30 日,它展现出绝妙的人机交互体验,能够充分理解人类自然语言,可以用人类自然对话方式来交互。」A. 2022 B. 2024 C. 2020 D. 2025
「2. 如今,在中国,AI 初创企业如雨后春笋般不断涌现。()年初,发布了低成本高性能生成式 AI 的 DeepSeek 在全世界爆火,昭示着『中华 AI』的茁壮成长,性能竞争迎来新局面。」A. 2022 B. 2024 C. 2020 D. 2025
第 15 章叫「面向 AGI」,48 屏,讲的是通用人工智能的路径与争议。它的作业在问 ChatGPT 的发布年份和 DeepSeek 的爆火年份。
这两道题,任何一年的百度百科都能答,而第 15 章的正文读不读都不影响答题。这不是「题出得简单」,这是「题和章没关系」——作业变成了考记忆的年表,而不是考理解的判断。一本书如果每章都用选择题收尾,那它的每一章都在暗示读者:这里的知识是可以被四个选项框住的。
对比一下 p0006 那句「学生针对每章内容写下的阅读笔记(建议)」——「建议」两个字加得很诚实,说明编者自己也知道,真正有价值的学习动作(写笔记、做研究性学习)没法计分,能计分的只有选择题和考勤。
七、它的短板
按严重程度排,四条。
第一,均匀分配消灭了优先级。15 章 44 到 63 屏,占比全在 5.6% 到 8.0%。结果是提示工程 51 屏、伦理与法律 44 屏、AGI 48 屏、音频生成 48 屏——四个完全不同量级的话题,在这本书里几乎等重。读者读完拿不到「先学哪个、多花时间在哪个」的判断,而这恰恰是入门书最该给的东西。
第二,只有「是什么」,没有「什么时候会错」。p0135 的 GAN 四代、p0300 的风格迁移三概念、p0185 的提示三步流程,全是定义加分类,没有一处失败案例、没有一处参数判据、没有一处「这么做会出问题」。787 屏里我没有读到一次「这个方法的局限是什么」的明确表述——除了第 14 章那些被人起诉的案例,而那是法律风险,不是技术局限。
第三,目录编号有断层,正文编号体系混用。目录里 1.5 节的小节是 1.5.1、1.5.2、1.5.3,然后直接跳到 1.5.5、1.5.6、1.5.7——1.5.4 缺号,且正文没有补。同样的问题在 p0135 上以另一种形式出现:同一份列表里,「③不使用 sigmoid」「④改进版本 WGAN-GP」用的是圈号,紧接着「(3)样式 GAN」「(4)周期 GAN」换成了括号数字。两套编号在同一页混用,读者没法确认自己读到第几层。
第四,作业与章节脱节。p0765 的第 15 章作业问的是 ChatGPT 与 DeepSeek 的发布年份,与「面向 AGI」这一章的内容没有关系。这类题目对教学有害:它让学生以为记住年份就是学会了。
再补一条客观事实,不作评价:微信读书末页(p0787)显示「待评分」「0 人点评」「推荐值 0%」。这本书在读者端几乎没有声音——它大概真的只活在课堂里。
八、给要用这本书的人
最合适:要开一门 32 学时课的老师。这本书基本可以当现成教案用:15 章对应 15 次课,每章 2 学时,每章配 15 道选择题和一次分组实践,连进度表都给你排好了(p0006),连「召集人__(专业、班级__)」的表格都印好了(p0058)。你要做的只是删掉一半选择题,换成一个真项目。
次合适:完全零基础、需要一个「知道有哪些东西」的地图的人。它的覆盖面是真的全:从 ENIAC 到 AGI,从文本到多模态,从文化创意到金融医疗,15 章把这片地全踩了一遍。作为索引,它合格——你从这里知道「哦,还有音频生成这回事」,然后再去找专门的书。
要当心的地方:把「三步生成流程」当成模型的工作方式。p0185 那三步(解析提示词—检索知识库—生成文本)会让读者误以为模型的回答是「查出来的」。记住:普通对话模型的输出是算出来的,不是查出来的;「查」是 RAG 才有的动作。这个区别决定了你怎么理解幻觉,也决定了你该不该给它接知识库。
不合适:想动手做出东西的人。787 屏里没有一个完整可跑的项目,没有一行需要你调试的代码(全书基本不涉及编程),也没有一处参数该填什么。这是一本「知道」的书,不是一本「会做」的书。
读法建议:把它当字典,别当教程。先读第 4 章(提示工程,51 屏)和第 3 章(大语言模型,63 屏)——这两章是全书离「能用」最近的;再跳到第 14 章看那条诉讼时间线,那是全书唯一可核查的干货;行业五章(第 9 到第 13 章)按你的行业挑一章读,其余四章只看小节标题;第 1 章可以整章跳过,除非你真的需要知道 ENIAC 是哪一年造的。
一句话:它把十五个话题切成十五块一样的砖,砌成了一堵整齐的墙——整齐是它的美德,也是它不告诉你门在哪的原因。
抽样核对 9 屏:p0006 教学进度表(16 行,多数每章 2 学时;「研究性学习」「作业」两列;填表人/系主任签字栏;教学评测五项含「平时考勤情况」) · p0012 1.1.1 通用计算机(图 1-1 ENIAC;烤面包机比喻) · p0049 第 1 章【作业】选择题(大数据的 3V 特征;「用现有的一般技术难以管理」) · p0058 第 1 章【研究性学习】(步骤 1 理论学习 30 分钟;步骤 2 实践操作 60 分钟;小组 3 到 5 人;召集人__(专业、班级__)) · p0125 3.2.1 词元及具标记化(token 为单词/子词/字符映射成的数字列表;3.2.2 基础模型:数千台 GPU/TPU 训练数周、耗资数百万美元) · p0135 第 3 章 GAN 演进(WGAN 直接优化推土机距离;WGAN-GP 梯度惩罚;样式 GAN 四点:分层感知控制/映射网络/AdaIN/渐进式增长;周期 GAN 四类应用;圈号与括号数字混编) · p0185 4.2 提示的原理(解析提示词—检索知识库—生成文本三步;「更是一种全新的『编程语言』」) · p0300 6.3.1 基本原理(CNN 提取内容图像高级特征与风格图像纹理特征;内容/风格/目标三图像定义) · p0510 10.4 健康产品(图 10-3 可穿戴健康产品:基于织物的自发电生物传感器(乳胶);三条「有望取得突破」) · p0720 第 14 章(2023-02-15 马可尼指控;06-28 特伦布莱与阿瓦德集体诉讼;同月 16 名匿名人士索赔 30 亿美元;07-10 希尔弗曼等三人起诉;09-19 美国作家协会及乔治·R·R·马丁等 17 位作家起诉;12 月 11 位作家在曼哈顿联邦法院起诉) · p0765 第 15 章【作业】(ChatGPT 发布年份四选一;DeepSeek 爆火年份四选一) · p0787 末页(参考文献 [9] 周苏《创新思维与 TRIZ 创新方法》、[10] 周苏《人工智能伦理与职业素养》2025;待评分 0 人点评 推荐值 0%)
说明:篇幅占比由 pages.jsonl 逐页章节映射聚合而得(前置 8 屏 1.0%;第 1 章 52 屏 6.6%;第 2 章 55 屏 7.0%;第 3 章 63 屏 8.0%;第 4 章 51 屏 6.5%;第 5 章 54 屏 6.9%;第 6 章 51 屏 6.5%;第 7 章 48 屏 6.1%;第 8 章 53 屏 6.7%;第 9 章 57 屏 7.2%;第 10 章 44 屏 5.6%;第 11 章 55 屏 7.0%;第 12 章 50 屏 6.4%;第 13 章 54 屏 6.9%;第 14 章 44 屏 5.6%;第 15 章 48 屏 6.1%;合计 787 屏。最厚第 3 章 63 屏,最薄第 10、14 章各 44 屏,差 19 屏)· 抽样率 9/787 ≈ 1.1% · 第 2、5、7、8、9、11、12、13 章仅按目录与篇幅核对,未逐字展开 · 笔记与图谱生成于 2026-11-10
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: