
Building Agentic AI Systems:985 屏里只跑了一个订票例子
微信读书《Building Agentic AI Systems》· 抓取 985 屏 / 10 章 / 87 条目录 · 读到书尾
逐字核对 13 屏 · p0006 书名条核对为本书 · 2026-11-10
抽样点位的选法:这本书的目录是「三部分十章」的直线结构,我按「前置取两屏(序与献词)、前三章各取一屏、中段四章各取一屏、末三章各取一屏、最后一屏收尾」布点,重点压在两个地方:一是第 2 章与第 4 章怎么用同一个例子讲「自主性」和「反思」,二是第 10 章凭什么占到全书五分之一。抽读 13 屏约占 1.3%。章节篇幅占比不是抽样得出的,是用 pages.jsonl 逐页章节映射做的全量聚合。
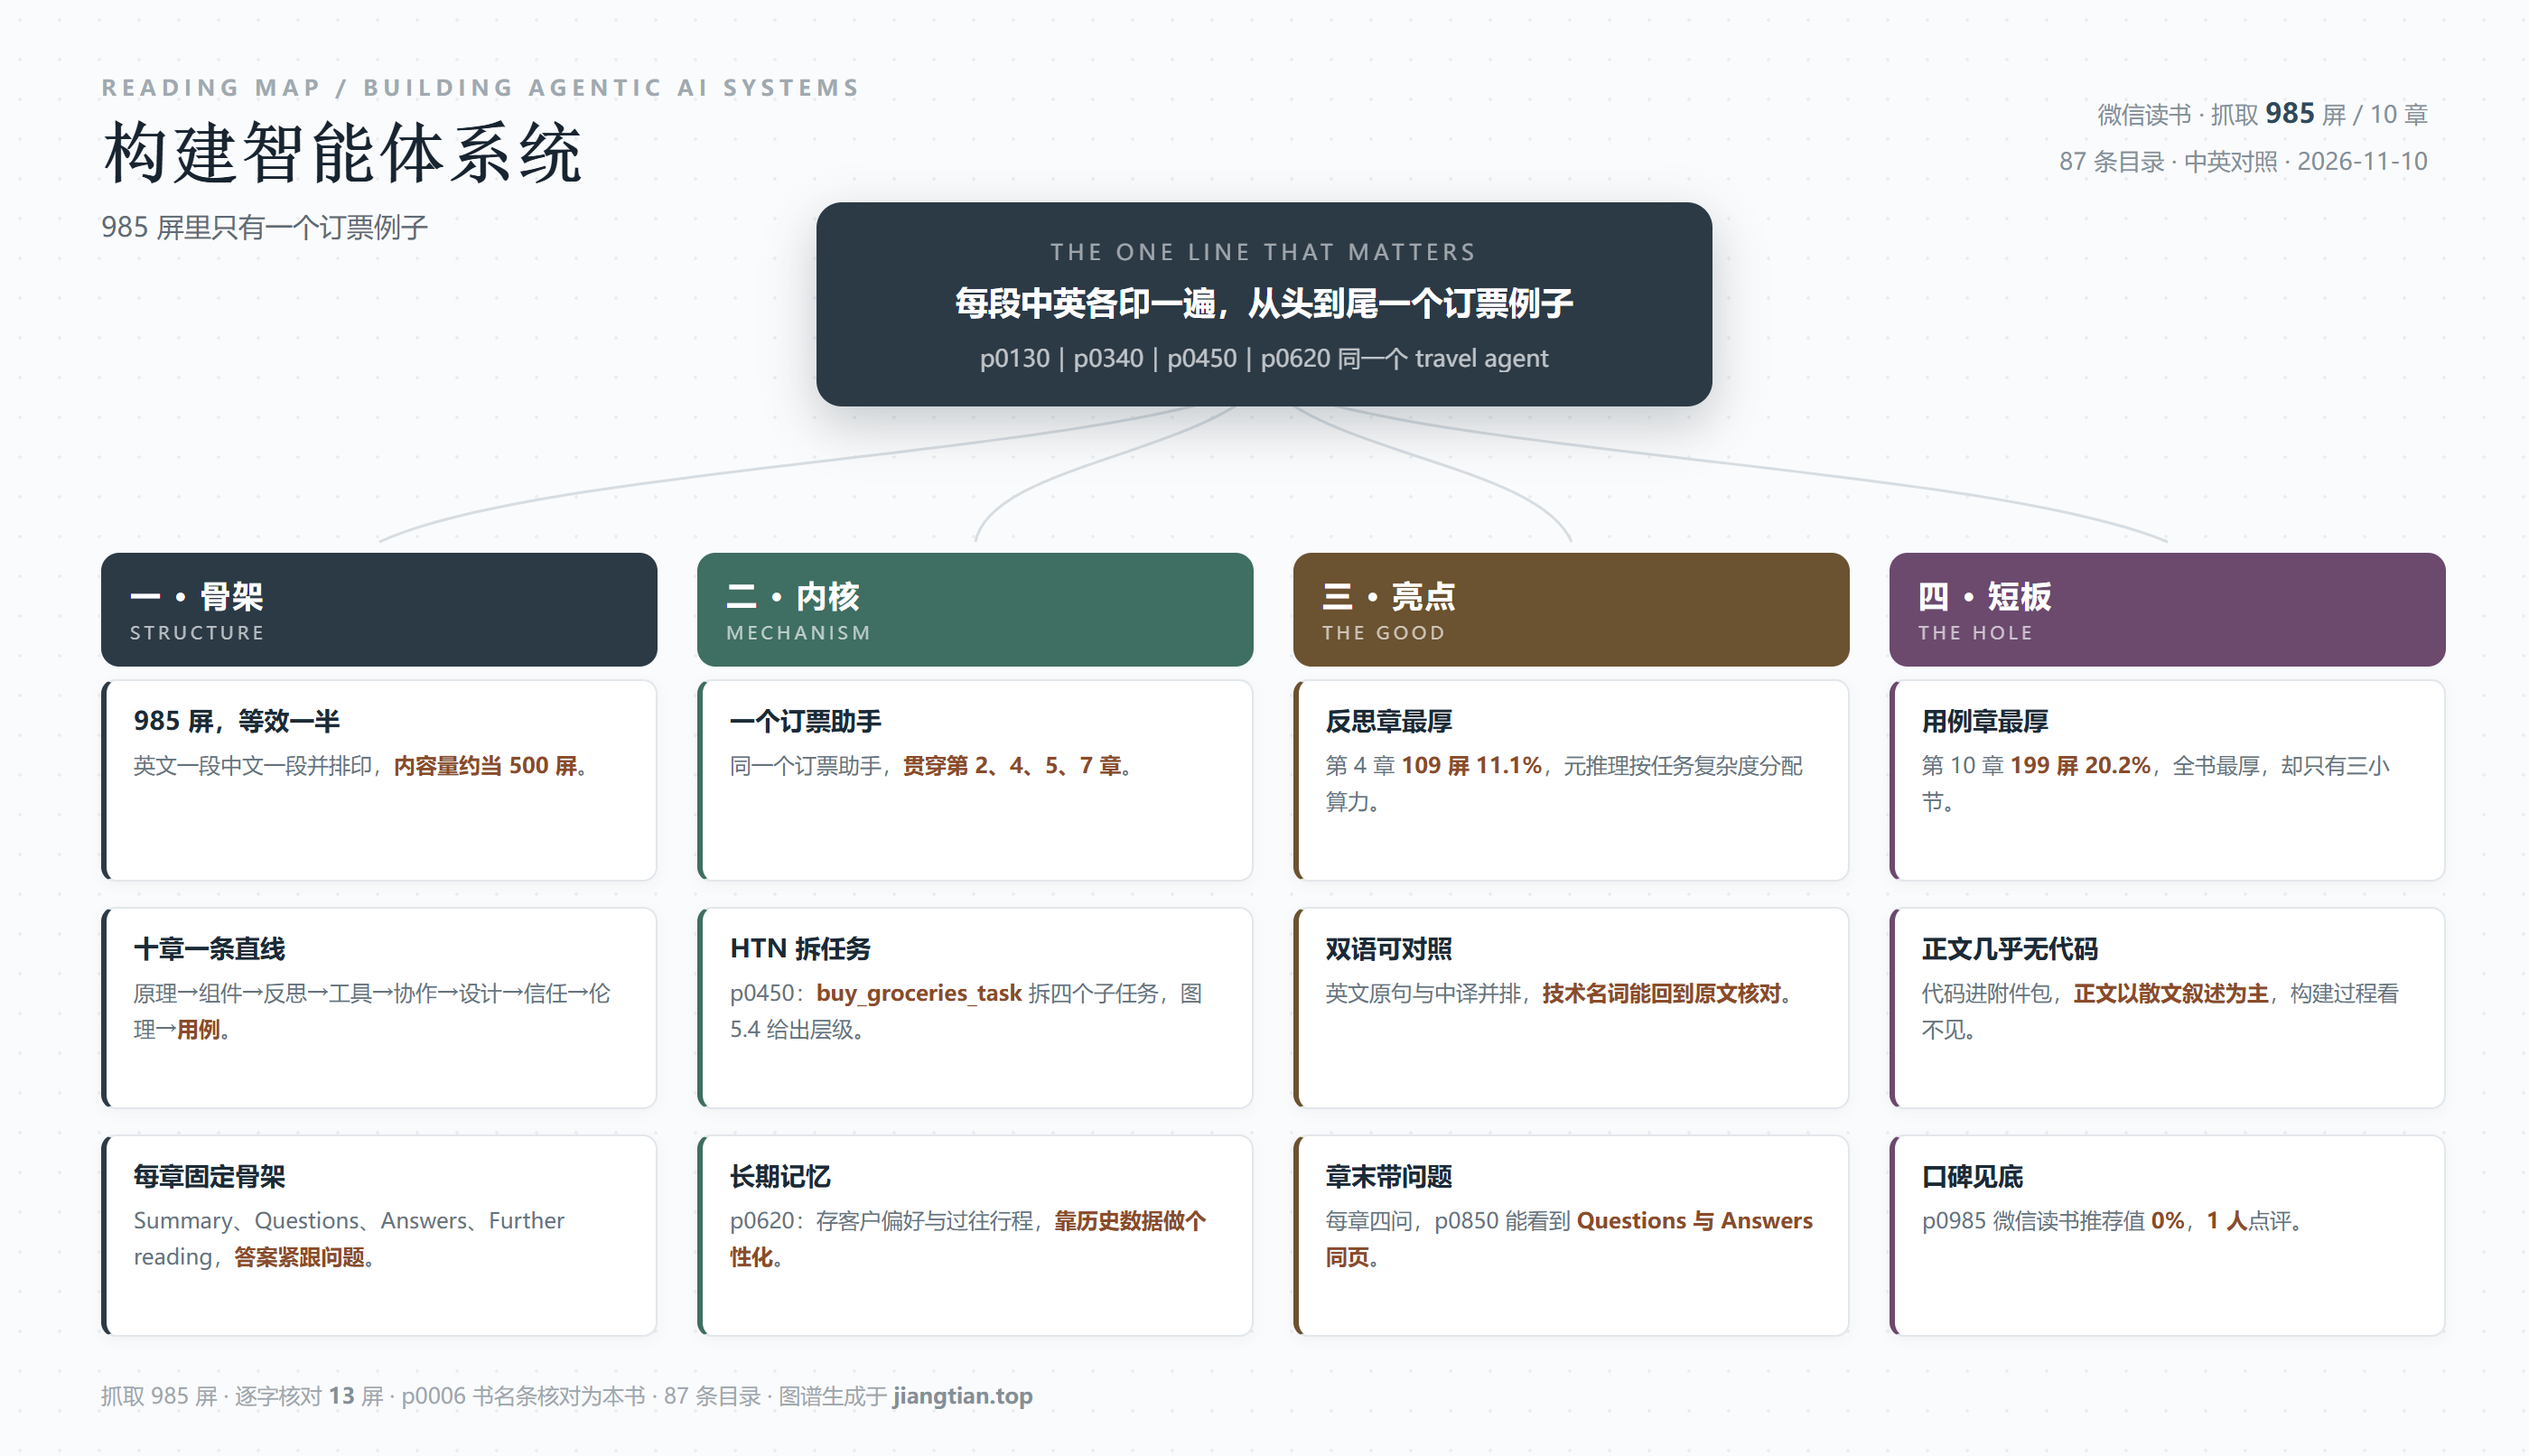
我先给结论:这本书的问题不在写得差,在写得省。985 屏里,每一段英文后面都跟一段中文译文,逐段重复、逐句对应;把重复扣掉,它的实际内容量大约相当于 500 屏。而 500 屏的正文里,从头到尾只有一个例子——一个帮人订机票订酒店的旅行代理。从第 2 章的「自主性」讲到第 7 章的「长期记忆」,同一个 travel booking assistant 被反复搬上台。
一本叫 Building 的书,用五分之一的篇幅告诉你「这东西能用来干什么」,用一个虚构的小场景解释「这东西是怎么运转的」,然后把真正的代码放进附件包里。这不是失败,这是一种很成熟的写法:把读者当听众,而不是当施工队。但它也有代价——你读完之后会觉得都懂了,然后打开编辑器,发现自己什么都不会写。
一、先把账算清楚:985 屏里有多少是重复的
这本书的体量很容易让人误判。微信读书抓下来 985 屏、87 条目录、10 章,按 1173 秒的翻页时长算,是一本需要认真对待的技术书。但打开第一页就会发现它的排版方式:一段英文,紧接着一段中文,再一段英文,再一段中文。
p0130 是这样的:先一段英文讲「These decisions can have a significant impact on the functioning of the system itself or its interactions with the environment.」,紧接一段中文「在大多数情况下,人工智能的自主性涉及系统根据其内部程序、模型和处理的数据自主做出决策的能力……」;然后是新的英文段、新的中文段。p0620 讲长期记忆,同样的节奏。p0700 讲知识产权,还是同样的节奏。
如果只是术语加注,这没什么可说的。但它是整段整段地重复。到了 p0800,连项目符号列表都印两遍——「Rendering farm API: Manages compute resources for 3D visualization」下面紧跟「渲染农场 API:用于管理 3D 可视化的计算资源」,「Reference library: Archive of past productions, style guides, and mood boards」下面紧跟「参考图书馆:过去的制作档案、风格指南和情绪板」。一屏之内,四行英文、四行中文,讲的是一模一样的事。
所以这本 985 屏的书,折算成中文单语的等效体量大约在 500 屏上下。这不是我在挑剔排版,这是一个可以算出来的数:你花 985 屏的时间,其中将近一半是在读自己刚读过的东西。作为对照,如果出版社真想给双语版,通行做法是原文一册、译文一册,或者左右分栏;逐段交替是最省事、也最占篇幅的一种。
顺带说一句译文。逐句直译的痕迹很重,句子跟着英文的语序走,定语套定语:「对我们的儿子来说,他对『爸爸在忙什么』的无尽好奇心每天都提醒着我为什么探索很重要——你的惊奇和问题在我最需要的时候激发了我的灵感」。意思没错,但读起来像翻译腔的原文,而不是中文。技术书里这还可以忍,因为名词能对上;讲故事的地方,读感就掉下来了。
二、骨架:十章一条直线,前三章占四分之一
把 pages.jsonl 按章聚合一遍,这本书的形状就出来了。前置(版权、序、献词、作者简介、前言)50 屏 5.1%;第 1 章「生成式 AI 基础」66 屏 6.7%;第 2 章「智能体系统的原理」85 屏 8.6%;第 3 章「智能体的核心组件」85 屏 8.6%;第 4 章「智能体中的反思与内省」109 屏 11.1%;第 5 章「工具使用与规划」92 屏 9.3%;第 6 章「协调者、工作者与委派者」76 屏 7.7%;第 7 章「有效的智能体系统设计技巧」91 屏 9.2%;第 8 章「建立信任」58 屏 5.9%;第 9 章「安全与伦理」68 屏 6.9%;第 10 章「常见用例与应用」199 屏 20.2%。三个 Part 分隔页各 2 屏。
这个分布有两个问题。
第一个:前三章 236 屏、占 24%,全在讲概念。第 1 章讲生成式 AI 是什么、有哪几类模型、有什么局限;第 2 章讲自主性、能动性、自治,讲智能体的架构和多智能体系统;第 3 章讲知识表示、推理、学习机制、决策与规划。三章加起来接近全书的四分之一,但你读完能拿走的只有一套术语。对一个已经知道什么是 LLM 的读者,这 236 屏的信息密度大概相当于一篇综述。
第二个,也是更值得说的:第三部分叫「信任、安全、伦理与应用」,占 325 屏 33%,但它由两章原则加一章清单组成。第 8 章 58 屏讲信任(透明、可解释、处理不确定性与偏见),第 9 章 68 屏讲安全与伦理(风险、负责任 AI、伦理框架、隐私与安全),两章合计 126 屏 12.8%。这两章是全书唯一「承诺交付物」的部分——书名许诺你建系统,而这两章许诺你建得对。实际给出的是一份原则清单:p0700 讲知识产权,说系统应当尊重版权、商标和其他知识产权,开发者应当实现检测与防止未授权使用的技术,使用第三方内容时应当提供适当的归属与信用。三条都正确,三条都无法验收。
第 3 章的构成也值得单独说。85 屏分五节:知识表示、推理、学习机制、决策与规划、用生成式 AI 增强智能体能力。前四节是符号 AI 的经典科目——知识图谱、逻辑推理、强化学习、规划算法,第五节才是「用生成式 AI 增强」。也就是说,一本以生成式 AI 命名的书,把一章的前五分之四留给了前 LLM 时代的知识体系,最后一节才回到主题。这部分不是没用(推理链、规划、记忆确实要从这些老概念里借词汇),但它和「构建」的距离比和「考试」的距离远。
三、它真正讲清楚的一件事:反思是算力分配问题
如果这本书只能留一页,我会留 p0340。
那一页在讲「元推理(meta-reasoning)」:旅行代理可以按任务的复杂度和风险,动态分配自己的计算资源。复杂的、高风险的多国多目的地行程,投入更多算力做更深的推理和分析;常规的、简单的请求,就靠更简单的启发式方法或预定义规则,把资源省下来。紧接着它自己泼了一盆冷水:把过多算力用来优化复杂行程,会遇到收益递减(diminishing returns),代理可能变得「过度」——原文停在「the agent could become overly」这一句,下一页才接上。
这半页的价值在于,它把「智能体该想多深」这个通常被讲成玄学的问题,讲成了一个工程问题:反思不是越多越好,反思有成本,成本要按场景分配。第 4 章占 109 屏、11.1%,是全书最长的技术章,这个长度花在了对的地方。同一章里它还区分了「反思(reflection)」与「内省(introspection)」——前者是对输出与过程的回看,后者是对自身状态与能力的审视。这个区分放在 2024 年之后的中文语境里依然有用,因为很多文章把两者混着说。
第 7 章 91 屏 9.2% 也值得一提,它是全书最接近工程的一章:聚焦的系统提示与指令、状态空间与环境建模、智能体的记忆架构与上下文管理、工作流里的串行与并行。这四节的名字就是四个真实的设计决策点。可惜仍停在「应该考虑什么」,没有落到「怎么设、设多少」。
把第 4 章和第 6 章放在一起看,能看出这本书的偏好。第 4 章讲「反思」,109 屏 11.1%,全书第二厚;第 6 章讲「协调者—工作者—委派者」(CWD)模型,76 屏 7.7%,比反思少 33 屏。而在真实的智能体系统里,多主体协作出问题的概率远高于单个主体反思不足:谁来决定任务怎么切、切完谁验收、两个 worker 给出冲突结果怎么办、委派链断在中途怎么回滚——这些是上线的门槛。第 6 章的四个小节是「理解 CWD 模型、设计角色分配、主体间通信与协作、在生成式 AI 系统中实现 CWD」,四节里只有最后一节讲实现,篇幅上还得和前三节平分那 76 屏。
这个配比透露了作者的重心:他更愿意写「智能体内部怎么想」,不太愿意写「多个智能体之间怎么不打架」。前者好写,可以顺着一个例子往外推;后者难写,必须落到协议、超时、幂等、仲裁这些没有故事性的东西上。
四、只有一个例子:是省事,也是回避
这本书的叙述方式很统一:先给概念,再拿旅行代理举例。
p0130 用它讲自主性:系统分析两地之间航班的可用性、票价、用户给的座位偏好等限制条件,然后决定怎样最优地搜索航班和酒店,使客户的出行总成本最小;系统要对自己的决策结果负责,因为结果会影响整个行程和客户的花费。
p0450 用它讲分层任务网络(HTN):高层任务(复合任务)拆成更小的、可管理的子任务,直到拆到能直接执行的原始任务。书里给的例子是 buy_groceries_task 拆成四个子任务,其中一个子任务 select_items 再拆成三个更具体的动作,图 5.4 画出了这个层级。
p0620 用它讲长期记忆:存客户在多次预订中表达的偏好、过去的行程安排、关于目的地和季节性的知识、以及与服务商的关系;有了这些,代理能基于历史做决策,不必让客户每次重复自己的需求。
三个例子,一个场景。这在小书里是优点(读者不用重新进入情境),在 985 屏的书里就是问题:订票这个场景,天然不需要那些最难的部分。它不需要工具调用失败后的重试与降级,不需要跨系统的权限边界,不需要多轮对话里的状态污染处理,不需要成本上限与配额,不需要审计留痕。第 5 章 92 屏讲工具使用与规划,第 7 章 91 屏讲状态空间与记忆架构,理论上正该讲这些——但例子撑不住,因为订票不会遇到。
于是出现了一个循环:例子选得越小,讲得越顺;讲得越顺,越不像真实系统;越不像真实系统,读者上手时越容易撞墙。一本教人构建的书,选择了一个不会失败的世界。
还有一层更细的账可以算。这本书 87 条目录里,17 条是前置(版权信息、两篇 Foreword、贡献者、作者与审稿人简介、Discord/Reddit 社群、Preface、读者对象、本书内容、如何最大化利用本书、下载示例代码、图片免责声明、排版约定、联系方式、分享想法、免费 PDF),另有 5 条是书末(Index、Why subscribe、Other Books You May Enjoy、Packt is searching for authors、Join our community)。扣掉这 22 条,真正给正文的只有 65 条目录,十章平均 6.5 条。换句话说,一章六七个小节,每个小节十几屏——这个粒度只够讲清一个概念,不够讲清一个做法。
我拿「如果这本书要真的能让人动手」的标准,列了五样必备的东西,对照下来一样都没有:一是接口契约(工具描述写什么字段、模型怎么知道该调哪个);二是状态机(对话轮次之间什么该留、什么该丢);三是失败语义(超时、限流、工具报错分别怎么处理);四是评测集(怎么知道改完提示词之后变好了);五是成本账(一次任务的 token 与调用次数预算)。这五样,是「构建」这个词最低限度的含义。
五、最厚的一章最薄:第 10 章 199 屏
第 10 章「常见用例与应用」199 屏,20.2%,是全书最厚的一章,比第二厚的第 4 章(109 屏)多出 90 屏。而它的目录只有三个小节:创意与艺术应用、自然语言处理与对话代理、决策支持与优化。
199 屏除以 3 节,每节 66 屏。听起来很充实,但看形态就知道不是。p0800 是其中一节的中间页,内容是一个 3D 动画工作室需要的系统清单:生产管理系统(跟踪预算、进度与资源分配)、渲染农场 API(管理 3D 可视化的计算资源)、相机与设备数据库(技术规格与可用情况)、参考图书馆(过去的制作档案、风格指南、情绪板)、版本控制系统(记录每次迭代与变更)。五项,每项一句解释,中英各一遍。
这就是这一章的基本单位:一个行业,列五个到八个「这个行业里可以自动化的东西」,各配一句话。它能帮你确认「我的行业也有类似的东西」,但它不能帮你决定「先做哪一个、怎么接、失败了怎么办」。
一本讲构建的书,把五分之一的篇幅放在「能用来干什么」,而不是「怎么建起来」,这是结构上的错位。更直白地说:这一章如果是放在书的开头当引子,20 屏就够了;放在结尾当展望,10 屏就够了。199 屏意味着,它被当成了主体内容来写。
换个算法更刺眼:这一章有 199 屏,而整本讲「建立信任」的第 8 章只有 58 屏,整本讲「安全与伦理」的第 9 章只有 68 屏。「这东西能用在哪些行业」的篇幅,是一整章「怎么不出事」的三倍。对一本面向从业者的书,这是个可疑的优先级——尤其当这本行业书的目标读者,多半是要把智能体塞进某个已有业务里的人,他们最缺的恰恰是「不出事」那部分。
六、习题与答案印在一起,暴露了它的读者假设
p0850 是全书结构上最说明问题的一页。它同时印着第 10 章的四道 Questions 和紧接其后的 Answers:第 3 题「比较和对比代理系统在机器人技术中的作用与决策支持系统中的作用。它们在维护上下文方面的方法有何不同?」第 4 题「以本章中的企业知识管理用例为例,说明不同角色如何协作来解决复杂的信息检索问题。」第 5 题「本章以供应链优化网络为例进行了讨论。在这种情况下,采用代理系统方法有哪些主要优势?不同的代理之间又是如何相互补充的?」然后是「答案 / Answers」,第一条答案是「Agentic systems in creative applications maintain context and creative vision...」
英文一遍、中文一遍,问题和答案各印两遍。这一屏实际只有三个问题、三条答案,却占满了整屏。更关键的是顺序:答案就在问题下面几行。
这个体例说明了一件事:这本书的默认读者是坐在教室里的人,老师布置作业、学生翻到后面核对。对自学者,等于把练习册的答案印在题目正下方——你还没来得及想,眼睛已经看到了。而每章末固定五件套(Summary、Questions、Answers、Further reading、References)也从侧面印证,这是一本按教材模板组装出来的书:结构整齐、可检索、可布置作业,但不逼你动手。
我不认为教材体例本身是缺点。缺点在于,它用教材的骨架,承担了工程手册的承诺——书名是 Building,封面宣传的是「empowering practitioners to design systems that dynamically learn and continuously improve」(前言原句),而正文里没有一个完整的、端到端的构建过程。
再看这三道题的问法:「比较和对比」「说明不同角色如何协作」「有哪些主要优势」——全是课堂动词,指向的是「你能不能复述我刚讲的内容」。没有一道题指向「你能不能做出来」:没有一个「给你的代理加一条超时策略」、没有一个「设计一个评测集来判断改完提示词是否变好」。习题的问法,比目录更能说明一本书期待读者做什么。
七、它的短板
第一,构建动作发生在书外。前言里有「Download the example code files」这一节,说明代码是有的,但在附件包里。正文里的代码只是残影:p0450 页面顶端孤零零一行「14 }」,是某个清单的收尾括号,前面十几行在上页。一本 985 屏的书,你翻完不知道那些类是怎么组织的、依赖怎么装、跑起来是什么样。对「构建」这个动词来说,这是根本性的缺口。
第二,单一例子让覆盖面虚高。目录看是十章齐全:原理、组件、反思、工具、协作、设计、信任、伦理、用例。但十个主题共用一个小场景,等于十个镜头拍同一个房间。真实系统里最贵的三件事——集成、失败处理、成本——全书没有一个完整的走查。
第三,伦理与安全停在原则层。p0700 的三条(尊重知识产权、实现检测与防止未授权使用、给第三方内容署名)都对,但没有一条给出判据:检测什么?检出率多少算合格?署名放在哪里、什么格式?第 9 章 68 屏 6.9%,是全书第二薄的正文章,而它承担的是一本书里最容易出事的部分。
第四,口碑数据很难看,但样本太小,得说清楚。p0985 是全书末页:微信读书推荐值 0%,1 人点评。0% 不是「很差」,是「评分数不足」——1 个人的样本说明不了质量,只能说明一件事:这本书在中文读者里几乎没人读完、也没人评。对一个准备投入 985 屏时间的人来说,这个信号仍然有效,只是它衡量的是「有多少人验证过」,不是「这本书好不好」。
八、这本书该怎么用
我的用法建议很具体:
当概念地图读,不当实现指南读。第 2 章(自主性/能动性/自治的区分)、第 3 章(知识表示—推理—学习—决策这条链)、第 4 章(反思与内省的区别、元推理的成本权衡)、第 7 章(提示、状态空间、记忆、串并行四个决策点)——这四章的骨架值得抄进笔记,它们提供了一个提问清单:我这个系统,状态空间怎么划?记忆放哪一层?什么时候该反思、反思几轮?
双语对照的正确用法是反过来用。不要顺着读中文,那样你只是在读一遍书。先扫中文抓结构,遇到术语回英文原句核对——比如「智能代理」这个词,英文原文是 agent,国内通行译法是「智能体」;书里统一用「智能代理」,你搜中文资料会对不上。这类对照只有回到原文才做得成,这是双语版唯一实打实的好处。
第 10 章当灵感清单翻,别当章节读。199 屏的用例,按行业扫标题,看到自己行业就停一下,记下那五到八个可自动化的点,然后合上书去画自己的架构图。这是它最好的用法——它负责提醒你「还有这些事可以做」,不负责告诉你怎么做。
补课的地方在书外。工具调用的失败重试、权限与沙箱、成本核算、可观测性,这四件事这本书都不讲,而它们决定了你的智能体能不能上线。这本书给你的是「智能体是什么形状」,剩下的是工程。
如果一定要给一个动手顺序,我会这样排:第一步,把 p0340 那半页的元推理逻辑抄下来,做成一个「什么时候多想一步」的判定函数——输入任务复杂度与风险等级,输出反思轮次上限。这一步不需要框架,一个 if-else 就能落地,而且立刻能省 token。第二步,照第 5 章的 HTN 思路,把你自己的业务流程拆到「原始任务」层,拆不动的地方就是缺工具的地方,工具清单自然出来了。第三步,用第 7 章的四节做一遍设计评审:提示写给谁、状态放哪、记忆存几层、哪几步能并行。第四步,搭一个二十条的小评测集,每题写明「什么算答对」——这一步书里没教,但没有它,前三步做的所有优化都是凭感觉。
做完这四步,你会发现这本书的价值已经用完了,而它也恰好用完了。这不是贬低:一本能把你送到「可以自己开工」这一步的书,已经比大多数同类强。问题只在于它送的这段路,本来可以短一半。
一句话收尾:这是一本把「构建」写成「讲解」的书,最好的用法是把它当目录,而不是当教程。
说明:篇幅占比由 pages.jsonl 逐页章节映射聚合而得(前置 50 屏 5.1%;第 1 章 66 屏 6.7%;第 2 章 85 屏 8.6%;第 3 章 85 屏 8.6%;第 4 章 109 屏 11.1%;第 5 章 92 屏 9.3%;第 6 章 76 屏 7.7%;第 7 章 91 屏 9.2%;第 8 章 58 屏 5.9%;第 9 章 68 屏 6.9%;第 10 章 199 屏 20.2%;三个 Part 分隔页各 2 屏;合计 985 屏)· 第 1、3、6、8 章仅按目录与篇幅核对,未逐字展开 · 笔记与图谱生成于 2026-11-10
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: