
Agentic Coding with Claude Code:它把上下文当预算管,把工具当债记
微信读书《Agentic Coding with Claude Code》· 抓取 950 屏 / 12 章 / 79 节 · 读到书尾
逐字核对 8 屏 · p0006 版权页核对为本书(Packt Publishing,2026 年 3 月首版)· 2026-11-10
抽样点位的选法:这本书按 Part 分成三大块(基础 / 扩展 / 进阶),我按「一块取两三屏」铺开——Part 1 取 p0060(CLAUDE.md 去重)、p0125(计划模式)、p0176(hooks);Part 2 取 p0272(MCP 架构)、p0336(上下文污染)、p0348(CodeMode)、p0495(子代理测试);Part 3 取 p0740(技能与子代理的分界)、p0827(并行何时反效果)、p0885(末章)。重点压在三个地方:一、工具定义到底吃掉多少上下文;二、技能与子代理的运行环境差在哪;三、末章 72 屏到底写了什么。抽读 8 屏约占 0.8%。各章篇幅占比不是抽样估的,是用 pages.jsonl 的逐页章节映射做的全量聚合。
先说结论:这是一本把「上下文」当预算来算的书,而它自己最大的问题,是没算清「篇幅」这笔账。950 屏听起来像一本厚书,实际上它是英中双语对照排版——英文一段、中文一段,一屏的信息量只有半屏。真正的内容密度,大概相当于一本 450 屏的单语书。这个注水不是作者的错,是阅读器的翻译开关,但它直接决定了你读这本书的手感:你会觉得它啰嗦,其实它只是被复述了一遍。
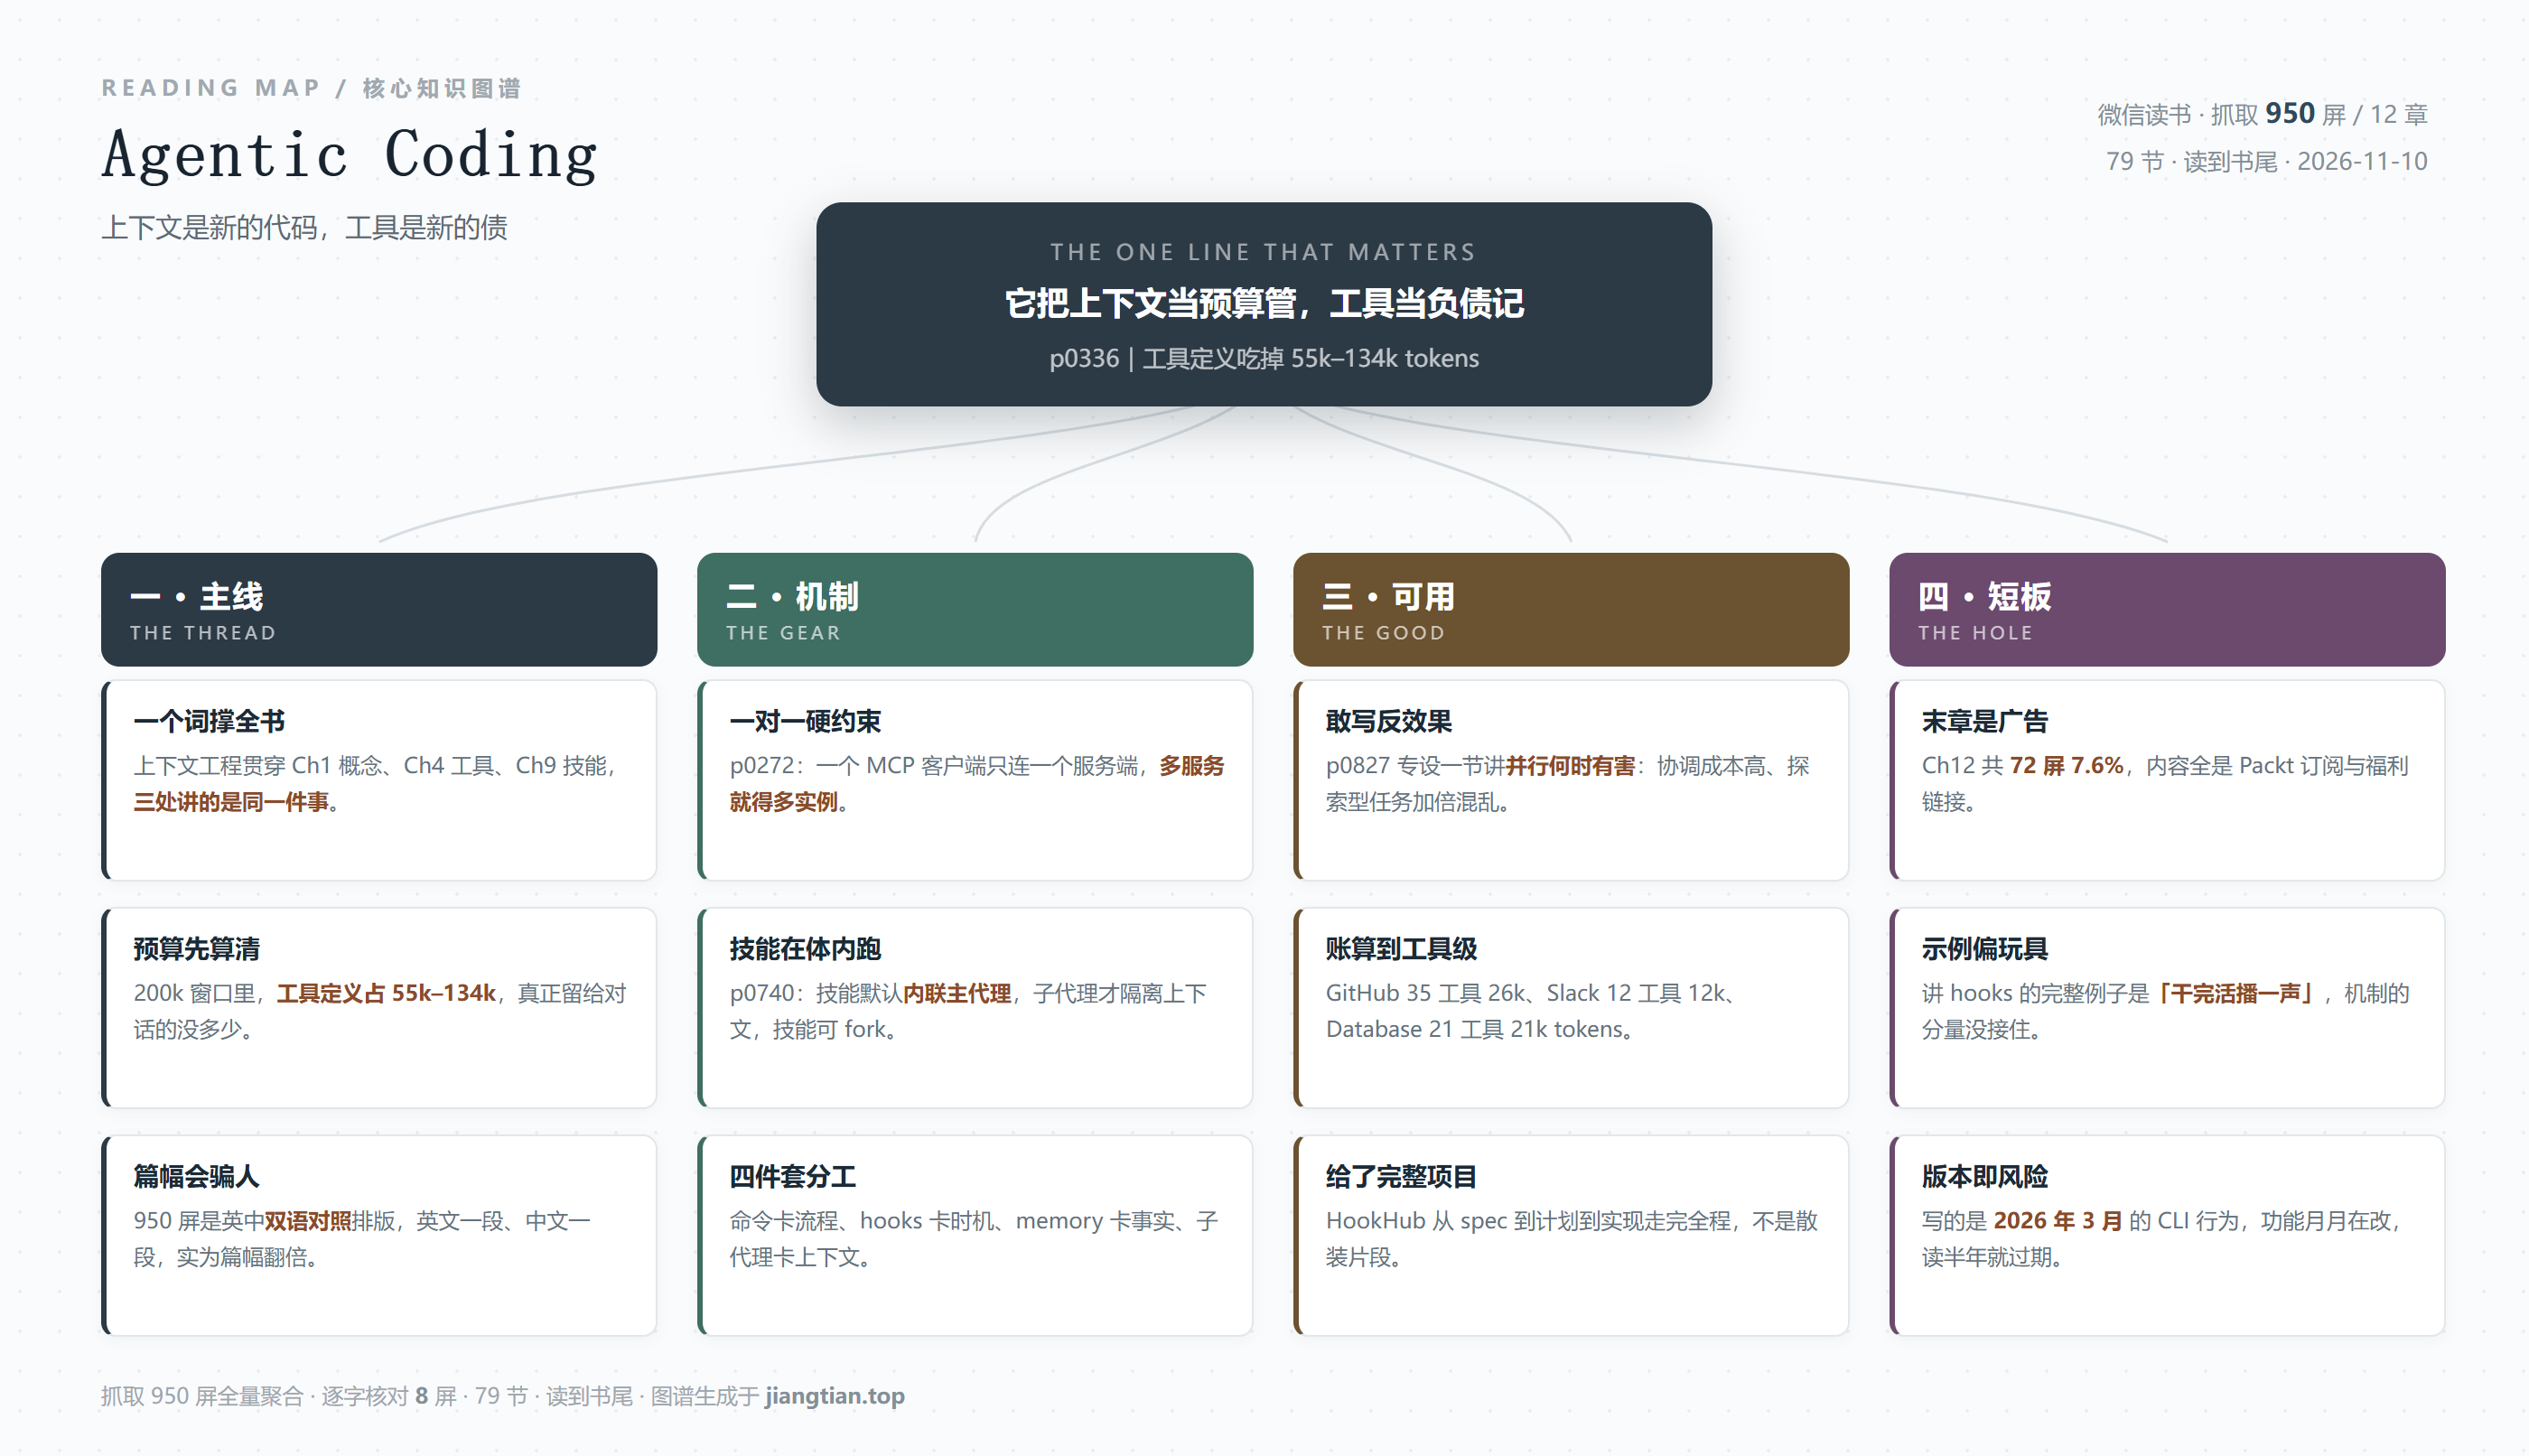
把水挤掉之后,剩下的东西是扎实的。它给了一个我在此之前只在零散博客里见过的判断:MCP 工具不是免费的,每接一个服务器,都从你的上下文窗口里划走一块。p0336 那张图画得很直白——200k 的窗口,工具定义占掉 55k 到 134k,剩下才是「你真正说的话」。GitHub 35 个工具 26k tokens、Slack 12 个工具 12k、Sentry 10 个工具 9k、数据库 21 个工具 21k。图下面有一句小字:ALL LOADED even if you just want to change a button。就这一句,值这本书一半的价钱。
一、它的主线:上下文是一种会花完的资源
全书十二章,真正的主题只有一个词:context engineering。作者把它拆成三层讲,而且这三层是递进的,不是并列的。
第一层是「写什么进上下文」。第 1 章 46 屏,讲 CLAUDE.md 该放什么、不该放什么。这一章里有一个很实在的细节,p0060:用脚本按 Git 分支动态更新 CLAUDE.md 时,如果每次都 >> 追加,文件里会积满重复条目,越滚越大;所以脚本里要先检查这条引用在不在,不在才写。这个坑我踩过,它写在书上,说明作者是真用过。
第二层是「工具怎么占上下文」。第 4 章 154 屏,全书最厚的一章,几乎是整本书的重心。它讲的不是「MCP 怎么装」,而是「装完之后你的窗口还剩多少」。
第三层是「怎么把上下文隔离开」。第 7 章子代理 122 屏、第 9 章技能 67 屏。这一层解决的是第二层带来的问题:工具太多把窗口塞满了怎么办?答案是别在主代理里塞,扔给子代理,让它用一个干净的窗口干完活,只把结论带回来。
这三层扣得很紧,是我读这本书最舒服的地方。多数技术书是「功能清单」,这本是「一条因果链」——因为窗口有限,所以工具要省着接;因为工具省不下来,所以要隔离;因为要隔离,所以要有子代理和技能。你顺着这条链读,每一章都在回答上一章留下的问题。
也是读到这里我才想明白,为什么「上下文工程」值得单独造一个词,而不是并进「提示词技巧」。提示词技巧关心的是「这句话怎么写」,上下文工程关心的是「这个窗口里该放什么、不该放什么」。前者是写作,后者是配置管理——你要决定哪些文件被读进来、哪些工具被加载、哪些历史被保留、哪些规则该删掉。这四件事没有一件靠「把话说漂亮」能解决,全得靠取舍。作者用一本书把「取舍」讲成了可操作的动作,这是他最值钱的地方。
而它讲这条链的方式,也值得说一句:几乎每个判断后面都跟着一个数字或一段代码。p0272 讲 MCP 的架构,落到一句硬约束——一个 MCP 客户端只能连一个服务端,所以主机要连三个服务端,就得分三个客户端。这句话本身不稀奇,稀奇的是它配了图,图里三个客户端并排,每个后面拖一个箭头。你看完图,就再也不会问「为什么不能一个客户端连三个」。
二、第 3 章那 96 屏,才是多数人真正缺的
第 3 章 96 屏,10.1%,全书第三厚。目录里它管的东西很杂:价格与套餐、斜杠命令、hooks、memory、rewind(回退)、由技能驱动的自定义命令、以及用上下文工程改进自动生成的提交信息。
我的判断是:这一章的投入产出比高于第 4 章。你未必会接三个 MCP 服务器,但你每天都在敲斜杠命令;你不会天天配子代理,但你一定会被 memory 里一条过时的旧规则坑一次——而那一节讲的正是「记忆是文件,可以改,也必须定期删」。
更可惜的是 rewind 只给了十几屏。这是长会话里唯一能救命的功能:代理改错了文件,你不是靠 Ctrl+Z,是靠回退到某个检查点。这种功能应该配三个真实故障场景来讲——「它删了不该删的」「它改了三个文件只对了一个」「它把配置改坏了但没报错」。书里讲了怎么用,没讲什么时候必须用。
提交信息那一节短,但它是全书唯一把上下文工程用在「小事」上的示范:不追求宏大,只让每次 commit 的信息读起来像人写的。这种小处的示范,比第 4 章那些架构图更能说明「工程化」是什么——工程化不是接更多工具,是把每一件小事都变成可复现的动作。
三、154 屏讲 MCP:它把「接工具」讲成了一件有代价的事
第 4 章占 16.2%,比第 5 章(GitHub 集成,39 屏)加第 6 章(计划模式与多代理,32 屏)加起来还多一倍。这个配比不是随手排的,它反映了一个判断:对今天的 Claude Code 用户来说,最难的不是「让它写代码」,是「让它看见外面的世界」。
这一章里我最想推荐的是 p0336 那张「上下文污染」图。它的厉害之处在于把一个抽象问题变成了可数的东西:模型看不到你的意图,它只看到一串工具定义;这些定义在你说第一句话之前就已经加载完了;所以你今天只想改一个按钮的颜色,也要先付 26k tokens 的 GitHub 税。
顺着这个判断,作者给了三种解法,而且排了序。第一种是减少服务器数量——只接真正常用的;第二种是用 scope 控制加载范围(p0305 有一张 cheat sheet,讲 user / project / local 三级配置各自在哪加载);第三种最激进,是 p0348 的 Cloudflare CodeMode。
CodeMode 的思路值得单独说:既然工具定义占地方,那就别把工具一个个暴露给模型,而是把工具包成一个 TypeScript API,让模型直接写代码调用,代码在沙箱里跑一次,返回结果。从「模型调工具、看结果、再调工具」的多轮往返,变成「模型写一段脚本、跑一次」。书里给的理由很朴素:往返次数少了,token 省了,而且模型写代码比填参数更擅长。
我认为这是全书最有前瞻性的一页。它其实在说一件事:工具调用的未来不是「更多工具」,是「更少的接口、更强的执行环境」。这句话放到 2026 年看是常识,放到一本 3 月出版的书里,算看得远。可惜作者只给了四页,讲完原理就收了,没有讲沙箱怎么隔离、出错怎么回滚、权限怎么收。这四页像一张便条,贴在一堵墙上。
四、技能和子代理:它终于把「在体内跑」和「另起一间屋」分清了
这两个概念在中文技术圈被混用得一塌糊涂,我自己也长期说不清。p0740 那一页把它讲清了,原话是:技能默认在主代理里内联执行,子代理在隔离的上下文里执行;但技能可以指定 context: fork,那样它就会跑在一个类似子代理的轻量隔离环境里,只是配置项更少。
这句话的分量在于它给出了判据,而不是定义。判据是:你需要它「记得刚才聊了什么」吗?需要,就用技能,因为它在主上下文里跑,能看见前文;不需要,只想让它干完一件独立的事、把结论交回来,就用子代理,因为它另起一间屋,脏东西留在屋里。
书里接着给了一张对比表,把技能、子代理、MCP 服务器、斜杠命令放在同一个坐标系里比。这张表是全书信息密度最高的一处,也是我认为最该被抄下来贴在显示器边上的一处。因为在实际工作里,你遇到的第一个问题从来不是「怎么写」,而是「这件事该用哪个原语做」——用错了,后面全是返工。
顺着这个分类,第 8 章又补了第五、第六个原语:输出样式(output style)和状态行(status line)。输出样式管的是「它说话的方式」——同样一段分析,是给你一份正式报告,还是给你三条要点,差别不在内容而在腔调;状态行管的是「你随时能看见什么」——目录里那一节的标题是「进阶状态行:显示最近一条用户提示」,等于给长会话加了一根锚,你不至于滚了三千行之后忘了自己最初问的是什么。
这两个东西很多人不知道存在,因为官方文档把它们埋在配置页里。这本书把它们拎出来单独成章,85 屏,8.9%,理由是充分的:输出样式解决「输出不像你要的」,状态行解决「你忘了自己在干什么」,这两件都是长期使用才会浮出来的痛点。一本只在第一天有用的书不会写这两章。
但它讲这一层的方式,暴露了这本书的一个通病:机制讲得很细,示范给得很轻。第 7 章 122 屏讲子代理,配置、测试、上下文流转、并发扩展都讲了,可跑起来的例子是让一个子代理去审一段斐波那契数列的代码(p0495,命令是 funny review @main.py)。斐波那契是个好教具,但它不是好案例:真实项目里你要审的是三百行的业务逻辑、是跨文件的调用链、是「这个改动会不会碰坏别的地方」。这些,书里没有。
hooks 那一节更明显。这是 Claude Code 里最能体现「工程化」的机制——它让你在特定时机插入自己的脚本,等于给代理装了生命周期的钩子。可全书用来演示它的完整例子,是「任务结束时播一声响」(p0176:uv init、把主文件改名成 play_sound.py、uv run play_sound.py、然后回 Claude Code 验证没声音)。播一声响是好玩的,但它撑不起一个机制的重量。读者看完知道 hook 能干什么,但不知道「用它拦住一次危险操作」「用它强制跑一遍 lint」「用它把每次改动写进审计日志」——而这些才是 hooks 存在的理由。
五、它最难得的一节:承认并行会帮倒忙
技术书有个通病:只讲「怎么用」,不讲「什么时候别用」。因为讲前者是赋能,讲后者是否定自己的卖点。这本书在 p0827 破了这个例,专门开了一节叫「并行代理何时适得其反」。
它给的第一条是协调成本:如果你为了不让几个代理互相踩脚,得写出详细到没有歧义的规范,那说明问题已经严重了——你在划边界上花的时间越多,从并行里得到的越少。第二条是探索型或不明确的工作:当你还不知道正确解法时(比如调一个刁钻的 bug、试一个没想清的原型),多开代理只会把不确定性乘以几倍;与其让几个代理同时撞死路,不如集中一次迭代。
这两条我完全同意,而且我觉得它说得还不够狠。真实的失败模式比这更难看:并行代理写出来的东西,单看每份都合格,合起来互相矛盾。两个代理各自实现了同一套鉴权,命名不同、错误码不同,合并的时候你要花比从头写更多的时间去调和。这不是协调成本,这是「一致性债务」,而书里没提这个词。
不过它至少给了那句心法:并行适合「任务独立、边界清楚、结果可验证」的活。这句话说起来简单,用起来能省掉一半的无用功。我把它当成这本书的第二条主线——它不只教你怎么让 AI 干得更多,也教你怎么判断「不该让它干」。
顺带说一句第 6 章(计划模式与多代理)只有 32 屏,3.4%,全书倒数第二薄。而这恰恰是最难、最容易出事的一段:什么时候该让它先出计划、计划里该有什么、批准之后怎么保证它按计划走。32 屏讲这些,只能算点了个题。相比之下,第 4 章为了讲清 MCP 的一个 scope 配置,能写一整节。这个篇幅分配说明作者更熟「工具」,不熟「流程」。
六、体例:一本被翻译了两遍的书
前面说过 950 屏是双语对照。这件事值得单独一节,因为它影响你怎么读这本书。
每一屏的结构是固定的:一段英文,紧跟一段中文;图注也是两行,先英文再中文。中文读起来有明显的机翻痕迹——「一个重要的细节是」「这表明环境设置正确」「小贴士」这类句式,是人不会这么写但翻译会这么写的。术语也不统一:hook 一会儿是「钩子」一会儿是 hook,subagent 在正文里叫「子代理」,在标题里叫「子代理智能体」,skill 一律译成「技能」,跟 Claude 官方中文文档里的说法勉强对得上,但跟社区里常说的「Skill」混着用,读的时候要在脑子里做一次映射。
这不是书的错,但它造成两个实际后果。第一,屏数虚高,你以为在读一本 950 屏的大书,实际信息量对折。我不知道有多少人是被「950 屏」这个数字吸引进来的,但如果你按屏数估算阅读时间,会估错一倍。第二,中文读者拿不到准确的术语表。这本书的英文原版是有索引的(末章有 Index,虽然在广告区后面),但中文是机翻叠加的,索引里的词条和正文里的译名对不上,等于没有。
给一个实用的建议:这本书该读英文那一半。中文那半留着核对你没读懂的地方。你会发现读英文反而快——因为英文是原生的,逻辑连贯;中文是把英文逐句拆开重装,读起来像在泥里走。
七、它的结构:前紧后松,最后一章是广告
把 950 屏按章拆开,配比是这样的:第 1 章 46 屏 4.8%,第 2 章 57 屏 6.0%,第 3 章 96 屏 10.1%,第 4 章 154 屏 16.2%,第 5 章 39 屏 4.1%,第 6 章 32 屏 3.4%,第 7 章 122 屏 12.8%,第 8 章 85 屏 8.9%,第 9 章 67 屏 7.1%,第 10 章 87 屏 9.2%,第 11 章 46 屏 4.8%,第 12 章 72 屏 7.6%。
这个曲线是个倒 U:中间(第 4、7 章)最厚,两头渐薄。这个形状本身合理——中间是硬骨头。但末端那一块不该这么厚。
值得想一想的是:为什么第 4 章能写 154 屏,第 6 章只能写 32 屏?我的解释是——因为 MCP 有规格,流程没有规格。MCP 是一份公开协议,有架构图、有传输方式、有 scope 层级、有限制清单,你可以一页一页照着写,写多少页都不空。而「什么时候该让它先出计划」「计划批了之后怎么盯」这类事,没有协议可依,全靠经验,写起来就没底,于是作者很快收了。这也是所有技术书的通病:写得厚的部分,往往不是因为重要,是因为好写。读者如果按篇幅分配注意力,会被系统性地误导——你以为作者最看重 MCP,其实他只是最熟 MCP。
第 12 章叫「Unlock Your Exclusive Benefits」,72 屏,占全书 7.6%,内容是出版社的订阅推销。p0885 那一页是一整版的 Packt 标志,下面写着订阅后可看 7000 多本图书和视频、4000 位行业专家的内容、以及一串「为什么要订阅」的条目。它被编成了第 12 章,进了目录,和「理解深代理」并列。一本讲工程判断的书,用将近 8% 的篇幅卖会员,这是编辑层面的失守,不是作者的失守——但它确实占了你 72 屏的时间和 7.6% 的书价。
还有一处更小的失手,能看出这本书赶工。目录里第 57 条标题是「The future of AI coding: The future of AI coding: a team of specialize…」——同一个标题被复制粘贴了两遍,而且第二遍还断在 specialize 这个词上。这种错误在 Packt 出的快书里很常见:作者交稿、编辑没细看、排版直接跑。它不致命,但它是个信号——连目录都没人通读一遍的书,正文里的数字你敢全信吗?
八、它的短板
第一,示范的分量配不上机制的分量。前面说过 hooks 的例子是「播一声响」、子代理的例子是「审斐波那契」。这不是偶然,是这本书的普遍写法:它用一个最小可运行的东西证明「这个功能存在」,然后就往下走了。读者读完能复述机制,但没法迁移。真正的技术书应该反过来——用一个真实的、恶心的案例,让读者看见机制在压力下怎么工作。
第二,它没算「钱」这笔账。它算了 token:工具定义吃多少、上下文剩多少、CodeMode 省多少往返。这些都很具体。但全书我抽的 8 屏里,没有一处告诉你「跑完一个中等任务大概花多少钱」。第 3 章有「Pricing and plans」一节,讲的是订阅档位,不是任务成本。token 是过程指标,钱是结果指标;一本教人做工程决策的书,只给过程指标,读者没法回答老板那句「这东西一个月要多少预算」。
第三,示例代码不成体系。这本书有一个贯穿的主线项目 HookHub(p0125 那张图就是 Claude 给它出的 MVP 规范:项目概览、MVP 范围、钩子的数据模型、UI 与 UX 要求),这个设计是好的——有一个真项目串着,读者不至于学了就忘。但抽读的几屏里,代码块都是片段:一段 bash 去重脚本、一段 Python 播声音、一段 TypeScript 调工具。片段能说明道理,拼不成一个仓库。你想照着做一个能跑的东西,还得自己去填中间那些没人写的胶水。
第四,它的时效性比它自己承认的更短。版权页写着 2026 年 3 月首版(p0006),书里描述的 CLI 行为、斜杠命令、hooks 事件名,都是那个时间点的快照。而这类工具一个月一个小版本、三个月一次行为变更。作者显然知道,所以写了「Current limitations of MCP」这样的小节,也提到 CodeMode 这种还在演进的东西——但他没有在开头放一句「本书描述的行为以 2026 年 3 月为准,变化请查官方文档」。这一句缺席,会让半年后的读者在某个命令失效时,怀疑是自己操作错了。
第五,中文版是机翻叠加,术语没有统一。上面单独说过,这里只补一句判断:对中文读者,这本书最好的读法是「英文为主、中文为辅」。如果你只看中文那一半,你会得到一本术语混乱、句式生硬、图注重复的书,而它本来不是这样。
九、这本书该怎么用
当「预算表」用。把 p0336 那张图抄下来,改成你自己的版本:列出你现在接的每个 MCP 服务器、每个服务器的工具数、估算的 token 占用,加总,看占了你窗口的百分之几。这个动作花二十分钟,能省掉你后面几个月的「为什么它老是忘事」。大多数「模型变笨了」的抱怨,本质是窗口被工具塞满了。
第 9 章那张对比表要背下来。技能、子代理、MCP、斜杠命令,四个原语各管什么、在哪个上下文里跑。这张表是决策工具,不是知识点。你每接一个新需求,先问一句「这是技能的事还是子代理的事」,能少走很多弯路。
第 4 章的 scope cheat sheet 打印出来。user / project / local 三级配置在哪加载、优先级怎么排,这种东西记不住,但每次配错都要排查半小时。
第 12 章直接跳过。72 屏,一个字都不用看。全书实际可读 878 屏,双语对折之后约等于 440 屏的单语书——按这个体量,它值两天时间,不值一周。
如果只做一件事,做这个:打开你现在最常用的那个项目,看一眼 CLAUDE.md 有多长,再看一眼你接了几个 MCP 服务器。如果文件超过两百行、服务器超过三个,这本书的第 1 章和第 4 章你今晚就能用上——不是学新东西,是收拾旧东西。技术书的价值常常不在「教你多少」,而在「让你想起该清理什么」。
再说说这本书适合谁、不适合谁,因为这个问题比「好不好」更实际。
适合:已经在用 Claude Code、但总觉得它「不稳定」的人。你会在这本书里找到解释——不是模型玄学,是窗口被工具塞满了、是 CLAUDE.md 里的旧规则还在生效、是该隔离的活没隔离。这类读者读第 4、7、9 章,收益最大,因为那三章讲的是「为什么会坏」。
勉强适合:想搭一套团队规范的技术负责人。书里给了可以照抄的骨架(CLAUDE.md 该放什么、技能文件长什么样、子代理怎么配、MCP 怎么按 scope 分层),但没给「怎么说服团队接受这套规范」。后者是管理问题,书不管。
不适合:还没写过一行代码就想「用 AI 做产品」的人。这本书全部的前提是你手里有一个仓库、会读报错、知道什么是依赖和分支。它不教编程,只教怎么把编程这件事交给代理而不失控。顺序错了,读它会很挫败:你会觉得每个例子都懂,但一动手就卡在第一步。
一句话收尾:它教你的不是「怎么让 Claude Code 更听话」,是「怎么在 200k 的窗口里做取舍」;前者是技巧,会过期,后者是工程,能带走。
说明:篇幅占比由 pages.jsonl 逐页章节映射聚合而得(前置 37 屏 3.9%;第 1 章 46 屏 4.8%;第 2 章 57 屏 6.0%;第 3 章 96 屏 10.1%;第 4 章 154 屏 16.2%;第 5 章 39 屏 4.1%;第 6 章 32 屏 3.4%;第 7 章 122 屏 12.8%;第 8 章 85 屏 8.9%;第 9 章 67 屏 7.1%;第 10 章 87 屏 9.2%;第 11 章 46 屏 4.8%;第 12 章 72 屏 7.6%;合计 950 屏)·「双语对照、中文为机器翻译」的判断基于抽读 8 屏的排版目视记录,不排除部分章节另有处理 ·「没有成本实测」的判断限于抽读 8 屏,属抽样结论 · 第 5、6、8、11 章仅按目录与篇幅核对,未逐字展开 · 笔记与图谱生成于 2026-11-10
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: