
生成式人工智能应用实践:十三章,十三种活,一条工作流都没有
微信读书《生成式人工智能应用实践》· 抓取 635 屏 / 13 章 / 115 条目录 · 读到书尾
逐字核对 6 屏 · 书名条与页面一致 · 2026-11-10
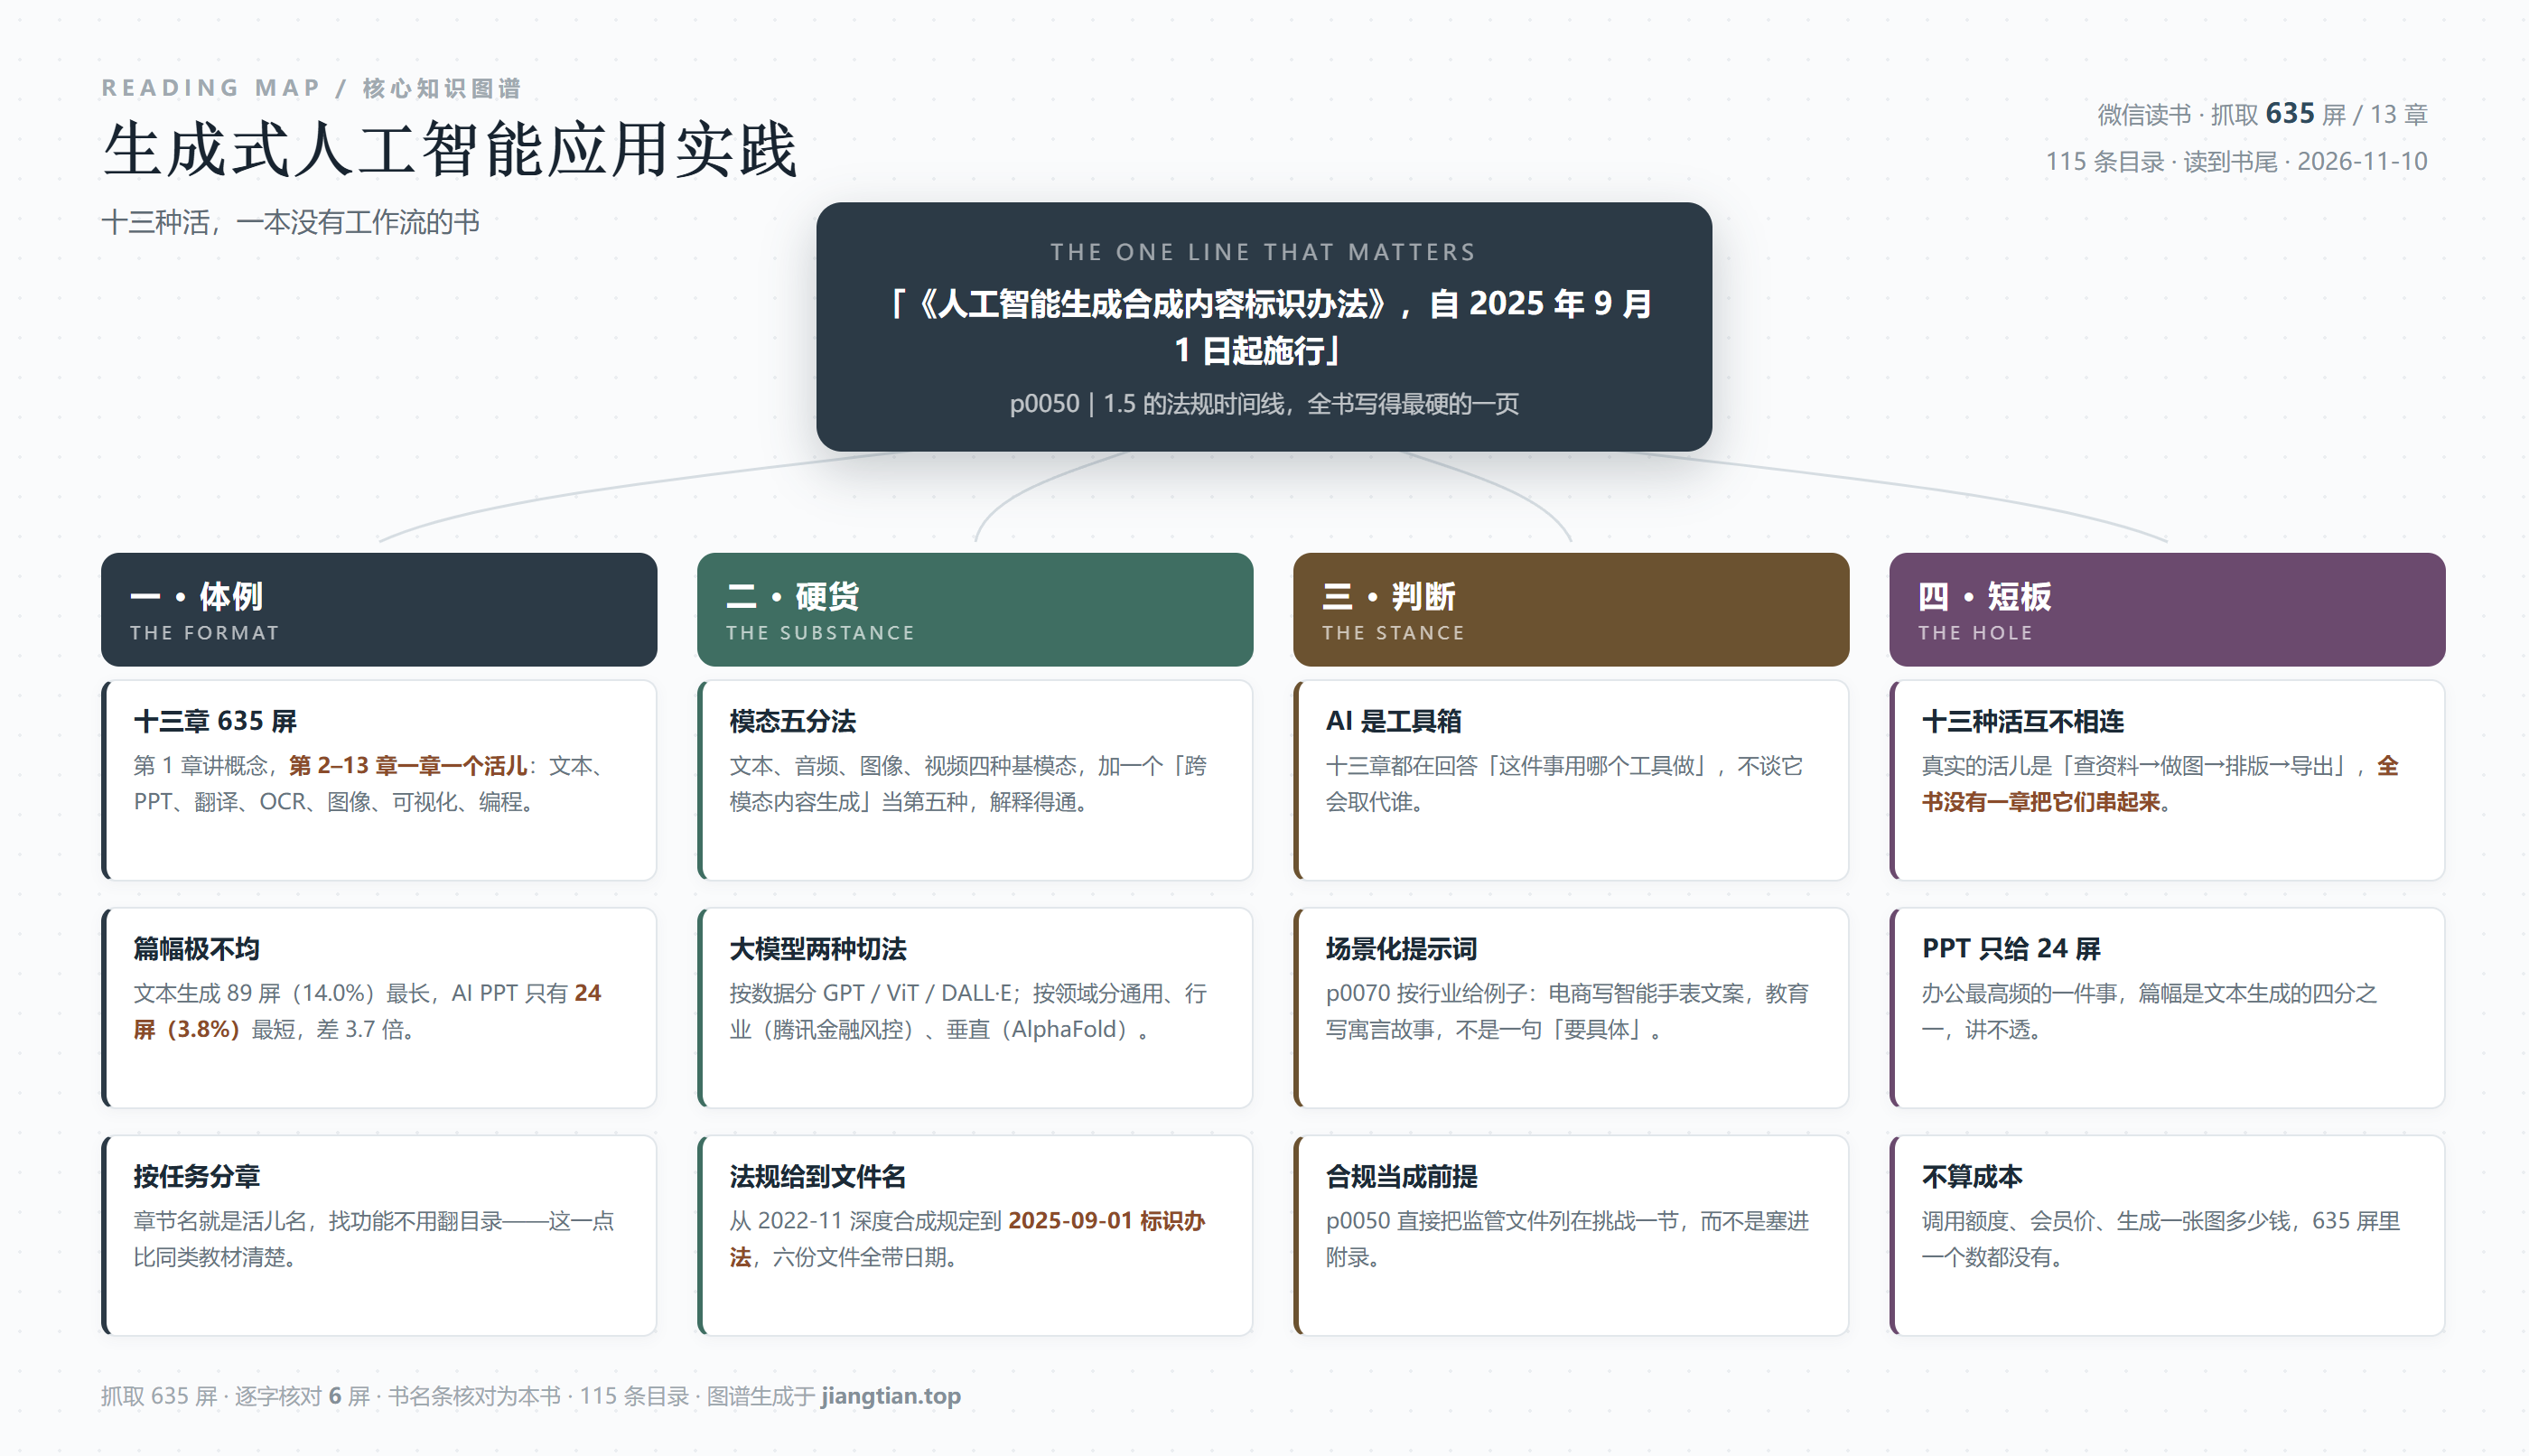
抽样点位的选法:这本书按任务分章,每章一个活儿,所以不能只看一章。我先量了十三章的篇幅(第 2 章文本生成 89 屏最长,第 3 章 PPT 24 屏最短),再按「概念—法规—方法—工具」四个位置各取一屏:p0020(1.2 生成式人工智能的概念,四模态与大模型两套切法)、p0050(1.5 挑战里的法规时间线)、p0070(2.3 提示词工程与场景示例)、p0092(2.4 DeepSeek 的功能分工),另加 p0006 章首页核对书名。抽读 6 屏约占 1%,重点压在两个问题上:它的骨架是不是真的比同类清楚;以及十三种活为什么没被串起来。
这一阵子连着翻了好几本名字里带「AIGC」「生成式人工智能」的教材,多数有个共同毛病:章节按技术名词切,读者学完不知道能干什么。这本《生成式人工智能应用实践》反过来——十三章,一章一个活儿。
第 2 章 AI 文本生成、第 3 章 AI PPT 自动化生成、第 4 章 AI 翻译、第 5 章 OCR 技术及其应用、第 6 章 AI 图像生成、第 7 章 AI 图像编辑、第 8 章 AI 视觉传达设计、第 9 章 AI 数据可视化、第 10 章 AI 图像分析、第 11 章 AI 音频处理、第 12 章 AI 视频处理、第 13 章 AI 编程。
这个目录扫一眼就知道能解决什么问题。想给报告配图,翻第 6 章;想把一堆扫描件变成能搜的文字,翻第 5 章;想把表格变成图,翻第 9 章。它不需要你先理解什么叫注意力机制,才准你打开软件。
一、先说骨架:635 屏,13 章,115 条目录
635 屏分给十三章,平均每章 49 屏,但实际差得很远。我按 pages.jsonl 逐页算过:第 2 章文本生成 89 屏,占 14.0%,是最厚的一章;第 6 章图像生成 69 屏,第 9 章数据可视化 62 屏,第 8 章视觉传达设计 59 屏;最薄的是第 3 章 AI PPT,只有 24 屏,占 3.8%。
115 条目录摊到 635 屏,平均每 5.5 屏一个小节,密度是合适的——比起那些 700 多屏只给 60 多条目录的书,这本查起来舒服得多。这也侧面说明编者的态度:他知道读者是来查的,不是来通读的。
第 1 章 50 屏讲概念,占了 7.9%,五节:1.1 人工智能概述、1.2 生成式人工智能的概念、1.3 生成式人工智能工具、1.4 智能体开发平台、1.5 生成式人工智能面临的挑战。这个安排我很赞成——概念只给一章,够用就走,不占着篇幅装深刻。
二、1.2 那两页,把大模型讲清楚了
p0020 这页我读了两遍,因为它在两段里塞进了两个很有用的框架。
第一个是模态的划分。原文写:「根据生成内容的不同,生成式人工智能可划分为 4 种基础模态,分别涵盖文本、音频、图像和视频。此外,这 4 种模态的融合产生了第五种模态——跨模态内容生成。」这句话解释了一件事:为什么「文生图」不算第五种模态,而「图生文再配音配乐」才算。它把模态的边界画在了「输出形态」而不是「输入形态」上,这个切法经得起推敲。
第二个是大模型的两种切法,而且它把「大」这个字解释对了:「大模型之『大』,表现在参数数量大、数据训练量大和计算资源需求大。」这一句比很多书写得实在——多数书只会说「参数多」,它把数据量和算力也点了出来,这三样才是「大」的全部成本。
接着它给了两条分类轴。按数据类型分:大语言模型(GPT 系列)、计算机视觉大模型(ViT 系列)、多模态大模型(DALL·E)。按应用领域分:通用领域大模型(GPT 系列)、行业大模型(腾讯金融风控大模型)、垂直大模型(DeepMind 的蛋白质结构预测模型 AlphaFold)。
这两条轴的价值在于它们能互相交叉。同样是「金融」,按数据类型看可能是个语言模型,按应用领域看就是行业大模型;AlphaFold 被归到「垂直」,是因为它只干一件事——把氨基酸序列变成三维结构。读者把这两个坐标一叠,就能给自己手上那个项目定位:我是做通用还是垂直,是吃文本还是吃图像。
还有一句写在段末,只有一行:「AI 工具即封装了大模型的、易于用户使用的工具。」这句话看着平淡,其实把整本书的立场说明了——工具是壳,模型是芯,读者要学的是怎么用壳。这也解释了为什么第十三章都在讲活儿,没有一章讲训练。
三、1.5 的法规时间线,是全书唯一一处「别人不敢写」的地方
p0050 是我在这本书里读到的最意外的一页。1.5「生成式人工智能面临的挑战」开篇不讲偏见、不讲失业,先摆了一串法规和文件,而且每一个都带日期:
2022 年 11 月 25 日,《互联网信息服务深度合成管理规定》发布,其中对人脸生成、替换、操控和合成人声及仿声等都有明确约束。2023 年 8 月 15 日起施行的《生成式人工智能服务管理暂行办法》对生成式人工智能服务实行包容审慎和分类分级监管。联合国教科文组织于 2023 年 9 月发布了「Guidance for generative AI in education and research」。2023 年 11 月 1 日,在首届全球 AI 安全峰会上,中国、美国、英国等 28 个国家代表及欧盟出席并联合签订《布莱切利宣言》。2024 年 9 月 9 日,全国网络安全标准化技术委员会制定的《人工智能安全治理框架》1.0 版发布。2025 年 3 月 7 日,国家互联网信息办公室、工业和信息化部、公安部、国家广播电视总局制定了《人工智能生成合成内容标识办法》,自 2025 年 9 月 1 日起施行。
这一段的分量,得放在同类书里比才看得出来。我上个月读过一本 754 屏的装机教材,全书的「伦理」只出现在两篇一页纸的拓展阅读里;还有一本 717 屏的 Visio 教材,讲 AI 时一次都没提合规。而这本书把监管文件当成「挑战」的一部分正面列出来,还精确到「2025 年 9 月 1 日起施行」。
这一条对读者是真有用的。2025 年 9 月 1 日之后,用 AI 生成的图片、音频、视频在平台上发布,需要有标识;做自媒体的人如果不知道这件事,作品被限流都找不到原因。教材把日期写清楚,读者才知道自己手上的项目受哪一条管。
我唯一的意见是:这六份文件摆完之后,正文只写了一句「当前,以生成式人工智能为代表的 AI 应用主要面临以下问题」,就转去讲「信息偏向性问题」了。法规和后面的问题清单之间没有咬合——哪条法规对应哪个问题、违规了会怎样,一句都没有。这一页本来可以是全书最有分量的地方,现在它是一个资料卡。
四、2.3 的场景化提示词,比「要具体」三个字有用
2.3「提示词工程」这一节的写法很朴素:先定义,再给场景。定义部分说「提示词(Prompt,又称指令、咒语)输入是一种与生成式人工智能进行交互的方式」,然后给了一句我认同的判断——「专业知识能够帮助人们深入理解复杂问题的本质,也能够帮助人们更准确地设计提示词」。
2.3.1 直接上例子,按行业分:「(1)电商:为的一款新型智能手表生成一段吸引人的产品描述,突出其健康监测和运动追踪功能。」「(2)教育:以『勇气』为主题,为小学生写一篇简短的寓言故事。」
这两个例子都不长,但结构是对的:对象(新型智能手表/小学生)、任务(产品描述/寓言故事)、约束(突出健康监测和运动追踪/以勇气为主题、要简短)。三个要素齐了,读者就知道「具体」具体在哪三个位置。这比那种列十条原则、每条后面不跟例子的写法强得多。
顺带说一句我对「提示词工程」这个词的看法。这本书的定义是中规中矩的:在不微调模型的情况下,通过设计提示词来控制模型输出行为。但作为一本 2025 年的教材,它没有提「提示词的收益正在被模型能力吃掉」这件事——现在很多模型已经能自己追问「你要什么风格」,那种精心设计的角色扮演式提示词,边际收益比两年前低了不少。教材把提示词写成一门需要长期修炼的手艺,读者学完可能会高估它的门槛。
五、2.4 里那句「要访问网络链接用 Kimi」,我很喜欢
2.4 是「DeepSeek 文本生成多元功能详解」,89 屏那一章的主体。开头有一句交代:「本书主要使用 DeepSeek 进行说明,若需要访问网络链接则使用 Kimi。」
就这么一句话,把两件事说清了:主用哪个,什么时候换。这类教材最常见的问题是全程写「某 AI 工具」,读者不知道去哪注册;好一点的会写「以 DeepSeek 为例」;最好的是这样——不仅说用哪个,还说为什么在某种情况下要换一个。
这个「换」也不是随口的。让模型读一个网页链接,各家支持程度差别很大,有的直接说不能访问,有的能读但只读首屏。教材明说「要访问网络链接就用 Kimi」,等于把一个实际会踩的坑提前标了出来。
2.4.1「自动化文本生成」下面的例子也是这个路子。它不空谈「可以写新闻」,而是给提示词原文:「撰写一篇突发性新闻报道,主题是『市中心大楼深夜突发大火』,关键词包括火灾、紧急疏散、消防救援、目击者证言、伤亡情况、起火原因调查,请聚焦于事件的即时影响、现场情况描述、官方声明与初步调查结果。」六个关键词加三个聚焦方向,这就是一份可以照着改的模板。
六、问题出在哪:十三种活,没有一章把活串起来
这本书的长处和短处,其实是同一个设计带来的。按任务分章让它好查,也让它散。
真实的活儿是什么样的?举个最普通的例子:老板让你做一份季度汇报。你要先去查行业数据(第 2 章、第 5 章),把数据做成图(第 9 章),给 PPT 配几张示意图(第 6 章、第 8 章),写讲稿(第 2 章),配音或者做个短视频版(第 11 章、第 12 章),最后排版成 PPT(第 3 章)。一件事串起了七章。
而这本书十三章是十三个独立房间,每间房里工具齐全,房间之间没有门。你在第 6 章生成的图,怎么带进第 3 章的 PPT?第 9 章做出来的图表,分辨率够不够印?第 5 章 OCR 出来的文字带着排版垃圾,怎么清洗了再喂给第 2 章?这些「交接处」的问题,才是实际做活时最耗时间的部分,全书一章都没讲。
这也是我判断一本「应用实践」类教材好不好用的标准:不看它讲了多少功能,看它有没有一次从头到尾的完整交付。这本书有十三次漂亮的切片,没有一次完整的交付。
七、它的短板
第一,十三章互不相连,没有工作流。按任务分章的好处是好查,代价是没有一章回答「这些工具怎么配合」。读者学完十三章,会十三种单点技能,仍然不会做一件完整的活。补一章「一个项目的全流程」就能救,可惜没有。
第二,篇幅分配和实际需求不匹配。AI PPT 只给了 24 屏、3.8%,是十三章里最薄的;而做 PPT 恰恰是办公场景里最高频、最费时间的一件事。反过来,文本生成拿了 89 屏。这个配比更像是按「技术热度」排的,不是按「用的人多少」排的。
第三,全书不算成本。调用额度、会员价、生成一张图多少钱、跑一次长文档要等多久,635 屏里一个数都没有。读者做完第一个项目,才会发现免费额度已经没了。这一点和法规那一页形成了奇怪的对照:编者知道要写「2025 年 9 月 1 日施行」,却不知道要写「这个月免费额度是多少」。
第四,法规只摆不咬合。1.5 那六份文件列得很准,但列完就转去讲问题清单,没有说明哪条管哪种行为、违规的后果是什么。资料摆在那里,读者得自己去对应。
第五,提示词被高估了。2.3 把提示词工程写成一门需要专业知识和长期训练的手艺。方向没错,但少了另一面:模型自己在变强,很多过去要靠技巧绕的坑,现在直说就行。教材只教「怎么设计」,没教「什么时候不用设计」。
这些短板里,前两条是结构问题,后三条是细节问题。结构问题最难改——要动目录;细节问题本来能补,补了这本书的成色会明显不一样。
八、一句话
这是我近期翻过的同类教材里骨架最清楚的一本:一章一个活儿,找得到、看得懂、能照做,1.2 的概念和 1.5 的法规尤其值钱。但它把 AI 拆成了十三把工具,没教你怎么用这十三把工具做完一件事——它是一本好用的功能字典,还不是一本能带人交活的手册。
抓取:微信读书《生成式人工智能应用实践》,635 屏,710 秒,13 章,115 条目录,读到书尾(reached_end=True)。
逐字核对 6 屏:p0006(第 1 章章首页,书名条核对)· p0020(1.2 四模态与第五种跨模态、大模型两种分类轴)· p0050(1.5 六份法规与文件的时间线)· p0070(2.3 提示词工程定义、2.3.1 电商与教育两个场景示例)· p0092(2.4 导语「主用 DeepSeek,访问网络链接用 Kimi」、2.4.1 突发新闻提示词原文)
说明:各章篇幅由 pages.jsonl 逐页章节映射全量聚合(第 1 章 50 屏 7.9%、第 2 章 89 屏 14.0%、第 3 章 24 屏 3.8%、第 4 章 37 屏 5.8%、第 5 章 29 屏 4.6%、第 6 章 69 屏 10.9%、第 7 章 40 屏 6.3%、第 8 章 59 屏 9.3%、第 9 章 62 屏 9.8%、第 10 章 26 屏 4.1%、第 11 章 54 屏 8.5%、第 12 章 53 屏 8.3%、第 13 章 38 屏 6.0%,前置 5 屏,合计 635 屏);目录 115 条为 meta.json 全量计数;「七章串起一件活」按书内章节编号逐条对应 · 笔记与图谱生成于 2026-11-10
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: