
生成式AI实战:最厚的一章,给了 2022 年的主角
微信读书《生成式AI实战》· 抓取 565 屏 / 7 章 / 169 条目录 · 读到书尾
逐字核对 5 屏 · p0006 前言「本书主要内容」核对为本书 · 2026-11-10
抽样点位的选法:这本书的章篇幅极不均匀(第 3 章 Stable Diffusion 183 屏,占 32.4%;第 7 章伦理只有 27 屏),所以抽样不按章抽,按「三种书里该有的东西」抽:原理(p0072 的 2.2.2 自注意力与掩码)、代码(p0326 的 4.1.2 LangChain 建 Agent 示例)、以及伦理(p0540 的幻觉一节);另加 p0037(1.2.2 生成式模型四类并列)和 p0006(前言的章节说明)。抽读 5 屏约占 0.9%,重点压在三个问题上:这本书的「实战」到底指什么;篇幅配比是怎么排出来的;以及它对「幻觉」这种真问题有没有给出可操作的办法。
这批 AI 教材里,多数是「场景 + 提示词」的路子,讲原理的少。这本《生成式AI实战》不一样:它真讲注意力机制,真给 Python 代码,还把开源案例单独立了一章。565 屏、169 条目录,平均 3.3 屏一个小节,导航密度是这批书里最高的。
但它也有一个很明显的问题:最厚的一章,给了 2022 年最火的那个模型。
一、七章的配比,把这本写在了 2023 年
我先把篇幅算清楚:第 1 章生成式 AI 基础 40 屏(7.1%)、第 2 章 Transformer 和 GPT 模型 82 屏(14.5%)、第 3 章 Stable Diffusion 183 屏(32.4%)、第 4 章 LangChain 与 AI Agent 88 屏(15.6%)、第 5 章生成式 AI 开源应用案例 87 屏(15.4%)、第 6 章行业应用 46 屏(8.1%)、第 7 章伦理道德 27 屏(4.8%),前置 12 屏。
这个配比一望可知:Stable Diffusion 独占近三分之一,比 Transformer+GPT 加起来(82 屏)还多一倍;而 LangChain 与 Agent 只有 88 屏,行业应用 46 屏,伦理 27 屏。
放在 2023 年,这个配比是对的。那时候「生成式 AI」在普通人心里约等于「AI 画图」,Stable Diffusion 是入口,学它的 ControlNet、LoRA、模型选择,确实是硬需求。可这本书是给 2025—2026 年的读者看的。这两年做图这件事已经往对话式走了,真正拉开差距的地方换成了 Agent、RAG、多模态和工程化。一本 565 屏的书,把三成押在一个正在退居二线的工具上,这不是内容错,是重心偏。
我也理解这种偏。SD 那一章好写:有界面、有参数、有出图对比,每一屏都能配图,写起来踏实。Agent 那一章难写:概念在变,接口在变,写三个月就过时。教材天然会往「能配图、不会过时」的地方倾斜。但这恰恰是教材该警惕的——越容易写的章节,越容易把书带偏。
二、自注意力那一页,把「H 个头」讲明白了
p0072 是 2.2.2「GPT 模型的核心技术」。这一节列了四块:自注意力机制、掩码因果关系、优化算法与正则化、模型微调与迁移学习。我重点看了前两块。
关于自注意力,原文写:「自注意力机制是 Transformer 和 GPT 模型的核心组成部分。它允许模型在处理输入序列时关注到其他位置的信息,从而捕捉长距离依赖关系。」这句是标准说法。真正的好东西在下一段:「多头自注意力是自注意力机制的一种改进,通过使用多个不同的线性投影来增加模型的表达能力。具体来说,在多头自注意力中,输入向量首先被分为 H 个头,每个头都有其独立的权重矩阵。之后,每个头分别计算自注意力得分,并将结果重新组合起来,形成最终的输出向量。」
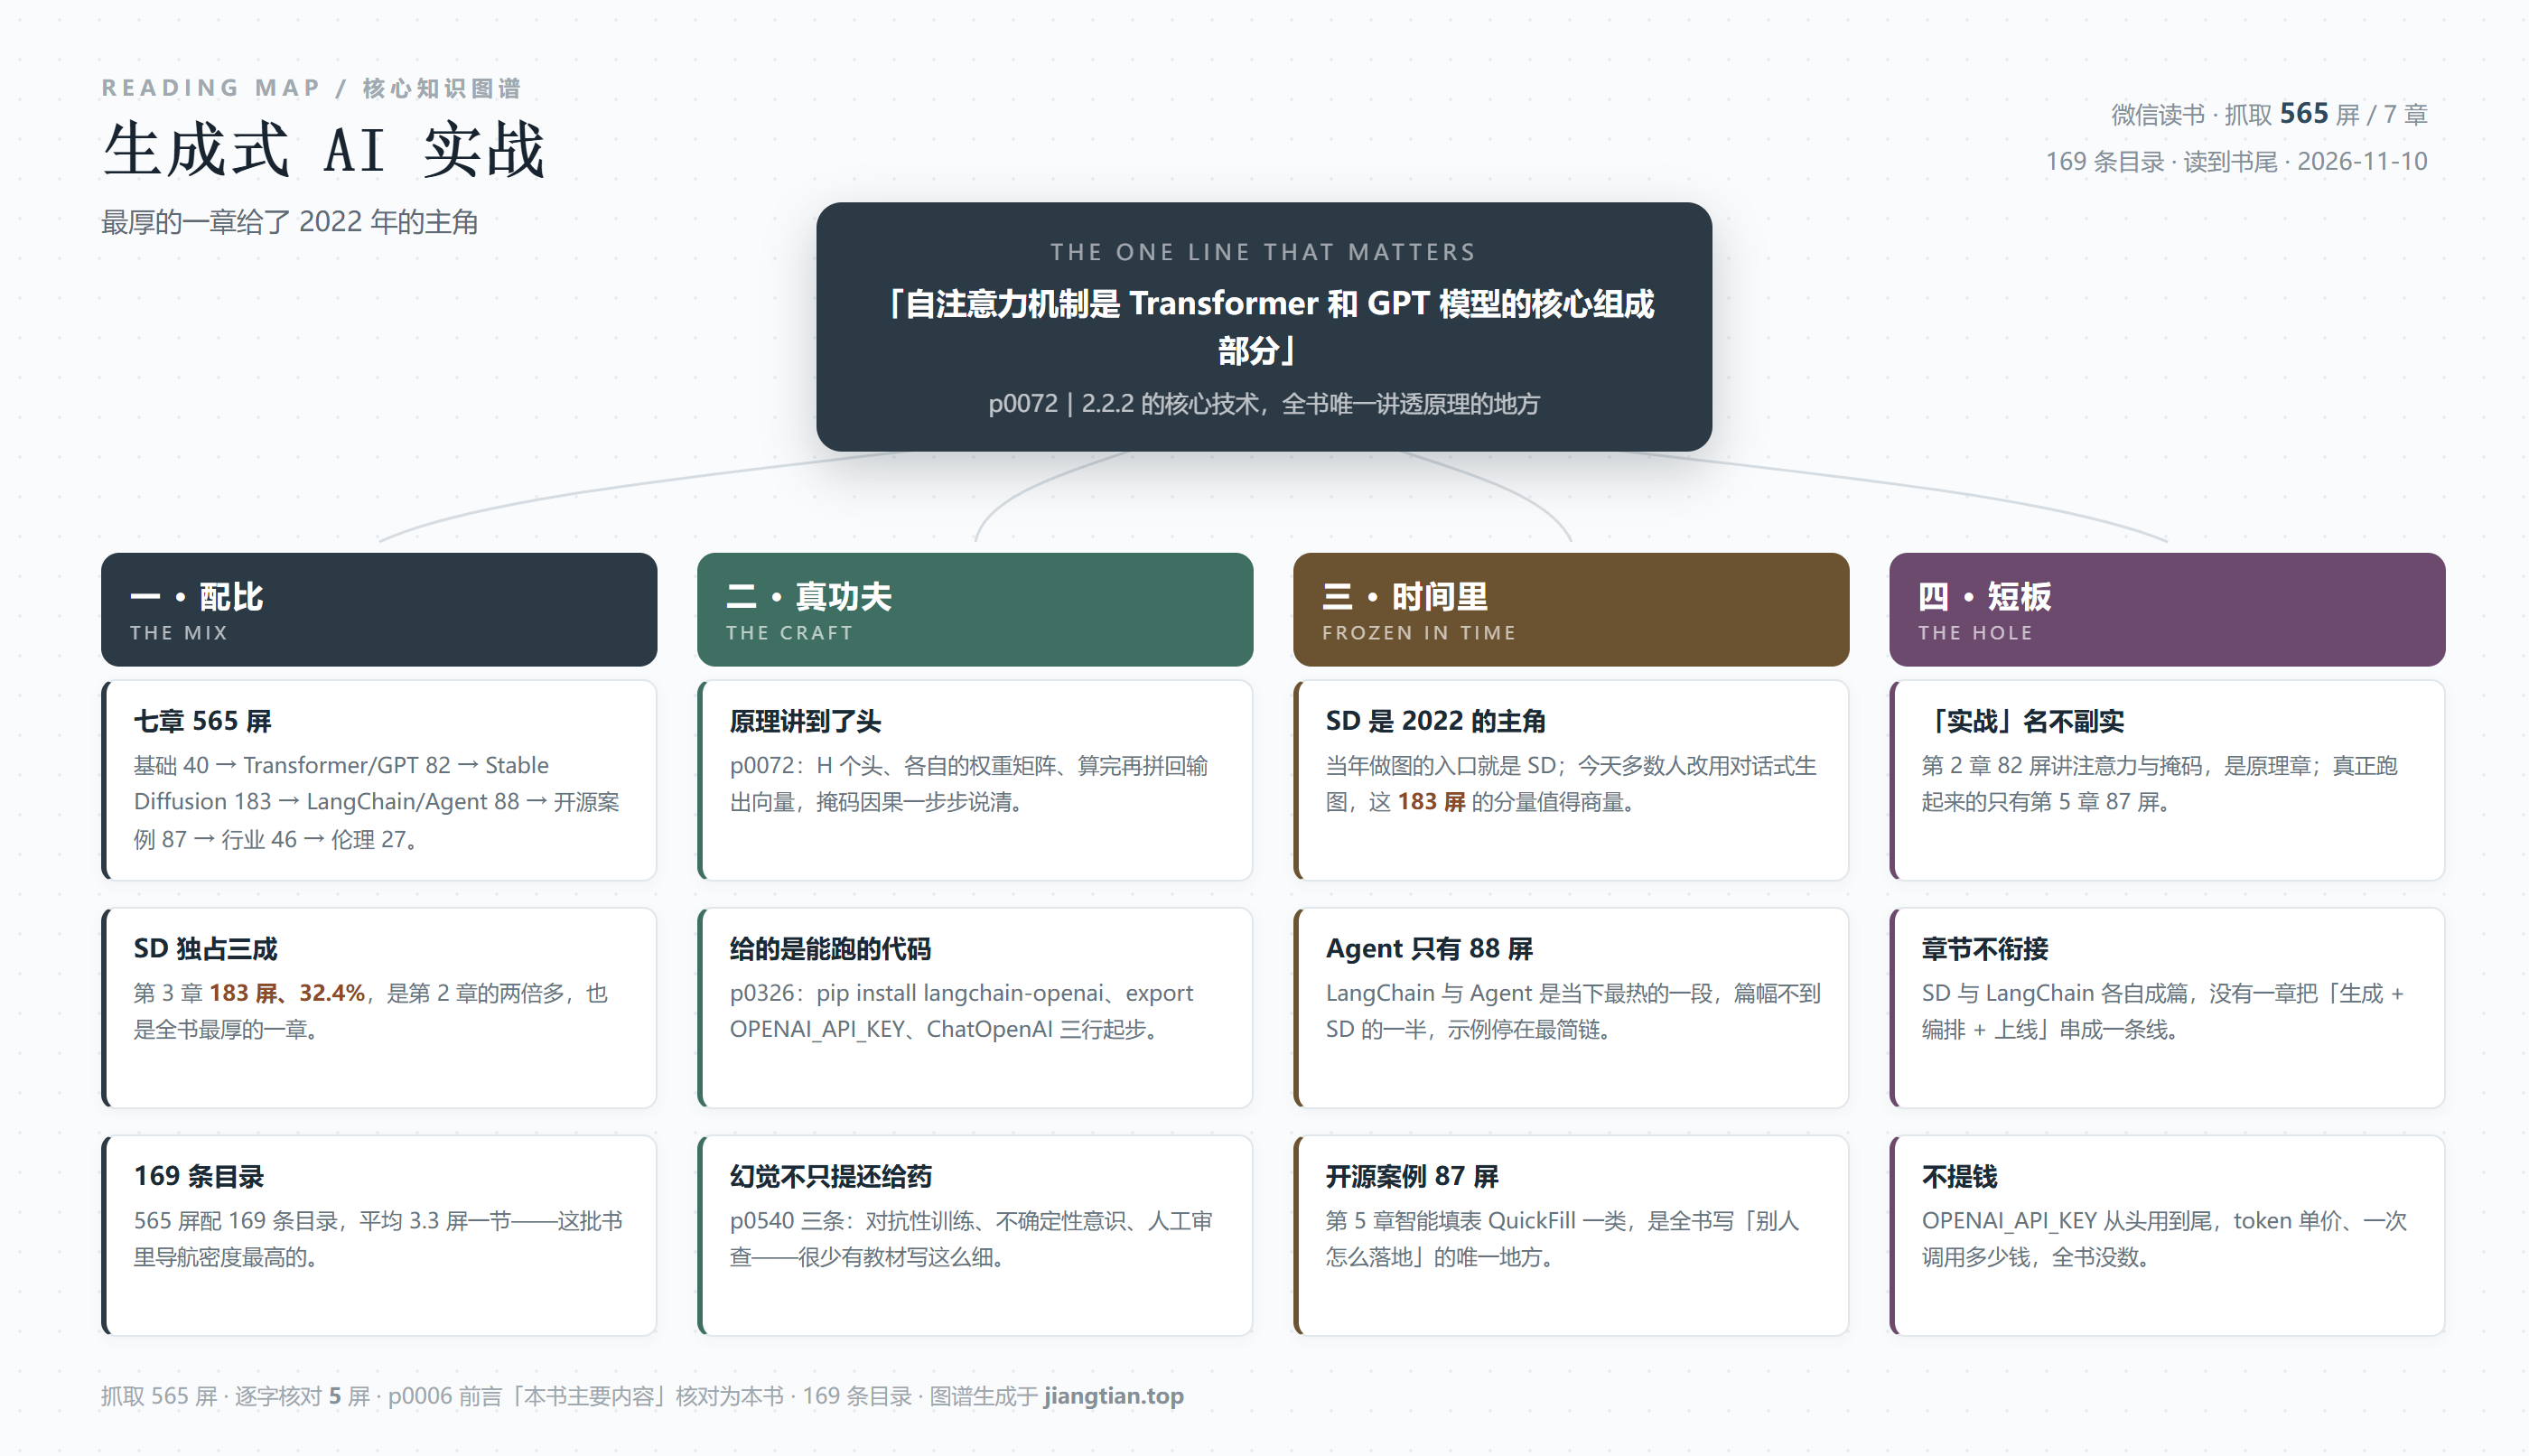
「H 个头、每个头独立权重矩阵、算完再拼回去」——这三句把多头注意力说清楚了,而且没有掉进公式。很多书到这里会直接甩一张 QKV 矩阵图,读者看完记住三个字母,不知道它在干嘛。这本书选了文字路线,读者能自己复述出来。
同一页还讲了一个常被忽略的点:「自注意力机制的一个重要优势是并行计算能力。相比于循环神经网络和长短期记忆网络等顺序处理序列的方法,Transformer 可以同时处理整个序列,从而大大提高计算效率。」这句解释了为什么 Transformer 能取代 RNN——不是因为更准,是因为能并行。这个因果链,很多教程是跳过不讲直接讲架构的。
掩码那一段也实在:「为了防止 GPT 模型在生成过程中产生信息泄露,需要使用掩码来解决因果关系问题。具体而言,在计算自注意力得分时,模型会将未来位置的信息设置为负无穷大。」——「未来位置设为负无穷大」,一句话说清了 causal mask 的全部机制。这是我在这一批教材里读到的最干净的一句技术解释。
三、LangChain 那段代码,是全书最像「实战」的地方
p0326 是 4.1.2「使用 LangChain 构建 AI Agent 示例」。它的结构排得很好:先讲目标,再给代码,代码旁边配解释。
导语写的是:「本节将从一个简单的大语言模型链开始,它仅依赖提示模板中的信息来响应。首先,构建一个检索链,该链从单独的数据库中获取数据并将其传递到提示模板中。然后,添加聊天记录,以创建对话检索链……最后,构建一个 AI Agent——它利用大语言模型来确定其是否需要获取数据来回答问题。」
这是「链式升级」的写法:从最简的一条链,到加检索,到加记忆,到变成 Agent。四步走完,读者能明白 Agent 不是凭空冒出来的东西,是在链上多了一个「自己决定要不要取数」的环节。这个讲法比一上来就画 Agent 架构图有效得多。
然后给代码,第一段是 Shell:pip install langchain-openai,接着 export OPENAI_API_KEY="...";第二段是 Python:from langchain_openai import ChatOpenAI 和 llm = ChatOpenAI(),还注了一句「或采取以下方法导入模型,同时输入密钥」。
这两段代码的价值不在难,在于它是能跑的第一行。绝大多数人卡在「装什么包、密钥放哪」,书上把这两步写出来,后面才有戏。同页下面还有一句测试思路,让读者问它「什么是 LangSmith」——用一个训练数据里不存在的东西去测,看它会不会硬编。这个测试点选得聪明,它顺手教了一种验证方法:拿新东西问模型,看它承认不知道,还是编一个。
四、幻觉那一节,是全书最值钱的四页
伦理章只有 27 屏、4.8%,排在最后,容易被当成附录跳过。但 p0540 那几页值得单独拎出来说。
第二节「幻觉:解决模型生成的虚假信息」开头是一句坦白:「大语言模型面临的另一个挑战是它们倾向于产生幻觉,即模型生成错误或虚构信息的情况。这可能是由于模型固有的生成式似是而非但不准确的文本能力所致。」
「固有的生成式似是而非」——这个措辞很准。它没有把幻觉说成 bug,而说成这种模型的本性:它的任务就是生成「看起来对的下一段」,所以「看起来对」和「真的对」之间天生有道缝。承认这一点,后面的对策才站得住。
它给的对策有三条,我原文抄下来:对抗性训练——「将大语言模型暴露于对抗性输入中,以提高它们区分准确和不准确信息的能力」;不确定性意识——「实施使大语言模型能够量化其输出不确定性的技术,指示幻觉的可能性」;人工审查——「在敏感或关键应用中纳入人工审查机制,以验证大语言模型输出的准确性」。
这三条里,第二条最有意思,也最难实现:让模型自己说「我这句话有多大把握」。业内做了两年,至今没有能直接拿来用的方案。书上把它和对抗性训练并列,看着像同等的三条,其实难度差着一个量级。把「还在研究」和「可以立刻做」放在一起,是教材常见的偷懒——不过它至少把人工审查列了出来,这是唯一一条今天就能落地的。
再往前一页讲的是数据约束与透明度:数据约束要求「仔细策划用于训练大语言模型的数据,以尽量减少包含不准确或误导信息的情况」;透明度是「促进大语言模型开发和运作的透明度,让用户了解所使用的数据来源和训练过程」。这两条是治理层面的,写得不深,但方向没错。
五、「实战」这两个字,撑不撑得住
书名有「实战」。我把各章按「是不是在动手」分了一遍:
第 1 章讲判别式模型与生成式模型(GMM、HMM、GAN、扩散模型),是概念;第 2 章 82 屏讲 Transformer 与 GPT,是原理加三个应用实例;第 3 章 183 屏讲 Stable Diffusion,勉强算实战——如果它讲的是操作的话;第 4 章 88 屏讲 LangChain,有代码,算实战;第 5 章 87 屏讲开源案例,是别人的实战;第 6 章 46 屏讲行业应用,是案例综述;第 7 章 27 屏讲伦理,是讨论。
也就是说,「你自己动手」的部分集中在第 3、4 章,272 屏,48.1%;其余一半多是在讲原理、看案例、谈伦理。这不是坏事,但它跟「实战」两个字对不上。更准确的书名应该是「生成式 AI 原理与工程实践」——那样读者就不会抱着「照着做一本书就能出活」的期待进来。
p0006 前言里其实说得很老实。它逐章交代:「第1章介绍了生成式AI技术的基础工具……第2章介绍了Transformer模型的基础知识、GPT的发展历程及基本原理。此外,还向读者介绍了使用ChatGPT的方法。最后,通过3个实际案例展现了Transformer和GPT模型的强大应用能力。」——用的词是「介绍」「了解」,不是「做出」。前言是诚实的,封面是热闹的。
六、它的短板
第一,重心停在 2022。写着「实战」,却把 32.4% 的篇幅给了 Stable Diffusion,而 Agent 只有 15.6%、行业应用 8.1%。读者今天最需要的三件事——怎么让 AI 自己查资料、怎么接进自己的系统、怎么控制成本——合起来不到三成。
第二,章与章不衔接。SD 那一章讲出图,LangChain 那一章讲编排,中间没有一条线把它们连起来。真实项目里,「用 SD 出一批图,再用 Agent 自动挑图配文」是很常见的组合,书里没这个环节。
第三,不提钱。代码从第 4 章起就绕不开 OPENAI_API_KEY,可 token 单价、一次调用大概多少、跑通一个 demo 要花几毛还是几块,565 屏里没有一个数。对自学者,这是最容易卡住的地方。
第四,没有降级路径。代码直接指向在线接口,读者若遇到网络不通、额度不足、库版本变更,书上没有替代方案。教学代码最怕这个:学生第一步就没跑起来,后面全废。
第五,伦理章的处理太轻。27 屏、4.8%,还排在最后。可这本书前面教的是「怎么生成」,生成能力越强,伦理越不是附录。前面几本教材里,有一本把六份监管文件连日期一起列了出来(2022 年 11 月的深度合成规定到 2025 年 9 月的标识办法),这本书一份都没提。
公道话说在前面:这本书的技术功底在这批里是拔尖的。它能把多头注意力用三句中文讲清、把 causal mask 说成「未来位置设为负无穷大」、把幻觉说成「固有的生成式似是而非」,这些都不是抄来的句子,是作者真读懂了才写得出的。它的问题不在懂不懂,在排布——把 2023 年的重心,原样搬到了 2026 年的书里。
七、一句话
想搞懂 Transformer 到底在算什么、想第一次把 LangChain 跑起来、想知道幻觉为什么是这种模型的本性——这本书在这三件事上比大多数同类书都强。但如果你要找的是「今天怎么用 AI 干活」,它会把你带回到 2022 年的那间出图机房:它讲透了一个正在退场的入口,却没讲清正在上场的那个。
抓取:微信读书《生成式AI实战》,565 屏,641 秒,7 章,169 条目录,读到书尾(reached_end=True)。
逐字核对 5 屏:p0006(前言「本书主要内容」,逐章交代)· p0037(1.2.2 生成式模型:GMM/HMM/GAN/扩散模型四类并列,图 1-2 HMM 状态迁移)· p0072(2.2.2 自注意力、多头注意力的 H 个头、掩码因果「未来位置设为负无穷大」)· p0326(4.1.2 LangChain 建 Agent:四步链式升级、pip install langchain-openai、ChatOpenAI 初始化、用 LangSmith 做测试)· p0540(第 7 章:数据约束与透明度、幻觉三条对策)
说明:各章篇幅由 pages.jsonl 逐页章节映射全量聚合(第 1 章 40 屏 7.1%、第 2 章 82 屏 14.5%、第 3 章 183 屏 32.4%、第 4 章 88 屏 15.6%、第 5 章 87 屏 15.4%、第 6 章 46 屏 8.1%、第 7 章 27 屏 4.8%,前置 12 屏,合计 565 屏);「动手章 272 屏 48.1%」= 第 3 章 183 + 第 4 章 88,另加第 5 章的开源案例 87 屏作对照;目录 169 条为 meta.json 全量计数 · 笔记与图谱生成于 2026-11-10
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: