
生成式AI入门与AWS实战:给了 392 台 A100,没给一张账单
微信读书《生成式AI入门与AWS实战》· 抓取 494 屏 / 12 章 / 105 条目录 · 读到书尾
逐字核对 7 屏 · p0006 为 O'Reilly 赞誉页,书名条核对为本书(目录名与真实书名一致)· 2026-11-10
抽样点位的选法:这是一本 O'Reilly 的技术书,骨架是「原理 → 训练 → 优化 → 应用 → 托管服务」,每章末尾都有小结,读起来是一条很清楚的上坡路。我先取了两头(p0020 第 1 章导语、p0494 全书最后一屏),再顺着「数字最密」这条线索取了三处(p0121 第 4 章导语的 Falcon 集群配置、p0132 的 fp32/fp16 位宽表、p0442 第 12 章 Bedrock 的模型清单),另外专门补了两处「作者讲边界」的段落(p0255 第 8 章导语的三个问题、p0289 的 9.1 局限性),以及 p0039 的 1.5「为什么选择基于 AWS」和 p0189 第 6 章导语的 PEFT 分类。重点压在三个问题上:一是这本书给的数字到底硬到什么程度;二是它自己提出的问题有没有被自己回答;三是「入门」和「实战」这两个词,各自兑现了多少。抽读 7 屏约占 1.4%。各章屏数是用 pages.jsonl 的逐页章节映射做的全量聚合,不是抽样估的。
先给结论:这是一本写得很认真、译得也算用心、但把最要紧的那笔账跳过去了的书。它在第 4 章的导语里,用两句话交代了一个 400 亿参数模型需要多大的集群——384 张 A100、48 台 ml.p4d.24xlarge;然后顺手补了一句「最新版本是 3136 张 A100、392 台」。数字给得这么具体,读者自然会想问下一个问题:这 392 台机器跑一小时多少钱?训完这一个模型,账单是几位数?
这本书没有回答。全书 494 屏,没有一处报价。
一、先说公道话:这十二章是真下过功夫的
在批评之前,得把它的好处说清楚,否则后面的批评会显得不公道。
第一,这本书的数字是自洽的。p0121 那句「原始 400 亿参数的 Falcon 由 384 张 NVIDIA A100 GPU、15 TB GPU RAM 和 55 TB CPU RAM 组成的 48 台 ml.p4d.24xlarge Amazon SageMaker 实例集群上训练」,紧跟着一句「(撰写本书时)最新版本的 Falcon 是由 3136 张 NVIDIA A100 GPU、125 TB GPU RAM 和 450 TB CPU RAM 组成的 392 台 ml.p4d.24xlarge 实例集群上训练的」。383 张配 48 台,3136 张配 392 台——两处都正好是「每台 8 卡」,48×8=384,392×8=3136。这个数对得上,说明作者不是随手抄的新闻,是把集群配置算过一遍的。
第二,它的章节纪律很好。12 章,105 条目录,每一章末尾都有「小结」。这不是小事。技术书最怕的就是读者读到第 7 章已经忘了第 3 章讲什么,每章收一次口,等于给了一次回头的机会。十二章十二次小结,这个动作在同类书里并不普遍。
第三,它讲原理的地方,用的是能看懂的方式。p0132 讲 fp16 为什么省显存,没有停在「精度降低所以省空间」这种话上,而是给了表 4-3:fp32 是「1 位符号 + 8 位指数 + 23 位小数」,fp16 是「1 位符号 + 5 位指数 + 10 位小数」,然后一句「由于指数和小数的位数减少,fp16 数字的可表示范围仅为 -65504~65504」,最后给一行代码 torch.finfo(torch.float16)。给范围、给位数、给验证方法——这是一个完整的解释闭环。读者不需要相信作者,可以自己跑一行代码验证。
第四,也是我最认可的一点:它有几处肯承认边界。p0286 讲 RAG 与微调的取舍,给了一句真正有用的判据:「如果需要访问外部数据或动态数据,那么,由于 RAG 已可以满足需求,因此不需要进行成本较高的持续微调。」这句话的价值在于它是决策规则,不是功能介绍。它告诉你什么时候不用做某件事,这比告诉你「微调很强大」要有用得多。同一页还有一句「RAG 和微调可以一起使用,它们并不互斥」——这句是在纠一个常见的误解,很多人以为这两个是二选一。
所以这不是一本糊弄的书。它有真东西。问题在于,它的真东西集中在「怎么算」,而一本叫「实战」的书,读者最需要的其实是「怎么算账」。
二、392 台 A100:全书最硬的一处数字,也是最扎心的一处
我把 p0121 那段话读了三遍,因为它在这本书里的位置很特殊——它是第 4 章「显存和计算优化」的导语,也就是全章的开场白。作者用一整个段落告诉你:训练一个 400 亿参数的模型,要 392 台机器、3136 张卡、125 TB 显存、450 TB 内存。
这段话说得非常好,好在它不回避规模。很多技术书讲分布式训练,会说「需要多卡并行」「需要大显存」,读者看完对「大」没有概念。这本书给了一个可以握住的东西:392 台。你可以想象 392 台机器排在一起是什么场面,这个数字有物理感。
但它停在了「有多少台」,没走到「多少钱」。而这两件事之间只隔一个乘法。ml.p4d.24xlarge 是 AWS 上一个公开报价的机型,任何人都能查到它的按需单价;392 台乘以单价乘以小时数,就是一次训练的成本区间。这本书手上握着全部原料,唯独没有做这道乘法。
我不认为这是作者不会算。更可能的解释是:书是写给「用 AWS 的人」的,而用 AWS 的人打开控制台就能看到价格,作者觉得不必写。这个理由在 2019 年成立,在现在不成立——因为这本书的读者不是已经在用 AWS 的人,是打算开始用的人。p0039 的 1.5 节标题就叫「为什么选择基于 AWS 构建生成式 AI」,它给出的四条理由是:提高选择的灵活性、企业级的安全和治理能力、先进的生成式 AI 能力、持续创新的能力。四条理由,一条都没提钱。
这四条理由,每一条都是对的,但每一条都不是决策依据。「灵活性」「安全性」「先进性」「持续创新」——这四个词可以原样搬到任何一家云厂商的官网上,一个字都不用改。真正让人做决定的那个数——同样的活,在 AWS 上做和在别处做,账单差多少——书里没有。而这一节在全书里的位置很关键:它是第 1 章,是读者建立第一印象的地方。第一印象是四个形容词,后面十一章都在讲技术细节,读者读到最后也不会知道这东西到底贵不贵。
三、8.1 提了三个问题,全书没有一处回答
最能说明这本书「知道该问什么、但没答」的证据,在第 8 章的导语。p0255 原话:
「在部署模型前,应了解模型可能需要的相关资源及预期的交互体验。为了评估模型需要的资源,需要思考 3 个问题:模型的推理速度如何?为计算资源设定的预算是多少?为了获得更快的推理速度以及更低的存储成本,愿意对模型能力做出何种妥协与权衡?」
这三个问题提得非常准。第一个是性能,第二个是成本,第三个是权衡——正好是一个工程决策的全部要素。而且第三个问题问得尤其好:「愿意对模型能力做出何种妥协与权衡」,这句话承认了工程不是求最优,是求够用。一个能写出这句话的人,是懂工程的。
然后这一章讲了什么?剪枝、量化、蒸馏。这三种技术都对,都是降成本的手段。但整章没有一处把「成本」落到数字上:剪枝能省多少显存、量化之后延迟降多少毫秒、蒸馏之后准确率掉几个点、这些变化折算成钱是多少。三个问题摆在章首,三十一屏技术讲完,一个问题都没合上。
这个模式在第 4 章重复了一次:给了 392 台的配置,不给单价。在第 9 章又重复了一次:讲 RAG 能解决幻觉和知识截断,不讲 RAG 引入的检索延迟和向量库成本。三次都是同一个动作——把问题的框架搭好,把答案留在门外。
我理解技术作者为什么容易这样。技术是确定的,可以写清楚;成本是不确定的,跟区域、跟预留实例、跟当时的促销、跟你的谈判能力都有关,写死了就会错。但「不确定」不等于「不能写」。写「按某年某月的公开按需价,这个规模的小时成本在四位数美元量级」,比不写要好得多——读者至少知道自己在看一个什么量级的东西。给一个会过期的区间,比给一个永远正确的空白,有用。
四、「局限性」这一节,只挑了 RAG 能治的两个
p0289 是 9.1「大语言模型的局限性」的开头。原话:「大语言模型在获取准确的和最新的知识方面存在一定的局限性。本节聚焦于可以通过 RAG 来改进的两个常见问题——幻觉和知识截断。」
这句话写得非常坦白,坦白到把方法论暴露了:这一节不是按「模型有哪些局限」来组织的,是按「哪些局限能用 RAG 治」来筛的。筛完只剩两个:幻觉、知识截断。
但大语言模型的局限远不止这两个。至少还有三个同样致命、而且 RAG 治不了的:成本(长上下文和多轮对话的 token 消耗是线性涨的)、延迟(生成式输出是一个 token 一个 token 吐出来的,首字延迟和总时长都不可压缩)、不可控(同样的输入,两次输出可能不一样,这在需要审计的场景里是硬伤)。
这三条,一条都没进「局限性」这一节。而它们恰恰是落地时最先撞上的墙。幻觉是质量问题,可以靠 RAG 和人工审核缓解;成本、延迟、不可控是工程问题,绕不过去,只能设计规避。一本叫「实战」的书,把质量问题写了,把工程问题留白了。
p0289 那个幻觉的例子倒是举得很实在。提示是「What does the dog breed snazzy-fluffykins look like?」,模型的补全是「The snazzy-fluffykins is a small, fluffy dog with curly fur. They have big round eyes and long, fluffy ears.」——「snazzy-fluffykins」这个犬种根本不存在,是作者编的,模型照样一本正经地描述了它的毛色、眼睛和耳朵。这个例子的好,在于它给出的不是「模型可能出错」这种警告,是一个可复现的实验。读者可以自己拿这句话去问任何一个模型,看它是不是也会编。这比任何形容词都有说服力。
顺带说一句,这个例子的提示词和补全都是英文原文,中译本没有翻译。全书类似的代码块、提示词、输出示例,基本都保留了英文。对一本技术书来说这不算错——代码本来就该是英文——但提示词和自然语言输出不是代码,保留原文会让中文读者多一层翻译负担,尤其是在讲「提示词怎么写」的第 2 章。
五、「实战」两个字,被压缩在第 12 章的 54 屏里
书名是《生成式 AI 入门与 AWS 实战》。「入门」和「AWS 实战」是两个承诺,得分开算账。
先说「AWS」这笔账。全书 12 章 494 屏,AWS 真正作为主角出现的地方,我数出来是五处:1.4「AWS 上的生成式 AI」、1.5「为什么选择基于 AWS 构建生成式 AI」、1.6「在 AWS 上构建生成式 AI 应用程序」(三节挤在第 1 章 26 屏里)、4.6「基于 AWS 的分布式计算」、8.3「AWS Inferentia:专为推理而打造的硬件」,加上第 12 章 Bedrock 的 54 屏。
也就是说,除了第 12 章,AWS 在其余十一章里基本是个配角,偶尔被提一句。第 2 章讲提示工程,用的例子是通用的;第 3 章讲 Transformer,讲的是论文里的架构;第 5 到 7 章讲微调、LoRA、RLHF,讲的是 Hugging Face 那套生态;第 10、11 章讲多模态和 Stable Diffusion,讲的是 Stability AI 的模型。这些内容全都对,但它们跟 AWS 的关系,就像「学开车」和「学开丰田」的关系。
第 12 章那 54 屏(占全书 10.9%)才是真正的 AWS 部分。它讲了什么?12.1 Bedrock 基础模型(支持 AI21 Labs、Anthropic、Cohere、Meta、Stability AI 等第三方的模型,加上亚马逊自研的 Titan)、12.2 Bedrock 推理 API、12.3 大语言模型推理 API、12.4 通过 Bedrock 进行微调、12.5 创建 agent、12.6 多模态模型、12.7 数据隐私和网络安全、12.8 治理和监控。
p0442 有一句很典型的写法:「可以通过 AWS 管理控制台、AWS CLI 或 AWS SDK 访问这些基础模型。本章的代码将使用 Amazon Bedrock 的 Python SDK(boto3)。你可以使用 Bedrock Python 函数 list_foundation_models() 查看最新的可用模型列表。」然后一句「请记住,在评估不同的模型时,应首先尝试第 2 章和第 10 章中讨论的各种提示工程技术」。
这段写得挺诚实——它让读者去看第 2 章和第 10 章,没有假装 Bedrock 能解决一切。但它的形态是产品说明书:哪个 API 调什么、哪个函数列模型、哪个页面在哪里。54 屏讲完,读者知道了 Bedrock 有哪些能力,仍然不知道「我的这个项目,该不该用 Bedrock,还是自己搭」。这个判断需要成本数据、需要延迟数据、需要运维人力的估算——正好是前面几节缺的那些。
再说「入门」这笔账。这本书最难的三章是第 4 章(显存与计算优化,41 屏)、第 7 章(RLHF 微调,42 屏)、第 3 章(大语言基础模型,34 屏)。第 7 章从「与人类价值观对齐:有用的、诚实的、无害的」一路讲到「训练自定义奖励模型」「通过人类反馈进行强化学习微调」「评估 RLHF 微调模型」。这是研究岗的活。一个真正的入门读者,读到「训练自定义奖励模型」这一节,会觉得离自己很远——他没有标注团队,没有偏好数据集,也不会去动 PPO 的超参。
而入门读者真正需要的三件事——该选哪个模型、一次调用多少钱、什么情况下别用云——分别对应第 3 章、第 8 章和一本不存在的章节。第 3 章讲的是 Transformer 架构和缩放定律,不是模型选型;第 8 章讲了部署优化,没讲报价;「什么情况下别用云」这一章,从头到尾没有。
六、时间戳:CodeWhisperer、SD 2、Chinchilla
这本书有一个绕不过去的问题:它写的是一段正在快速变化的技术。
p0020,第 1 章的导语,列举 AWS 的生成式 AI 服务:「包括 Amazon Bedrock、Amazon SageMaker、Amazon CodeWhisperer、AWS Trainium 和 AWS Inferentia」。CodeWhisperer 这个名字,在 2024 年 4 月已经被并入 Amazon Q Developer,不再单独存在。一本 2026 年还在卖的书,正文里还在用一个已经消失的产品名,这不是作者的错,是出版流程的问题——但从读者的角度,这就是一条过期信息。
再往后看。第 10 章 10.8「Stable Diffusion 2 架构」、10.9「Stable Diffusion XL 架构」,两节专门讲 SD 2 和 SDXL 的结构。第 11 章讲 ControlNet 和通过 RLHF 做人类偏好对齐。第 3 章 3.7 讲缩放定律,3.8 讲「计算最优模型」——这是 Chinchilla 那篇论文的结论,2022 年的东西。第 6 章 6.2 讲 LoRA 和 QLoRA。
这些内容在写的时候都是前沿,现在都成了「技术史」。SDXL 之后又出了 SD3、Flux;Chinchilla 的最优配比早被后来的实践推翻过几轮;LoRA 现在是最基础的手段,往上还有 DoRA、各种 adapter 变体。一本书不能永远新,但一本书可以选择「讲哪些不容易过期的部分」。这本书的选择正好相反:它把大量篇幅给了具体的模型版本(SD 2、SDXL、Titan、Falcon),而这些东西的保质期是按月算的。
作者自己其实是知道这件事的。p0121 那句「(撰写本书时)最新版本的 Falcon」,括号里那五个字就是证据——他知道这个数字会变,所以标了个时间戳。这个括注很诚实,也很无奈:它等于承认了「这本书的一部分内容,在印出来的那一刻就开始过期了」。问题是,既然知道,为什么不做一次版本更新?中译本出版时,SD 2 已经出了两年,CodeWhisperer 已经改名,这些改动的工作量并不大。
七、一处小疏漏,和一处大空白
小疏漏在 p0189。第 6 章导语讲 PEFT 的分类:「一篇关于 Scaling 的论文探讨了各种 PEFT 和类别。这些 PEFT 虽然在实现上有所不同,但它们通常都是将模型的所有或大部分原始参数冻结,并通过训练一组额外的、更小的参数来扩展或替换模型层。其中,最常用的 PEFT 属于 Additive 和重参数化类别。」
「一篇关于 Scaling 的论文」——没有作者、没有年份、没有编号、没有出现在任何参考文献里。这是一本 O'Reilly 的书,这是一本讲机器学习方法的书,引用一篇论文只用「一篇关于 Scaling 的论文」来指代,等于没引。我翻了一遍 105 条目录,没有「参考文献」,没有「索引」,一条都没有。十二章讲下来,所有的论文、数据集、模型,全部靠正文里的自然语言提及,读者想追源头无处可追。
大空白在「什么情况下别用它」。这是全书最缺的一章,而且它本该是最值钱的一章。
一本云厂商生态的书,最容易犯的错是把「用云」当成默认选项,只在「怎么用」上做文章。这本书在这一点上比很多同类书做得好——p0286 那句「不需要进行成本较高的持续微调」,就是在劝你别做某件事。但它只劝了一次,而且劝的是「别微调」,不是「别上云」。
真该写的是这些:什么规模的团队适合直接调 API,什么规模必须自建推理集群;延迟敏感的场景(比如实时对话)为什么托管服务不一定最优;数据不能出内网时,Bedrock 的「数据隐私和网络安全」(12.7 节)到底保障了什么、没保障什么;以及最现实的一条——一个日调用量不到一万次的应用,用它自己的服务器跑一个 7B 模型,和用托管 API,哪个账单更小。
这些问题,书的材料全都够,一处都没问。
八、它的短板
第一,给了规模不给成本。p0121 把 392 台机器、3136 张卡、125 TB 显存全写出来了,唯独没写这一小时的价钱。8.1 把「为计算资源设定的预算是多少」列为必答三问之一,全书没有一处回答。这是最要命的一处:一本「实战」书,读者最想带走的就是这个数。
第二,「局限性」是按「能不能用 RAG 治」筛的。p0289 明说了「本节聚焦于可以通过 RAG 来改进的两个常见问题」,于是幻觉和知识截断进了,成本、延迟、不可控没进。后者才是落地时最先撞上的墙。
第三,「AWS」被压成了五节加一章。1.4/1.5/1.6 三节挤在第 1 章的 26 屏里,加上 4.6、8.3,再加第 12 章 54 屏。其余十一章是模型原理综述,讲的是 Transformer、Chinchilla、LoRA、RLHF、SD,跟具体哪家云关系不大。书名里的「AWS」,实际承担的是 10.9% 的篇幅。
第四,入门定位和执行错位。第 7 章 42 屏讲训练奖励模型和 PPO,这是研究岗的活;而入门读者需要的「怎么选模型」「一次调用多少钱」,没有专章。这本书更像一本「给中级工程师的参考手册」,被贴了「入门」的标签。
第五,没有参考文献。105 条目录里没有「参考文献」也没有「索引」,p0189 引用一篇论文只写「一篇关于 Scaling 的论文」。技术书可以不给脚注,但不能连一张文献表都没有。
这本书该给谁读?我的判断是:给已经有 AWS 账号、手上有一个具体项目要落地、需要一本把 12 个环节串起来的中级工程师。他读这本书,能知道从用例定义到微调到部署到托管的完整链条,知道每一环有哪几种做法,遇到具体问题时知道去哪一节翻。这个价值是实的。
但如果一个刚入门的人问我该不该从这本开始,我会说:可以先读第 1、2、9 章,把「生成式 AI 的项目生命周期」「提示工程」「RAG 与 agent」看明白,然后去查你想要的那个模型的实际报价,再决定要不要读完剩下的九章。因为这本书教了你所有「怎么做」,唯独没教你「做这个要花多少钱、值不值」——而后者才是决定你要不要开始的那一步。
最后一屏(p0494)是「全书完」和一个评分卡:微信读书推荐值 0%,「评分不足」,下面一行小字「18 人点评」。一本书在中文读者里几乎没有回声,不代表它不好——技术书的读者本来就窄。但这个数字至少说明一件事:这本书没有找到它的读者。而它没找到读者的原因,可能正好和它最大的短板是同一个:想学的人被第 7 章的 PPO 挡在门外,要用的人拿不到那张账单。
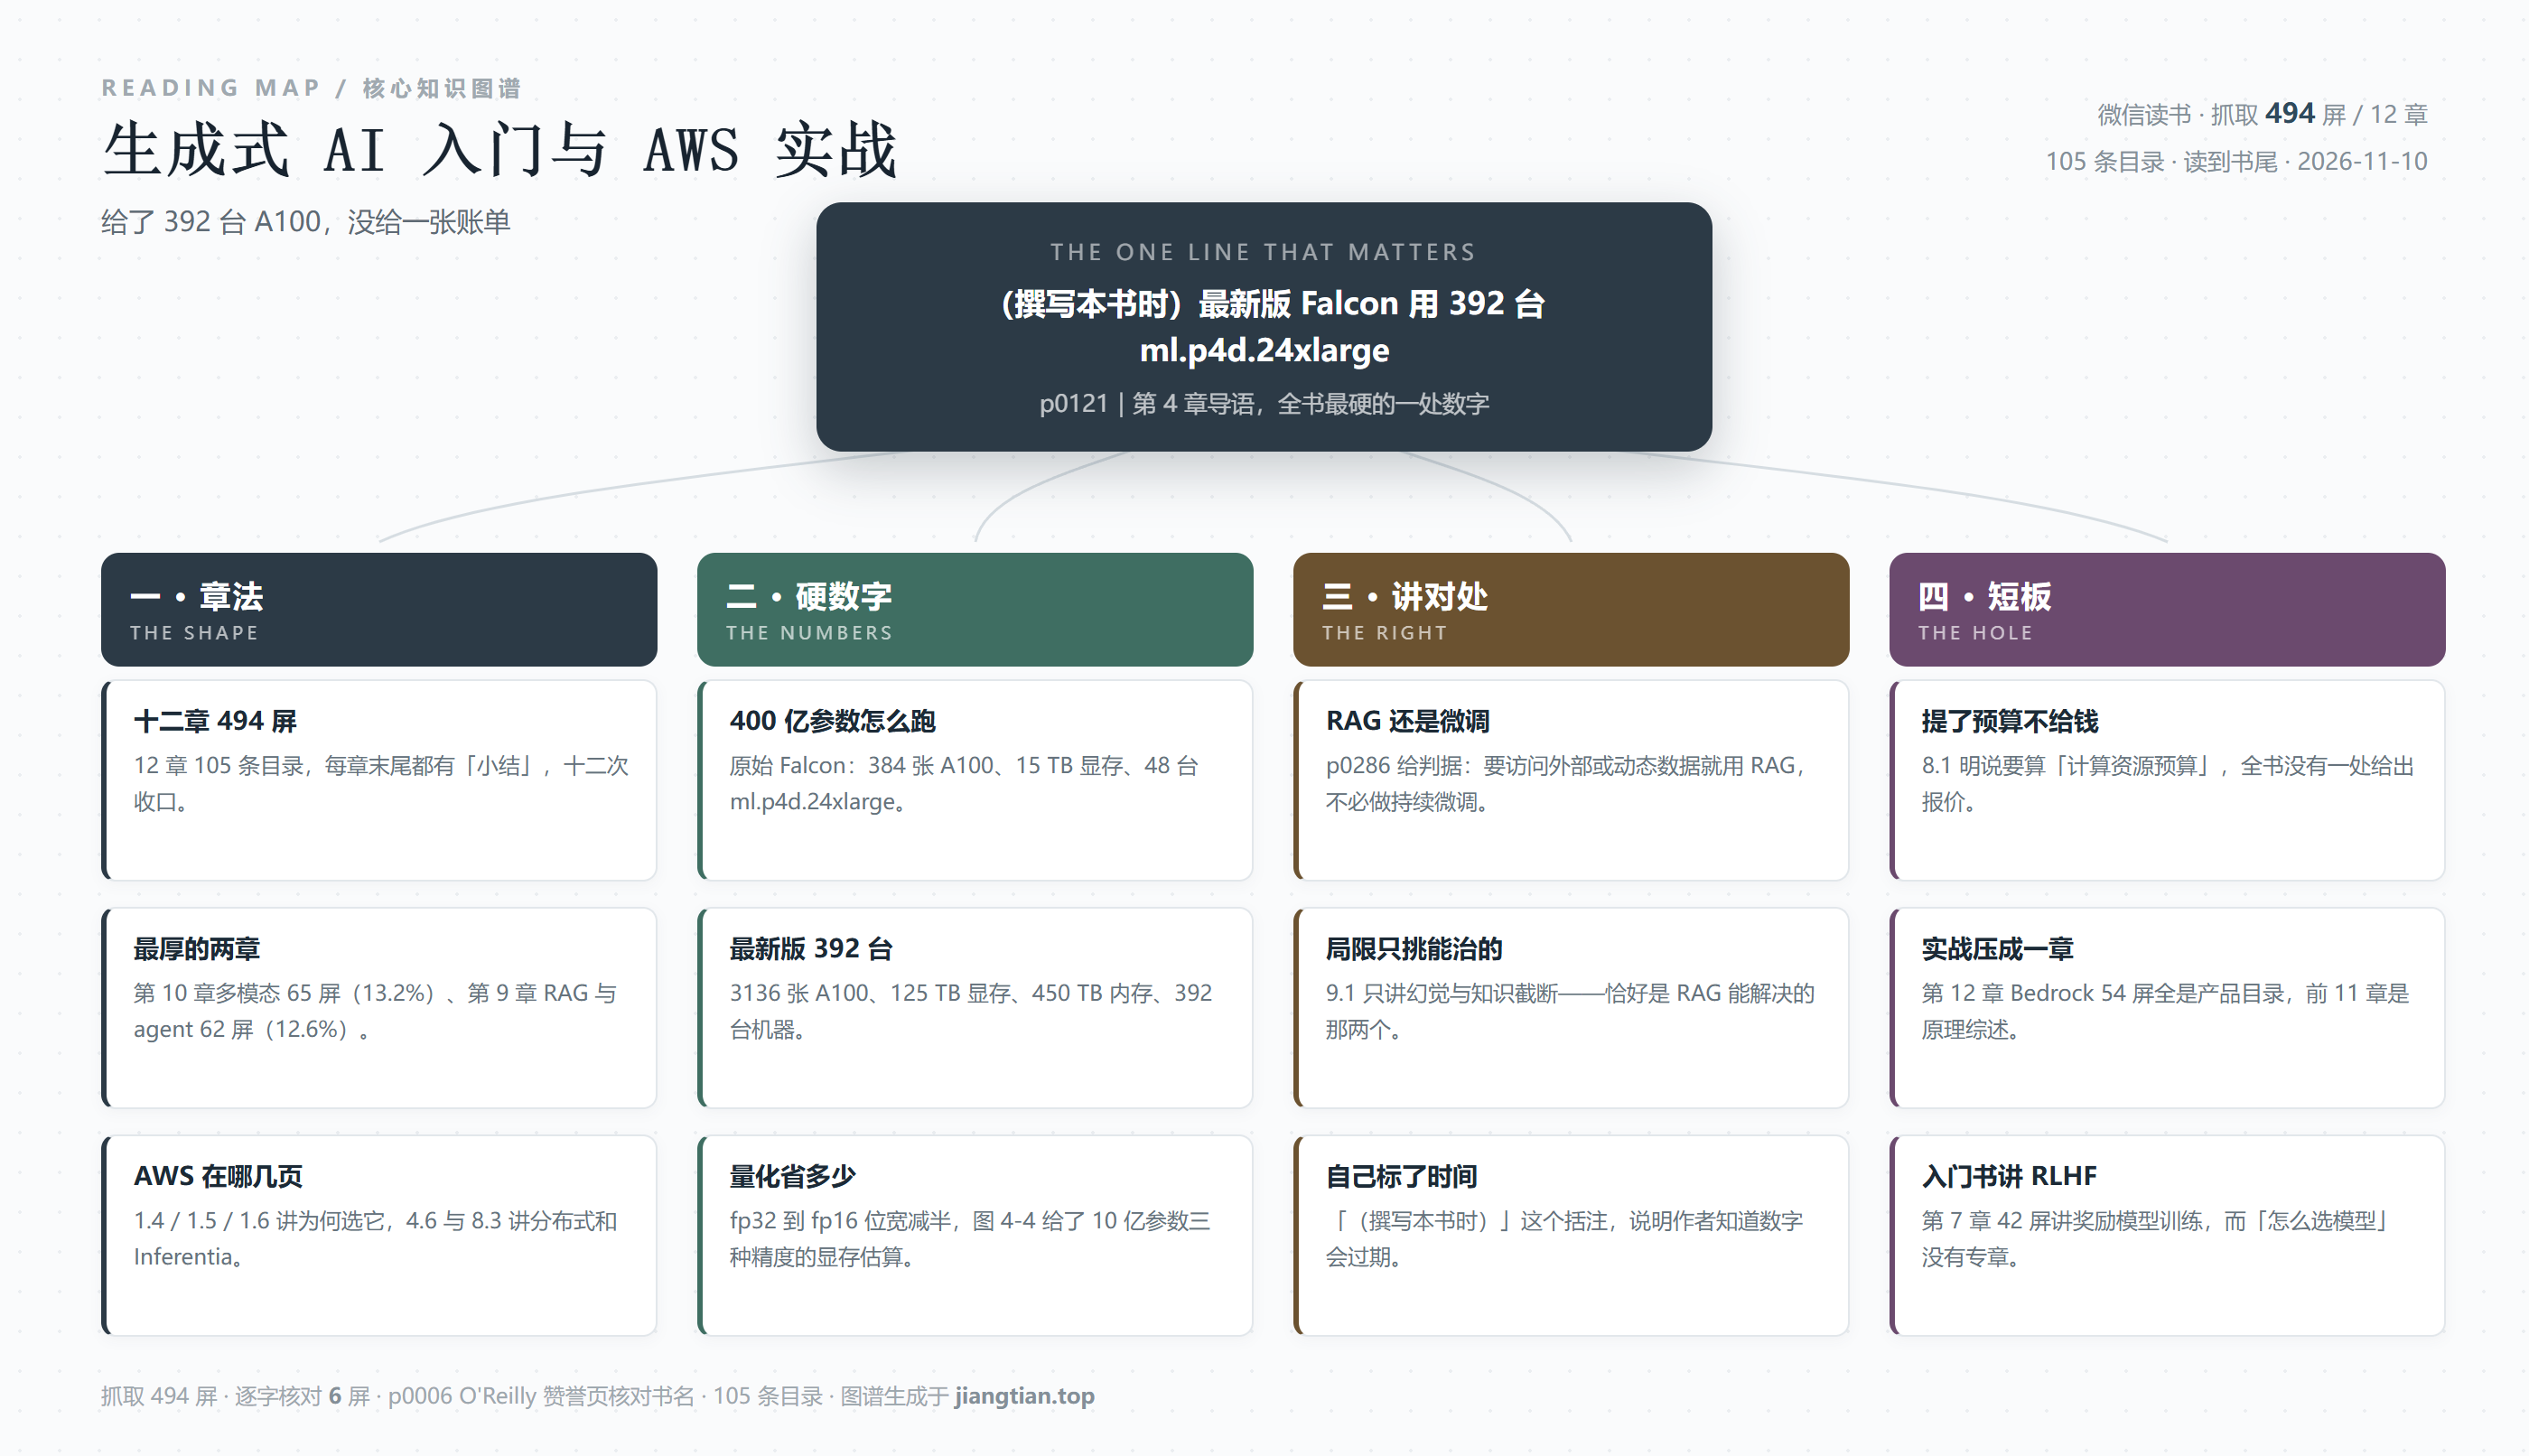
一句话:这本书把训练的规模写到了「392 台」这么具体,却没把账单写到「多少钱」这么具体——而 392 台这个数字的唯一用处,就是让人算出后面那个数。
说明:各章屏数由 pages.jsonl 逐页章节映射全量聚合(第 1 章 26 屏 5.3%、第 2 章 41 屏 8.3%、第 3 章 34 屏 6.9%、第 4 章 41 屏 8.3%、第 5 章 26 屏 5.3%、第 6 章 25 屏 5.1%、第 7 章 42 屏 8.5%、第 8 章 31 屏 6.3%、第 9 章 62 屏 12.6%、第 10 章 65 屏 13.2%、第 11 章 28 屏 5.7%、第 12 章 54 屏 10.9%,前置 19 屏 3.8%,合计 494 屏);「12 章 12 次小结」由 105 条目录逐条比对得出;「无参考文献、无索引」同样由目录全量核对得出 · 笔记与图谱生成于 2026-11-10
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: