
可灵AI视频与AI绘画技巧大全:388 屏,把「技巧」写成了「点哪里」
微信读书《可灵AI视频与AI绘画技巧大全》· 抓取 388 屏 / 14 章 / 133 条目录 · 读到书尾,用时 432.5 秒
逐字核对 9 屏 · p0006 书名条核对为本书(目录名与真实书名一致)· 2026-11-11
抽样点位怎么定的:这本书的骨架是「三篇 → 14 章 → 每章若干「技巧」节」,每一节的标准动作都是「扫码看视频 + 步骤 01/02/03 + 一张界面截图」,所以我不按章节均匀取,而是专挑三类点位:一类是它自称讲「原理」的地方(p0014 什么是可灵、p0031 什么是AI视频、p0033 技术原理、p0204 与 p0210 AI绘画原理),看它是不是真有解释;二类是它自称讲「技巧」的地方(p0064、p0067 文生视频、p0174 视频续写、p0241 文生图、p0286 垫图),看提示词到底从哪来;三类是它最后的综合实战(p0356 老照片变视频、p0375 熊猫变身大厨),看前面 12 章教的能不能拼成一个作品。九屏约占 2.3%。各章屏数不是估的,是用 pages.jsonl 的章节映射做的全量聚合。
我把这本书 388 屏读完了,它教的全是点哪里。这不是一句刻薄话,是它自己在前言里写的定位——「每个案例都有详细的步骤说明」「介绍了不同平台(手机版和网页版)上的应用方法」。两句话都没问题,问题是:当一本书把「步骤说明」和「两个平台都讲」当成核心卖点的时候,它就已经把自己限定成一本界面说明书了,而界面是会过期的。
它过期得还挺快。前言「特别提醒」的第一条自己承认:书写的是快影 App 6.62.062006 版、剪映电脑版 5.9.0、可灵网页版,而从编辑到出版要一段时间,界面会有变动,「请举一反三」。这句话很诚实,但它同时宣告了这本书一半的价值保质期。你在 2026 年打开可灵,页面早不是那几张截图的样子了。
一、把身份说清楚:它不是技巧书,是界面说明书
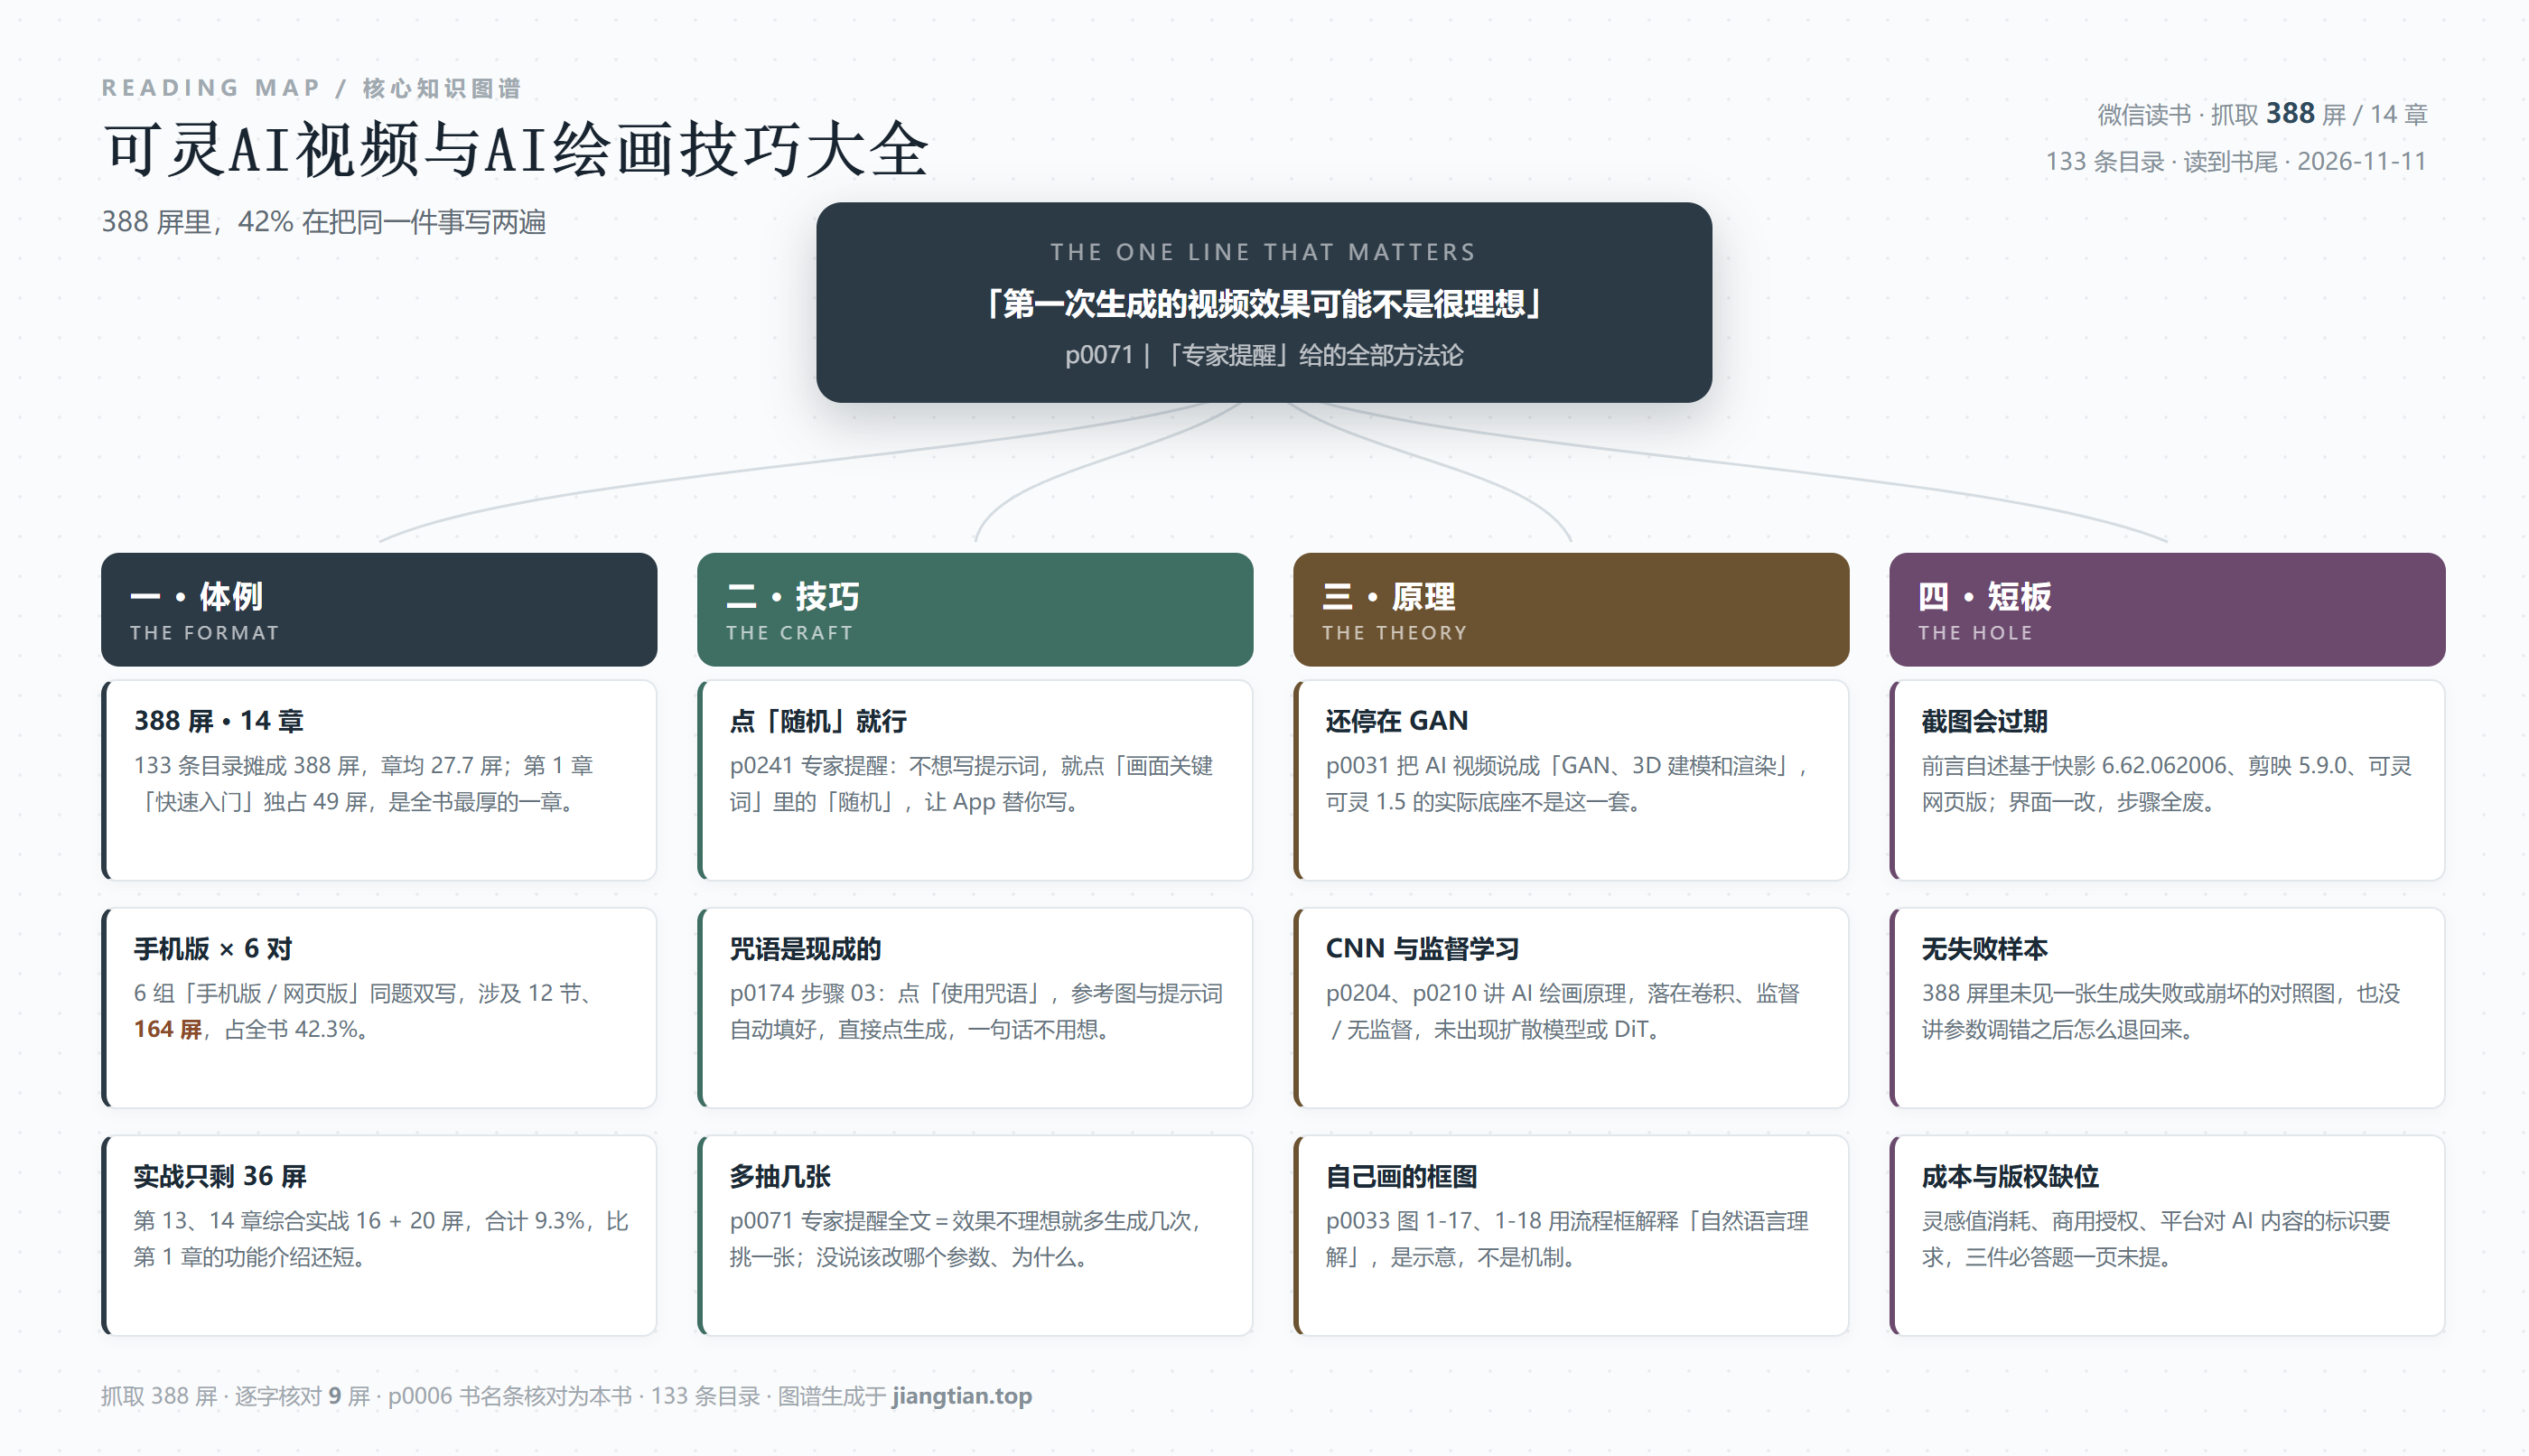
388 屏,14 章,133 条目录(14 个章标题、110 个节标题,外加版权、作者、前言、本书特色、特别提醒、作者服务、三个篇名)。平均每章 27.7 屏,平均每个节 2.5 屏——这个密度本身就说明问题:一个节 2.5 屏,能装下「扫码看教学视频」的二维码、三条步骤、两张截图,装不下任何一段论证。
最厚的一章是第 1 章「可灵AI视频快速入门」,49 屏,占 12.6%。这一章干什么?1.1 什么是可灵AI、工具准备、页面布局、主要功能;1.2 什么是AI视频、技术原理、主要用途。全部是「认识」类内容。最薄的一章是第 13 章「综合实战1:老照片变视频」,16 屏,占 4.1%。
也就是说:这本书在「认识工具」上花的篇幅,是它在「做出一个作品」上的三倍。第 1 章 49 屏对第 13 章 16 屏,这个比例不需要任何解读,它就是这本书的价值观。
我不否认界面说明书的用处。一个刚拿到可灵账号的人,翻到 2.1.1 照着步骤 01 到 07 走一遍,确实能出第一条片子——p0064 写得很清楚:启动快影 App,点「剪辑」界面里的「AI创作」,进「AI生视频」板块,输入提示词,设置生成信息。这条路是通的。但通完之后呢?
二、42.3% 的篇幅在把同一件事写两遍,而作者把它当卖点
这是我读完最不舒服的地方,也是这本书结构上最大的浪费。
全书有 6 组「同一功能,手机版一遍、网页版一遍」的成对节:2.1/2.2 文生视频、3.1/3.2 图生视频、4.1/4.2 图文结合生视频、6.1/6.2 视频续写、8.1/8.2 文生图、12.1/12.2 图文结合绘画。这 12 个节落在第 2、3、4、6、8、12 章,而这六章合计 33 + 28 + 24 + 29 + 22 + 28 = 164 屏,占全书 42.3%。
换句话说,你花钱买的 388 屏里,有 164 屏在告诉你「同一个按钮,在手机上在这儿,在浏览器里在那儿」。而这 164 屏的内容差异,本质就是导航路径的差异,不是方法的差异。
更值得注意的是作者的态度。前言「本书特色」第 4 条写的是:「跨平台操作:介绍了在不同平台(手机版和网页版)上的应用方法,使读者能够根据自己的喜好和需求选择合适的创作工具。」
「跨平台操作:介绍了在不同平台(手机版和网页版)上的应用方法,使读者能够根据自己的喜好和需求选择合适的创作工具。」—— 前言「本书特色」第 4 条,原文
把「写了两遍」包装成「跨平台」的能力,这是一个很典型的教材式偷换。真正的跨平台写作应该回答的是:手机上做不了什么、网页版做不了什么、什么活必须在哪一端完成、两端的产物怎么接续。这本书一个都没答。它只是把同一个流程拍了两遍截图。
而且这个重复还挤掉了别的东西。第 5 章「首尾帧」24 屏、第 9 章「上传参考图绘画」18 屏、第 10 章「垫图绘画」23 屏、第 11 章「借助历史图片绘画」25 屏——这四章都没有做手机/网页双写,它们是全书密度最高的部分。第 10 章讲垫图,p0286 的步骤里其实出现了界面上的参考强度调节,但正文只写了一句话「使用调整后的提示词进行AI绘画」,那个滑块的作用、数值区间、调高调低分别会怎样,一个字没有。省下来的篇幅没有变成深度,只是变成了截图。
三、全书最强的一招,是教你别写提示词
一本书叫「技巧大全」,我最好奇的就是它的提示词方法论。翻完我的结论是:它没有方法论,它有的是按钮。
第 8 章「使用文字绘画的实战技巧」,8.1.1 到步骤 03,先把风格选成「3D萌娃」,然后在「画面关键词」的文本框里输入提示词。到这里都正常。紧接着一个「★专家提醒★」,原文是:
「在使用『AI作图』功能生成图片时,用户既可以根据需求输入提示词,又可以让快影App随机生成提示词。具体来说,用户只需点击『画面关键词』板块中的『随机』按钮,即可让快影App随机输入提示词。」—— p0241,8.1.1 步骤 03 后的「专家提醒」原文
一个教人「用文字绘画」的章节,在讲完怎么输入文字之后,第一句建议是:你也可以不写,点一下「随机」。
我知道作者的意思可能是「新手可以先玩起来」。但这句话出现在一本以「技巧」命名、把「文字绘画」单独立成一章的书里,性质就变了。它等于承认:这个功能的核心难点(把想法翻译成模型能懂的描述)不在本书射程内。
第 6 章「视频续写」更直接。p0174 步骤 02 让用户点「使用咒语」按钮,步骤 03 写:「随后,在『图文描述』板块中会自动显示对应的参考图和提示词,然后设置视频的其他生成信息,点击『生成视频』按钮。」——提示词是系统给的,参考图是系统给的,用户要做的只是点「生成」。这一节叫「手机版视频续写实战」。
我把三处串起来看,得到的是同一个模式:这本书默认提示词是天上掉下来的。要么点「随机」,要么点「使用咒语」,要么照抄书里那一条成品。至于这条成品为什么长这样、删掉哪个词会变、加一个镜头运动会怎样,全书没写。
而这恰恰是 2024 年之后 AI 创作唯一没法被界面更新淘汰的能力。界面三个月一改,参数名一改,按钮位置一挪,这本书的第 2 到 12 章就全部作废;但「怎么把一句人话拆成主体、场景、镜头、光线、风格」这件事,五年内不会变。作者选了会过期的那一半来写,而且写了 388 屏。
四、唯一像「方法论」的一屏,只有一句话
2.1.2「调整视频的效果」结尾,有一个「★专家提醒★」,我把它整段抄下来,因为它几乎是全书唯一一处面对「生成结果不如预期」这个真实处境的地方:
「有时候,调整视频生成信息之后,第一次生成的视频效果可能不是很理想。此时,用户可以多次进行视频的生成,并从中选择自己满意的效果。当然,如果多次生成之后,视频效果还是不太好,用户也可以重新对视频的生成信息进行调整,然后再进行视频的生成。」—— p0071,2.1.2 后的「专家提醒」原文
这段话是成立的,甚至可以说它是对的:AI 生成本来就是抽样的活,同一个提示词跑四次,出四张不同的脸,挑一张。任何做过这行的人都知道「多抽」是日常。
但它只说了「多抽」,没说「抽不出来怎么办」。而后者才是真问题。一个新手照书里的提示词生成了十次,十次都是六根手指,他需要的不是「再生成几次」,而是「这是提示词的问题、参考图的问题,还是这个模型压根做不了手」。这三条路对应三种完全不同的动作:改描述、换首帧、放弃这个镜头改分镜。这本书一条都没给。
「多试几次」不是方法论,是把方法论的缺失藏进了一个看起来很务实的句子里。它让读者觉得自己得到了建议,实际上只是被告知「继续撞」。
顺便说一句:这本书的结构里其实已经埋好了回答这个问题的条件。它讲了首尾帧(第 5 章)、讲了续写(第 6 章)、讲了垫图(第 10 章)、讲了图文结合(第 4、12 章),这些都是控制生成结果的具体手段。如果作者肯在第 2 章那句话说:「崩了先看是主体崩还是运动崩,主体崩换参考图,运动崩拆成两段用首尾帧接」,这本书的价值会翻倍。他选择不说,因为那需要判断,而判断不能做成截图。
五、每两屏挂一个二维码,等于承认文字讲不清
还有一个细节,我一开始没在意,翻到第四屏才发现它无处不在:几乎每一个小节下面,都有一张二维码,配一行小字「扫码看教学视频」。p0014 有,p0064 有,p0241 有,第 5 章第 6 章都有。388 屏里二维码的密度,大概和截图的密度差不多。
二维码本身不是问题,很多教材都这么干。问题在于它出现的位置。如果一本书在讲「什么是可灵」这种概念页时挂二维码,那可以理解成补充;但它在讲「步骤 01 点这个按钮」时也挂二维码,就等于承认:这一屏的文字本身讲不清楚这个操作。
一个操作要靠视频才能讲清,通常只有两种原因:要么界面太复杂、静态图表达不了层级关系,要么文字写得不够准、得靠演示兜底。这本书两边都占一点。但不管是哪一种,结果都一样——读者真正学会的那一下,发生在视频里,不在书里。而视频不在你买的这本纸质书里,它在网上,会下架、会换链接、会和这一版的界面一起过期。
这就把这本书的可靠性结构说穿了:文字负责目录和步骤编号,截图负责指位置,真正的「怎么按」交给视频,「为什么这么按」谁也不负责。三层里最不值钱的一层,占了 388 屏。
六、讲「技术原理」的那三节,讲的是另一个时代的技术
这是硬伤,而且是可以直接指出来的硬伤。
p0014「什么是可灵AI」的全文解释是:可灵(Kling)AI 是快手科技自研的一款视频生成大模型,具备强大的视频生成能力,能根据用户输入的文本或图片快速生成高质量的视频;除基础功能外还推出了运镜控制、首尾帧等新功能。整段没有一个版本号、一个时长上限、一个分辨率、一个参数量。作为「什么是」的定义,它给的是宣传语,不是参数。
p0031「什么是AI视频」倒给了技术名词:「这种技术基于深度学习模型,如生成对抗网络(Generative Adversarial Networks,GANs)、3D建模和渲染等,用户只需要输入相应的提示词,即可生成一条符合要求的AI视频作品。」
问题就在这句。可灵这一代视频生成模型的技术底座是扩散模型(尤其是 DiT 这一类把 Transformer 装进扩散框架的结构),不是 GAN,也不是 3D 建模加渲染。GAN 是 2014 年的路线,在图像生成上曾经主流,在视频生成长度、时序一致性上早就不是主角了。一本 2024 年写可灵的书,在第一章把可灵的技术路线说成 GAN,这不是简化,这是张冠李戴。
p0033 更能说明作者的写作习惯。这一页给了两张图:图 1-17「可灵AI自然语言理解的相关分析」、图 1-18「场景合成和渲染」。图里画的是「理解复杂文本 → 提取关键信息、主题和视觉描述 → 指导视频的生成过程」三个方框加箭头。这是作者自己画的流程图,它描述的是「输入一句话会经历哪几个概念环节」,不是「模型内部怎么算」。作为科普示意图没问题,但它被放在「技术原理」这个标题下,读者会以为这就是原理。
第 7 章讲 AI 绘画原理,同样的毛病。p0204 讲「卷积神经网络技术」,列了四条:图像分类和识别、图像风格转换、图像生成和重构、图像降噪和杂物去除。p0210 接着讲「监督学习和无监督学习」。一直讲到第 7 章结束,我没有在任何一页看到「扩散模型」这四个字,也没有看到「潜空间」「去噪步数」「CFG」这些真正决定出图效果的概念。
这不是吹毛求疵。你在这本书里学到的「原理」是 GAN + CNN + 监督学习,而你在可灵里实际操作的参数是「创意想象力」「参考强度」「风格化」——这些参数只有在扩散模型的语境里才能被理解。原理讲错了代,后面所有参数就只能靠背,不能靠推。这也解释了为什么第 8 到 12 章全在写「输入提示词,点击生成」,因为它没有能力解释「为什么这个词有用」。
七、两章综合实战共 36 屏,它能证明的恰恰是短板
第三篇叫「综合实战篇」,两章:第 13 章老照片变视频 16 屏,第 14 章熊猫变身大厨 20 屏。合计 36 屏,占 9.3%。
第 13 章的流程我看了 p0356:进入「AI视频」页面的「图生视频」选项卡,点左上角的「可灵1.0」按钮,在弹出列表里选「可灵 1.5」,切换模型,然后上传老照片当首帧。这个细节反而是全书少见的「有用的东西」——它告诉你模型版本是可切换的,且不同版本效果不同。可惜它出现在第 13 章第 3 屏,前面 12 章一次没提过版本差异。
第 14 章 p0375:步骤 05 单击「画质增强」按钮,平台对所选的图片单独做画质增强,生成一张更清晰的图,作为视频的参考图;然后 14.2 进入「使用图片生成视频」。这个流程是对的,也是真实工作流:先修图,再图生视频。
但两章加起来 36 屏,仍不足以构成一个「作品」。一个能发布的老照片变视频,至少还要回答:选哪张照片(不是所有老照片都适合动起来)、动多少算合适(全脸都在动的结果通常很吓人)、配什么音乐、多长、竖屏还是横屏、发到哪个平台。这六个问题,两章一个都没碰。第 13 章在「生成视频」这一步就结束了。
第 14 章还有个结构上的小问题:整章 20 屏,前半是 14.1「输入提示词生成图片」,一直做到步骤 05 画质增强,14.2「使用图片生成视频」要到这一章过半之后才出现。也就是说,所谓的「视频综合案例」,真正动手做视频的部分被压到了后半章,前面大半在生图。这不是错,因为图生视频本来就得先有图;但它说明一件事——这本书的章节是按功能切块的,遇到「一个完整案例」时,它切不动了,只能把两块功能码在一起,起个案例的名字。
所以「综合实战」这个名字是有点虚的。它综合的是操作步骤,不是创作决策。它验证的是「前面 12 章教的按钮能不能连起来按」,而不是「这本书教的东西能不能做出一个有人看的东西」。前者是软件培训的验收标准,后者才是创作书的标准。
八、它的短板
按说好的,这一节老老实实写。
第一,时效性没有兜底。前言已经承认界面会变,但全书没有一处给出「界面变了怎么办」的迁移路径。388 屏里 90% 是截图加步骤编号,截图一过时,步骤编号就变成了指向虚空的箭头。相比之下,一本讲提示词结构的书,界面全废了还能用;这本不行。
第二,一个失败样本都没有。我核对的九屏里,所有生成结果都是成功的、好看的、构图中规中矩的。没有一张图告诉你「这样写会糊」「这样写会多出手指」「首尾帧差太远会抽搐」。一本操作书最该给的是失败对照,因为读者真正会遇到的都是失败。这本书的图全是成果展示,功能上更接近作品集。
第三,成本与版权完全缺位。可灵的生成要消耗灵感值,免费额度有限,书里只在「特别提醒」第 2 条说了一句「部分功能需要开通会员」「建议开通会员」——注意这个措辞,是从消费角度说的,不是从成本核算角度说的。一个要做 30 秒片子的团队需要多少额度、会员档位怎么选、批量生成和精修的额度分配怎么算,全书没有。AI 生成内容的商用授权、平台对 AI 内容的标识要求,同样一页未提。这两件事恰恰是学生和中小企业最容易踩坑的地方。
第四,重复挤占了深度。这一点前面算过账:164 屏、42.3% 用于手机/网页双写。如果把这 164 屏压成 40 屏的差异对照表,能腾出 120 屏。120 屏足够把提示词从「给成品」升级成「给方法」,也足够把第 10 章那个参考强度滑块讲透。作者没有这么做,因为写对照表要动脑,写两遍截图只要动手。
第五,它的「技巧」不成体系。14 章是按功能切的:文生视频、图生视频、图文结合、首尾帧、续写、文生图、参考图、垫图、历史图、图文结合绘画。这是软件菜单的顺序,不是创作流程的顺序。真正的创作顺序是:想一个镜头 → 决定用哪种生成方式 → 写描述 → 出片 → 判断哪里不对 → 换手段重做。这本书把「手段」摊了一桌子,唯独没有那条流程线。读者学完 14 章,会 10 种生成方式,但不知道下一个镜头该用哪一种。
九、那它适合谁
说句公道话:把这本书放在「工具书」这一格里,它是合格的。步骤清晰、截图清楚、每一节都配了扫码视频、连会员提示都写了。对于「今天下午就要交一条 15 秒的视频,我完全不会可灵」的人,翻到第 2 章照着按,一小时内能出片。这个价值是真实的。
它不适合的是另外两种人。一种是想靠 AI 视频吃饭的人——他需要的是提示词结构、失败诊断、成本控制,这本书一样不给。另一种是把它当教材用的老师和学生——教材要能撑过一个学期,而这本书的截图撑不过一次大版本更新。
判断标准其实很简单:把这本书的所有截图都糊掉,只留文字,它还剩下什么?我试了一遍,剩下的是「点这个按钮」「输入提示词」「点击生成」。这五个字重复了 388 屏。
所以回到标题那句判断:这本书的价值在「点哪里」,而 AI 创作的门槛早就不在「点哪里」了。现在随便一个模型,输入一句人话就能出一条片子;真正的差距在你想不想得出那个镜头、看不看得出这条片子哪里假、改不改得动。这三件事,都需要有人教你「为什么」,而这本书 388 屏只教了「怎么按」。
一句话:它是一本合格的软件说明书,被印成了「技巧大全」的样子;你要是想学可灵怎么点,它够用;你要是想学怎么让 AI 替你拍出想要的东西,它连门都没推开。
说明:各章屏数由 pages.jsonl 章节映射全量聚合——第1章 49、第2章 33、第3章 28、第4章 24、第5章 24、第6章 29、第7章 38、第8章 22、第9章 18、第10章 23、第11章 25、第12章 28、第13章 16、第14章 20,加前置 11 屏合计 388 屏。「手机版/网页版」成对节 6 组(2.1/2.2、3.1/3.2、4.1/4.2、6.1/6.2、8.1/8.2、12.1/12.2),对应第 2、3、4、6、8、12 章合计 164 屏,占 42.3% · 笔记与图谱生成于 2026-11-11
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: