
大模型垂直领域低算力迁移:内容是硬的,编排是软的,「低算力」挂错了位置
微信读书《大模型垂直领域低算力迁移:微调、部署与优化》· 抓取 382 屏 / 12 章 / 188 条目录 · 读到书尾,用时 453.3 秒
逐字核对 9 屏 · p0006 书名条核对为本书(目录名与真实书名一致)· 2026-11-11
抽样点位怎么定的:这本书是「通识动机 → 技术栈 → 数据 → 模型内部 → 微调 → 训练 → 推理 → 编译 → 非性能需求 → 部署」的工程顺序,环环相扣,所以我不按页码均匀取,而是顺着它的逻辑链卡点:p0011(第 1 章「iPhone 时刻」,看它怎么起势)、p0046(第 2 章推理优化策略总图,看它的技术地图)、p0066(第 3 章基座选择,看它给「低算力」定什么门槛)、p0093(第 4 章自我策展,看数据自举写到什么颗粒度)、p0167(第 7 章 LoRA 开头,看它从哪切入)、p0179(第 7 章 QLoRA,看显存优化的落地程度)、p0195(第 8 章集合通信,看它假定的硬件规模)、p0252(第 9 章页注意力,看推理优化的深度)、p0326(第 11 章水印检测)、p0368(第 12 章 TGI)。十屏约占 2.6%。各章屏数由 pages.jsonl 章节映射全量聚合,不是估的。
这本书读完,我的判断有点分裂:它是一本认真的书,但书名撒了个谎。三百八十二屏里,公式、架构图、论文级的细节都有,明显不是拼凑出来的;可它叫「低算力迁移」,而全书最长的一章讲的是数据中心级的分布式训练,全书给「低算力」定的门槛是「基座至少数百亿参数」。你带着一张显卡翻开它,翻到第 66 屏就会发现自己不在目标读者里。
先把好的部分说清楚,不然不公平。我在九屏里看到的东西,密度是够的:SVD 的低秩近似推导没有跳步,PagedAttention 的 copy-on-write 讲到了并行采样共享内存这一层,水印检测给的是 z-score=4.0、p=0.000032 这种可以直接对着论文核的数。这些不是「科普」级别的处理,这是把论文嚼过一遍再写出来的。
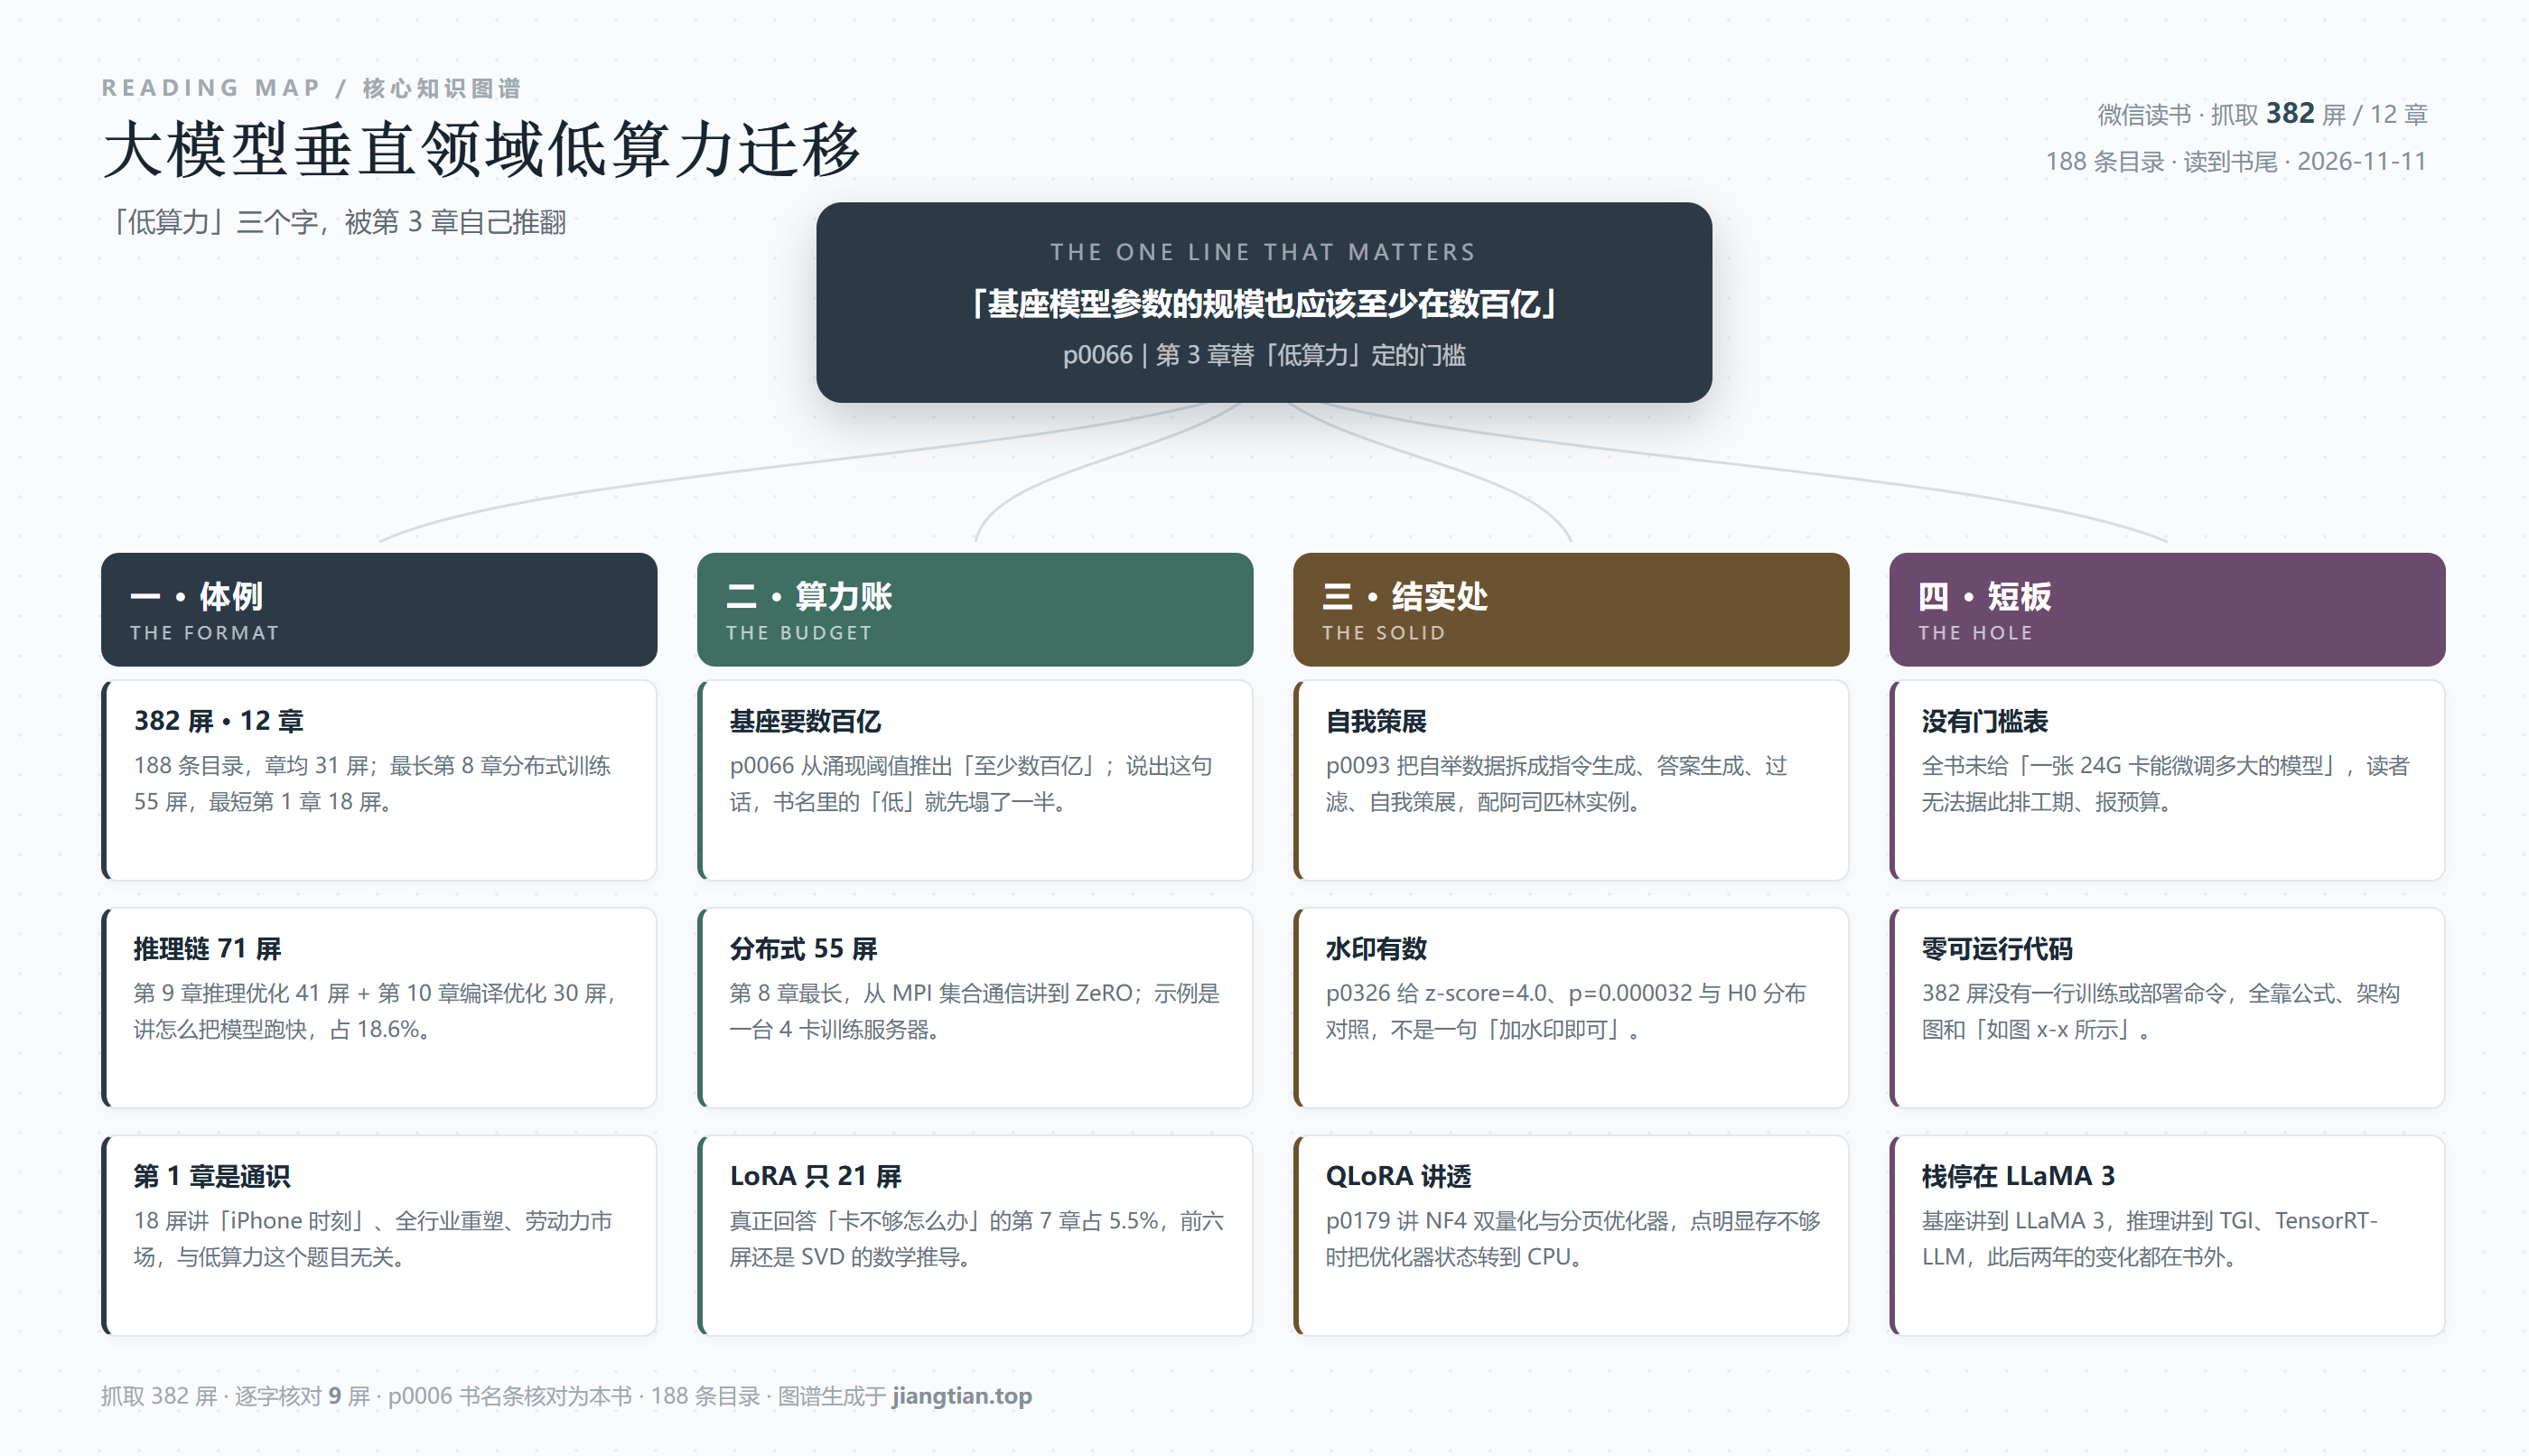
一、先把骨架摊开:一条很规整的工程流水线
382 屏,12 章,188 条目录。章均 31 屏,节均 2 屏——注意,2 屏一节意味着这本书的「节」不是论述单元,而是知识点单元,一个概念配一段解释配一张图,说完就走。
12 章的顺序是:行业变革(18 屏)→ 迁移技术栈(28 屏)→ 开源生态(25 屏)→ 自举数据(21 屏)→ 数据处理(22 屏)→ 大模型抽象(42 屏)→ LoRA 微调(21 屏)→ 分布式训练(55 屏)→ 推理优化(41 屏)→ 编译优化(30 屏)→ 部署的非性能需求(36 屏)→ 服务器端部署(35 屏)。
这条链是通的,而且顺序对:先告诉你为什么要做垂直迁移,再给你一张技术地图(2.1 列了提示工程、RAG、参数高效微调、全参数微调、从头预训练五种方式,2.1.6 单独收口到「低算力技术选型」),然后依次解决「数据从哪来」「模型内部长什么样」「怎么微调」「怎么训得快」「怎么推得快」「怎么编译」「怎么合规」「怎么上线」。这是一本工程书的正常写法:先建坐标系,再逐个填。
第 6 章「大模型抽象」42 屏塞在中间,是全书的枢纽。它讲计算图(静态图/动态图)、算子优化与调度、张量、序列化格式(TensorFlow、PyTorch、Safetensors)。这一章的存在说明作者知道一件事:不懂计算图的人,做不了后面第 8 到 10 章的任何优化,因为那些优化全是在图上改的。愿意花 11% 篇幅给这一章,是有诚意的表现。
二、「低算力」的承诺,被第 3 章的 66 屏一句话推翻
问题从书名开始。全书没有一处界定「低算力」到底是多少:几张卡?多少显存?单机还是多机?预算多少?这个量纲从头到尾缺席。而标题里唯一的核心变量,恰恰就是它。
更麻烦的是作者自己在第 3 章给了一个反方向的答案。p0066 讲「基座模型选择的关键指标」之参数规模,配了图 3-4「不同模型涌现能力的参数规模阈值」(横轴是模型规模/FLOPs,纵轴是准确率,对比 LaMDA、GPT-3、Gopher、Chinchilla、PaLM 在 9 项任务上的表现),然后写下结论:
「因此,理解项目需求和资源限制对选择合适模型至关重要。但基于不同模型涌现能力的参数规模阈值,基座模型参数的规模也应该至少在数百亿。」—— p0066,3.2.1 参数规模
这句话技术上站得住:涌现能力确实有参数门槛,小模型微调完还是小模型。但它跟书名放在一起就产生了直接的矛盾——一本讲「低算力迁移」的书,第一件要回答的事是「用多大的基座」,它回答「至少数百亿」。数百亿参数的模型,光是权重本身就要几百 GB 显存,加载都要多卡。
作者不是不知道这个矛盾。他在 3.2.1 前半段其实写了对的另一半:「对资源和计算能力有限的项目来说,选择参数较少的模型可能更为合适」。但这两句话放在同一段里,没有任何调和:既说越小越好,又说至少数百亿。读者读到这里会卡住——那到底该选多大?
这就是这本书最大的结构性问题:它把「低算力」当成一个宣传词,而不是一个约束条件。如果它是一个约束条件,全书的写法会完全不同:先给出「一张 24G 卡 / 一张 80G 卡 / 四张 80G 卡」三档资源预算,每一档说明能做什么、不能做什么、代价是什么,然后所有技术都挂到这三档上去。作者没这么做,他按技术分类写,写完发现「低算力」三个字安不上去,就把它留在了封面上。
顺便说,「低算力」这三个字本身就有两种读法,而这两种读法要的书完全不一样。一种是「我卡少」,读者是个人开发者、小团队、学校实验室,他要的是省显存、省时间、能在一台机器上跑通。另一种是「我单位成本要低」,读者是企业里的技术负责人,他有集群,但要算每千 token 的成本、要压推理延迟、要控住长期账单。前一本书讲 7.5 QLoRA 和 9.2 KV 缓存,后一本书讲 8.6 ZeRO 和 9.3 连续批处理。
这本书想两本都做,结果两头都没做透:给「卡少」的人,它把三分之一的篇幅(第 6、8、10 章共 127 屏,占 33.2%)花在了他摸不到的东西上;给「要省钱」的人,它连一个成本数字都没给。选题的模糊,最后变成了编排的散。
三、最长的一章,讲的是数据中心
第 8 章「大模型的分布式训练」55 屏,占 14.4%,是全书最长的一章。它讲什么?8.2 集群架构(GPU 集群、集合通信算子、通信拓扑)、8.3 通信架构(参数服务器 vs 基于归约)、8.4 并行模式(数据/张量/流水线并行及对比)、8.5 张量并行的逐层拆解(输入层、输出层、MLP、自注意力)、8.6 数据并行的内存优化(显存占用、ZeRO、ZeRO-Offload)。
p0195 讲集合通信,举的例子很说明问题:「本节以一台集成了 4 张训练加速卡的服务器为例,服务器内 4 张训练加速卡是全连接的,并假设每张加速卡对应的输入是:in0=[1, 2, 3, 4],in1=[5, 6, 7, 8],in2=[9, 10, 11, 12],in3=[13, 14, 15, 16]」,然后拿 rank 0 到 rank 3 讲 Broadcast、Reduce、Gather。
这段讲得清楚,Broadcast 是根节点向所有节点发同一份数据、保证初始参数一致,Reduce 是多节点数据归约。但请注意那个例子:4 张加速卡、全连接、MPI 语义。这是机内多卡的场景。而这一章后面 40 多屏的并行策略讨论,默认的语境是一整个集群——张量并行要 NVLink、流水线并行要切层、ZeRO 要分片优化器状态,这些东西的意义都建立在「卡很多、显存很紧、通信很贵」这个前提上。
一个只有单卡的人读第 8 章,学到的是一堆他永远用不上的知识。而这本书恰恰应该在第 8 章开头就说一句:「如果你的卡少于 4 张,可以直接跳到 7.5 QLoRA 和 9.2 内存优化,第 8 章对你没用。」它没说,它把 55 屏平铺在那里,让读者自己判断。
这不是知识错误,是编辑判断的缺失。一本写给「算力不够」的人的书,把最长的篇幅给了「算力很多」的解法,还不做分流提示,读者只会得到一个印象:哦,原来低算力迁移也要搞集群。那他就会关掉这本书。
四、真正的主角,只分到 21 屏,前六屏还是数学
如果让我指认这本书真正该有的主角,那就是第 7 章「LoRA 低算力微调」。它的全部篇幅是 21 屏,占 5.5%——比第 1 章的行业通识(18 屏)只多 3 屏,比第 8 章的分布式训练少了 34 屏。
21 屏里还要扣掉开头。p0167 我看到的第 7 章开头是 SVD:M = U Σ V*,矩阵分解的图示,说明「通过保留最大的几个奇异值(以及相应的奇异向量),可以得到矩阵的低秩近似。这种近似矩阵在信息保留方面是最优的(在 Frobenius 范数或 l2 范数意义下)」。
这段数学没错,而且是必要的——LoRA 的低秩分解就是从这来的。但它的位置有问题:一本面向工程实践的书,把唯一一章「低算力」内容的开头六屏用来推 SVD,等于把最想解决问题的人挡在了门口。真正该在最前面的,是「你的 24G 卡能训多大的模型」这张表。
好在 7.3 有「秩的选择」,7.5 有 QLoRA。p0179 讲 QLoRA 的三项改进,是我在这本书里看到的最落地的一段:双重量化(把第一级量化常数再量化一次,进一步压缩常数量化后的存储)、分页优化器(显存接近上限时把部分数据暂移到 CPU 内存,类似操作系统的分页)、以及这些改进让 QLoRA 成为「在资源受限环境下进行大模型微调的有力工具」,适用场景点名了「移动设备或边缘计算设备」和「显存有限的 GPU 服务器」。
这是全书唯一一处真正站在「卡不够」的立场上写的话。它出现在第 179 屏,一本 382 页的书翻到将近一半才出现。如果这一屏的思路(显存不够就把什么挪出去、挪出去损失多少)贯穿全书,这本书会变成另一本书。但它只出现了一次,后面又回到常规的架构叙述里去了。
五、写得最好的三处,值得单独说
批评说完,该表扬的地方必须点到,否则不叫读书笔记,叫找茬。
第一处是第 4 章的自我策展(p0093)。这一节把「用模型生成训练数据」拆成可执行的三段:自我增强阶段,让模型读无标注文档、生成对应的指令(书里的例子是阿司匹林那段说明文字,模型生成的指令是「描述阿司匹林的用途和功效」);评估筛选阶段,用已经在种子数据上微调过的模型给候选打分;自我策展(Self-Curation)阶段,从所有生成的数据里挑质量最高的实例用于下一步微调。三个阶段的划分干净,而且写了打分要有参照模型这一关键点。合成数据这件事,很多人只讲「让 GPT 造数据」,这本书讲的是「造完怎么筛」,后者才是难点。
第二处是第 11 章的水印(p0326)。图 11.4 把水印检测画成两个假设检验:H0 下 z-score=0.0、p-value=0.5(检测不出来,和随机没差别);检测到水印时 z-score=4.0、p-value=0.000032。接着 11.2.3 直接讲水印攻击技术——「每种技术都存在其潜在的漏洞」。
「LLM水印技术旨在防止LLM生成内容的滥用,但它们也面临多种攻击策略,可能削弱水印的有效性。」—— p0326,11.2.3 水印攻击技术
一本讲技术的书,肯把自家讲的技术「能被怎么破」写出来,这是学术诚实。同类书多的是「加水印即可溯源」这种话,这本书给的是检测的统计判据加攻击面,后者才是工程师需要知道的。
第三处是第 10 章整章。30 屏讲编译优化,包括深度学习编译的多级渐进优化、不同框架在不同阶段的编译策略、端侧部署工具、服务器端部署优化,还有 10.4.3「大模型的手动编译优化」。编译优化在大模型书里是冷门章节——大家更爱写微调和提示词——愿意给 30 屏,说明作者是按工程链条写的,不是按热度写的。
顺带说,2.3 那张「推理优化策略」总图(图 2.9)画得相当好:把优化分成训练中优化和训练后优化两列,横跨模型编译、模型压缩、模型分区三条路,每条路上标了工具(NVIDIA TensorRT、DeepSpeed、FT、HF、SageMaker),还标了准确率与性能的得失。这种图是干活的人才会画的。
六、第 9 章那 41 屏,是全书写得最像样的一段
如果只允许我推荐一章,我选第 9 章推理优化。41 屏,占 10.7%,分成四块:计算加速(算子融合、并行推理)、内存优化(KV 缓存、页注意力、快速注意力)、吞吐量优化(内存 I/O 瓶颈、静态批处理、连续批处理、动态分割融合)、量化(动机、原理、LLM.int8()、GPTQ)。
p0252 讲页注意力,是全书技术密度最高的一页。它把 KV 缓存拆成「逻辑 KV 存块」和「物理 KV 存块」,中间用一张块表映射,例子是提示词「Alan Turing is a computer scientist」加上补全「and mathematician renowned for」——两个序列的前半段共享同一批物理块,只有分叉之后的部分各占新块。接着它点出关键矛盾:共享能省显存,但序列之间必须互不污染,所以引入写时复制(copy-on-write),某个序列要写某个物理块时,系统不直接写入,而是先复制一份供该序列独立使用。
这段好在哪?好在它没有停在「PagedAttention 能省显存」这种结论上,而是把「为什么能省」和「省了之后靠什么保证正确」都写清楚了。这是工程书该有的颗粒度:一个优化只要涉及共享状态,就一定会带来一致性问题,讲优化不讲一致性,等于只讲了一半。
但它也暴露了这本书的老毛病。页注意力的显存节省比例,取决于你的序列长度分布、批量大小、并发数;书里讲透了机制,却没给一个「你在 24G 卡上跑 8K 上下文,能并发几个请求」的换算示例。读者知道原理,还是不知道自己的卡能撑多少。
七、它缺的那张表:一张 24G 卡能干什么
我读完最想要而没得到的东西,是一张表。表头四列:显存档位、能微调的基座规模、能用的方法、单次训练大概多久。
为什么这张表这么重要?因为「低算力迁移」这个题目的全部决策都压在这一张表上。你手上有一张 4090(24G),你需要的答案是:7B 模型能不能 QLoRA、LoRA rank 开多少、batch size 能设到几、序列长度卡在多少。有了这张表,剩下的章节都是查阅;没有这张表,剩下的章节都是知识。
书里其实散落着构成这张表的全部零件:7.3 讲秩的选择、7.5 讲 QLoRA 与分页优化器、8.6.1 讲设备内存占用、8.6.2/8.6.3 讲 ZeRO 与 ZeRO-Offload、9.2 讲 KV 缓存与页注意力、9.4 讲量化。这些零件拼起来,正好就是那张表。作者把它们按技术分类摆在了五个不同的章节里,却一次也没有横向拼过。
这是工程书和教材的分界线。教材按知识分类,工程书按决策分类。这本书的内容是工程书的料,编排是教材的编排。它默认读者会自己把第 7、8、9 章拼起来,可一个真正被显存卡住的人,往往连该翻哪一章都不知道。
八、它的短板
第一,382 屏没有一行可运行的代码。这是最硬的一条。第 12 章讲 TGI(p0368 讲到连续批处理、SSE 流式输出、模型分片走 NCCL、FlashAttention 与 PagedAttention、bitsandbytes/GPTQ/EETQ/AWQ 多种量化、OpenTelemetry 与 Prometheus 监控),讲得都对,但没有一条启动命令、没有一个配置项、没有一组并发与延迟的实测数。读者合上书,知道 TGI 很强,但不知道明天上班怎么把它跑起来。对一本 2024 年之后出的工程书,这个缺失是致命的——这些内容网上文档都有,书的价值本该在于「把坑标出来」。
第二,没有成本核算。低算力的另一半是钱。训练一次 7B 模型用 QLoRA 要多少卡时、租云主机一天多少钱、推理每千 token 折合多少、什么规模下自建比调 API 划算——这四个数一个都没有。而这本书的读者,恰恰是最需要算这笔账的人:大厂不缺卡,缺卡的人才算账。
第三,合成数据的风险只写了一半。第 4 章把自我策展讲得很清楚,但没回答「打分模型本身有偏怎么办」。自我策展的核心是用一个模型去评另一个模型产出的数据,如果评分模型偏好某种句式,筛出来的数据集就会整体偏向那种句式,微调完的模型说话会越来越像它自己。这是自举数据最常见的失败模式,书里没有一节叫「自举失败的迹象」。
第四,技术栈的截止时间很清楚。基座模型讲到 LLaMA 3(3.3.1 LLaMA 2、3.3.2 LLaMA 3、3.3.3 商用限制),推理栈讲到 TGI 与 TensorRT-LLM,量化讲到 LLM.int8() 与 GPTQ(AWQ、EETQ 只在 TGI 那段被顺带提及)。这意味着这本书的知识边界大致在 2024 年。开源模型的迭代周期是三个月,这本书的「选型」章节,现在读已经只能当方法论看,不能当清单用。
第五,第 1 章是注水。18 屏讲「大模型的 iPhone 时刻」、全行业重塑、劳动力市场变革、迁移的商业价值与技术护城河。p0011 的原话是「这将标志着人工智能作为应用基础架构的『iPhone时刻』」,配图 1.1 是大模型与操作系统融合的示意图,还提到 OpenAI 已建立类似 iPhone 的生态、通过应用市场提供 ChatGPT 插件。这些话在 2023 年是对的,在 2024 年已经属于行业通识,在 2026 年读起来像是给领导做的汇报。它占了 4.7% 的篇幅,删掉不影响任何技术理解。
第六,章与章之间不互相引用。第 7 章讲 LoRA 的显存优化、第 8 章讲 ZeRO 的显存优化、第 9 章讲 KV 缓存的显存优化,三处都在解决同一个物理问题,但彼此之间没有一句「这一点在第 x 章还会再出现,区别是……」。读者会被三个局部最优解绕晕,而真正需要建立的是一张全局的显存账本:权重占多少、梯度占多少、优化器状态占多少、激活占多少、KV 缓存占多少,各自的压缩手段是什么。这本书有这个账本的所有条目,就是没做汇总。
九、那它到底该给谁读
我给三种人三种建议。
如果你手上只有一张消费级显卡,别从第 1 章读。直接跳到 7.5 QLoRA、8.6 的 ZeRO-Offload、9.2 的 KV 缓存与页注意力、9.4 的量化,然后回第 4、5 章补数据。第 8 章前面 40 屏对你没用,第 10 章可以只看 10.4 端侧部署。
如果你在带团队做垂直领域落地,这本书值得当参考手册放在工位上,但别当决策依据。它能告诉你「有哪几种做法、各自代价在哪」,不能告诉你「你该选哪种、要花多少钱」。后两个问题得自己算。
如果你是学生,想搞明白大模型工程的全貌,这本书是合适的。188 条目录等于 188 个知识点,密度够、术语准、有论文出处意识,读一遍能把「微调—训练—推理—编译—部署」这条链串起来。第 11 章那种「非性能需求」的内容,很多同类书根本不写。
回到标题那句判断。这本书的问题不在于它写得差——恰恰相反,它写得太像一本正经的技术书了,正经到忘了自己封面上写的是「低算力」。它把「低算力」当成一个题材,而不是一个约束;当成一句可以吸引人翻开的广告,而不是一条必须贯穿全书的纪律。
一句话:内容是硬的,编排是软的——它有资格叫《大模型迁移的工程链条》,却没资格叫「低算力」,因为全书 382 屏里,只有 21 屏真正站在卡不够的人这一边。
说明:各章屏数由 pages.jsonl 章节映射全量聚合——第1章 18、第2章 28、第3章 25、第4章 21、第5章 22、第6章 42、第7章 21、第8章 55、第9章 41、第10章 30、第11章 36、第12章 35,加前置 8 屏合计 382 屏,章屏数合计 374 屏(占 97.9%)。第 8 章占 14.4% 为全书最长,第 7 章占 5.5%,第 9+10 章推理与编译合计 71 屏、占 18.6% · 笔记与图谱生成于 2026-11-11
AI 实战导师 / 企业 AI 落地顾问 / 智能体工程师,17 年跨界、15,000+ 小时 AI 实操、20+ 套已交付工作流。 看完整履历海报 → skills 实验室 →
发表评论: